起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
满意度在 AI 产品的适用性探索


满意度是体验研究的常用指标,但在 AI 产品中,用户预期因缺乏经验、宣传夸大和个体差异而变得不稳定且偏差大,导致满意度分数不再能直接等同于产品表现。本文深入剖析 AI 产品用户预期的三大特点,揭示其对满意度诊断功能的潜在误导,并引入失验与产品表现两个指标,提供一套拆分问题根源的实用思路,帮助研究者更准确地定位优化方向。
满意度,是体验研究里最常用的指标之一,但它的定义并不唯一,本文沿用流传较广的一种:满意度是用户对「预期与感知表现之间的差距」所做的评估反应(Tse & Wilton, 1988)——说白了,就是用户把「感知到的产品表现」和「心里的预期」比过之后,心里的感受:高了就满意,低了就不满意。
因此,满意度得分主要受两个因素影响:一是产品表现,即用户感知到的产品体验(价值、可用性等);二是预期,即用户心里「产品该给我什么、什么水平」的预设。
在互联网、硬件等产品体验研究里,满意度的两个用途主要是:看清体验水平、诊断产品或功能表现——哪一项得分低,一般就认为那一项做得不够好。
不过,这两个用途都是建立在「产品表现与预期相比」这个基础上。笔者注意到:在 AI 产品里,用户预期这个因素,对满意度的影响作用似乎比互联网时代更大,因此,笔者想探讨在 AI 大模型产品里:
- 用户预期的特点是什么?
- 这些特点,是否会影响满意度的两个用途?
- 如果影响了,如何应对?
一、AI 产品的用户预期:来源与特点
1. 用户预期的来源
据 Oliver 的研究,用户对某款产品的预期来自以下三方面信息:
- 过往经验:用过同类产品或本产品的经历、对某产品的熟悉程度。
- 外部信息输入:口碑、厂商的宣传(广告、官方宣传、价格等信号)、媒体介绍。
- 个体特征:个体差异,例如性别、受教育程度等。
2. AI 产品的用户预期有哪些特点
在 AI 产品体验研究里,笔者发现以上三个影响预期的信息源都变化了,因此 AI 产品的用户预期存在以下几个差异点(对比互联网产品的用户预期):
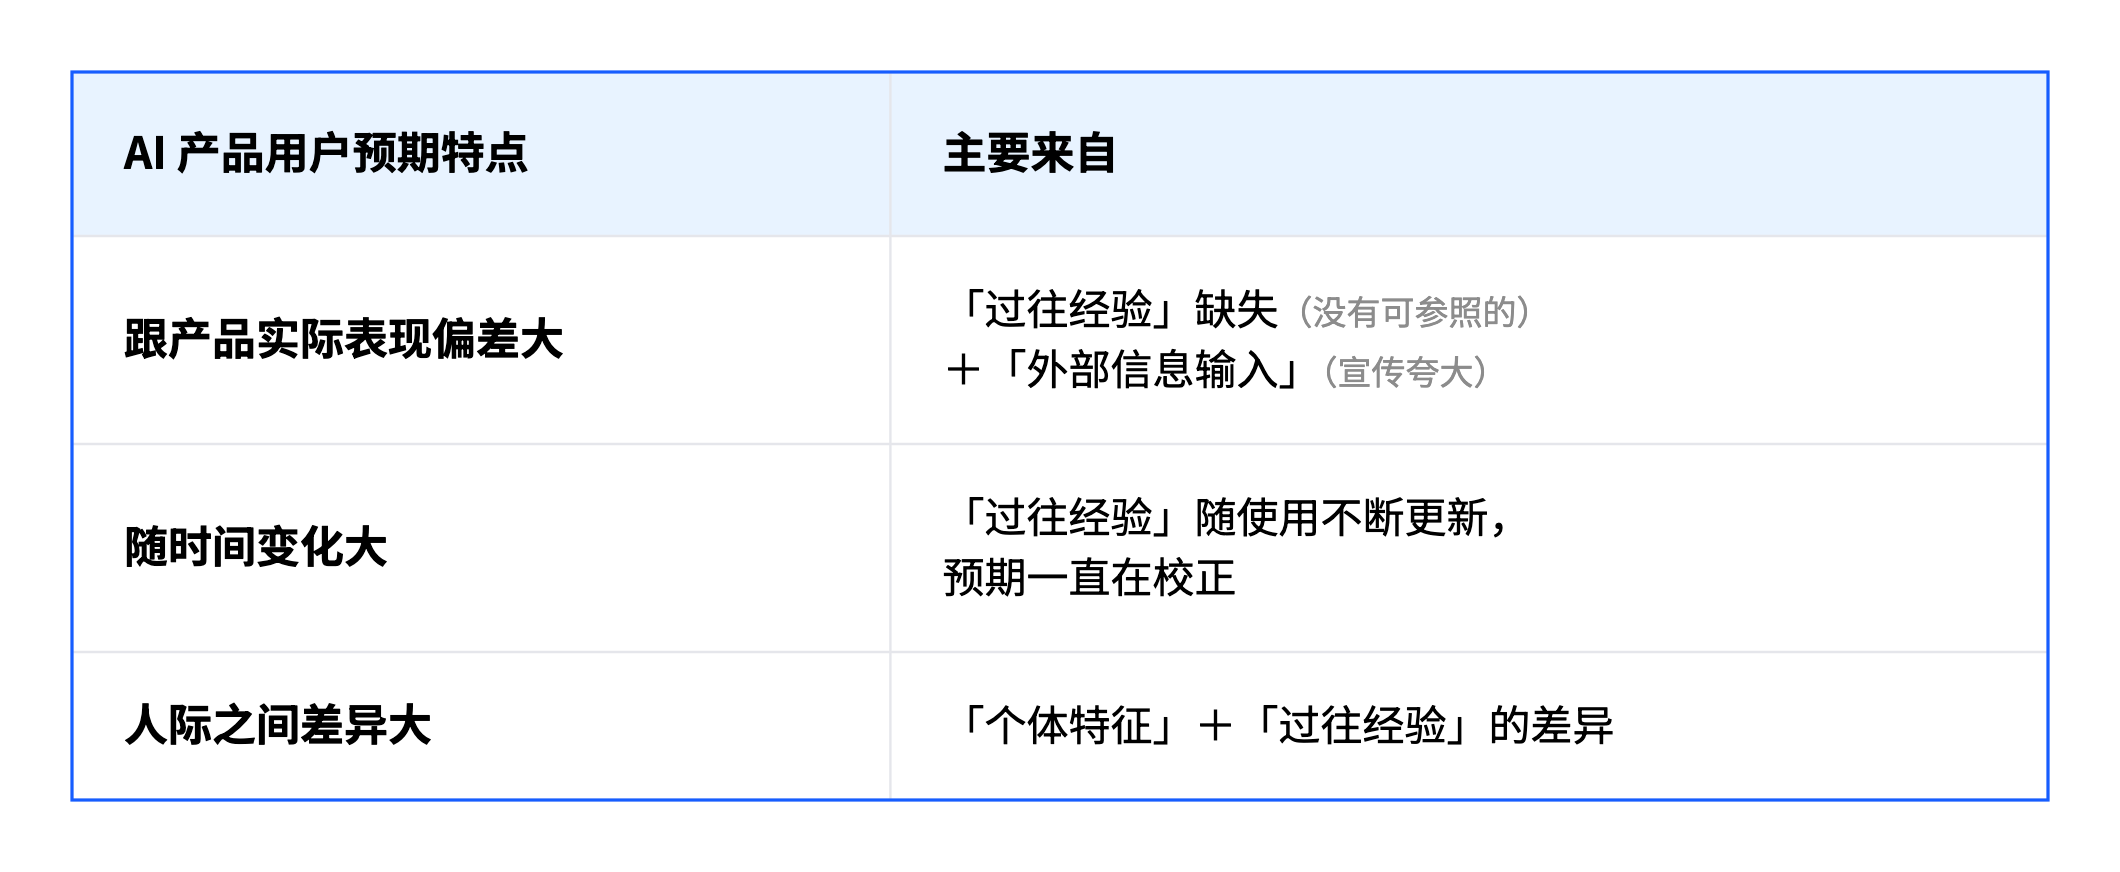
1)跟产品实际表现偏差大(来自「过往经验」缺失+「外部信息」影响)
与互联网产品不同,AI 是纯新产品:绝大多数用户都对它不太熟悉,更没有相关使用经验,所以根本也就不了解 AI 产品的真实水平;同时,用户又处在铺天盖地的宣传里,不管是官方广告、社媒帖子、视频,无不在营造这几个印象:「强大、智能、替代人类工作……」。
一边是没有可参照的实际经验,一边是夸大的外部信息,两者叠加,用户的预期自然与产品实际表现相差很大。
2)随时间变化大(来自「过往经验」的持续更新)
用户对 AI 的预期一开始就不太准、不成熟,它会在之后的使用里被不断校正。而这个校正,不是一次两次就能完成的,例如:部分用户刚开始不熟悉,等掌握一点使用技巧、经验,看到更高质量的产出后,预期可能提升;但也可能,有些用户抱着很高的预期而来,看到实际结果之后,发现跟宣传完全不一样,或者遇到了很多新的未知问题,预期会下降。所以,用户对 AI 产品的预期不是一次形成、长期不变的,且需要长时间的使用才会逐渐稳定。
3)人际之间差异大(来自「个体特征」和「过往经验」的差异)
用户因个体特征和使用经验不同,预期也会差得很远。一般而言,受教育程度更高、更年轻的用户,相对更容易接纳、掌握新技术,预期也更接近产品的实际水平;而有些人会相对更保守、谨慎;再加上每个人所处的信息环境不同,看到的「AI 能干什么」也不一样,预期就跟着分化。
二、预期特点对满意度的影响
既然 AI 产品的用户预期有这些特点,那它对满意度的两个用途意味着什么?
第一个用途,衡量体验水平——依然成立。
满意度是「预期」和「产品表现」比出来的结果,所以预期是否变化以及如何变化,都还会体现在分数里。用满意度来看体验好坏,这个用途在 AI 产品里不受影响。
第二个用途,诊断产品表现——这里值得注意:
在互联网产品的体验研究里,大家习惯用满意度分数来定位产品表现:哪一项得分低,就认为那一项做得不够好。这个推测成立的前提是用户的预期相对稳定、彼此之间的差异也有限,因此满意度分数的差异,基本可以认为来自产品本身。
但在 AI 产品里,预期这个因素的作用不容忽视:它不够稳定、可能跟实际产品表现偏差大、人跟人之间差异大,这意味着:同样的 AI 产品表现,不同用户会因为预期差异大,给出不同的满意度分数。这时候如果还把满意度分数直接等同于产品表现,就可能误判。
举个例子:
两个用户用相同的提示词,使用同一个对话大模型写活动方案,两人拿到的初稿水平相当,这个初稿肯定也都需要多轮追问、修改才最终可用,所以,关于产品表现,两个用户拿到的结果是一样的。但是,用户甲最初以为「一句话就能出成品」,所以拿到初稿后,会觉得离预期还差很远;而用户乙原本只指望 AI「能帮着出个草稿、省掉完全从 0 开始的麻烦」,拿到同样的初稿后是觉得符合预期的。这两人的满意度分数,如果甲明显低于乙,这个差距就不是产品表现造成的,而是两人心里的预期不同。
所以,对于当前的 AI 产品,尤其是用户缺乏足够的 AI 使用经验,预期不够稳定、准确时,只看满意度分数高低,就推测「哪一项做得不够好、需要去优化」,就不一定对。
需要说明的是,这套判断只对现在这一阶段成立。等以后大家对 AI 更熟悉、预期慢慢校准,这些差异会收窄,AI 产品的满意度或许又能像互联网产品那样,间接等同于产品表现。但现在还不到那个时候。
那么,当拿到满意度分数后,怎么才能分清楚问题到底出在哪?用户预期?产品表现?下文提供一个拆分的思路。
三、对策:用失验与产品表现拆开满意度
笔者参考相关文献,在满意度以外引入两个指标,一个对应「预期」,一个对应「产品表现」,它们只是第一步,更像是探针,提示「下一步该重点关注什么」,后续还要参考更多信息——用户特征(年龄、受教育程度等)、AI 使用经验、诉求等综合分析,才能更准确、有依据地判断出「该改产品、还是该管预期」。
下面先介绍这两个指标,再介绍基于这两个指标结果如何进一步分析。
1. 失验(disconfirmation)
是什么,怎么测:这个指标对应「预期」这个因素。虽然测量预期最直接的办法是问用户「你的预期是什么」,但做过访谈的人都会知道,预期藏在用户心里,很难在问卷里被测量出来,往往用户自己都说不清。所以,笔者借鉴其他满意度研究的做法,不问预期本身的内容,而是问「实际拿到的,跟你原来想的比,是高、是低、还是差不多」——这就是「失验」。它测量的是预期的方向与偏差。
谁提出的:这个做法最早由 Oliver 在 1980 年提出;1982 年 Churchill 与 Surprenant 把失验与预期、产品表现分开测量。
与满意度的区别:满意度是对这个差值产生的感受;失验是这个差值本身,是「判断」。
价值:失验把「实际相对预期」这个差值单独测量出来,可以间接反映「预期」在满意度里的作用。
用在哪:以 AI 体验评估项目为例,用在产品整体和主要任务(如写作、对话等)层面。
2. 产品表现
是什么,怎么测:这个指标对应「产品表现」这个因素,让用户评价「某任务的完成程度或问题解决程度」。
与失验、满意度的区别:失验看「比预期高还是低」,产品表现看「实际做到什么程度」,满意度是整体感受。
价值:给出「产品表现」这个因素的分数,和满意度、失验一起看,帮助判断满意度高低更可能是产品的原因,还是预期的原因。
用在哪:以 AI 体验评估项目为例,用在产品整体和主要任务(如写作、对话等)层面。
3. 拿到分之后,怎么往下分析
笔者分析思路如下:先看满意度和产品表现得分,有需要再纳入失验分进一步分析;其中,产品表现和满意度得分分别与目标值对比(如无,可对比历史、竞品等),可得到以下四类组合,分别对应不同的行动点:
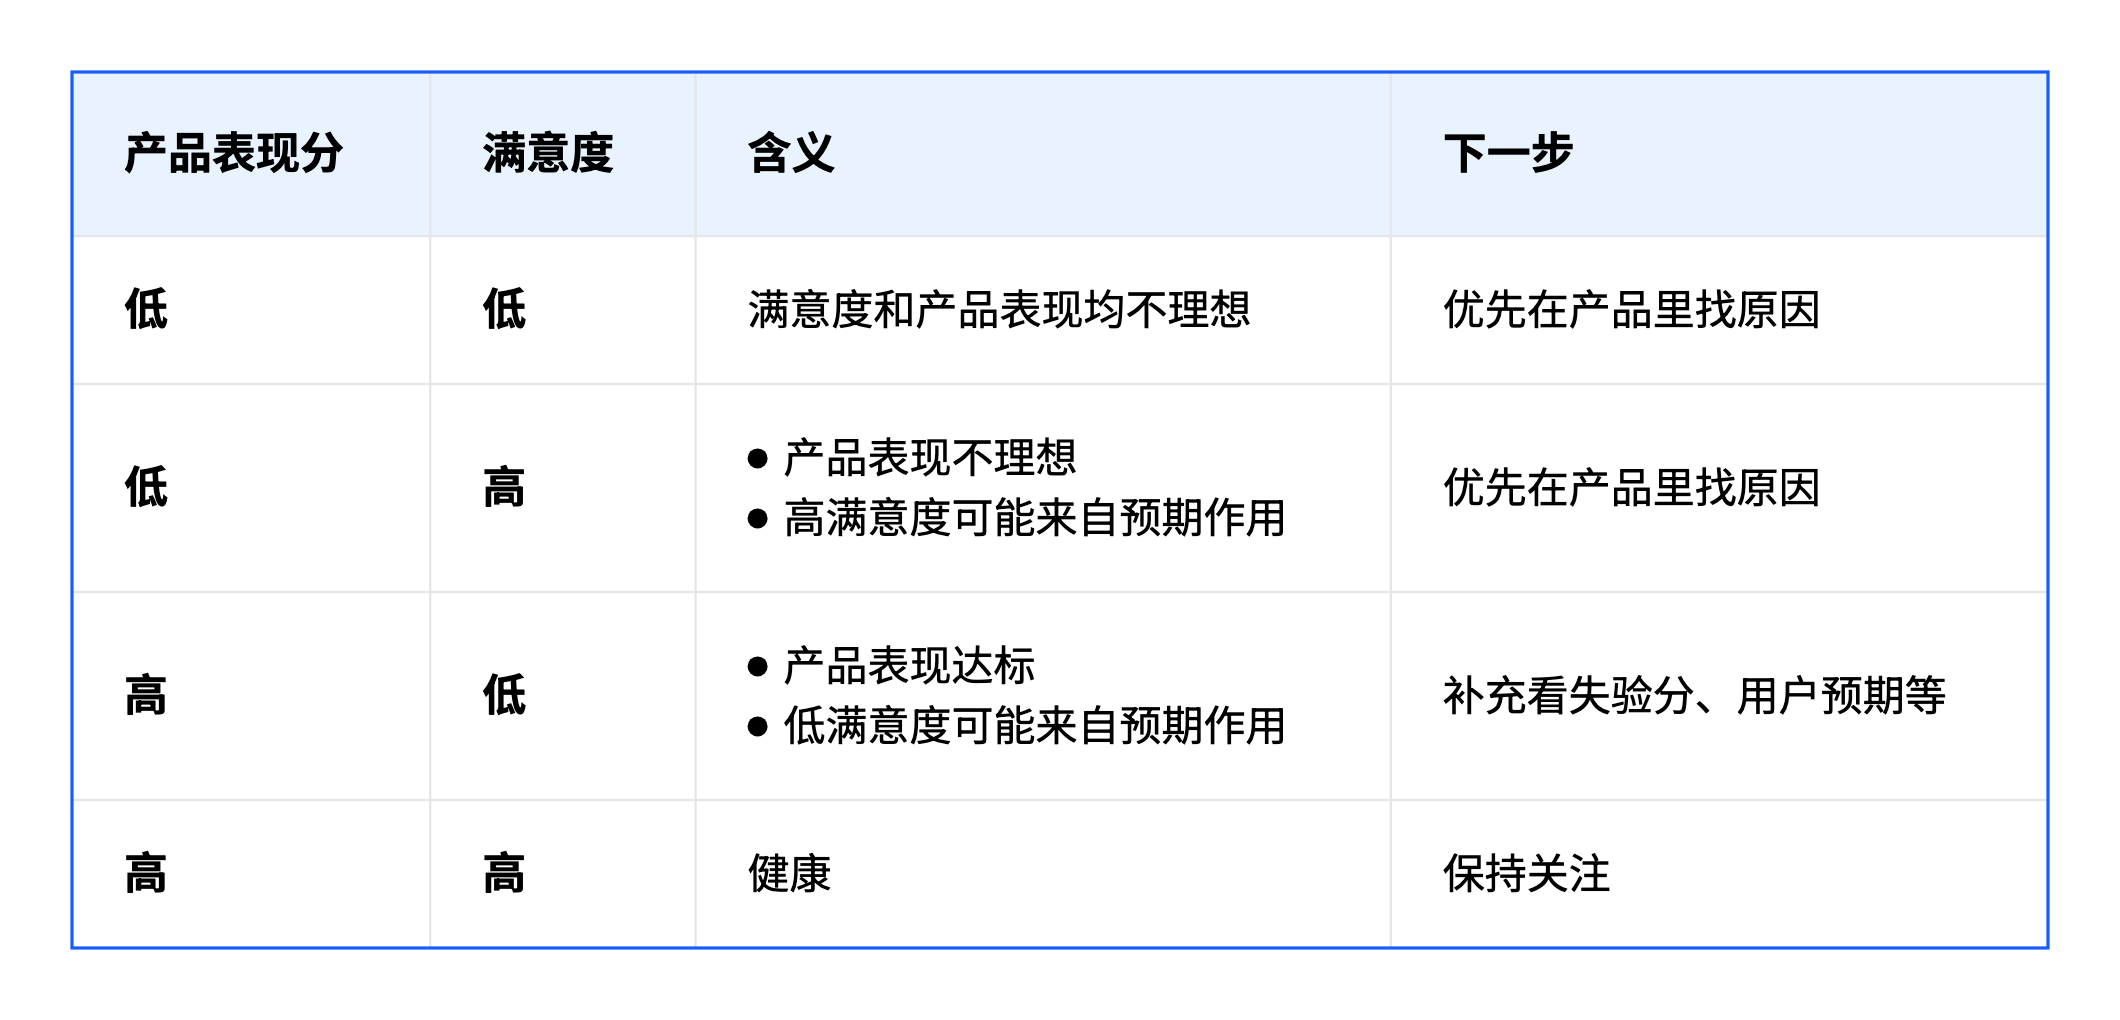
1)产品表现分低,满意度低
两个分指向一致。由于产品能力是体验的基础,且比管理预期更容易去发力和拿到结果,所以不管预期水平如何,都建议优先在产品里找原因。
2)产品表现分低,满意度高
不要被高满意度误导,觉得可以高枕无忧了,毕竟产品表现没达标,这个高满意度可能来自用户的低预期:用户本来就没抱多大期望,产品表现虽然一般,但可能只是因为比他们预期的好,就给了个高分。所以,下一步仍然先在产品里找找问题,不要忽视掉这个线索,错过产品优化的时机。
3)产品表现分高,满意度低
产品达标了,满意度分数却低,问题依然可能出在预期。考虑到满意度是忠诚度(用户留存等)的重要来源,所以不能因为产品表现不错就忽视满意度。下一步需要看看失验得分:选「低于预期」的人是不是占了多数?如果是,可能的原因是:用户带着很高的期望来,用下来虽然觉得产品不差,但因为没达到他预期的水平,于是给了低分。但这些只是推测,失验分也只是个「探针」:提示下一步需要关注什么,并不是结论。接着可以看这批人在影响预期的几个维度——年龄、受教育程度、AI 使用经验、诉求上有什么特点来辅助判断(例如,如果大多数都是受教育程度低、AI 使用经验很少的,则更可能是预期存在问题);有需要的话,可以补充访谈,弄清用户心中的 AI 是怎样的,这些印象又是从哪来的,以帮助找到原因。
4)产品表现分高,满意度高
情况健康,可先保持关注。
需要注意,以上三个指标得分给出的是方向,提示下一步该重点看什么,还需要补充其他相关指标信息、访谈来辅助下结论。
四、总结
- 满意度衡量「体验水平」这个用途,在 AI 产品里依然成立;但直接拿它诊断「产品表现」,就不一定走得通了:分数分不出「是产品表现差,还是预期在起作用」。
- 原因在于 AI 产品的用户预期。在当前这个阶段,它跟产品实际表现偏差大、随时间变化大、人际之间差异大。同样的产品表现,会因为预期不同,得到不同的满意度分数。
- 笔者建议的做法是:在满意度之外补两个指标——失验、产品表现,基于其得分,得到下一步方向或假设(先在产品还是预期里找原因);再结合用户特征、AI 使用经验、诉求等信息判断假设是否成立,从而找到准确的发力点。
以后再看到满意度分数,不妨把产品表现分也拿出来看一下,能减少一些误判。
附录:下一步,怎么摸清用户的预期:
前文提到,如果分数提示「可能是预期在起作用」,除了侧面看影响预期的一些因素(人口属性、AI 使用经验等)的表现,也可以再找用户聊一聊,以弄清楚用户心中 AI 的水平、能力到底是怎样的。但因为预期这个概念很大,且很可能用户自己也不一定非常清楚或没想过这个问题,所以需要在访谈中抛一些「引子」,例如:
① 投射法:不直接问「你预期 AI 是什么水平」,而是让用户描述、举例、讲故事——「你第一次用它前,以为它能干嘛?」「如果你把它比作一个人或你熟悉的其他工具,你觉得它跟谁像?」——从用户的叙述里,反推出他心里那套预设长什么样,再通过引导、追问,一步步看清用户的想法。
② 来源与印象:预期有三类来源(过往经验、外部信息、个体特征),因此问题可以从以上三方面入手:
- 过往经验:「你之前用过什么类似的产品吗?如果有,你觉得两者有什么差异?」
- 外部信息:「你从哪知道它的?广告里怎么说的?你印象中它最大的卖点是什么?你对这个卖点怎么看?」
- 个体特征:分析时注意从用户的个人特质、对 AI 的态度侧面看不同人群的特点、差异。
这样,通过以上的访谈内容,可以再次验证是不是用户的预期存在问题、影响了满意度评分;如果是,还可以获得更具体的问题原因(存在哪些误解,来源是什么等),帮助制定优化对策。
本文由 @晚风 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!