
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Atlas下一个AI时代的来临


李飞飞创办的 World Labs 发布多模态世界模型 Atlas,它不靠文字或像素预测,而是直接理解并重建三维物理世界。本文深度解析 Atlas 与 LLM、图像及视频模型的本质差异,拆解其为何被视为 AI 里程碑,并展望机器人与科学研究的核心应用场景。
一、Atlas 是什么
2026 年 9 月 1 日,李飞飞创办的空间智能公司 World Labs 发布了新一代多模态世界模型 Atlas。它不是又一个聊天机器人,也不是又一款图片或视频生成器,而是一个能够理解、重建并模拟三维物理世界的模型。
Atlas 的核心能力可以概括为一句话:给它几张 2D 图像,它就能预测从任意新角度观察同一场景时会看到什么——并且是以符合几何真实、空间一致的方式。发布时它支持三种工作模式:
- 稠密重建:以多张图片为输入,精确重建完整三维场景;
- 稀疏重建:仅凭少量视角(甚至零像素条件),推想整个空间;
- 纯生成:直接从文本描述生成一个可探索的三维世界。
与普通视频生成模型不同,Atlas 把相机几何信息(位姿)作为模型的原生输入,而不是用文字间接描述”镜头向左移动”。李飞飞在 CoRL 2026 大会上将其技术理念概括为:当大语言模型信奉 “Next Token Prediction”(预测下一个词)时,Atlas 的思路是 “Viewpoint Is All You Need”(预测下一个视角)。它在同一套自回归扩散 Transformer 架构下,同时吸收了文本、图像、视频、深度信号和 3D 结构信号进行训练。
第三方机构 RapidData 组织的约 50 万人次人类盲测中,Atlas 在相机控制生成能力上排名第一,能生成超过 60 秒、1440p 分辨率的连贯视角视频。同年 11 月 12 日,World Labs 将 Atlas 向公众和开发者全面开放。
值得注意的背景是:2026 年 9 月底,AMD 宣布以约 82 亿美元全股票收购 World Labs,交易于 11 月完成交割。李飞飞出任 AMD 执行副总裁兼首席科学家。一家芯片巨头愿意为一支成立仅两年的团队支付这个价格,恰恰说明”世界模型”已成为下一代 AI 竞争的关键筹码。
二、Atlas 与当前主流大模型的区别
要理解 Atlas 的意义,最直观的方式是把它和三代模型放在一起对比。
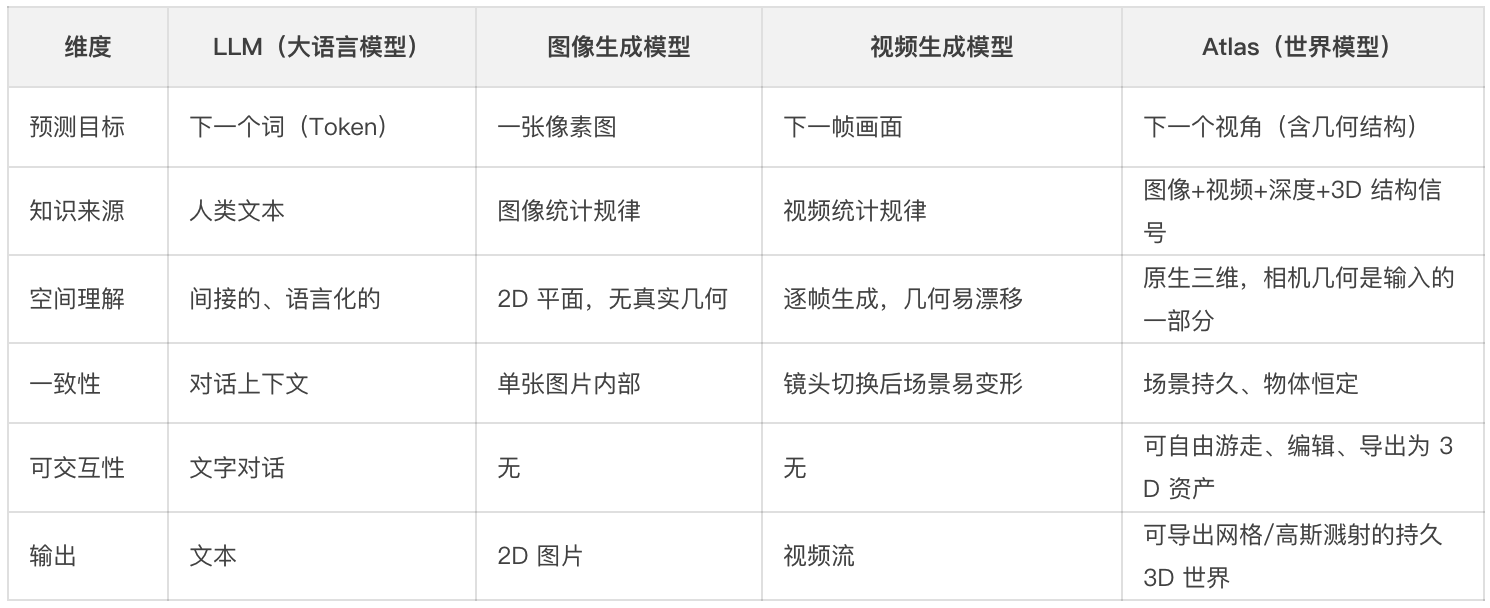
1. 与 LLM 的区别:从”谈论世界”到”理解世界”。 LLM 是在文字中长大的,它读过关于重力的所有描述,却从未”见过”一个杯子从桌上掉下去。李飞飞有一个广为流传的判断:大语言模型是”黑暗中的文字匠,雄辩却缺乏经验,博学却无所依凭”。LLM 可以流利地描述物理规律,但无法真正模拟物体碰撞后如何旋转、落在哪里。它对物理世界的理解是通过语言间接获得的近似。
2. 与图像模型的区别:从”平面像素”到”立体结构”。 Stable Diffusion、DALL·E 等图像模型能画出一张逼真的客厅照片,但那只是一层 2D 像素。你不能走进去,换个角度看它会露出破绽——影子不对、透视穿帮。Atlas 生成的是带真实几何的三维表示,场景中的物体是”存在的”,而不只是”看起来存在”。
3. 与视频模型的区别:从”幻灯片式幻觉”到”持久世界”。 Sora 类视频模型逐帧预测画面,擅长让画面”看起来在动”,但镜头一转,之前出现的椅子可能就变了形状甚至消失了——因为模型并没有一个持久的三维场景记忆。李飞飞强调 Marble(Atlas 的前代产品)的关键突破正是“物体恒常性”(Object Permanence):你转过身再回头,物体还在原地。Atlas 继承并强化了这一点,它生成的不是一段视频,而是一个一致的、可交互的数字空间。
一句话总结:LLM 学会了”说”,图像模型学会了”画”,视频模型学会了”演”,而 Atlas 在学”住在世界里”——感知、推理并与三维空间交互,这正是李飞飞所说的空间智能(Spatial Intelligence)。
三、为什么说 Atlas 是 AI 的里程碑
第一,它标志着 AI 主干道之外第二条路线的成熟。 过去十年,从 AlexNet 到 GPT,AI 几乎等同于”更大规模的统计学习”。而 Atlas 证明:AI 可以不靠逐字逐帧的预测,而是直接学习世界的几何结构与因果规律。这与杨立昆(Yann LeCun)主张的 JEPA 路线殊途同归——两位 AI 教母级人物在”AI 需要世界模型”这一点上达成共识,只是路径不同:LeCun 主张学习抽象的隐式表征,李飞飞坚持输出显式的、可视的 3D 世界。Atlas 是显式路线到目前为止最成功的实践。
第二,它补上了”具身智能”缺失的那块拼图。 机器人研究最大的瓶颈从来不是机械臂,而是训练数据——真实世界采数据太慢、太贵、太危险。World Labs 提出的 Real-to-Sim-to-Real(R2S2R)框架给出了答案:先从真实场景重建出高保真仿真环境,让机器人在里面完成数百万次试错,再把训练好的策略零样本迁移回真实世界。李飞飞已现场演示了机器人完全在 Atlas 构建的虚拟环境中训练、并直接部署到现实的案例。这相当于为机器人领域造出了自己的”ImageNet 时刻”。
第三,它验证了”空间智能”的产业价值,并推动了软硬一体的新格局。 从 2024 年估值 10 亿美元,到 2026 年 2 月 C 轮融资 10 亿美元(估值 54 亿),再到 AMD 82 亿美元收购——资本和芯片巨头用真金白银为这条路线投票。AMD 的逻辑很直白:世界模型的算力负载与语言模型完全不同,只有把模型团队放进公司内部,才能”在硬件图纸定稿之前,拿真实的空间智能负载去压测”。AI 竞争正从”谁的模型更强”演变为”谁的模型与芯片协同更深”。
第四,它把 AI 的能力边界从”语言世界”推进到”物理世界”。 ImageNet 让机器学会了”看见”,ChatGPT 让机器学会了”表达”,而 Atlas 及其代表的世界模型路线,正在让机器学会”理解空间本身”。李飞飞设想了一个”多宇宙”式的未来:3D 内容生成成本趋近于零,人类可以廉价地创造无数平行的数字世界,作为物理经验的无限延伸。这是继互联网(信息平权)、LLM(知识平权)之后,可能出现的第三次人机交互革命——体验与行动的平权。
四、未来最核心的应用场景
1. 机器人与具身智能(最重要、最确定)
这是 Atlas 的”主战场”。世界模型将成为机器人的虚拟训练场:仓库机器人、人形机器人、自动驾驶车辆都先在数字世界中经历千万次碰撞、跌倒和极端场景,再走向现实。苏姿丰判断物理 AI(尤其是机器人)是未来数万亿美元级的机会,Atlas 正是切入这一市场的核心武器。谁拥有最好的世界模型,谁就拥有机器人时代的”驾校”。
2. 科学研究:AI 的”虚拟实验室”
这是 Atlas 最令人期待、也最深远的应用方向:
- 实验预演与假设检验:科学家可以在重建的三维环境中模拟实验过程——晶体生长、流体行为、生物大分子构象变化——先用世界模型筛选假设,再投入昂贵的真实实验。这类似于 AlphaFold 之于结构生物学的作用,但覆盖面从单一问题扩展到整个物理场景。
- 医学与神经科学:李飞飞本人已提到 Marble 被用于精神病学研究。世界模型可以构建可控、可重复的虚拟环境,研究人类的空间认知、恐惧反应与记忆机制;外科医生可在重建的患者器官三维模型中反复演练手术。
- 材料与工程设计:设计师在生成的三维空间中快速迭代原型,模拟结构与受力,缩短从想法到实物的周期。
- 地球与环境科学:把真实地形、城市、气候场景重建为可交互数字孪生,模拟洪水演进、城市规划方案的长期影响。
科学方法的核心是”提出假设—验证假设”,而世界模型把验证这一步的成本降低了几个数量级。这是它作为”AI 里程碑”在科学领域的真正意义:它不是帮科学家写论文,而是给科学一个可反复试错的虚拟世界。
3. 游戏、影视与内容创作(最先商业化的场景)
Marble 已在此落地:文本/图片/视频输入即可生成可编辑、可导出的 3D 场景,直接接入 Unreal、Unity 工作流。Atlas 的实时交互能力(如演示项目 Frameboy)则指向下一代游戏形态——不是预制关卡,而是”按需生成且始终一致”的世界。虚拟制片、VR/AR 内容、沉浸式教育的制作成本都可能下降一个数量级。
4. 建筑与空间设计
拍几张照片就能生成可游走的三维方案,客户”走进”未来的房子再决定改哪里。房地产、城市规划、室内设计的工作流将被重构。
5. AI 智能体的”物理常识底座”
当前基于 LLM 的智能体常常”想得头头是道,做起来空间错乱”(比如规划一条几何上不可能的取物路径)。未来的分工很可能是:LLM 负责语言理解与推理规划,世界模型负责空间模拟与可行性验证——智能体在行动前先在”脑内”的世界模型里演练一遍。两者是互补而非替代关系。
五、冷静的另一半
里程碑不等于终点。Atlas 目前仍有清晰的技术边界:复杂场景下仍会出现局部几何漂移,且尚未真正模拟接触、动力学等物理属性——它能造出”看起来对”的世界,还没能造出”运行起来对”的世界。从”视觉上正确的世界”到”物理上正确的世界”,中间还隔着接触力学、材料属性、流体、软体形变等一堆硬问题。李飞飞自己也判断,Transformer 架构能否支撑到爱因斯坦式的抽象层级,目前证据不足,五年内才可能看到 AI 理解物理世界的实质性突破。
但方向已经清晰。二十年前,李飞飞用 1500 万张标注图片让机器学会了”看见”;今天,她押注的是让机器学会”存在于世界之中”。Atlas 或许还不是终极答案,但它把一个问题正式摆上了台面,并给出了第一个像样的答案:
智能的下一章,不写在文字里,而写在空间里。
本文由 @luffy 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务


- 目前还没评论,等你发挥!