起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
语义翻译:一条规则从被发现到自动生效,要经过谁?


当团队里不止一个人在做语义翻译,规则量从5条变成50条,谁来保证分散的翻译指向同一套机器规则?本文深度拆解一条规则从被发现到自动生效的完整生命周期,涵盖诞生、成长、分发、生效、验证、迭代六大环节,揭示组织翻译机制背后的关键决策点与角色分工。

在《语义翻译的操作日常》里,我讲的是“把’我觉得不对’变成’机器能查'”的日常动作,发现语义漂移、写YAML 契约、验证规则生效。那篇是操作手册,不问你是谁,只问你做不做得到。
在《意图设计的翻译能力》里,我讲的是“从人懂的直觉到机器读的规则”的能力本质,识别语义信号、编码语义层级、定义机器断言。那篇是能力宣言,不问你在什么岗位,只问你有没有这种判断力。
这两篇之间,缺了一个问题:当组织里不止一个人在做这件事,当规则量从5条变成50条,当两个团队对”严重”的定义开始互相覆盖,谁来保证这些分散的翻译,最终指向同一套机器规则?
这不是”招聘一个新岗位”的问题。我见过太多团队,设计师在写规范、前端在写校验、产品在写需求文档,每个人都在做语义判断,但判断标准散落在不同文档里,机器读不懂,人也对不齐。
这时候,团队里会自然长出一个人:他是那个每次评审会上被大家问”这个场景该用什么语义”的人,是那个最熟悉语义规范手册的人,是那个前端愿意把Prompt前缀交给他写、DesignOps愿意把Checklist交给他维护的人。
他可能叫”体验设计师”,可能叫”设计系统负责人”,可能叫”前端架构师”,岗位名称不重要,重要的是他在做”语义翻译”这件事,并且成为了团队里这件事的兜底者。
本文讲的,不是”怎么招聘这个人”,而是“当这个人出现时,他手里的规则,从被发现到自动生效,要经过谁、经过什么判断、留下什么痕迹”。
一条规则的生命周期,就是一套组织翻译机制的缩影。
全文地图
一条规则从”被发现”到”自动生效”,完整生命周期分为六个环节:
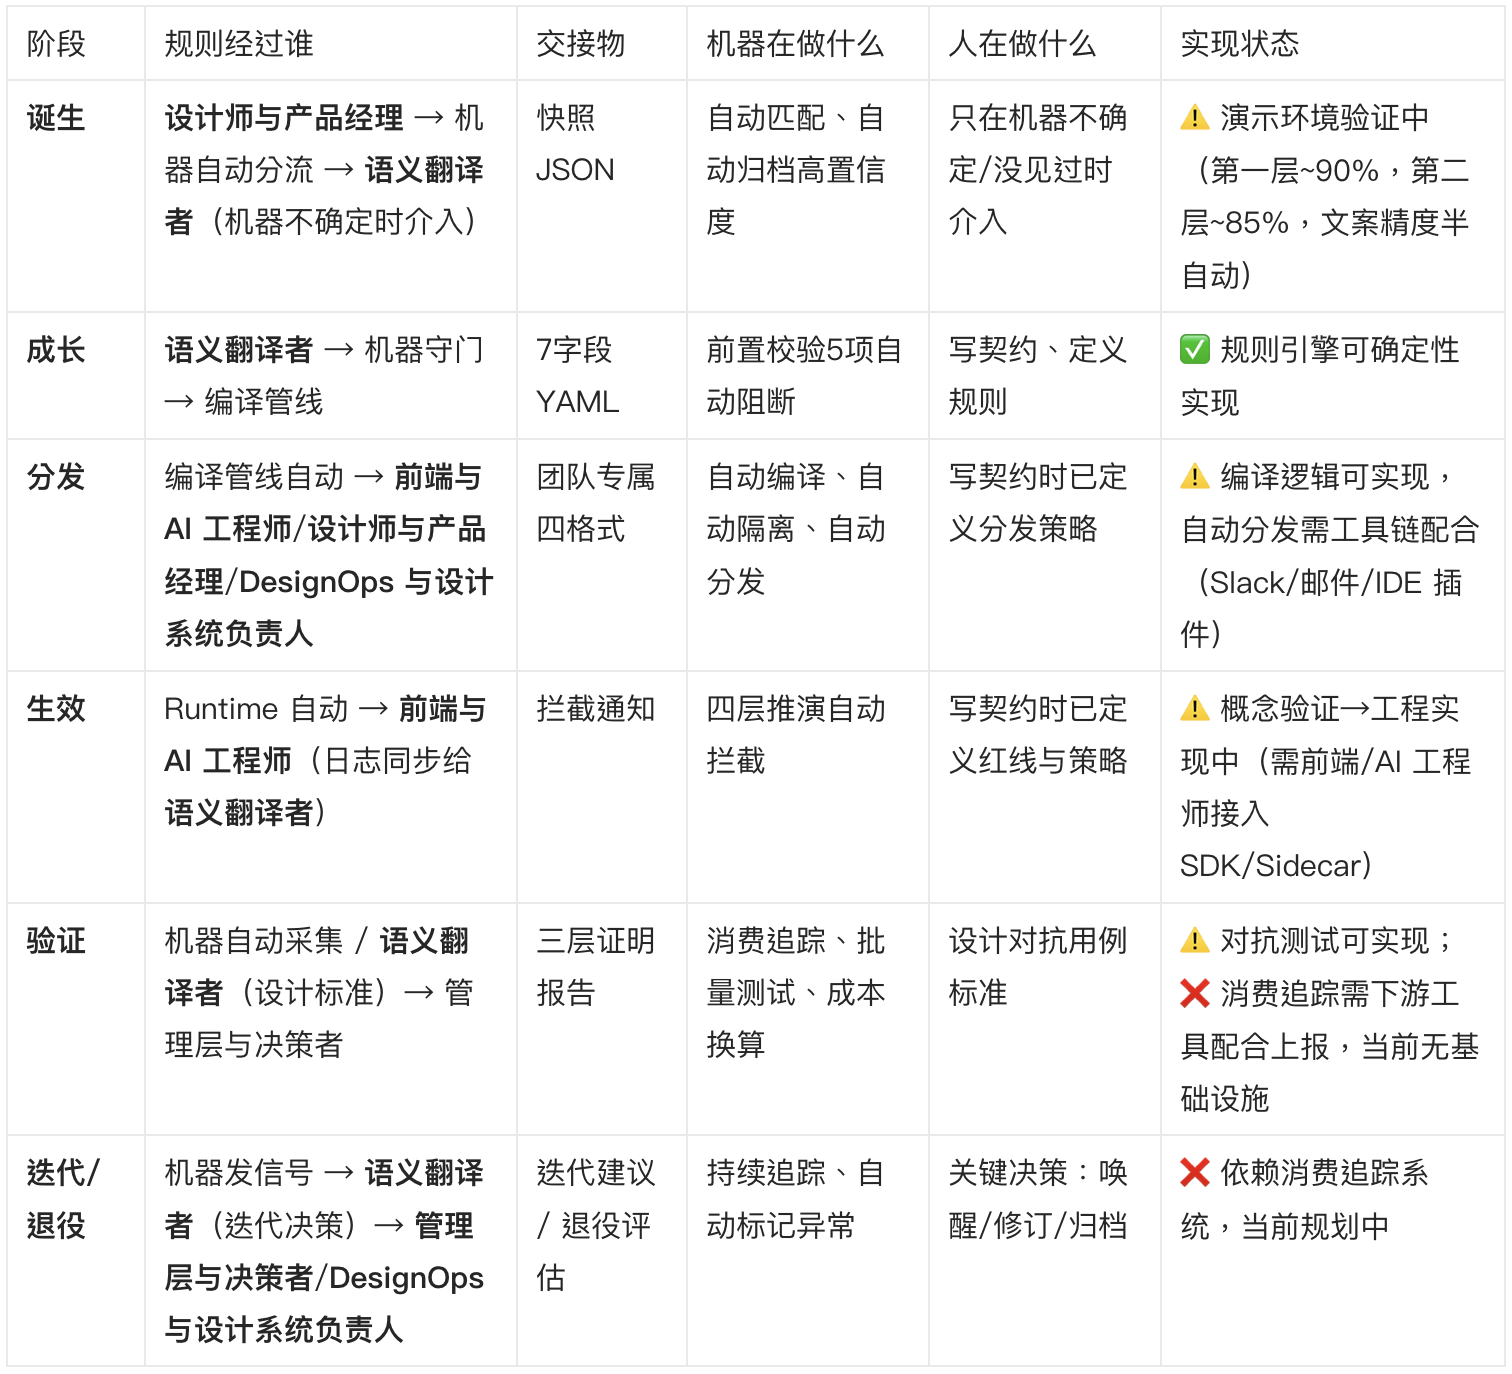
图例:✅ 已实现 / 规则引擎可确定性实现 · ⚠️ 演示验证中 / 需工具链配合 / 准确率有缺口 · ❌ 规划中 / 依赖前置系统
先把整条路画出来,后文每一节都是对其中一个节点的放大(横轴是规则的生命阶段,纵轴是谁在场):
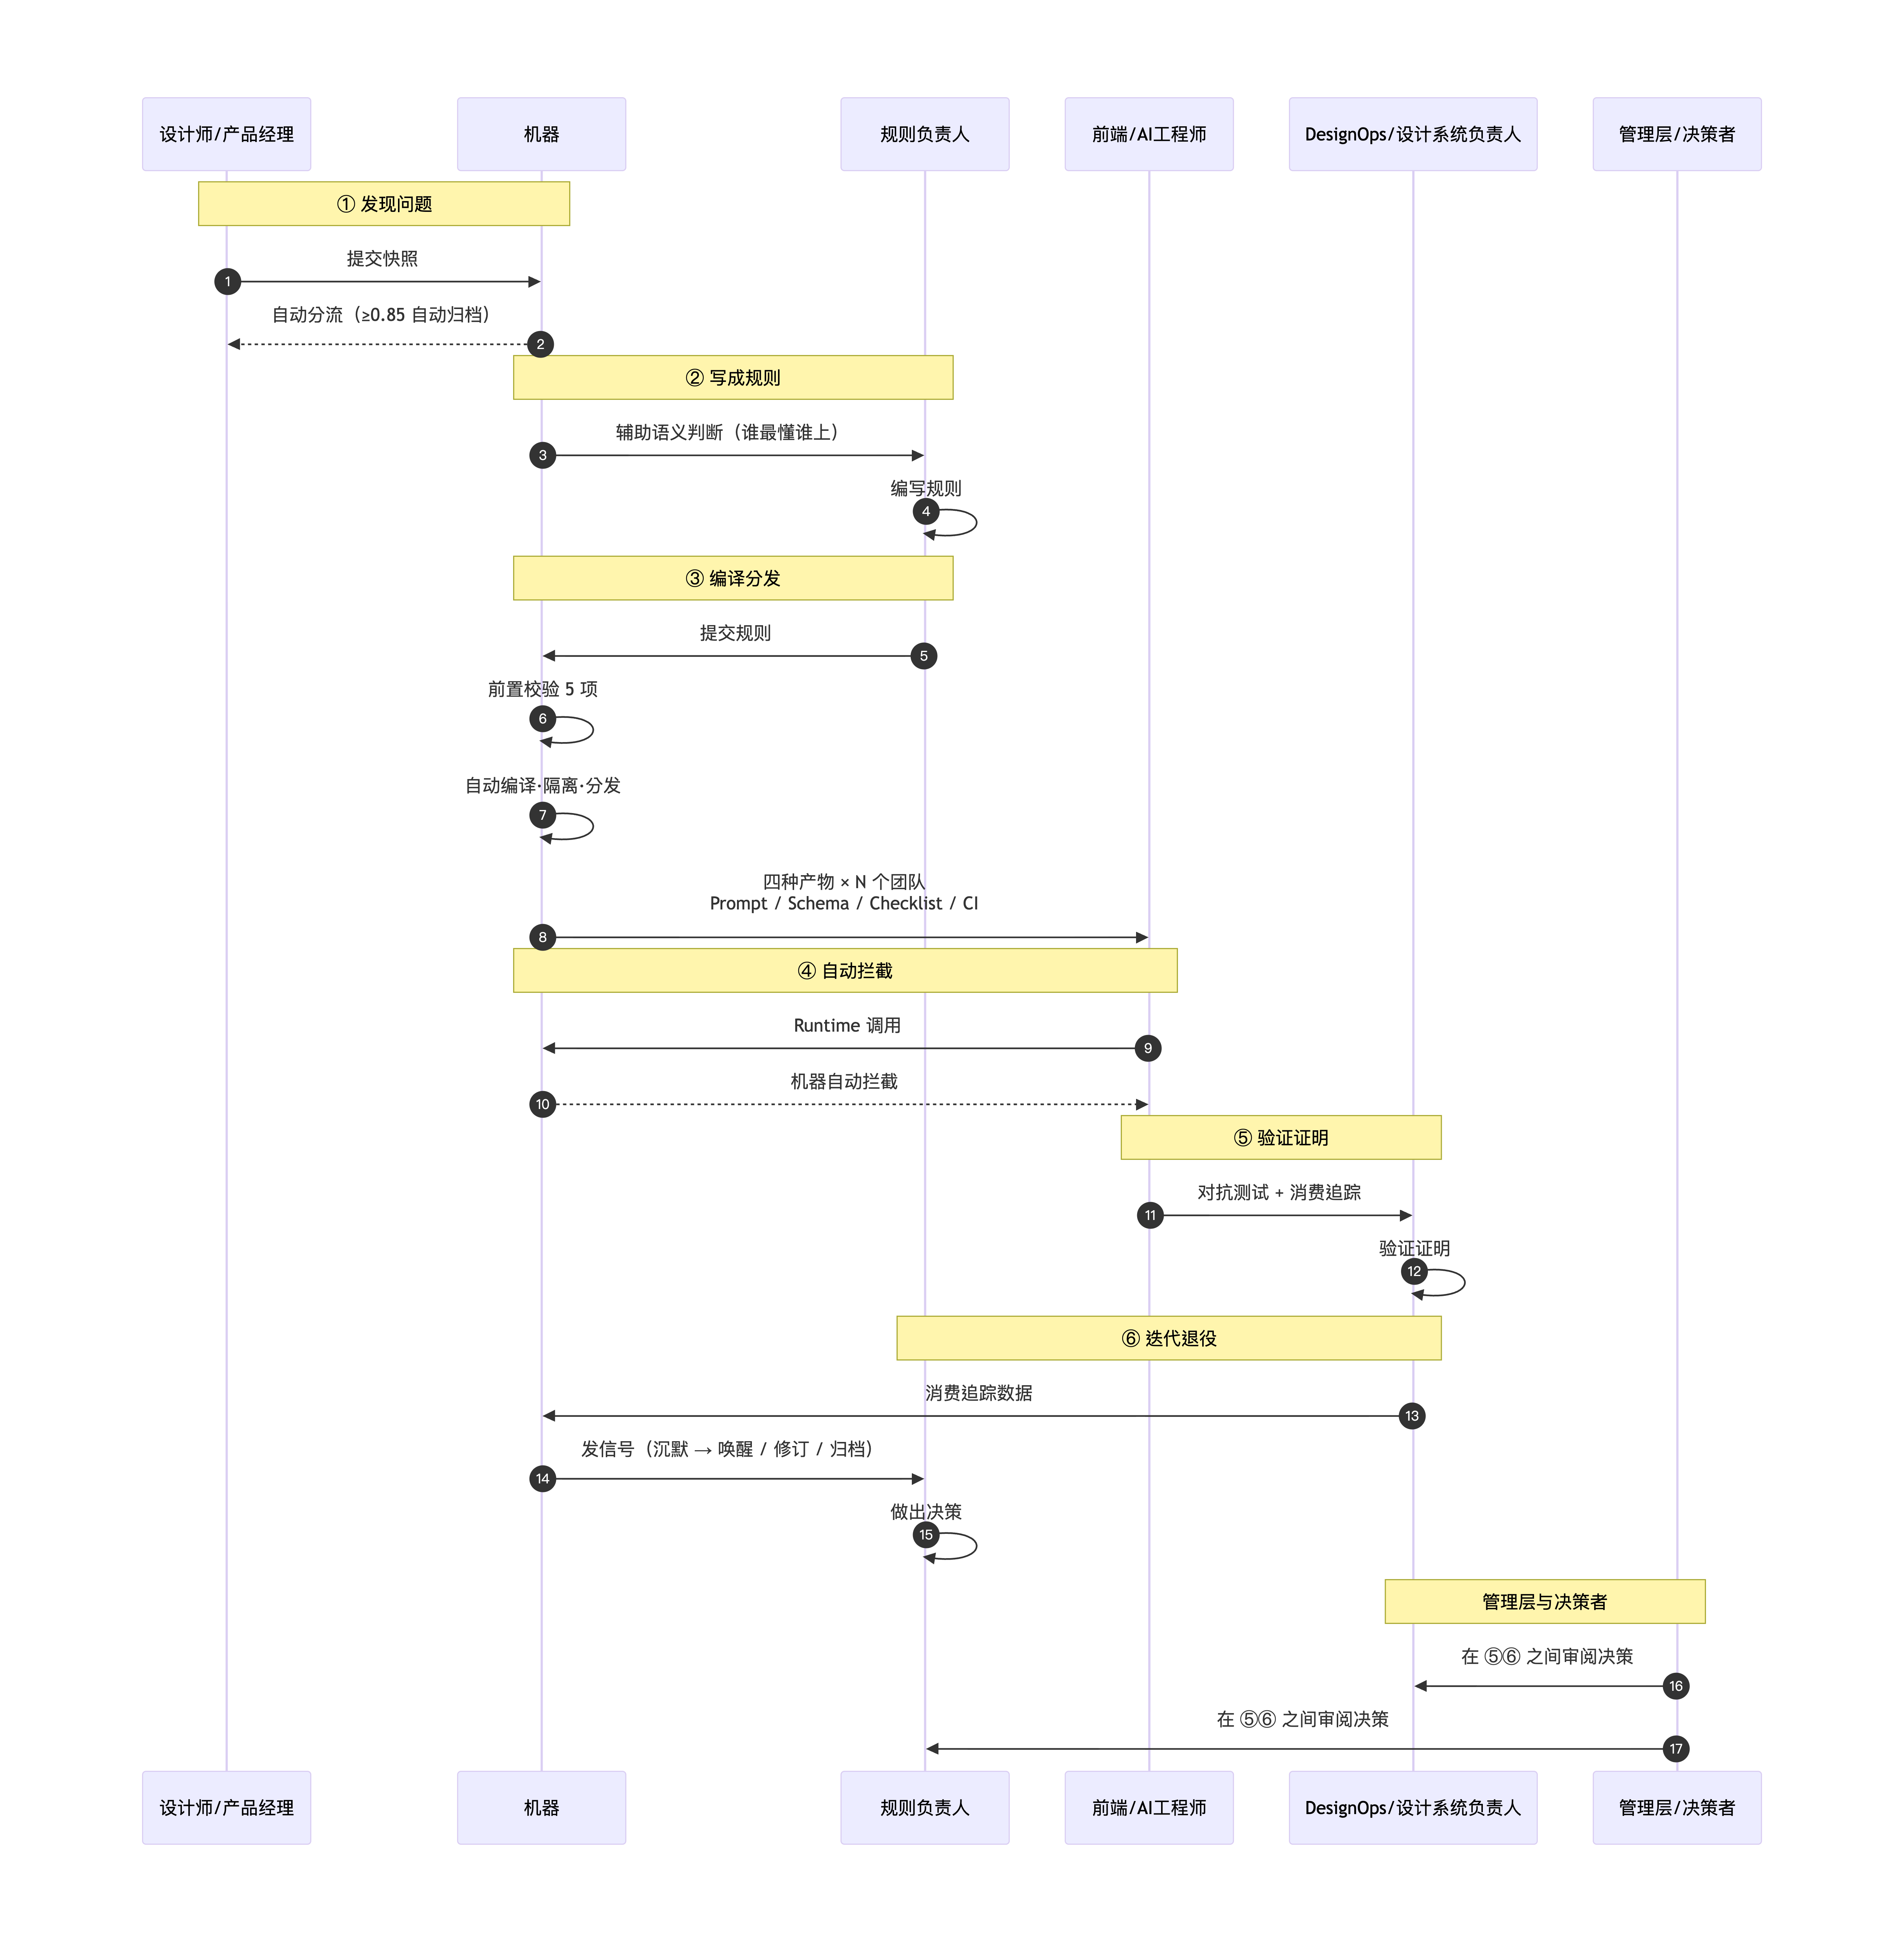
核心逻辑:人在关键决策点定义规则,机器在执行链路自动运行。
一、链路起点:问题怎么被发现(诞生期)
1.1 一句话概括
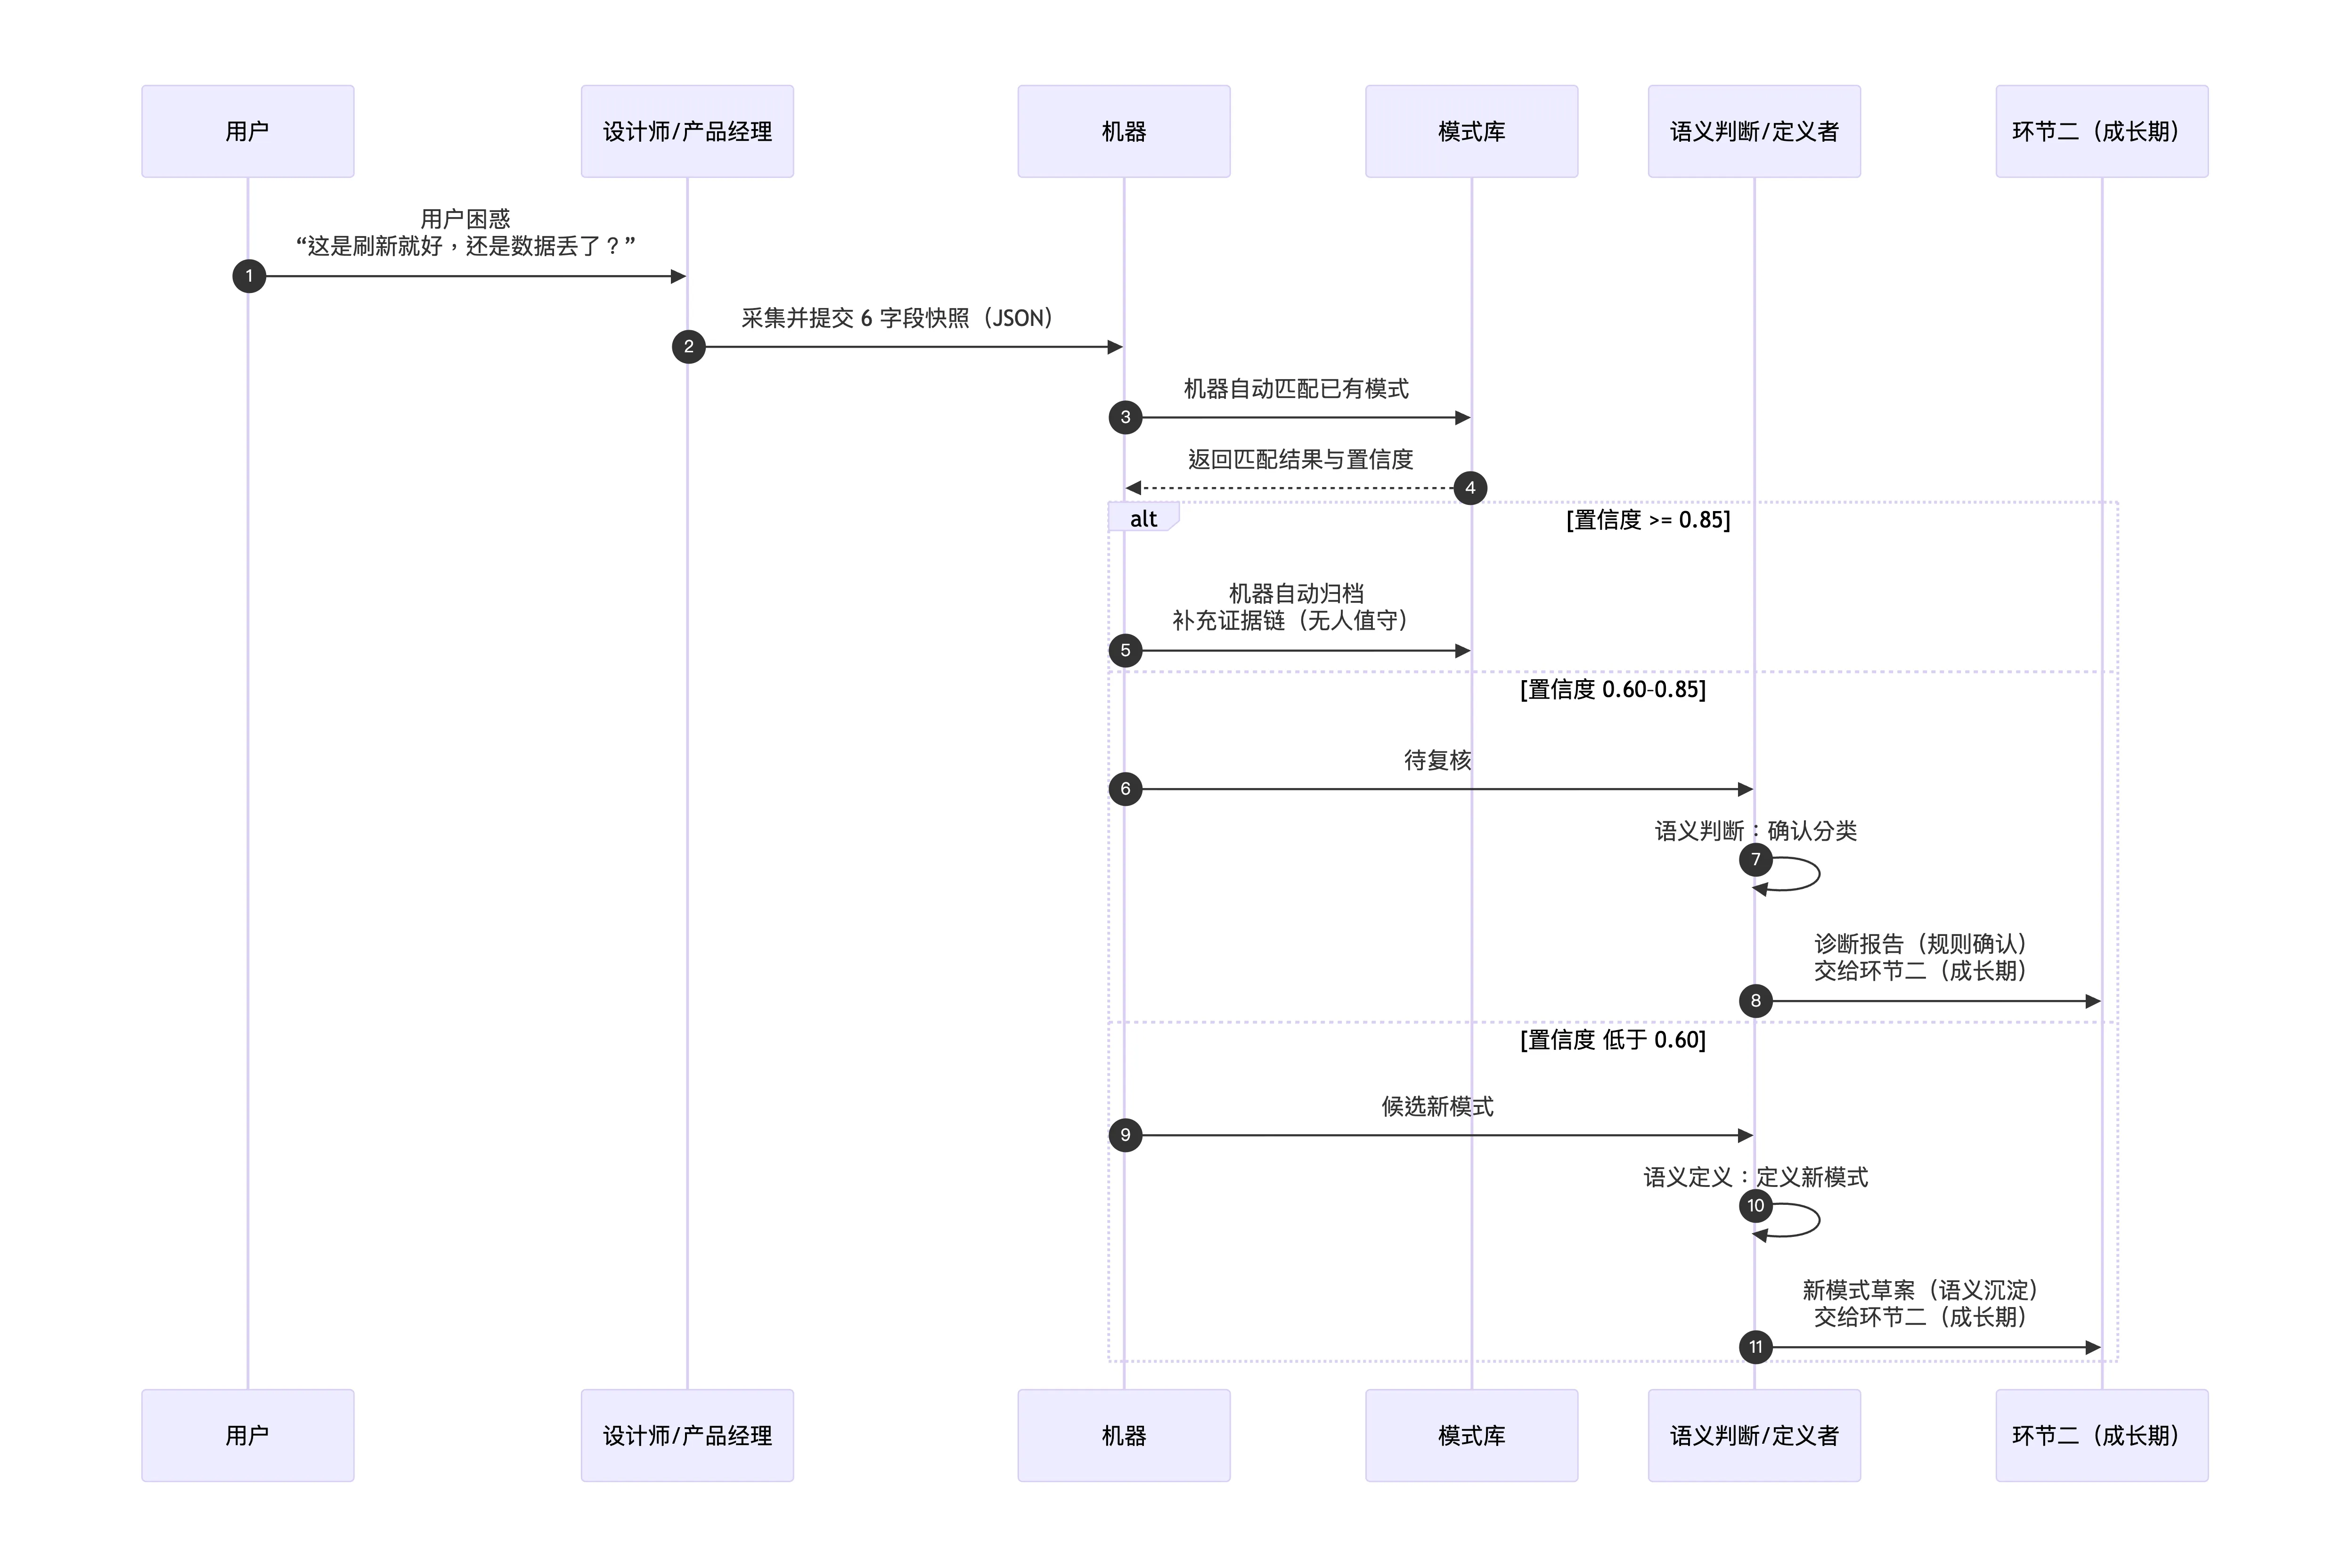
设计师与产品经理把”用户看不懂”变成一张结构化快照,机器先做自动匹配和分流,我在机器不确定时做分类决策。
1.2 本环节链路图
1.3 步骤拆解表
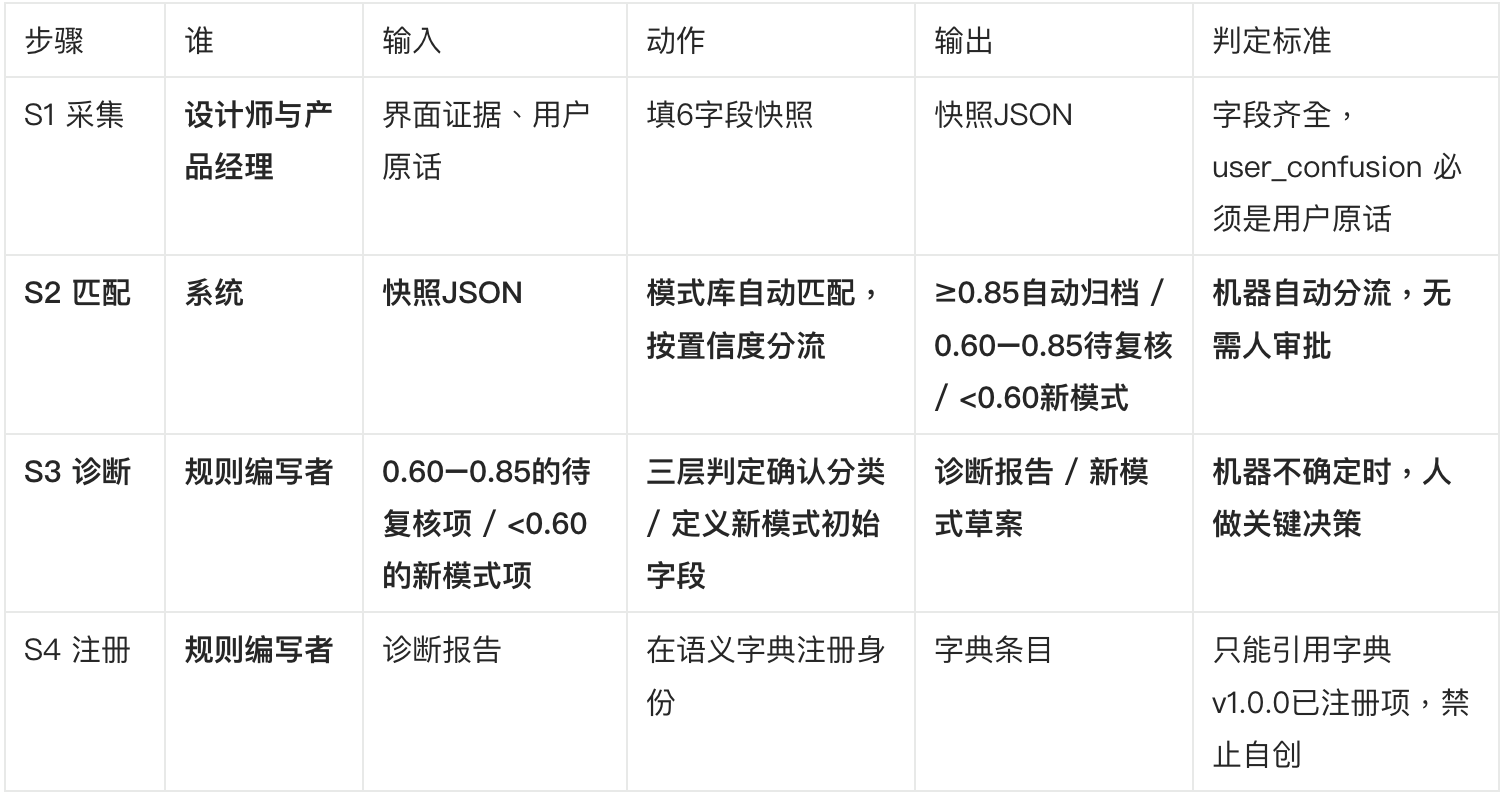
1.4 本环节交接单
这一环节最容易被低估的一句话:设计师与产品经理不需要懂任何YAML或语义理论,机器自动归档高置信度问题(≥0.85)。
门槛被刻意压到最低:会采集证据、会填表,就够。真正需要有人做语义判断的,只有两类情况,机器不确定时(由最熟悉这个场景语义的人确认分类),和机器没见过时(由最熟悉语义规范的人定义新模式)。其余时间,机器在自动归档。
需要在诊断报告上背书的,只有”机器不确定”的那一批。因为后面所有环节都建立在”这个分类是对的”之上,但高置信度的匹配,机器已经自动完成了。
设计师与产品经理提交的快照,如果 user_confusion 不是用户原话、visual_record 没有框出语义漂移区域,会在S2被打回重填。这个门槛不能降:地基不牢,契约会写偏。
二、核心环节:直觉怎么写成机器懂的规则(成长期)
2.1 一句话概括
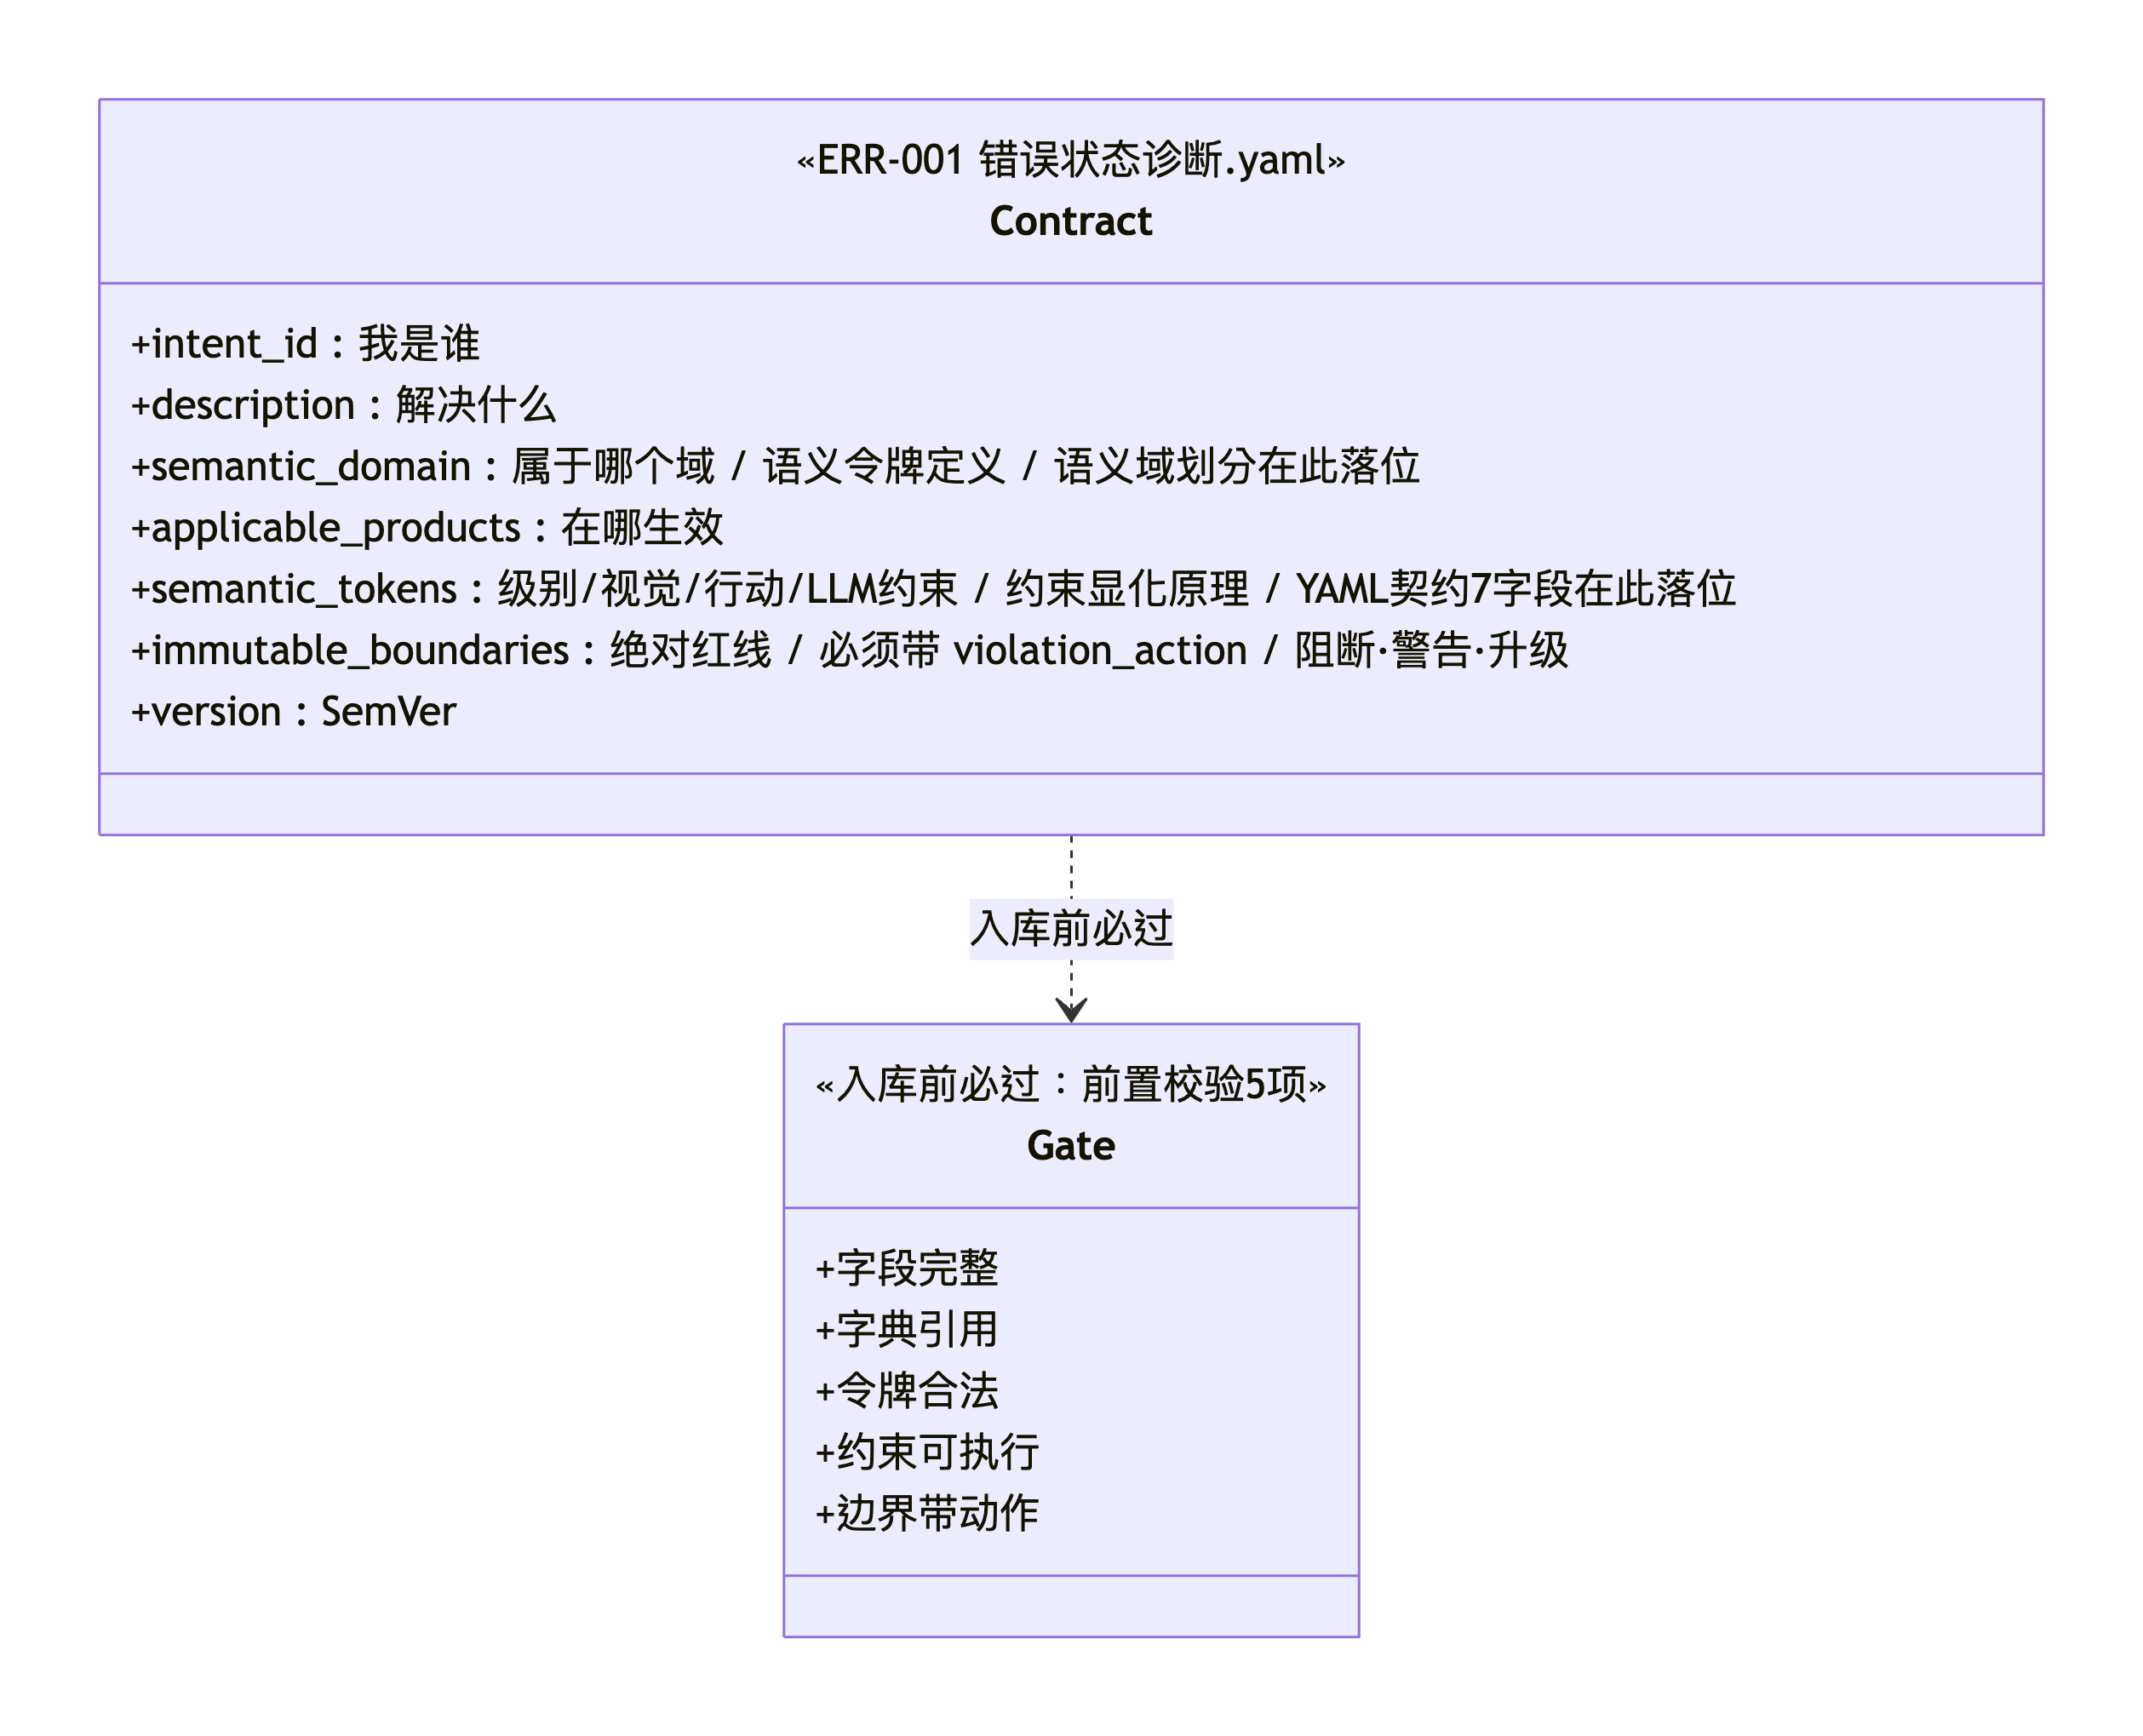
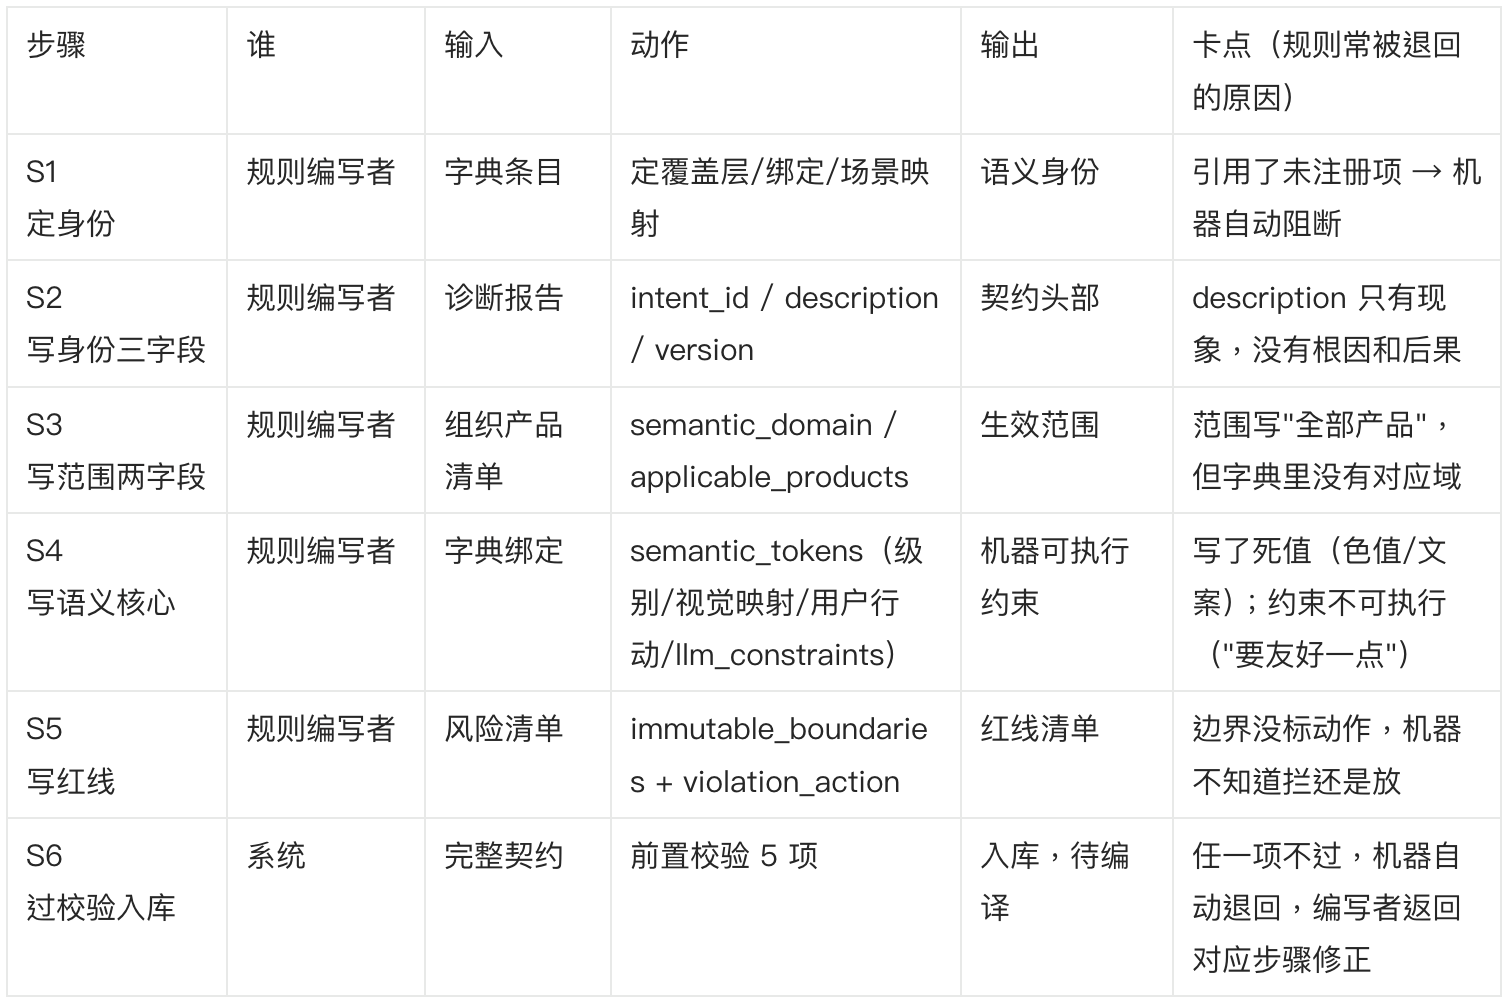
“规则要先上’户口’(语义身份)再长’身体’(YAML契约),7个冻结字段是底线,少一个,机器就不认。”
2.2 本环节脑图:一条契约的构成
2.3 步骤拆解表
2.4 本环节交接单
这一环节的核心认知:契约不是”写得更清楚的规范文档”,而是”机器会逐字段提问的代码”。
写契约时,就是在定义机器将来要问的问题:intent_id 回答”我是谁”,llm_constraints 回答”AI 必须做什么、禁止做什么”,immutable_boundaries 回答”什么情况下必须拦”。
S6的前置校验不是”人审”,是”机器守门”,机器按 schema 逐字段检查,不过就自动退回。提交者修正后重新提交,直到机器放行。入库现场不需要第二个人。
真正卡人的不是”会不会写YAML”,而是”能不能把’我觉得’翻译成’机器能查'”。这个翻译能力,不是某个岗位的专属,而是团队里对语义最熟悉的人自然沉淀出来的壁垒,前期可能是设计师在写,后期可能是前端在补,但当规则量上来、跨团队冲突变多,那个最懂语义规范的人,自然会成为规则的主要维护者。
三、分发环节:一份契约怎么变成 N 个团队的四种格式(分发期)
3.1 一句话概括
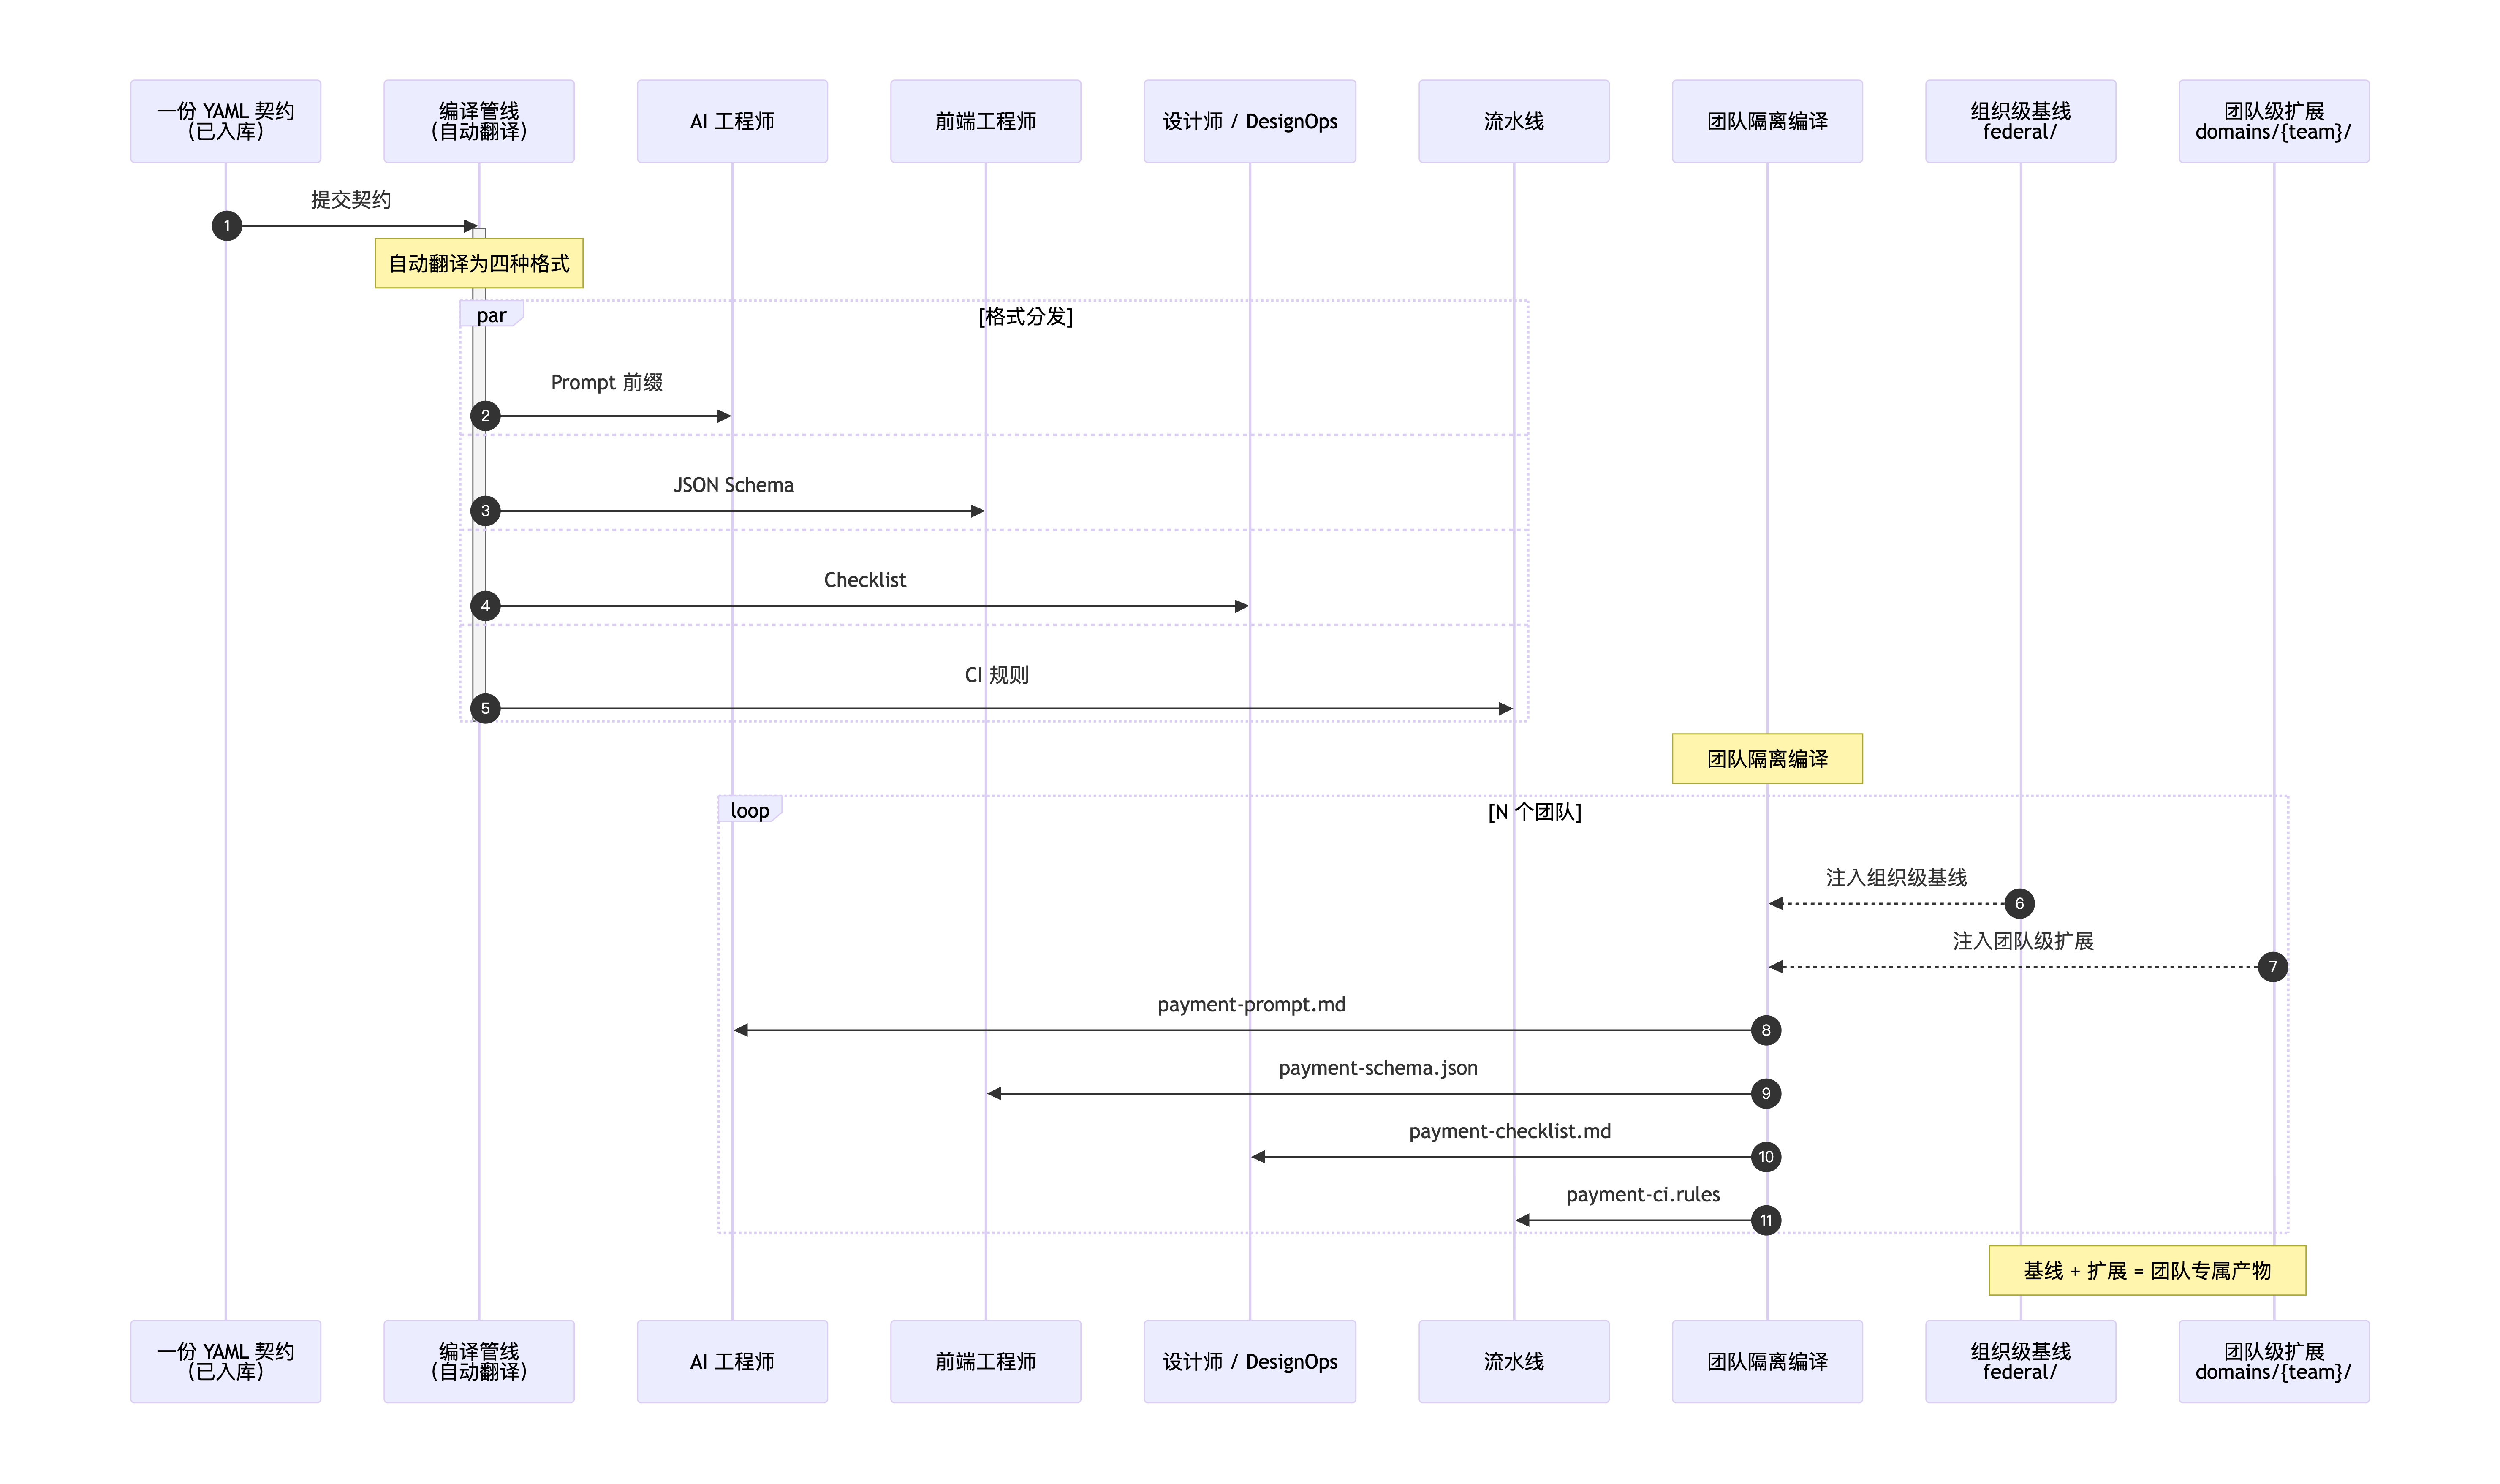
编译管线做一次翻译、两次分发,从一种语言到四种格式,从一份基线到N个团队隔离产物。
3.2 链路图
3.3 本环节交接单
这一环节,规则编写者不需要在场。
契约入库后,编译管线自动读取契约中定义的applicable_products(生效范围)和团队配置,自动合并组织级基线 + 团队级扩展,自动输出团队专属的四种格式。
分发策略在写契约时就已经确定好了,哪些产品生效、基线是什么、扩展是什么,都写在契约里。机器只是按契约的定义自动执行翻译和隔离。分发现场不需要人。
真正需要关注的不是”编译怎么实现”,而是”团队隔离”,支付团队的产物不能混入内部工具团队的产物,否则基线会被污染、扩展会冲突。编译管线的团队隔离机制,保证了”统一基线、各自扩展”的联邦自治结构在工程上可执行。
本环节实现状态:⚠️ 编译逻辑(YAML → 4格式)可通过GitHub Actions等CI工具实现;团队隔离(基线+扩展合并)逻辑已设计完成。但”自动分发到下游工具”需要额外的工具链集成(Slack/邮件/IDE 插件/Webhook)。
四、生效环节:规则怎么在生成现场拦下违规(生效期)
4.1 一句话概括
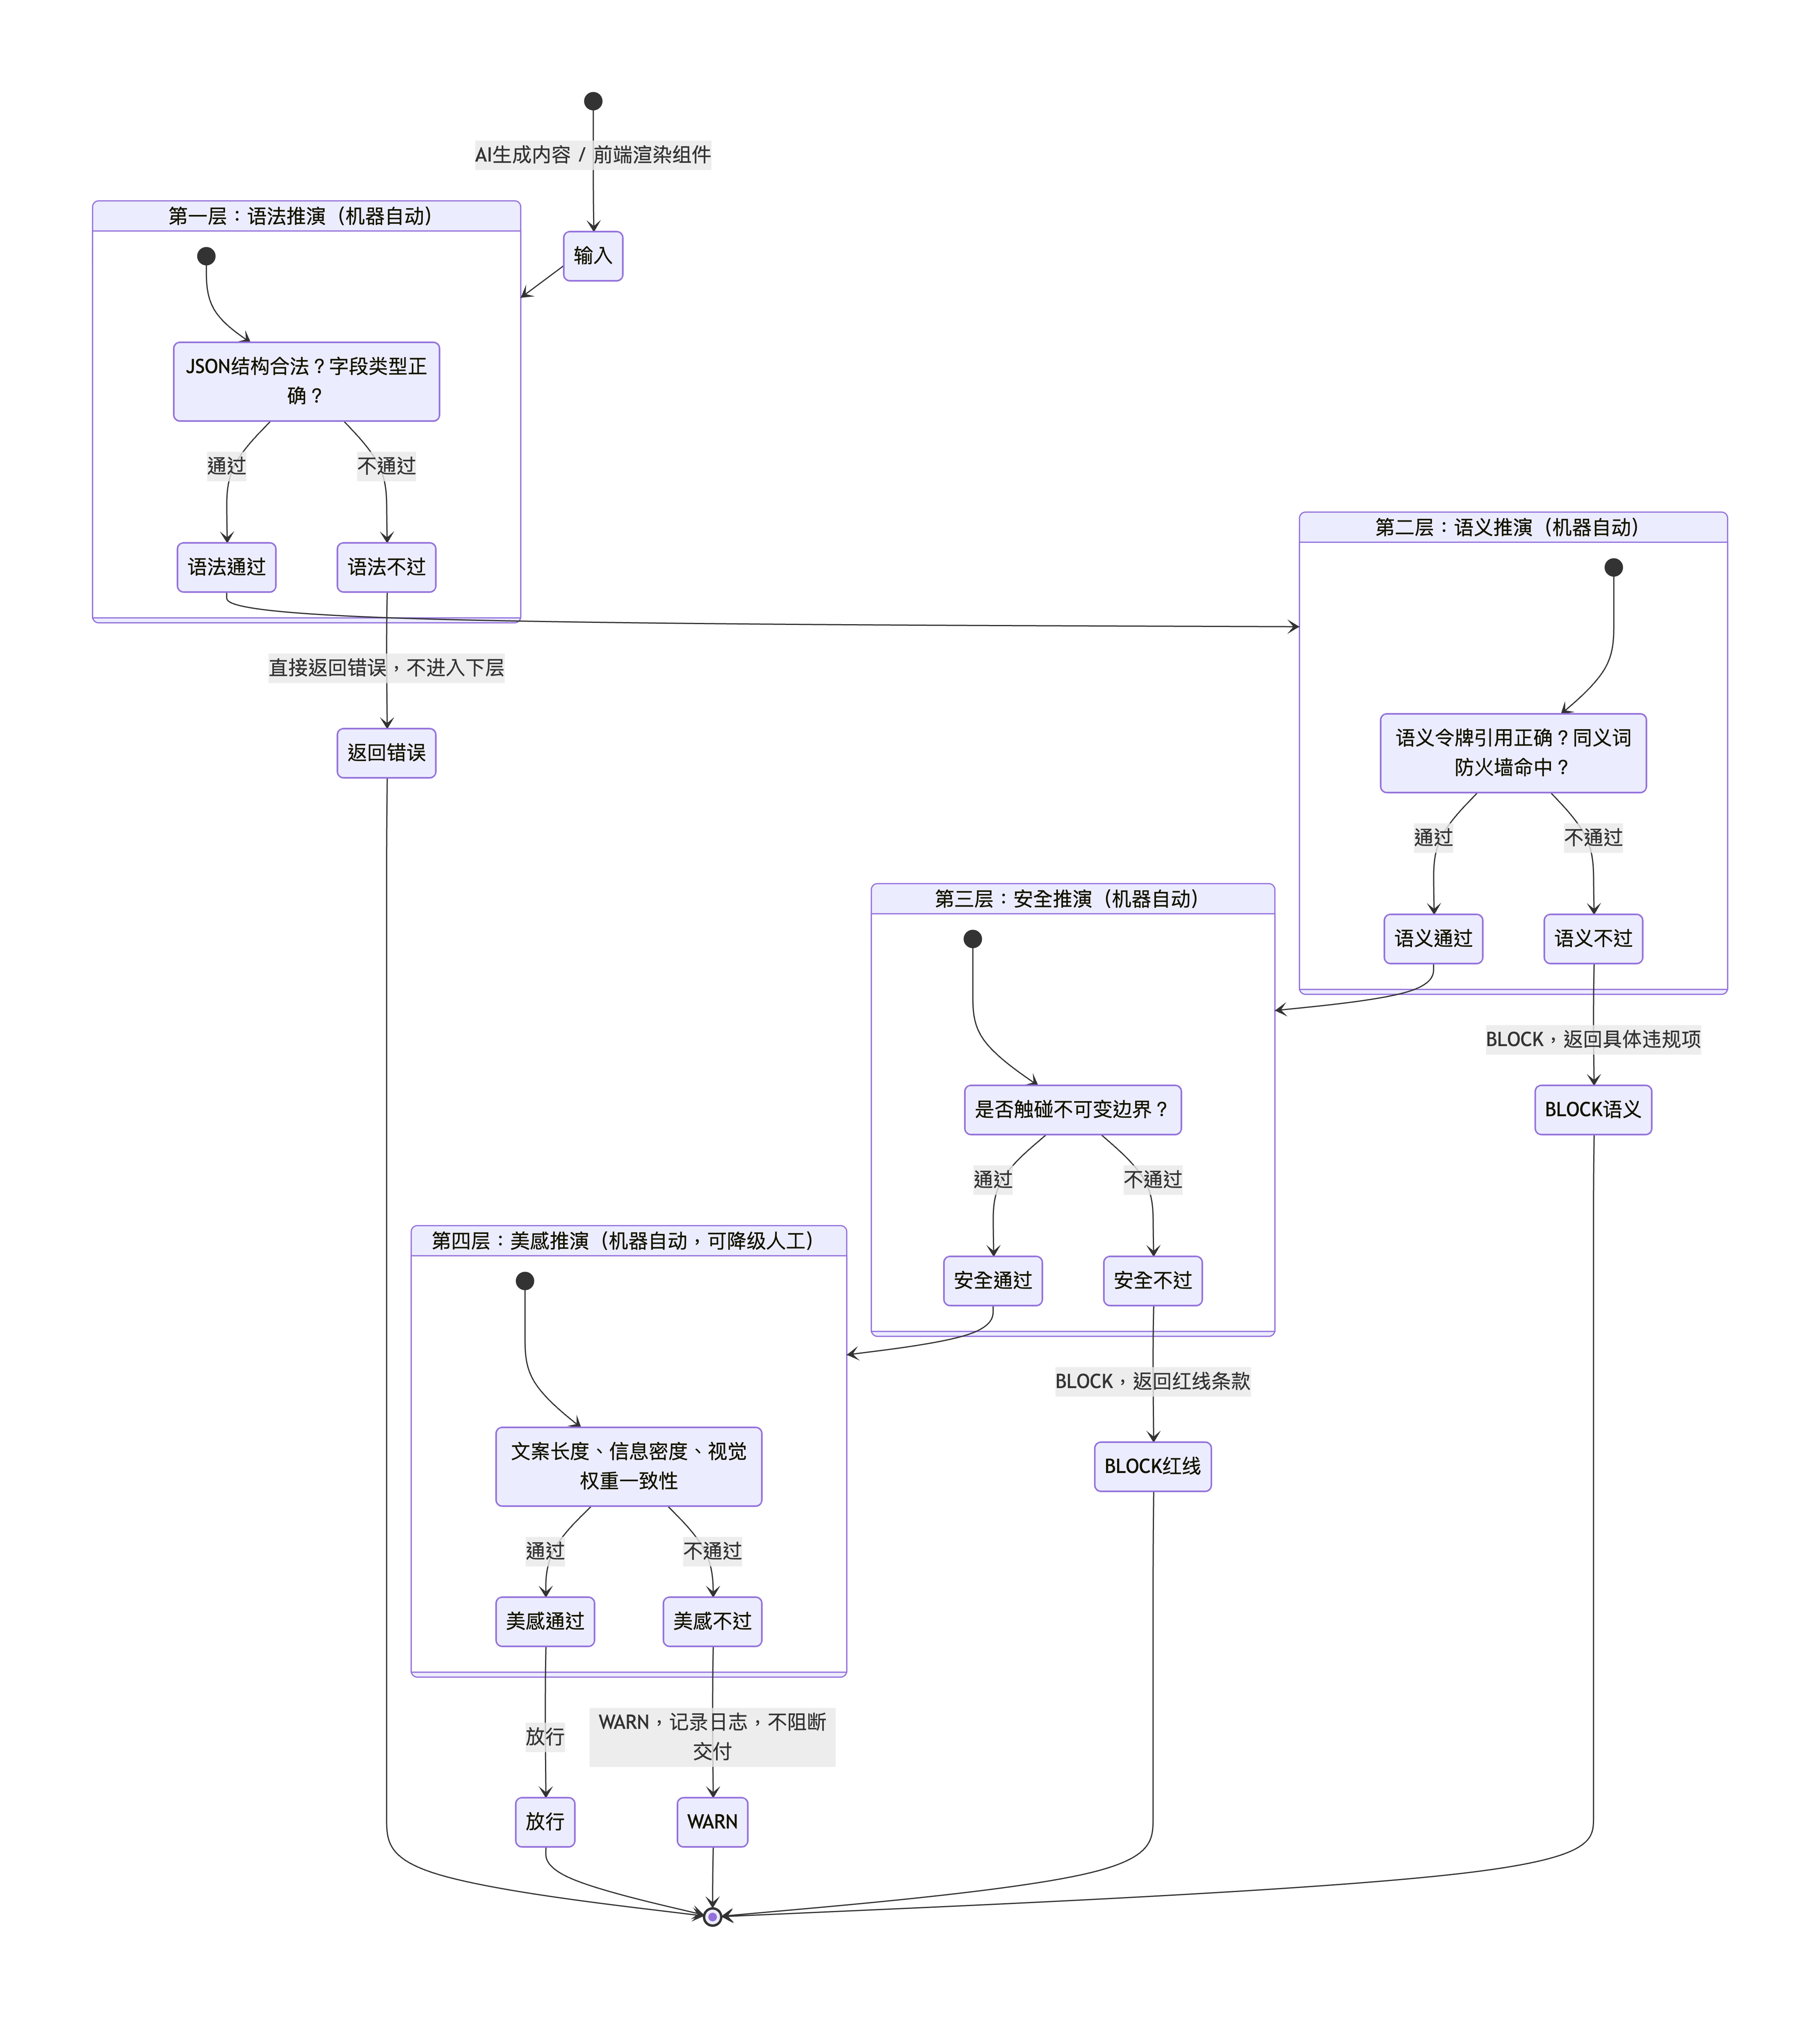
规则不再是文档,而是嵌在执行链路里的裁判,四层推演、层间短路、该拦的拦、该放的放。
4.2 四层推演的决策树
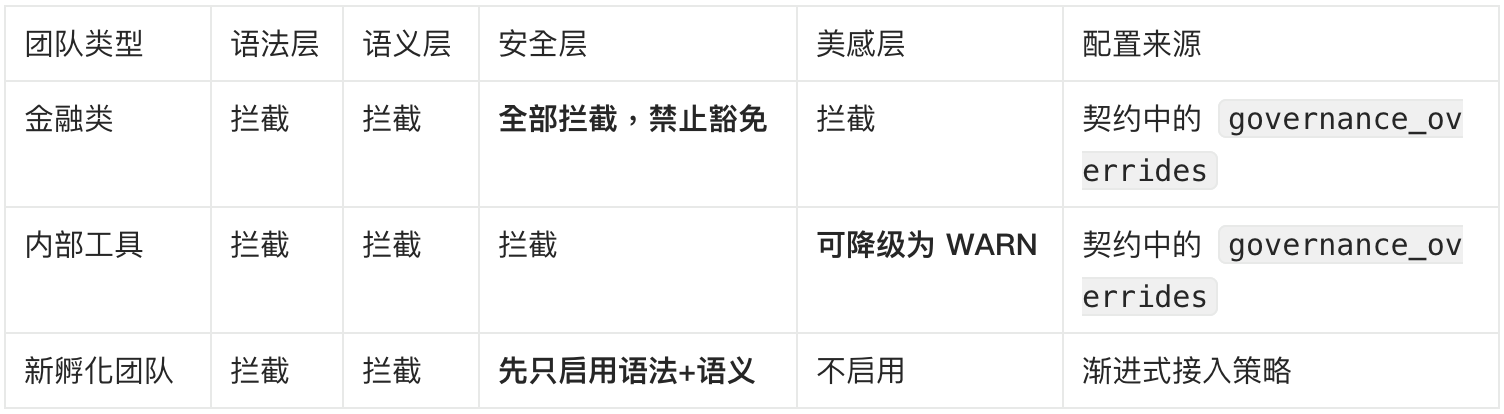
4.3 团队差异化配置表
4.4 本环节交接单
这一环节不需要人工介入,机器自动拦截。
Runtime嵌在前端渲染链路或AI生成链路里,自动读取契约中已写入的不可变边界和团队差异化策略,自动执行四层推演。
拦什么、放什么、拦完给什么建议,策略全部来自契约本身的定义。这些红线(拦截/警告/升级)和团队差异化配置,在契约编写阶段就已定义清楚,机器在运行时按预设规则自动执行。
生效现场不需要人工值守。人只在”机器拦下后需要人工复核”的例外场景出现。
真正需要提前想清楚的是”团队差异化”,不同业务对风险的容忍度不同,这个差异不能靠口头约定,必须写入契约,让机器自动执行。
五、验证环节:怎么证明规则真的有用(验证期)
5.1 一句话概括
三层证明,从”被消费了吗”到”拦得准吗”到”省钱了吗”,一层比一层接近决策。
5.2 三层证明的结构图
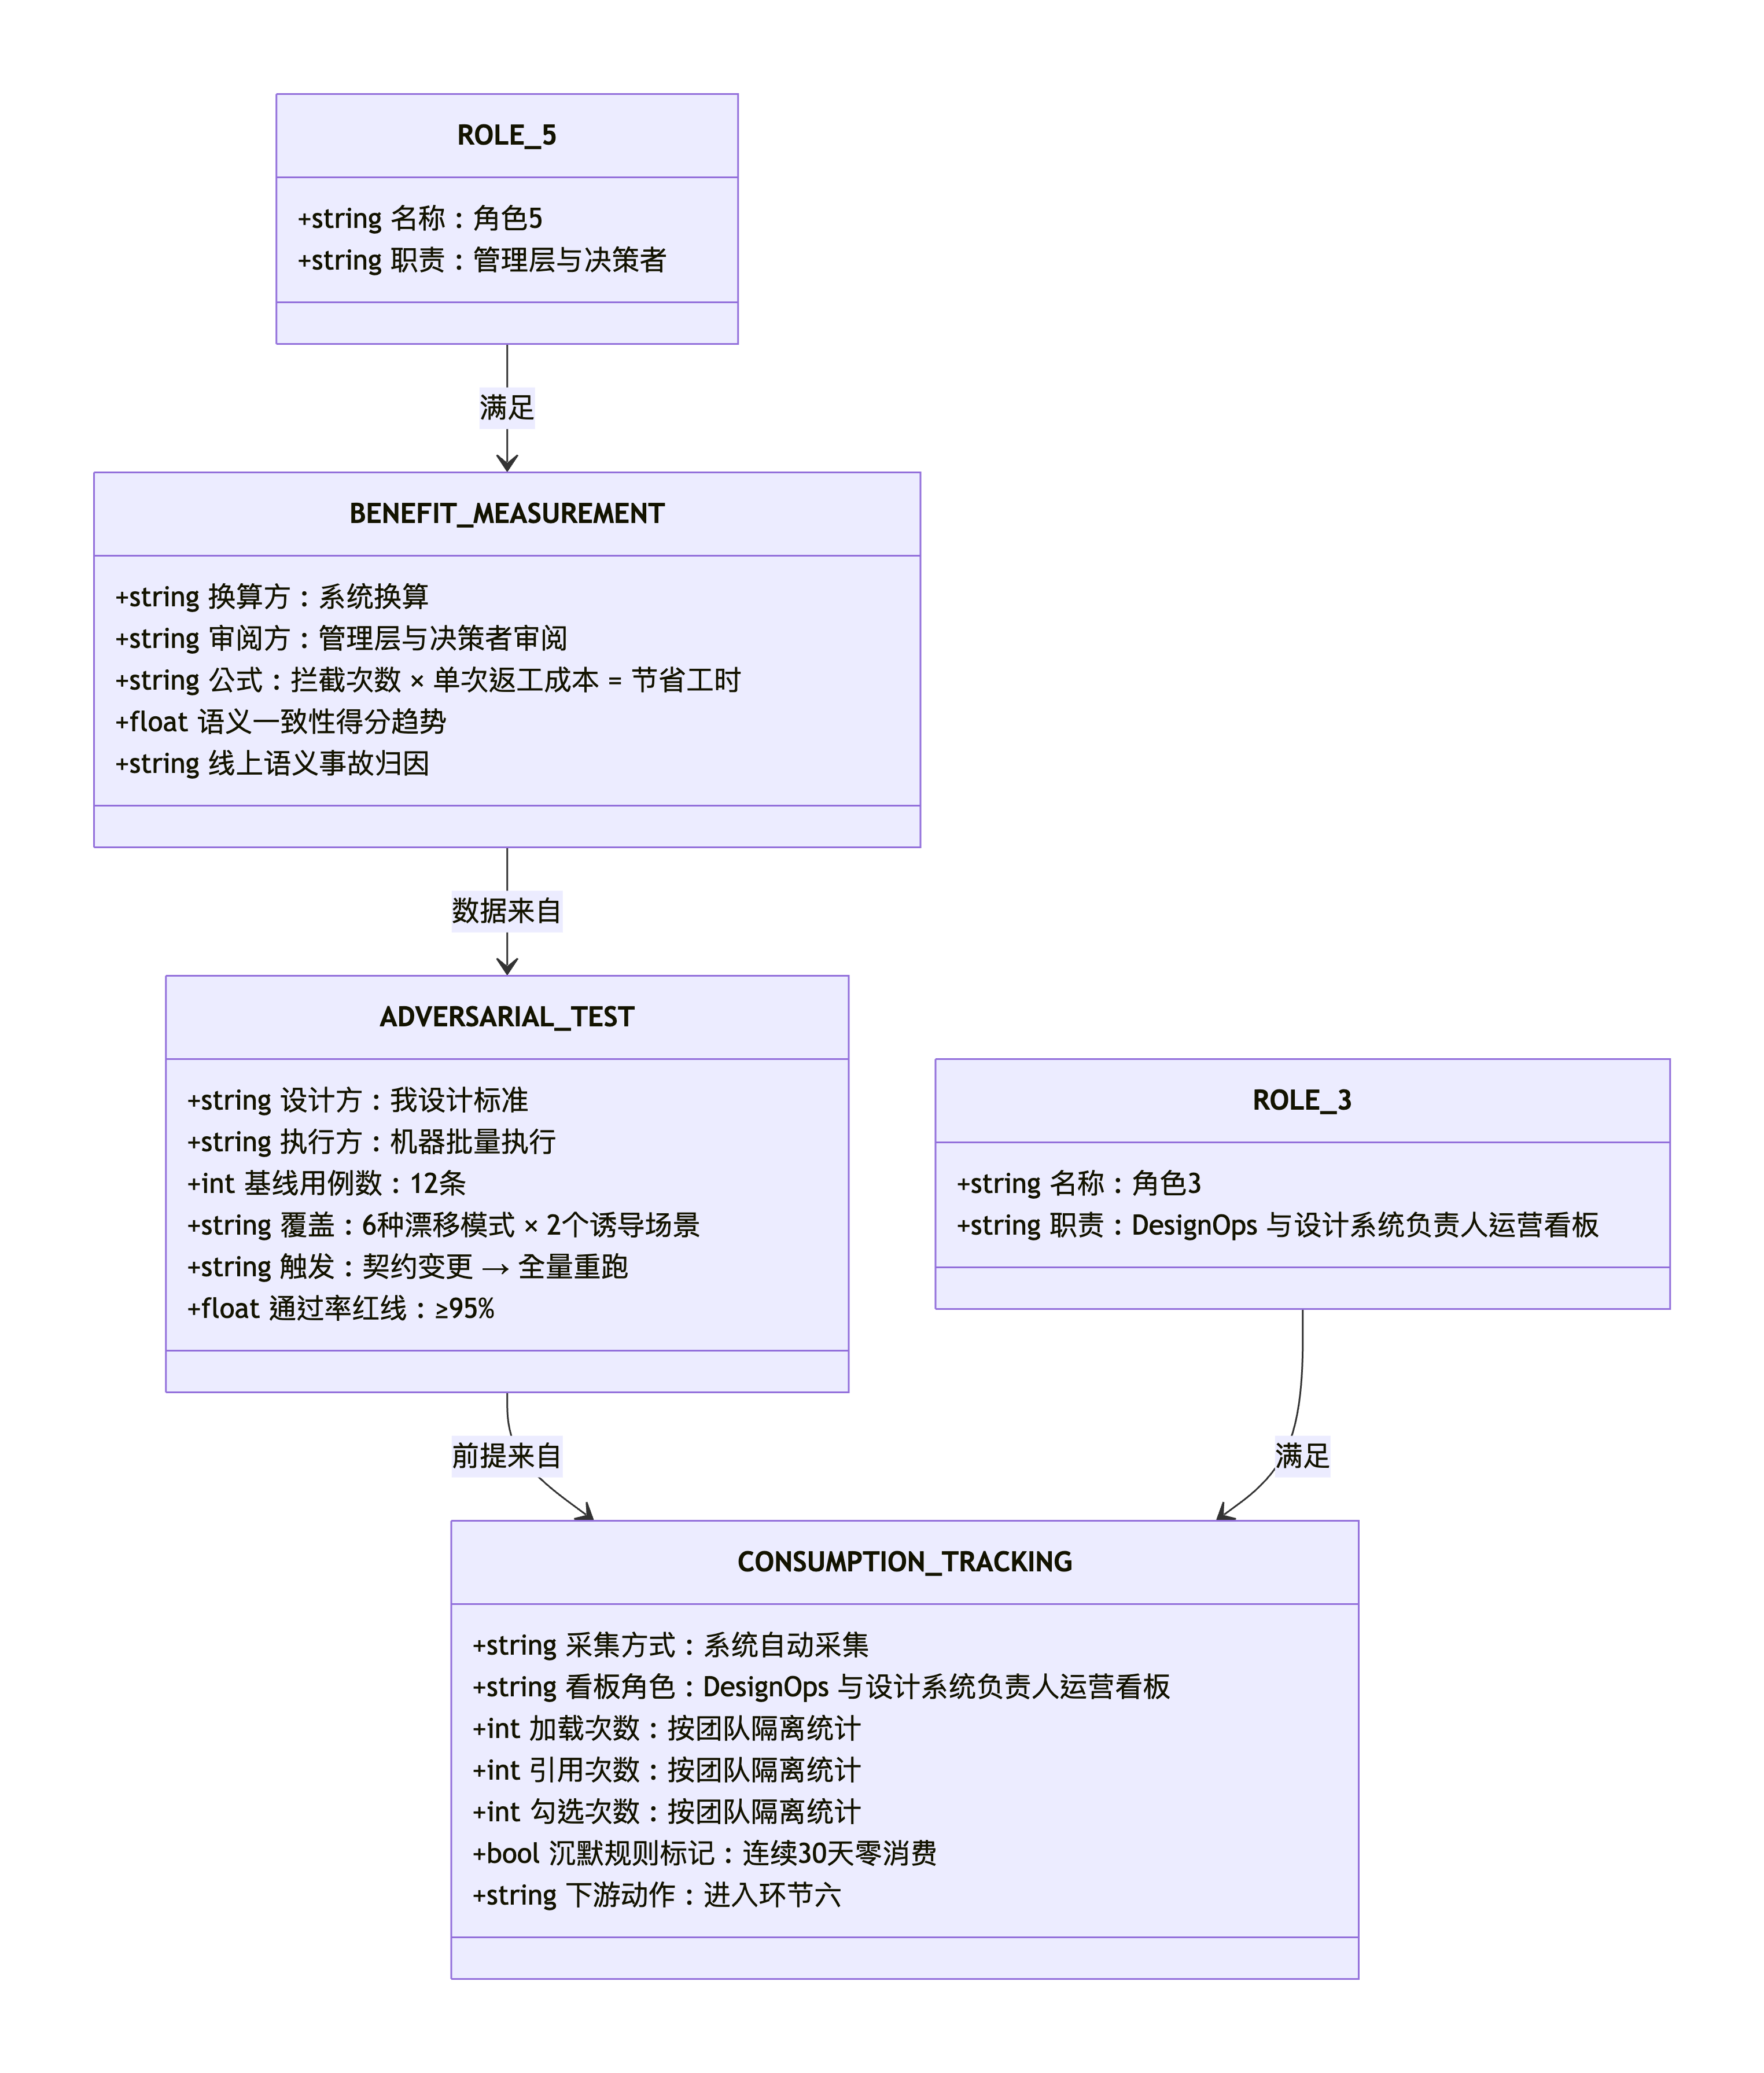
三层是递进关系:没被消费的规则谈不上拦截,拦不准的规则谈不上收益。任何一层塌掉,上面的层都是空中楼阁。
5.3 三层证明对照表
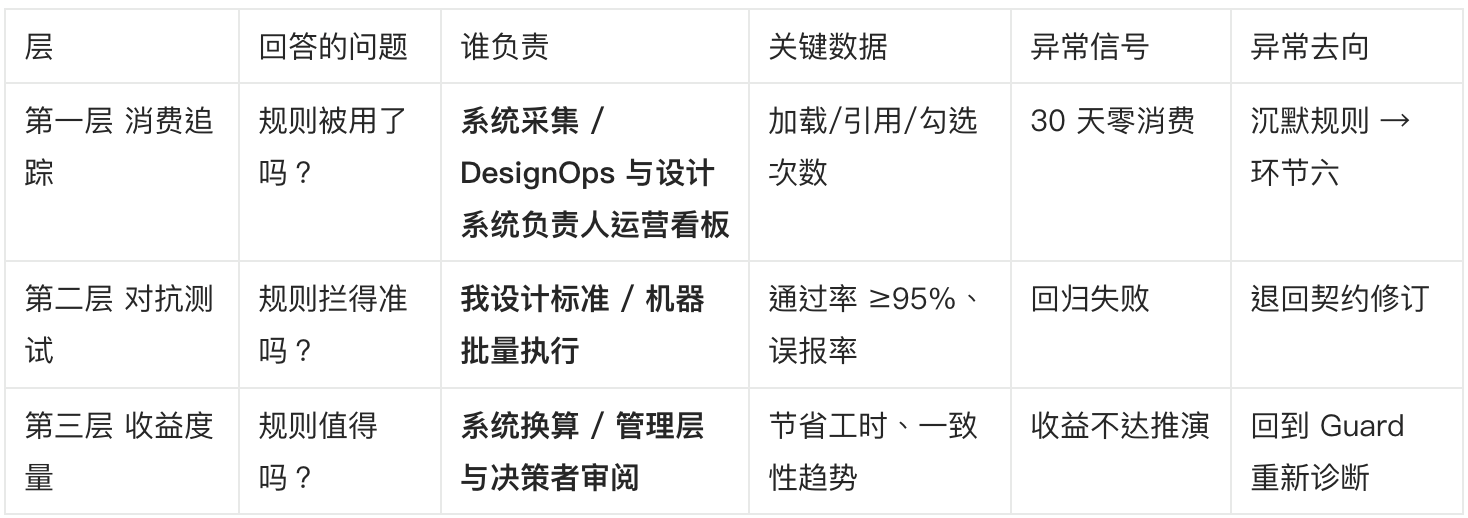
5.4 本环节交接单
第一层“被消费了吗”由机器自动采集、DesignOps与设计系统负责人 运营看板呈现,不需要谁手动统计。
第二层“拦得准吗”需要有人定义验证标准(对抗用例集),机器批量执行,不需要逐条人工测试。
第三层“省钱了吗”由系统按返工成本模型自动换算,管理层与决策者 审阅,不需要做规则的人算财务账。
验证环节真正需要人“在场”的,只有“设计对抗用例标准”这一个动作。其余是机器跑数据、DesignOps 与设计系统负责人 运营、管理层与决策者 决策。
真正需要提前设计的是“对抗用例集”,正向用例(符合契约的输入,机器应放行)和负向用例(违反契约的输入,机器应拦截)。这组用例是规则有效性的“证据链”,也是契约变更后的“回归测试基线”。
本环节实现状态:⚠️ 对抗用例集(12条基线)已设计完成,契约变更后全量重跑可通过CI流水线实现。❌消费追踪(Prompt前缀加载次数、JSON Schema引用次数、Checklist使用次数)需要下游工具(Cursor/Figma/ESLint)主动上报消费数据,目前无此基础设施,需手工统计替代。收益度量(返工成本换算)为数据模型推演口径,待生产环境实测校准。
六、收尾环节:数据怎么决定规则的下一次生命(迭代期与退役期)
6.1 一句话概括
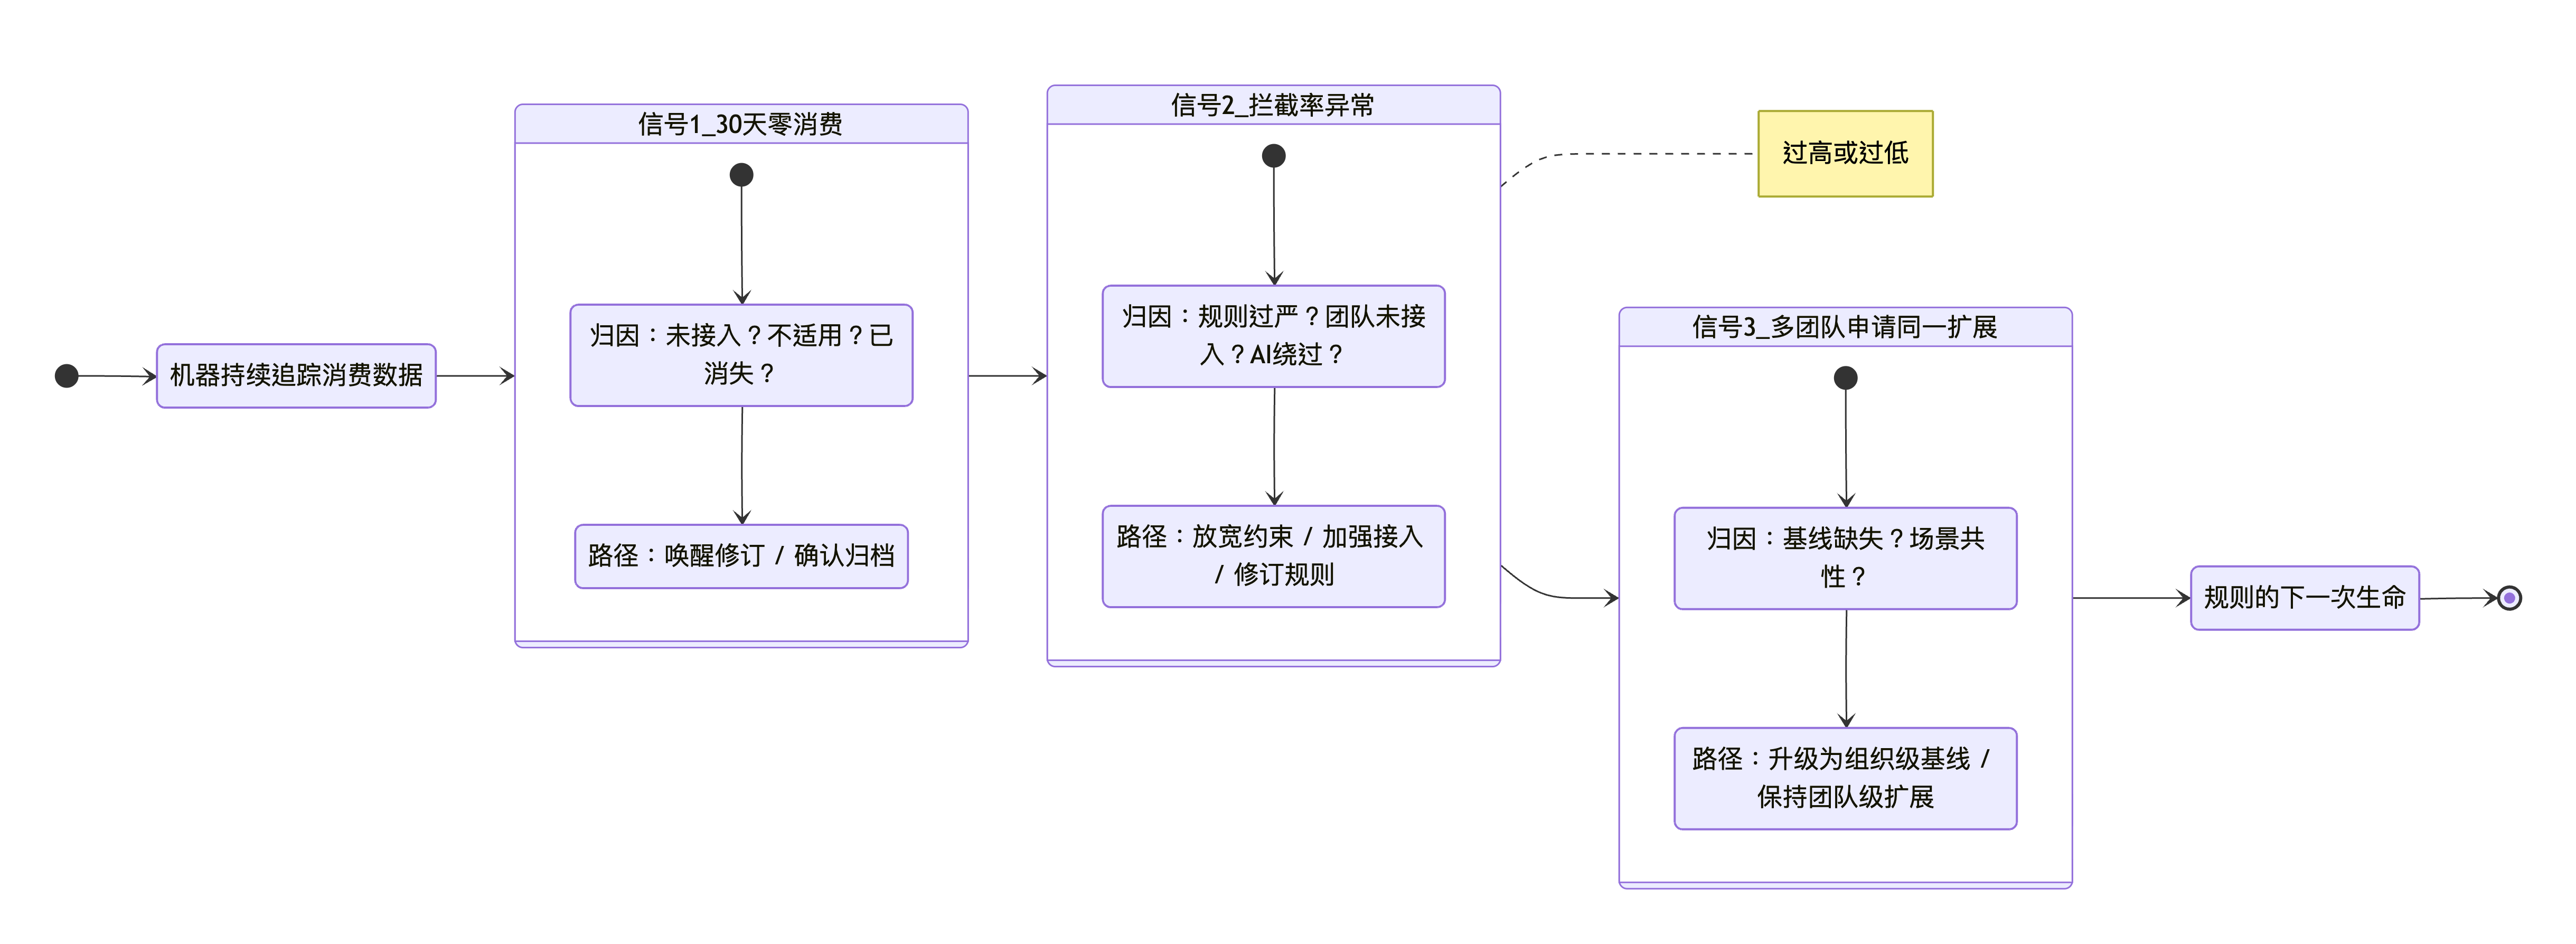
规则不会自动老去,机器发出信号,最熟悉这条规则的人在关键决策点做归因…
6.2 信号 → 归因 → 路径 的全景脑图
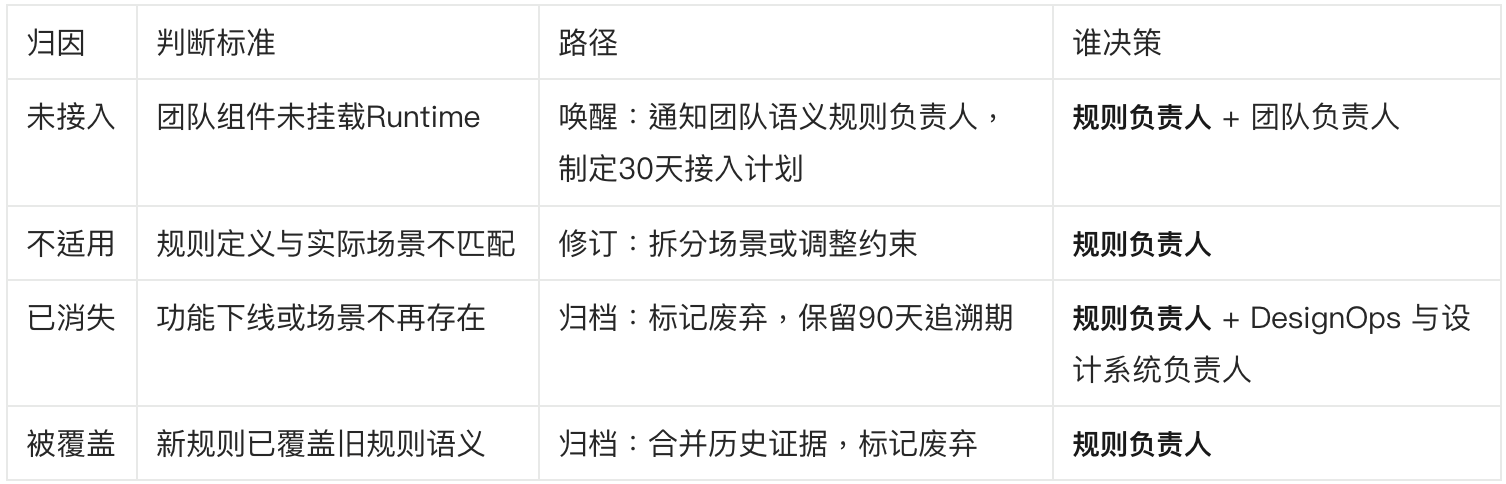
6.3 沉默规则的处理决策表
“规则负责人”不是固定岗位,而是”对这条规则最熟悉的人”,可能是当初写这条规则的设计师,可能是现在负责这个业务的产品经理,也可能是团队里自然沉淀语义经验的同事。关键是”谁最懂”,不是”谁专职”。
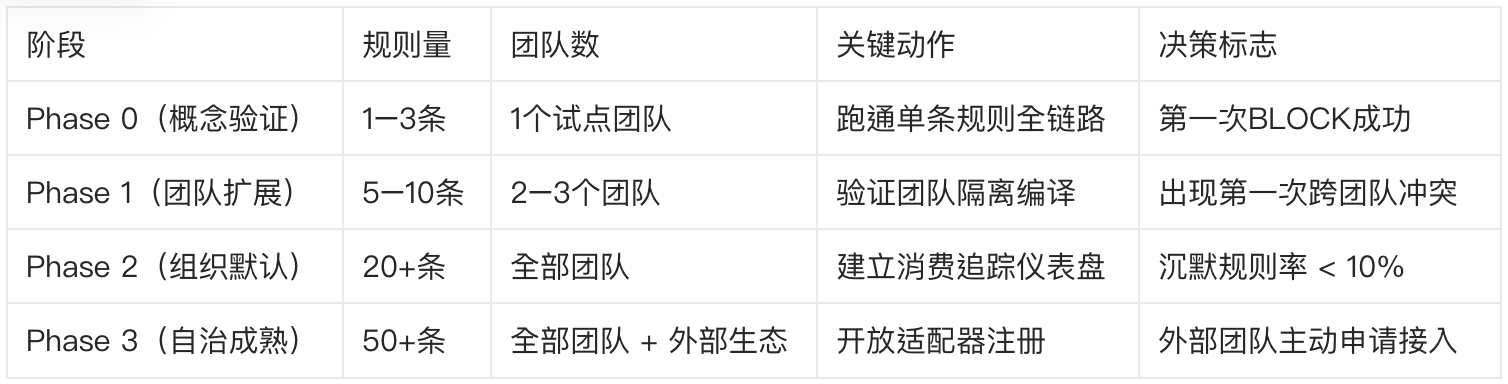
6.4 推广节奏表
6.5 本环节交接单
机器负责持续追踪消费数据,自动标记异常信号(30天零消费、拦截率异常、多团队扩展申请汇聚)。
规则负责人(不一定是专职,通常是最熟悉这条规则的人,可能是当初写它的设计师、现在负责这个业务的产品经理、或团队里沉淀语义规范的同事)在机器发信号后做关键决策:
● 沉默规则是”未接入””不适用”还是”已消失”?
● 归因后走哪条路径(唤醒 / 修订 / 归档)?
迭代期不是人盯着数据看,是机器看数据,人看到信号后决策。真正需要避免的是”规则写了没人管”,沉默规则如果不处理,会占用维护成本、污染字典、让团队对规则体系失去信任。机器发信号,是为了防止”人遗忘”。
七、全链路总收:六张交接单串起的一生
把六个环节的交接单首尾相接,整条链路就闭合了:
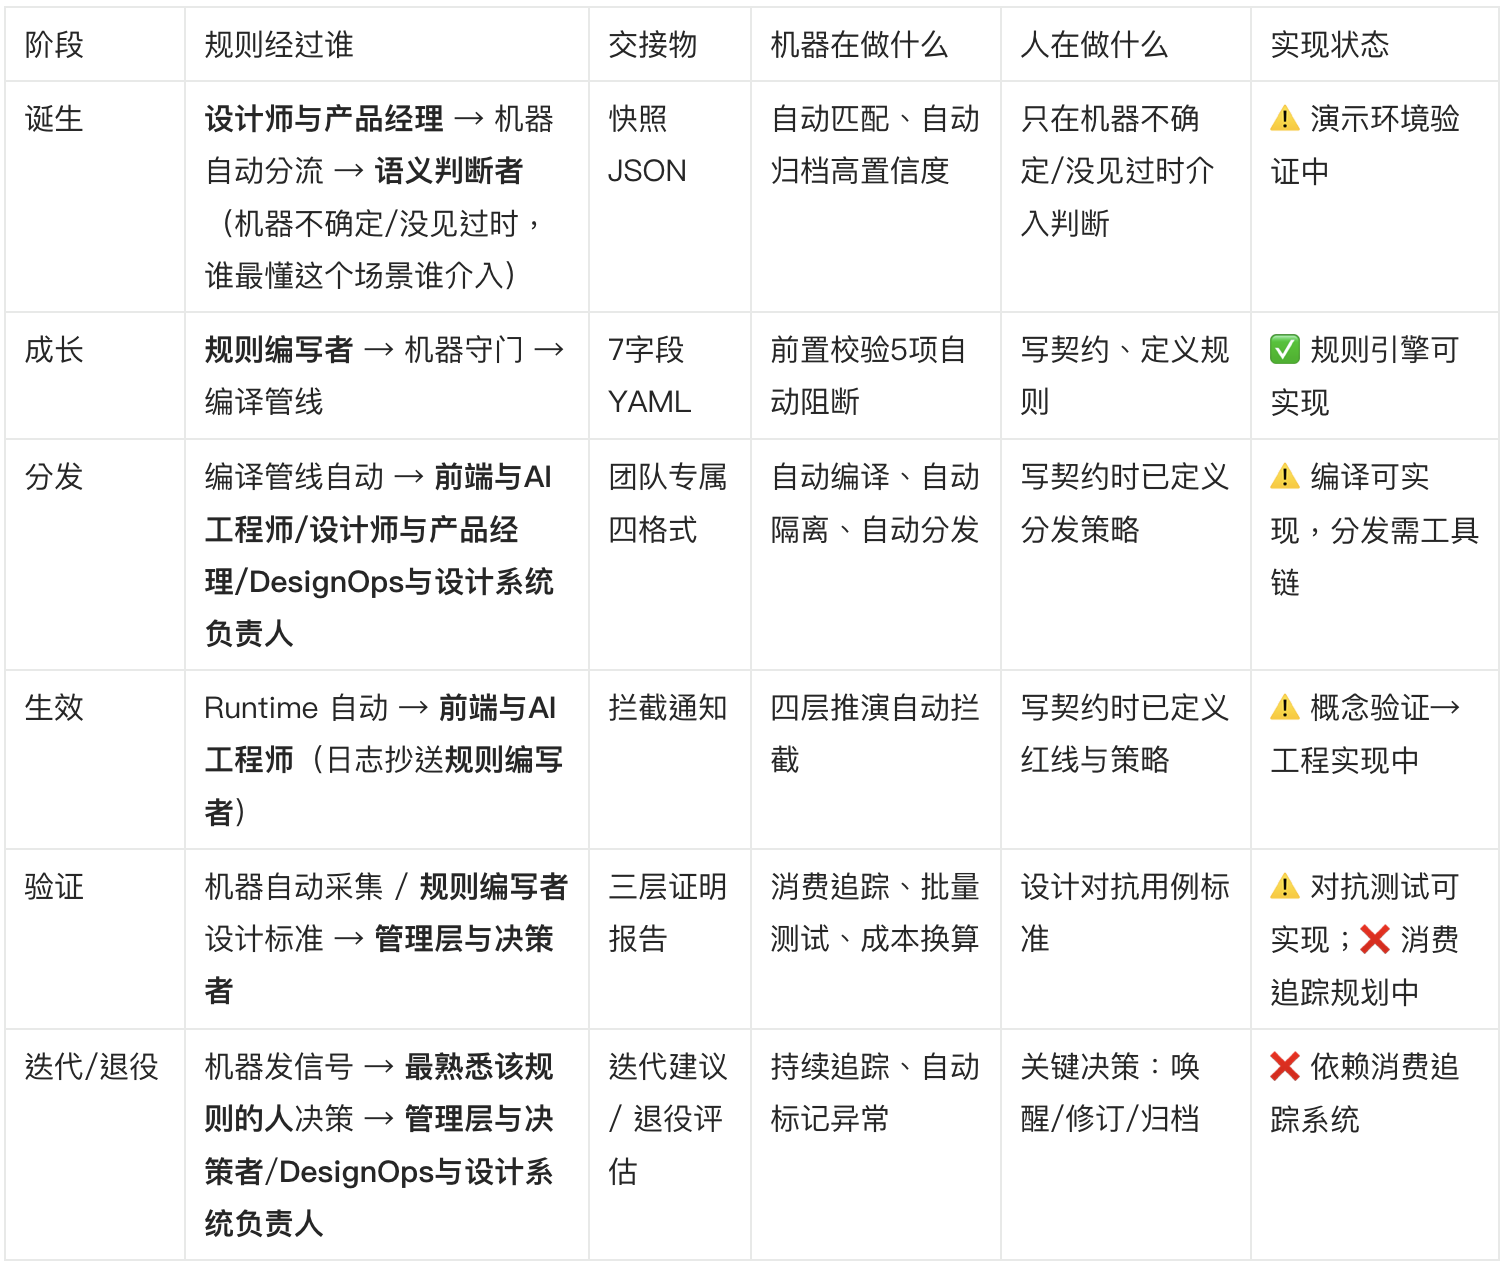
图例:✅ 已实现 / 规则引擎可确定性实现 · ⚠️ 演示验证中 / 需工具链配合 / 准确率有缺口 · ❌ 规划中 / 依赖前置系统
诚实口径声明:本文描述的”机器自动”链路,是 Schema-As-Code 框架的目标态架构。当前实际进度:模式匹配(演示环境验证)、编译前置校验(规则引擎可实现)、四层推演拦截(概念验证)、消费追踪(规划中)。各环节成熟度差异显著,实施时应按”先成长、后分发、再生效、最后验证迭代”的顺序渐进推进。
在这个链路里,人不是”人肉审查员”,而是”规则定义者”。
翻译发生在规则被写下的那一刻,把”人懂的直觉”翻译成”机器读的规则”。一旦契约进入编译管线,机器就在自动执行:自动归档、自动校验、自动编译、自动拦截、自动追踪、自动标记。
人在整条链路上的“在场”,被压缩到三个关键决策点:
- 机器不确定时(诞生期:0.60–0.85 的复核)
- 机器没见过时(诞生期:新模式的初始定义)
- 机器发信号时(迭代期:沉默规则唤醒、归因决策)
其余时间,机器在跑。翻译不断,语义就不会在传递中丢失,因为翻译发生在规则定义时,不是每次执行时。
这就是语义翻译这个能力在整条链路上的位置:人在关键决策点定义规则,机器在执行链路自动运行。
附录:口径溯源
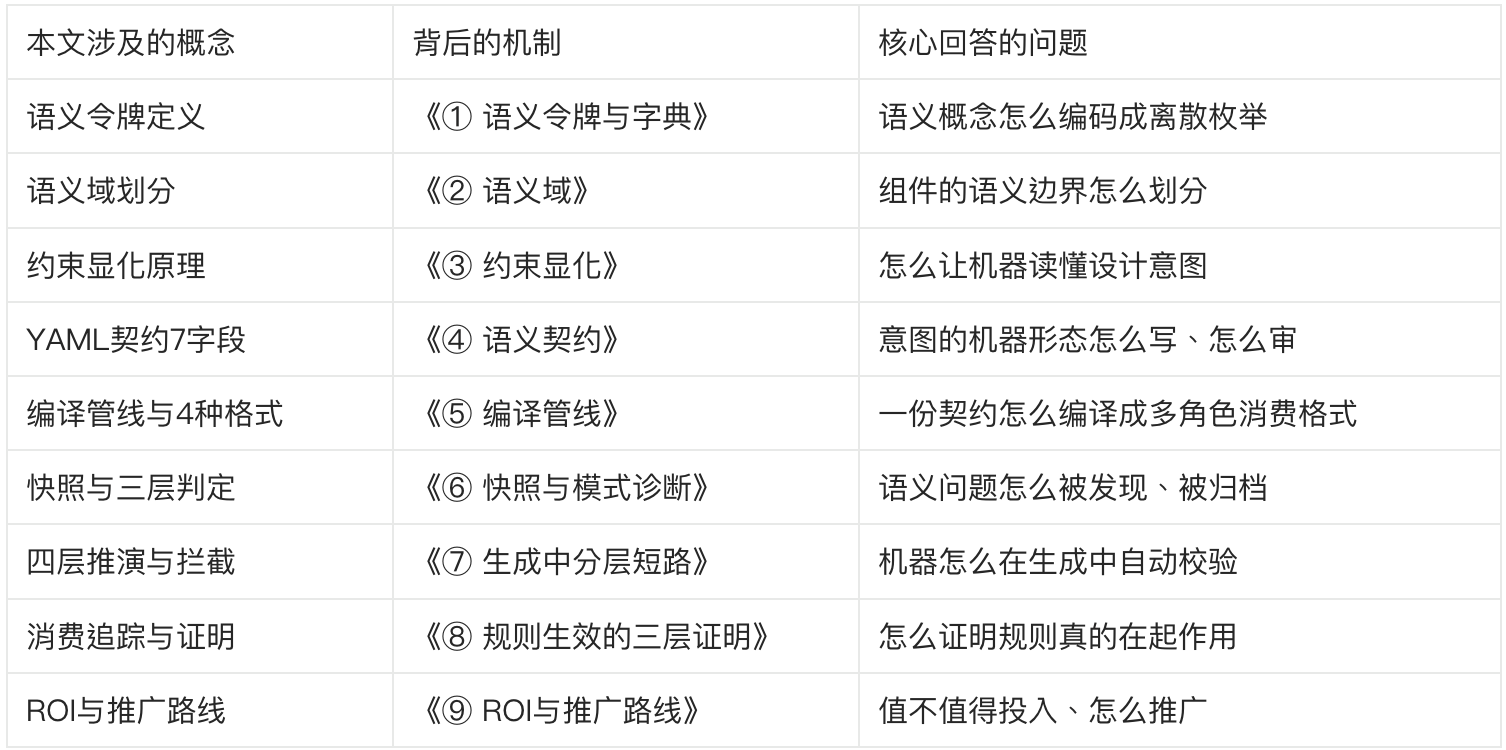
本文涉及的每一个操作判断、字段定义、检查逻辑,都有明确的方法论出处。
如果你想知道”为什么必须这样做”,以下是对应关系:
本文由 @阿基拉de_Akir 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!