起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
为什么大模型跑分很高,到了真实业务却不好用


为什么模型在 Benchmark 上表现优异,上线后却差评如潮?本文深入解析 Benchmark 的运作机制与 SOTA 的真实含义,揭示高分模型在真实业务中可能“水土不服”的三大原因,并给出产品经理科学使用 Benchmark 的实用建议,帮你避开选型陷阱。
我们常常会遇到这样的场景:AI产品根据各个 Benchmark 榜单上的成绩选出一个表现领先的模型,项目推进得很顺利,产品也成功上线。
正当PM信心满满地等待用户好评时,差评却如潮水般涌来:答非所问、流程卡住、遇到模糊表达就无法处理。
为什么在榜单上表现优秀的模型,到了真实业务中却可能不好用?
因为我们平时所说的 SOTA,本质上是模型在某套 Benchmark 中取得的成绩。想判断这份成绩能不能代表真实业务,就必须先弄清楚 Benchmark 考了什么,以及 SOTA 究竟意味着什么。
一、Benchmark 是什么
Benchmark 可以理解为给模型准备的一套标准化考试。不同模型完成相同或等价的任务,再按照相对统一的规则接受评分,得到的结果才具有一定的可比性。
一套 Benchmark 通常会包含以下内容:
- 评测任务或数据: 也就是模型需要完成的题目。例如,MMLU 主要考查多学科知识和推理能力,HumanEval 主要考查根据要求生成 Python 代码的能力。
- 输入输出要求: 规定模型会收到什么内容,以及需要按照什么形式作答。
- 评测方式和评分指标: 相当于考试中的判卷方法和评分标准,用来判断模型完成了多少题、最终表现如何。
- 参考答案或评测工具: 部分 Benchmark 还会提供参考答案、测试用例或专门的评测程序,但并不是所有 Benchmark 都存在唯一的标准答案。
为了方便理解,我们可以把 Benchmark 粗略分成两类:一类是通用 Benchmark,用来考查模型在多种任务上的能力;另一类是垂直 Benchmark,主要考查某一类能力,例如代码生成、数学推理或者医疗问答。
只看这些定义可能还是有些抽象。接下来,我们以 HumanEval 为例,看看一套 Benchmark 具体是怎样运行的。
二、用 HumanEval 看懂 Benchmark 怎样运行
HumanEval 是一个用来评测模型代码生成能力的 Benchmark。它准备了许多编程题,让不同模型在相同条件下作答,再通过预先设置的测试规则判断答案是否正确。
例如,其中一道题可能要求:
请写一个函数:输入一个数字,如果它是负数就返回原值,如果是正数就返回 0。
在计算机中,这道题会被保存成类似下面这样的结构。不需要看懂代码,这里展示它只是为了让我们更直观地理解一道 Benchmark 题目中包含哪些内容:
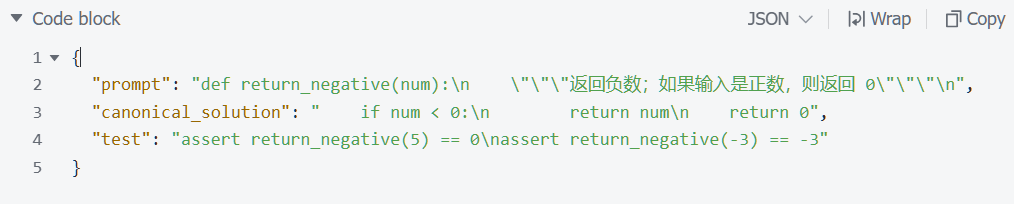
这不是 HumanEval 的完整原始数据,而是为了方便理解而删减过的示意内容。我们只需要关注其中三个部分:
- prompt: 给模型的题目。在这个例子中,它包含函数名称和功能要求,但没有把函数写完。
- canonical_solution: 出题人准备的一种正确写法,可以理解为参考答案。编程题可能有多种正确写法,所以它不是唯一答案。
- test: 自动判卷时使用的测试规则。它会分别输入正数和负数,检查最终的函数能否返回正确结果。
正式评测时,模型只会收到题目 prompt;模型生成答案后,评测程序会把题目和答案拼在一起,再交给测试代码判卷。
如果拼接后的代码面对不同输入都能得到预期结果,这道题就算通过;如果运行出错或者返回错误结果,这道题就算失败。
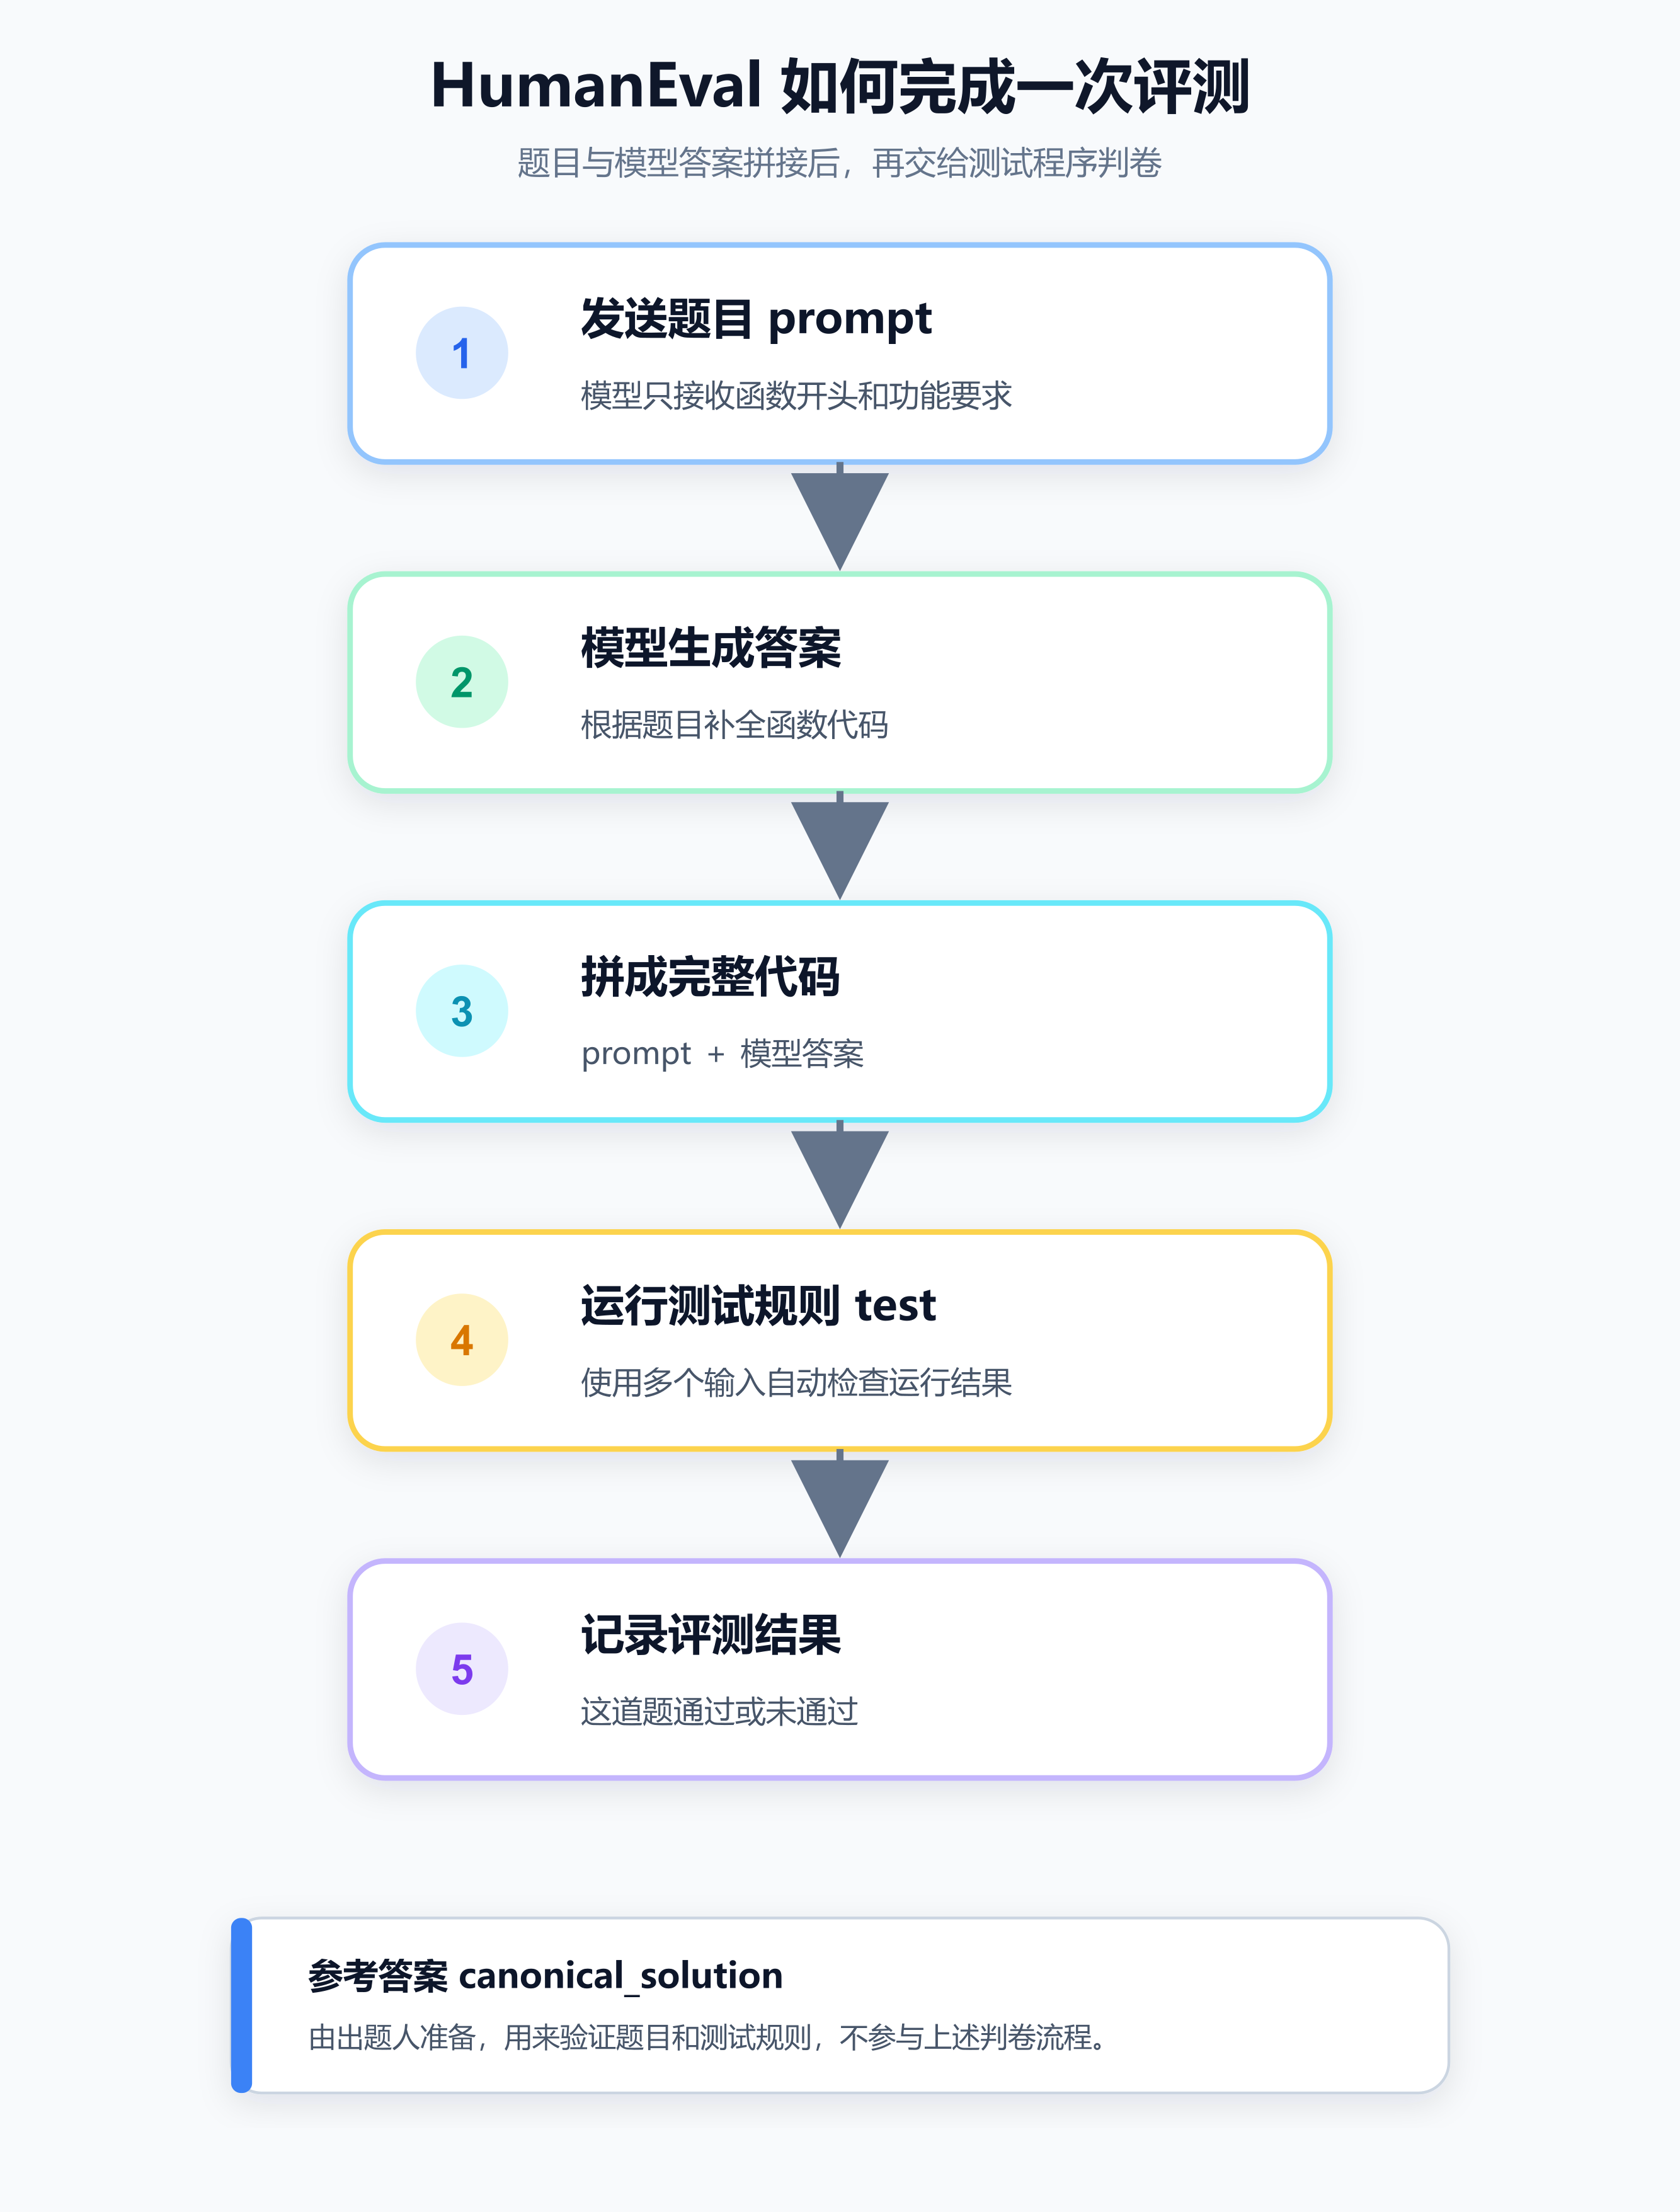
这里最重要的一点是:评测程序不会比较模型答案与 canonical_solution 是否一模一样,而是看拼接后的完整代码能不能通过测试。
这就是 HumanEval 能够自动判卷的原因,也是 Benchmark 能够比较不同模型的基础:题目相同、判卷规则相同,最终结果才具有一定的可比性。
三、SOTA 到底是什么
理解了 Benchmark 怎样运行,SOTA 就不难理解了。
SOTA 是 State of the Art 的缩写,通常指某个模型在特定 Benchmark、评测指标和测试条件下取得的当前最佳结果。
如果把 Benchmark 看作一场考试,那么 SOTA 就是这场考试目前的最高成绩,取得这个成绩的模型就是该项评测中的领先者。
但它只代表模型在这场考试中的表现,不代表它在所有能力上都是第一名。因此,我们平时所说的“SOTA 模型”,更准确的表达应该是“在某项 Benchmark 上取得 SOTA 的模型”。
四、为什么需要 Benchmark
既然一套 Benchmark 只能考查模型的部分能力,我们为什么还需要它?
模型训练完成以后,到底好不好?如果没有相对统一的评测标准,每个开发者都可能觉得自己的模型最强,不同公司的模型能力也很难直接比较。
Benchmark 的作用,就是把不同模型放到相对统一的任务和规则下进行测试。它可以帮助开发者了解模型擅长什么、在哪些地方还有不足,也可以帮助企业快速完成候选模型的初步筛选。
模型团队还可以通过多次评测,观察模型迭代后是否真的有所提升。也就是说,Benchmark 不仅是一张排行榜,还是衡量模型能力变化的一把尺子。
但这里有一个很重要的词:初步。Benchmark 解决了“怎样相对公平地比较模型”的问题,却没有完全解决另一个问题:考试成绩能不能代表模型在真实业务中的表现?
五、为什么 Benchmark 高分不等于业务好用
1. 标准题目与真实用户表达存在差距
许多传统 Benchmark 使用一套相对固定的题目。这些题目通常结构规整、要求清楚、信息完整,但真实用户提出的问题往往不是这样的。
例如,在客服机器人的测试中,标准问题可能是:
请帮我查询一下订单状态。
但真实用户可能会说:
都一个星期了还没收到,你们到底发货没有?
这时,模型不仅需要识别“查询订单状态”这个意图,还要理解用户的情绪,继续询问订单信息,调用业务系统查询,并在无法处理时提供人工客服入口。
Benchmark 主要验证模型面对边界清楚、信息完整的问题时表现如何,却未必充分验证它面对模糊表达、情绪化语言和复杂业务流程时的表现。
因此,Benchmark 测出来的是模型在标准条件下的部分能力,而真实业务考查的是模型、知识库、业务接口和产品流程共同工作的结果。
2. 公开 Benchmark 可能产生数据污染
当行业都使用同一批公开 Benchmark 评价模型时,另一个问题也会出现:测试题或与测试题高度相似的内容,可能已经进入模型的训练数据。
这并不一定意味着模型公司主动把答案加入训练集。大模型的训练数据规模非常庞大,公开题目、代码仓库和相关讨论都有可能被收录,从而产生数据污染。
如果模型在训练时已经见过这些题目,它在 Benchmark 上得到的高分,就不一定完全来自真正的泛化能力,也可能包含“见过类似题目”的影响。
因此,公开 Benchmark 的分数可以作为参考,但不能作为判断模型真实能力的唯一依据。
3. 一些 Benchmark 会逐渐饱和
一套 Benchmark 从学术论文提出,到社区验证、排行榜采用,再到企业广泛引用,通常需要一段时间。
但 AI 模型发展得非常快。随着越来越多的模型在同一套题目上取得高分,一些 Benchmark 会逐渐接近满分,难以继续区分模型之间的真实差距。这种情况通常被称为 Benchmark 饱和。
这不一定意味着 Benchmark 已经完全失效,而是它原本能够区分的能力,可能已经被越来越多的模型掌握。此时,即使两个模型在榜单上只相差几分,这个差距也未必能反映它们在真实业务中的体验差异。
六、产品经理应该怎样使用 Benchmark
Benchmark 并不是没有价值。问题不在于“要不要看 Benchmark”,而在于“应该怎样看”。
1. 把 Benchmark 当作选型起点
Benchmark 可以帮助我们快速了解模型的大致能力,并完成第一轮筛选。但上线决策不能只看公开榜单,还需要以真实业务评测为准。
2. 选择与业务相关的评测
不要只看一个分数,也不要为了数量盲目堆叠 Benchmark。应该选择与业务目标相关、评测条件透明,并且仍然具有区分度的 Benchmark 进行综合判断。
例如,产品需要处理复杂客服对话时,代码生成得分就没有太大参考价值;如果产品强调长文本理解,就应该重点关注与长上下文相关的评测。
3. 用真实问题完成上线前验证
产品经理可以从脱敏后的真实用户问题中整理一套内部测试集,覆盖正常表达、模糊表达、异常情况和高风险问题,再把候选模型放到真实的知识库、业务接口和产品流程中测试。
最终需要关注的不只是回答是否正确,还包括稳定性、响应速度、成本、工具调用和失败时的兜底能力。
4. 比较分数时先确认评测条件
只有在数据集版本、提示方式、模型参数和评分程序等条件一致,并且分数变化明显超过正常波动时,从 85 分提升到 88 分才具有较强的参考价值。
孤立地看到“某个模型得了 88 分”,并不能说明它一定更适合自己的业务。
七、结语
Benchmark 像一场统一考试,它能够帮助我们用相对标准的方法比较模型,但考试成绩并不能完整代表一个模型在真实业务中的表现。
一个模型在某项 Benchmark 上取得 SOTA,只能说明它在特定任务、特定指标和特定评测条件下表现优秀。真正决定产品体验的,还包括真实用户的表达方式、业务数据、系统能力、产品流程以及异常情况下的处理方式。
因此,产品经理既不能忽视 Benchmark,也不能迷信 Benchmark。看懂分数背后的评测方式,再用真实业务问题验证模型,才是更可靠的模型选型方法。
本文由 @小王的智驾科普 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!