起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
比 LLM 快 193 倍、输出 token 免费:Jev 的“判断模型”路线靠谱吗?


一个不会写字、只做判断的新模型,来自前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI。这篇笔记梳理了它的 RLCD 训练法、把智能塞进旧壳子的四个比喻,以及十八个行业用例,也如实列出自测数字与「零幻觉」两处可疑的地方。
We’re building prod, not God. 我们要造能投入生产的东西,不是造神。
——TypeSafe AI
这两天听到不少人提Jev,好奇去官网看了下,特别是他们的宣言印象深刻,又陆续看了一些相关内容,算我此刻的笔记,分享一下~
一、RLHF的核心贡献者“背叛”了自己的发明
一个不会写字、只做“判断”的新模型,来自一家叫TypeSafe AI的新公司,founder是Diogo Almeida,前OpenAI研究员,RLHF和ChatGPT的早期贡献者。
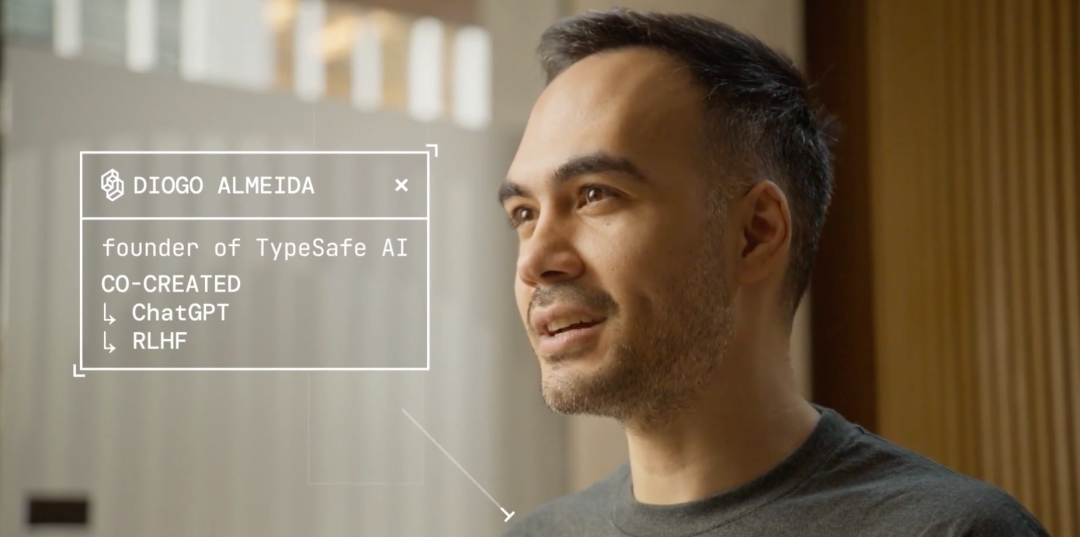
Almeida这个名字的分量在于:RLHF——用人类反馈训练模型——正是让ChatGPT成为ChatGPT的技术。整个行业过去四年都在这条路上狂奔:把模型训练得更健谈、更讨喜、更像一个坐在你对面的聪明人。
而Almeida的新公司,建立在对这条路线的公开批判之上。他在公告里说:
“I spent years working on models designed to make AI better at interacting with people. But if AI is going to fundamentally change how work gets done, people can’t be the only consumers of intelligence. Most intelligence should eventually live inside software, running quietly in the background.”
花了多年时间让AI更擅长与人互动。但如果AI要真正改变工作完成的方式,人就不能是智能唯一的消费者。大多数智能最终应该住在软件里,在后台安静运行。
二、Jev是什么:一个不会写字的模型
一句话版本:Jev彻底放弃文本生成,只做一件事——对一个预先定义好的答案空间,一次性输出每个选项的概率。
开发者提交状态(一段文本或结构化JSON,比如“我的卡被扣了两次款”),用三种问题原语之一发问:
- Choice:从最多255 个预定义选项中选择,返回全量概率分布。比如客服路由返回{“billing”: 0.08, “technical”: 0.85, “sales”: 0.07},外加一个置信度。
- Score:返回连续标量,比如流失风险0到1。
- Noul:自造词,返回校准过的是/否概率。
输出永远是类型化数值。软件直接检查、分支、执行,不需要从一段散文里抢救出一个决定。
为什么快?LLM逐token顺序生成,一个字符串里可能装着分类、解释、格式错误的数据或者没有依据的断言。官方称采用并行采样,避免逐token生成开放式文本——这也是官方“输出token免费”的底气来源:没有可计费的解码过程。
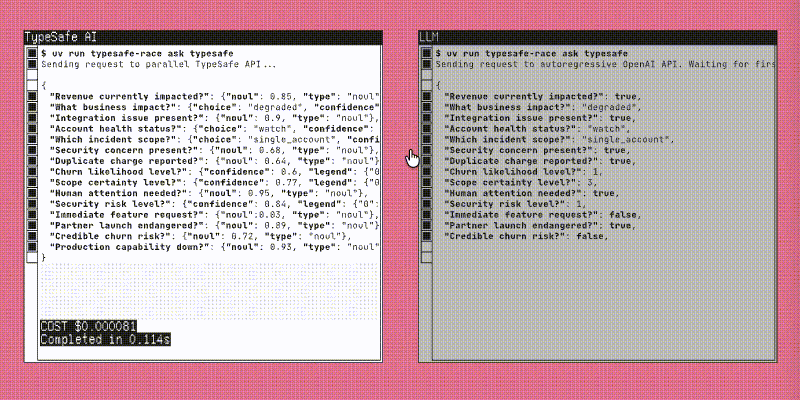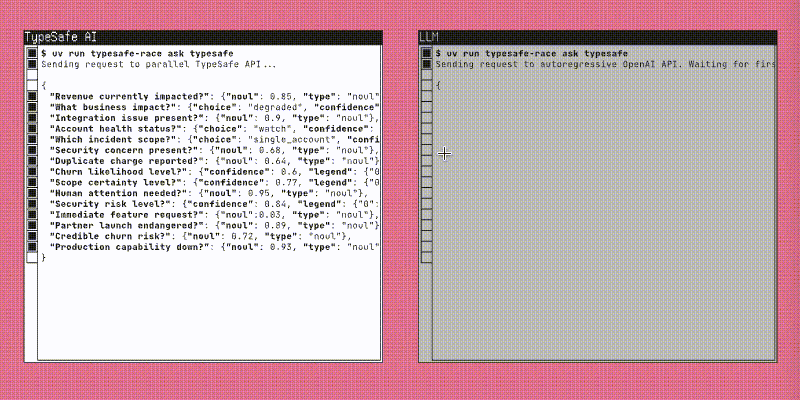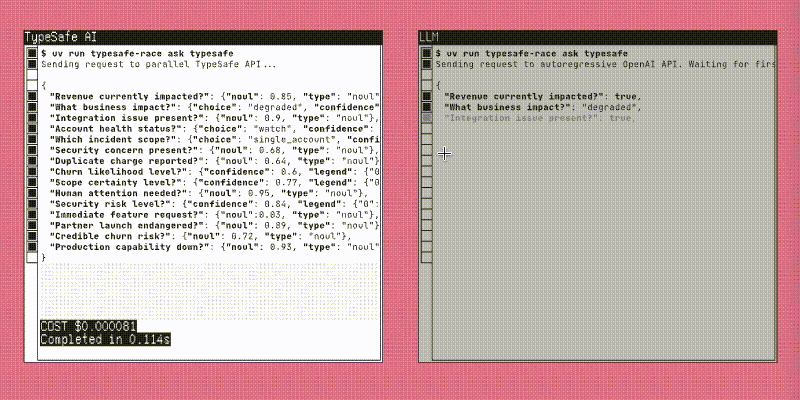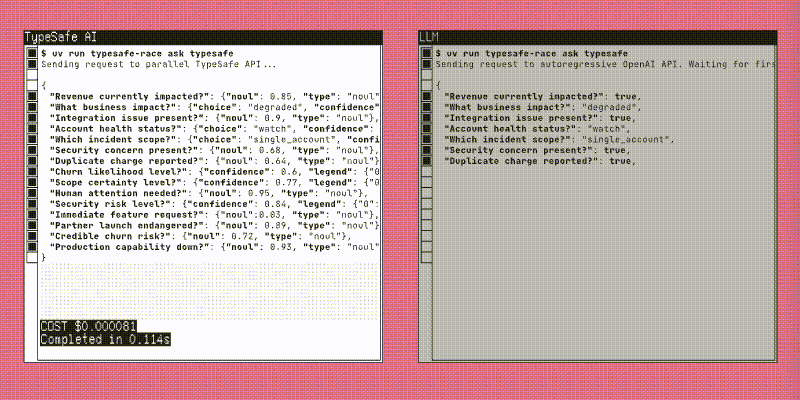
训练方法叫RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习),摆在RLHF和RLVR旁边自成一个序列:
- RLHF优化”人类偏好的文本”——结果是健谈讨喜的助手;
- RLVR优化”程序可验证的正确”——结果是刷榜的推理模型;
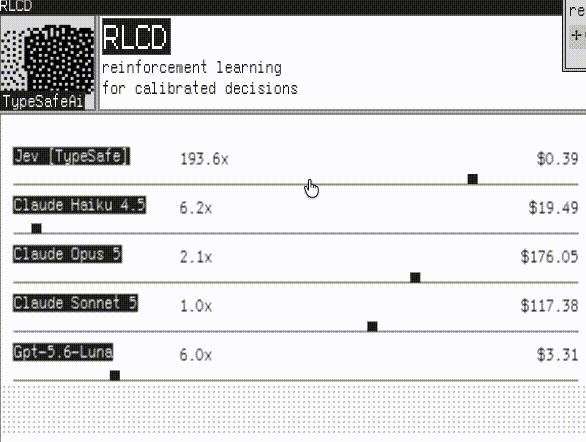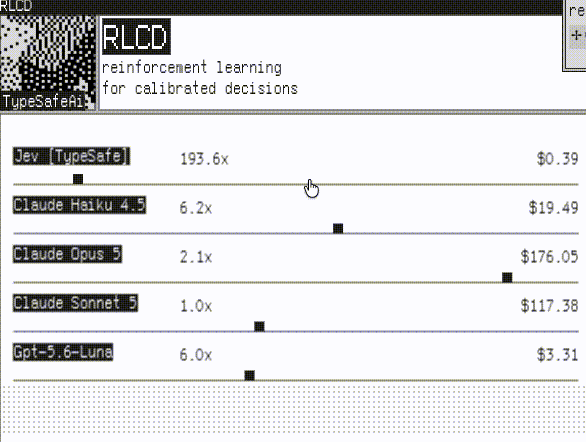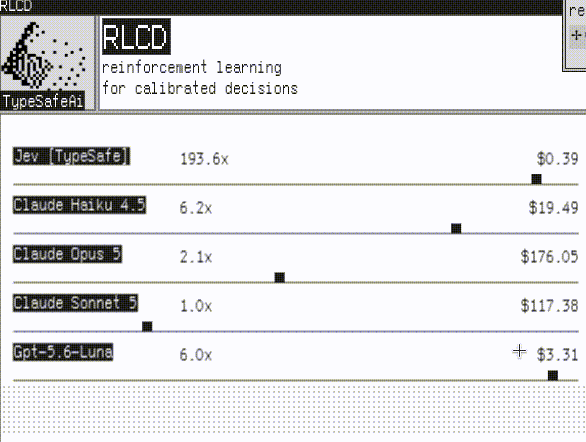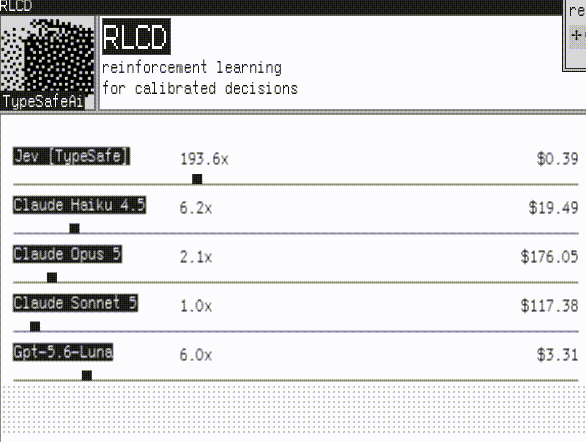
- RLCD优化”认知上诚实的概率”——模型说70%把握,就应该在大量同类决策中约70%正确。用的是考核天气预报员的那把尺子。
校准被提到这个高度,是因为无人值守的自动化需要它:你可以对0.55的置信度和0.95的置信度采取不同动作——但前提是那个数字在统计上诚实。
没有论文:RLCD的损失函数、奖励构造、架构细节全部未公开。Hacker News上从encoder-only猜到扩散模型,公司只说论文“以后可能有”。
三、Manifesto:一份少见的”反AGI”宣言
技术参数之外,TypeSafe的Manifesto才是理解这家公司野心的入口。
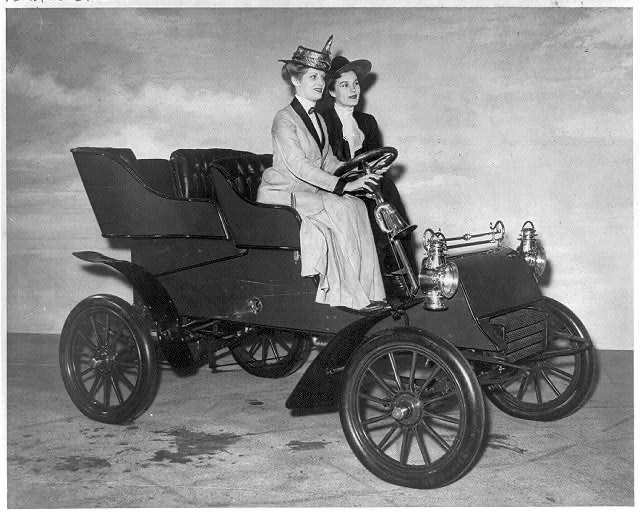
1)“无马马车”。 早期汽车被设计成“没有马的马车”:保留高座椅、马车弹簧,甚至鞭子插槽。新技术总是先被塞进旧事物的形状。今天的AI也一样——被训练成“乐于助人、口齿伶俐的助手”,前提是假设另一端坐着一个人。可预见的后果是:AI需要human in the loop,而不是在后台运行。但软件从来不是这样工作的——复杂的软件也是由简单逻辑和分层抽象搭起来的,每个分支都可以审计。
2)“SQL之前的数据库”。 今天的智能就像SQL出现之前的数据库:强大,但每次使用都是定制的。一旦一次聪明的决策变得像数据库查询一样可靠、可调用,建设者就会像堆叠软件一样堆叠智能。造数据库的人没想过Google,造协议的人没想过Stripe——寒武纪大爆发从来不是顶层设计出来的。
3)安全是分层的前提。 你让一个组件无人值守,因为它可靠;你在它之上构建,因为它可信。把依赖埋进系统五层深处需要信任,信任来自可检查、可测试、可逐件约束。在这份宣言里,安全不是对齐哲学,是工程纪律。
4)Neuro-symbolic的旧梦。 宣言脚注坦率承认这条路线的学术血统:神经网络负责感知,符号逻辑负责推理,被戏称为“smart if-statements”。宣言里我最喜欢的一句话也在这里:”计算机仅靠比特分支就能做这么多事,想象一下如果它们还能基于常识、理解和意图来分支。
四、用例地图:它如何思考和软件的关系
官方文档里有一页Use Case Map,我觉得比新闻稿更能说明他们怎么想问题。五大方向:
- AI Automation Software:代码拥有控制流,Jev处理语义判断,可以在后台跑一百万次,不需要human co-pilot;
- Real-time applications:150 毫秒级的前沿智能,快过人类感知,可以嵌进UI甚至驱动游戏;
- AI Map Reduce:便宜100 倍意味着可以扫海量数据——分类巨型agent轨迹、从大语料里提取特征;
- Universal Verification:验证其他AI的输入、抽取、推理链和工具调用,检测越狱、引用错误、幻觉,成本只是LLM调用的零头;
- Harness Engineering:模型路由、语义上下文检索、LLM错误检测和护栏。
下面铺开十八个行业场景:客服工单路由、保险理赔分流、金融犯罪警报排序、合同条款核查、电商违禁品检测、内容审核、简历初筛、需求预测……扫完这份清单,我的感受是:这些场景有一个共同点——它们要的都是“判断”,不是“生成”——而每一个,都是今天无数团队在用通用LLM硬做的事。
五、翻译行业既视感
我想翻译领域的QE(翻译质量评估):机器已经译出来了,哪句能交付,哪句必须人改?译文越流畅,有些错误反而越难发现,尤其术语、数字和否定关系。流畅的译文通常会把错误伪装得很好,反而更难检查出来。
QE就在处理这件事:没有参考译文时,预测质量或处理成本,为自动放行、人工修改提供依据。WMT从2012年就有QE评测,早于神经机器翻译普及;后来的 CometKiwi、ModelFront 则分别代表了研究和商业实践。
但QE有几个坑是实实在在的,可能也是Jev的前车之鉴,比如:
质量分不等于合格概率:模型可以很确定一段译文很差,也可以给出高分却没什么把握。客户要的通常是:在可接受的错误水平下,能少做多少译后编辑(人工处理)。
阈值也有适用范围:换领域、客户标准或语言组合,分数与质量的关系随时可能变化;Jev目前英语表现最好,中文或其他语言呢?
局部过关,不保证整体过关。每句都通顺,整篇却把同一个术语翻成三种东西。局部正确的累加,不等于全局正确。把问题拆小,方便测试,也把组合责任交给了开发者。
六、Think different的创新火花
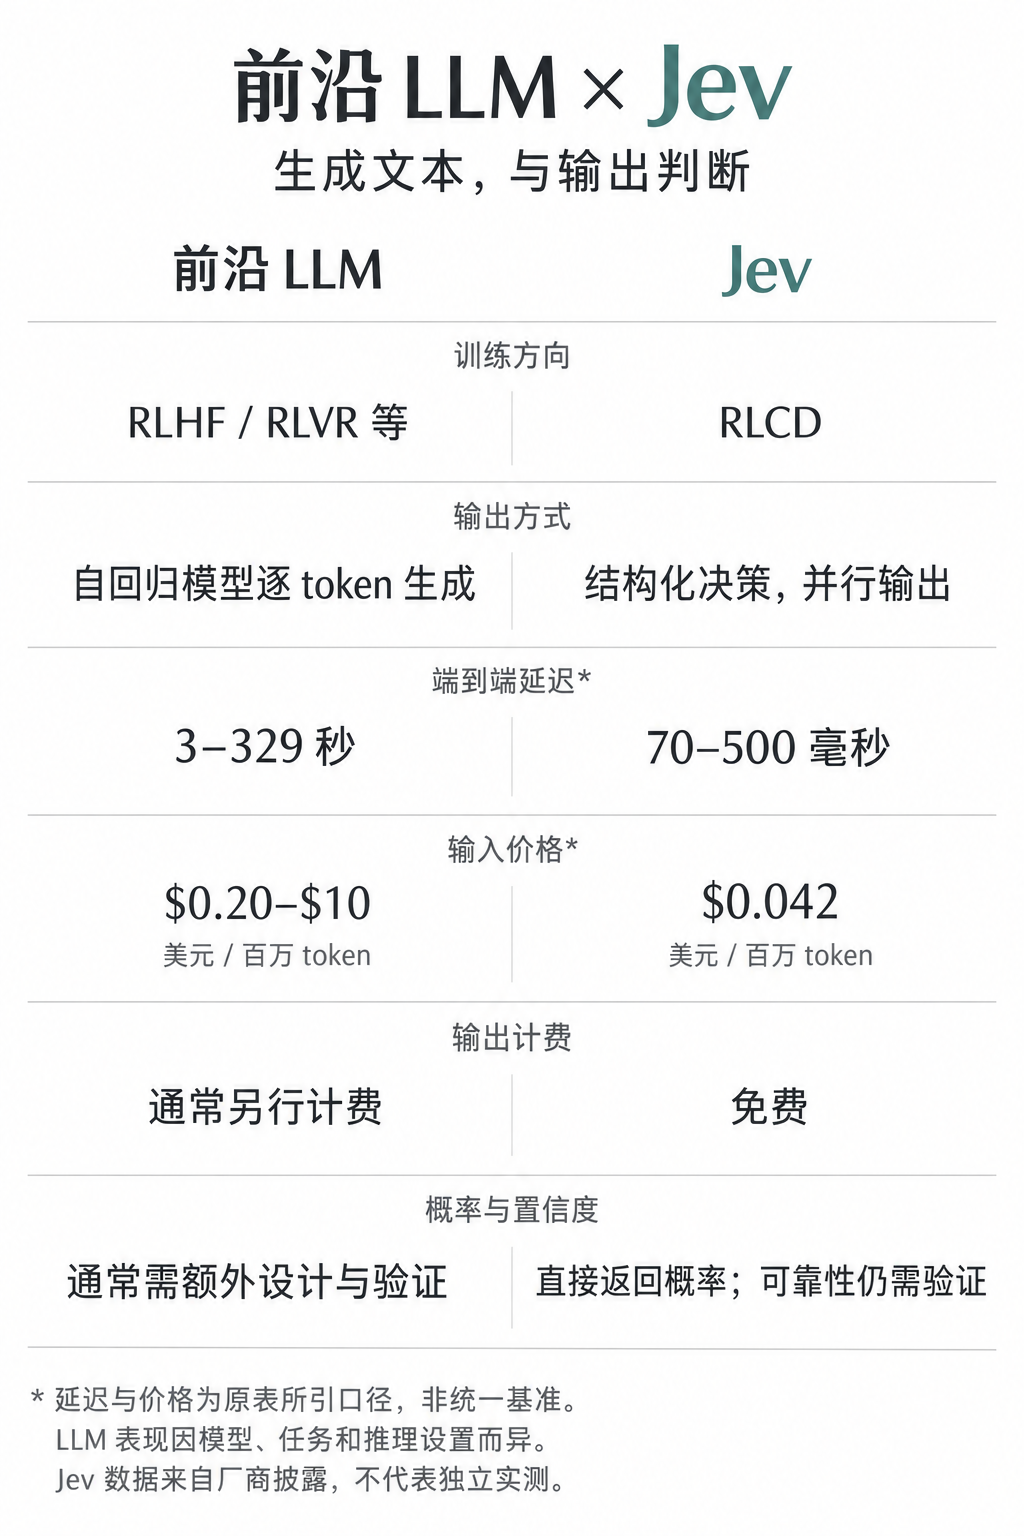
很久没有看到眼前一亮的模型了,在LLM军备竞赛的2026年,TypeSafe的确实是think different:不参加AGI竞赛,公开说“今天的模型早已越过创造巨大经济价值所需的智能门槛”;砍掉文本生成这个行业最大的卖点,做一个不会说话的模型——这就是think different。
一个亲手把模型训练成讨好人类的人,否定了过去的自己过的范式,并敢于说:LLM这条路对生产软件是错的。
一次有创新火花的产品洞察:是否所有业务都需要“系统二”?主流习惯问模型还能不能想得更深,Jev 反过来问:这个环节,值得花多少时间去想?
从足够底层的一个小小的角度偏离,你就发现他们后面看待问题的视角,就和主流大相径庭了。
Jev不是一个通用分类器,而是一个对RHLF本身优势和弱点的深度思考,人类反馈强化学习解决了和人类交互的问题,却放大和和软件交互的缺点——任何一个优点的背面,都是一个缺点。
七、给Jev泼点冷水
Jev目前大部分数字都是自测。 “快193.6 倍、便宜444.6 倍”来自官方自建的workflow eval,公司自己承认这处于真实收益的高端。不跑公开基准,而是对比GPT-6 Astra和Fable 5.1两个模型预测的平均值——不是ground truth。一个自称frontier的模型,主动绕开所有公共标尺。当然,新的东西本身也需要新的标尺。
“零幻觉”是语义游戏。 TypeSafe把幻觉定义为“落在schema之外的无效输出”,那么schema约束确实可以从构造上消除幻觉。但大多数用户担心的是另一种:答案以完美JSON呈现,但依然是幻觉。
它真正的竞品可能不是前沿LLM:
Jev要赢的不是GPT或Claude,而是蒸馏到极限的小模型、训练好的传统分类器、规则引擎;OpenAI Structured Outputs、BAML、DSPy、Outlines这条已经很成熟的结构化输出工具链;或者开发者早就在用验证器、重试、备用模型把通用LLM捆成判断机器。
Jev必须证明:一个为判断而生的模型,比“通用模型+工程胶水”更便宜、更准、更省心。不过,我还是看好这种边缘创新——现在很小,差异也没那么大,但差异只会加大,不会变小。
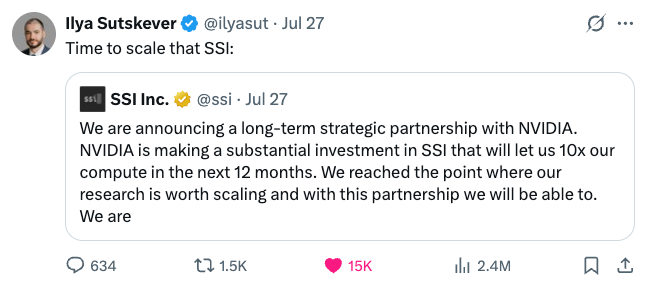
在Thinking machine Labs发布的东西有点失望后,开始怀念Safe super intellegence的Ilya,他会发一个什么样不同的模型?
作者:David Lee 公众号:David的AI全景图
本文由 @David Lee 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自作者提供

- 目前还没评论,等你发挥!