起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
WorkBuddy如何使用才更省积分?


不少人明明没做几次复杂操作,积分就飞速见底,原因往往是全程用高消耗模式、反复无效对话、零散处理小任务。文章按模式选择、模型匹配、上下文管理到指令输出整理了六个实操技巧,并指出三种模式的消耗排序是 Ask 最低、Plan 居中、Craft 最高。
很多人用WorkBuddy,都会遇到同一个尴尬问题:
明明没做几次复杂操作,积分就飞速见底,免费额度根本不够用。
归结原因,主要是全程用高消耗模式、反复无效对话、零散处理小任务,日积月累造成大量无效积分损耗。
为了帮助大家更高效地使用工具,下面整理了6个实操技巧。
从模式选择、模型匹配、上下文管理到指令输出、任务处理,全方位教你精准控制积分消耗。
01 优先选对模式:Ask/Plan/Craft,拒绝无脑用默认
很多用户根本不清楚WorkBuddy三大模式的消耗差距,不管是简单查问题、写大纲,还是做成品文档,一律用默认的Craft模式。
但事实是,三种模式的权限、功能、积分消耗层级完全不同,消耗排序:Ask<Plan<Craft。
选对模式,单次操作就能直接省下大半积分。
先给大家讲清楚三种模式的核心定位和适用场景,直接对标使用,不用瞎试:
1、Ask模式(最低消耗,日常首选)
这是真正的“省积分神器”,核心属性是纯问答、只读不操作、无文件权限。
它不会读取、修改、新建本地文件,不执行复杂拆解和落地操作,只专注解决即时性、轻量化问题,Token消耗极低,是日常高频场景的最优解。
适配场景:
简单答疑、概念查询、单词翻译、短句润色、问题纠错、思路咨询、知识点科普、临时疑问解答。
凡是不需要生成完整文档、不需要落地文件、不需要复杂拆解的问题,一律优先用Ask模式,别用高消耗模式浪费积分。
2、Plan模式(中等消耗,复杂任务过渡首选)
Plan模式的核心是先规划、后确认、再执行,不会直接输出成品内容,而是先帮你拆解任务、梳理框架、列出流程大纲,等待你确认后再推进后续操作。
它的优势在于,前期规划拆解的积分消耗极低,完美规避了Craft模式“一次性高消耗出错、返工重耗积分”的问题,大幅降低试错成本。
适配场景:
写文章/报告大纲、拆解工作项目、梳理选题思路、制定执行流程、规划代码逻辑、搭建内容框架。
但凡任务复杂、需求不清晰、担心输出出错返工的场景,先用Plan出框架,确认无误再落地,是最稳妥、最省积分的操作逻辑。
3、Craft模式(最高消耗,仅用于成品落地)
Craft是WorkBuddy权限最高的模式,支持本地文件读写、新建、修改、批量执行、生成完整成品文件。
可以直接输出Word、Excel、PPT、代码文件等可直接使用的成品,效率最高,但积分消耗也是最高的。
很多人的误区是小事也用Craft,白白浪费高额权限和积分。
记住核心原则:
Craft只做最终落地,不做咨询、不做试错、不做框架梳理。
适配场景:
生成完整成品文档、批量修改文件、代码落地调试、格式转换、完整方案输出、需要直接落地交付的任务。
02 按场景匹配模型:不盲目用高配模型,精准控耗
很多用户习惯性全程选用最高精度、最大参数的顶配模型,觉得“模型越好,效果越好”。
但实际上,不同场景对模型能力的需求天差地别,高配模型处理简单任务,完全是大材小用,只会白白浪费积分。
WorkBuddy不同模型的单价差距极大,核心逻辑:
任务难度越低,越选轻量化模型;任务精度要求越高,再启用高配模型,按需匹配才是极致省积分的关键。
推荐一套可直接照搬的场景匹配方案,适配日常99%的使用需求:
1 轻量化简单场景(低阶模型,极致省积分)
日常简单问答、短句修改、文案润色、简单翻译、知识点查询、基础纠错、话术优化等低难度任务,无需复杂逻辑推理和内容创作,直接选用轻量模型。
这类任务对精度、逻辑复杂度要求极低,轻量模型完全能完美胜任,且积分消耗只有高配模型的1/3甚至更低。
2 中度创作场景(中阶模型,性价比最优)
写公众号短文、日常周报、工作总结、普通文案、简单脚本、内容大纲细化、常规问题分析等任务,需要基础逻辑梳理和内容创作,但不需要极致细节和超强推理能力,选用中阶通用模型即可。
平衡输出质量和积分消耗,性价比最高,不会出现效果不足或积分浪费的情况。
3 高阶专业场景(高阶模型,按需使用)
复杂代码编写调试、专业方案撰写、数据分析、深度逻辑推理、长文创作、精密排版、复杂问题拆解等高难度任务,再启用高阶高精度模型。
这类任务对逻辑、细节、专业度要求极高,轻量、中阶模型无法胜任,必须用高配模型保障输出效果。
4 模型优惠活动(按需优先使用)
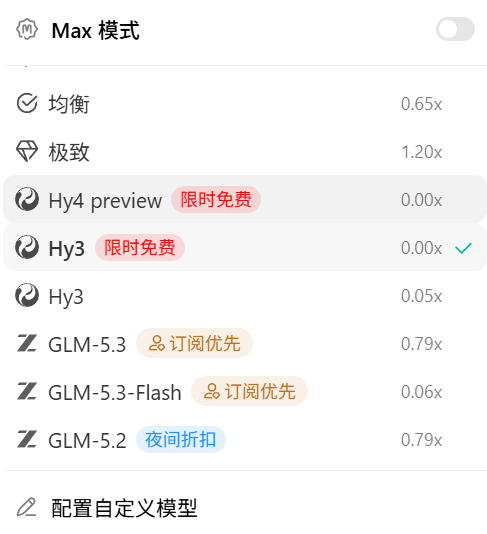
部分模型会推出优惠活动,比如Hy3的限时免费、GLM-5.2的夜间折扣(非高峰期积分5折)。
在满足使用需求的前提下,选用有优惠活动的模型,更省积分。
另外,模型右侧的倍率值(如“0.65x”)代表积分消耗速度。
数值越大,积分消耗越高,选用倍率低的模型,更省积分。
03 科学管理上下文:杜绝对话堆积,从源头控Token
很多人不知道,WorkBuddy最隐形的积分消耗,来自冗余的对话上下文。
每次发送新指令,系统会自动把当前对话的所有历史内容重新打包输入模型。
对话轮次越多、历史内容越长,输入Token就越多,积分消耗自然持续上涨。
很多时候你只是简单问一个新问题,却因为堆积了几十轮历史对话,积分消耗直接翻倍。
这也是很多用户疑惑“明明没输出多少内容,积分却扣得很多”的核心原因。
想要省积分,必须学会科学管理上下文,分享三个方法:
1 新任务必开新对话
彻底改掉“一个对话窗口用到黑”的习惯。
上一个任务是写文案,下一个任务是查代码,再下一个是翻译资料,跨类型、跨场景任务,全部新建对话。
清空无效历史上下文,直接减少无效输入Token,从源头降低积分消耗。
2 单任务结束及时清上下文
同一类任务长期对话,也会产生冗余内容。
比如反复修改同一篇文案,前面的初稿、作废修改记录、废弃思路,都是无效上下文。
任务定稿、阶段性完成后,立刻清理无关历史内容,只保留最终有效内容,避免旧内容持续占用Token。
3 超长任务分段重置
如果是万字长文、复杂项目方案、批量代码调试等超长任务,对话轮次超过10轮以上,建议分段结束后重置对话。
不要让上下文无限堆积,否则越用到后面,单次提问的积分消耗越高,隐形损耗极大。
04 需求一次说清:避免反复返工,杜绝重复耗积分
很多人习惯性“随口提问、模糊指令”,先让AI随便输出,不满意再一次次补充、修改、微调。
看似每一次修改消耗的积分不多,但多次返工叠加起来,消耗的积分远比一次性精准输出要多得多。
更关键的是,反复修改会持续叠加上下文冗余,造成二次积分浪费。
想要彻底规避这种损耗,核心原则只有一个:
单次需求,一次性讲全、讲准、讲透,尽量做到一次成型、零返工。
给大家一套通用指令模板,适配绝大多数场景:
- 明确场景:告诉我使用场景(职场汇报、自媒体发文、学生作业、代码开发、日常话术等);
- 明确受众与风格:正式/口语/简洁/活泼/专业,面向领导/客户/粉丝/自用;
- 明确核心要求:字数范围、结构框架、重点内容、禁止事项、格式要求;
- 明确交付形式:只要大纲、完整成文、表格呈现、逐条罗列、代码片段等。
举个对比案例:
❌ 低效模糊指令:
帮我写一篇周报。(输出宽泛、大概率不符合预期,需要多次修改)
✅ 精准省积分指令:
帮我写一篇职场正式周报,面向部门领导,字数800字左右,结构分为本周工作完成、现存问题、下周工作计划三部分,内容贴合新媒体运营日常工作,语言简洁务实,不用空话套话,直接输出成文版本。(一次成型,无需返工)
看似多打了几句话,实则用少量输入Token,省去多次返工的高额重复消耗,长期使用,省积分效果极其明显。
05 主动控制输出长度:拒绝无效长文本,精准降耗
积分消耗不仅看输入,更看输出长度。
输出的文字、代码、内容越长,输出Token越多,积分消耗越高。
很多时候我们只需要精简核心答案,但AI会默认输出“全面、详细、冗余”的内容。
各种铺垫、废话、通用科普堆砌,看似内容丰富,实则90%都是无效内容,纯粹浪费积分。
想要精准控耗,必须主动限制输出长度、约束输出格式,不要让AI自由发挥。
推荐三个约束技巧:
1 强制限定字数
所有文案、总结、问答、文稿类需求,必须明确标注字数范围。
比如“控制在500字以内”、“精简至300字核心内容”、“输出800字正式文稿”,杜绝无限制长篇输出。
2 明确精简要求
在指令中直接标注要求,如:
无需铺垫、无需多余科普、直接输出核心内容、拒绝空话套话、只保留关键信息。
从源头规避AI的惯性冗余输出。
3 指定输出格式
需要简洁答案就要求“逐条罗列、短句输出”,需要核心结论就要求“先给结果,再简单补充说明”。
避免大段段落式冗余输出,减少无效Token占用。
记住一个核心逻辑:够用即可,绝不贪多。
多余的每一个字,都是实打实消耗的积分,没必要为了无用内容透支积分额度。
06 批量处理同类任务:减少启动次数,压缩单次损耗
WorkBuddy每一次独立提问、每一次任务启动,都会产生固定的基础Token损耗。
10次零散小任务的消耗,远大于1次批量处理10个任务的消耗。
碎片化操作的基础损耗叠加,是很多重度用户积分不够用的核心原因。
很多人习惯想到一个问题问一次、有一个小需求做一次,零散操作看似灵活,实则每一次都重复消耗基础Token。
正确的省积分方式是:
攒同类任务,统一批量处理。
举几个日常高频案例:
- 文案优化:把所有需要润色、修改、纠错的短句、段落统一汇总,一次性批量让AI优化,不要一句一句单独修改。
- 问题答疑:把日常积累的同类知识点疑问统一整理,批量提问,不要碎片化随时提问。
- 内容创作:批量生成多篇短文大纲、多组选题、多版文案话术,集中处理,减少多次启动任务的基础损耗。
- 文件处理:同类格式转换、简单修改、内容提取任务,统一批量执行,避免多次单独操作。
批量规划、梳理框架用Plan模式,批量落地、生成成品用Craft模式,全程不用高消耗模式做简单预处理,进一步压缩积分损耗。
批量处理的核心价值,就是摊薄单次任务的固定基础消耗,大幅提升积分利用率,同样的积分,能多做2-3倍的工作量。
最后
看完这整套实操方法,大家应该明白,WorkBuddy积分不够用,多数是使用习惯问题。
真正的省积分,是不无效消耗、不重复损耗、不盲目高配、不冗余输出。
用最低的积分成本,完成最高效的工作产出,才是使用AI工具的核心意义。
本文由人人都是产品经理作者【伍德安思壮】,微信公众号:【时间之上】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!