起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
阿里Qwen系列还有高手,首发实测,我开发了一个音频工作室应用,已开源


作者在云栖大会现场看到阿里一次放出图像、音乐、世界模型、语音与实时交互等一长串新模型,当晚百炼上线了音频创作模型。他觉得线上调用有些麻烦,索性写了个本地工具 Qwen Audio Studio,支持播客、广告、有声书等七种创作模式,已经开源。
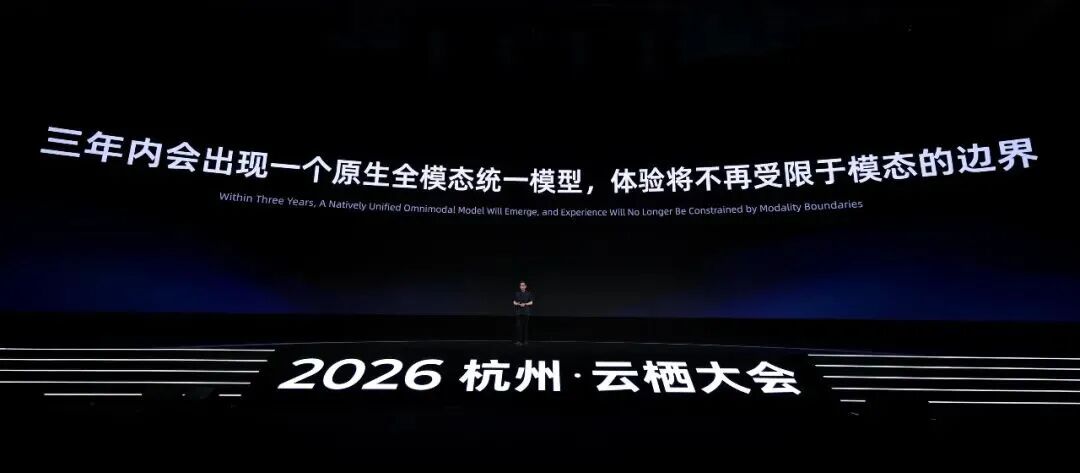
来杭州参加阿里云栖大会了,现场非常火爆,会上发布和预告的新模型也很多,激动的直搓手
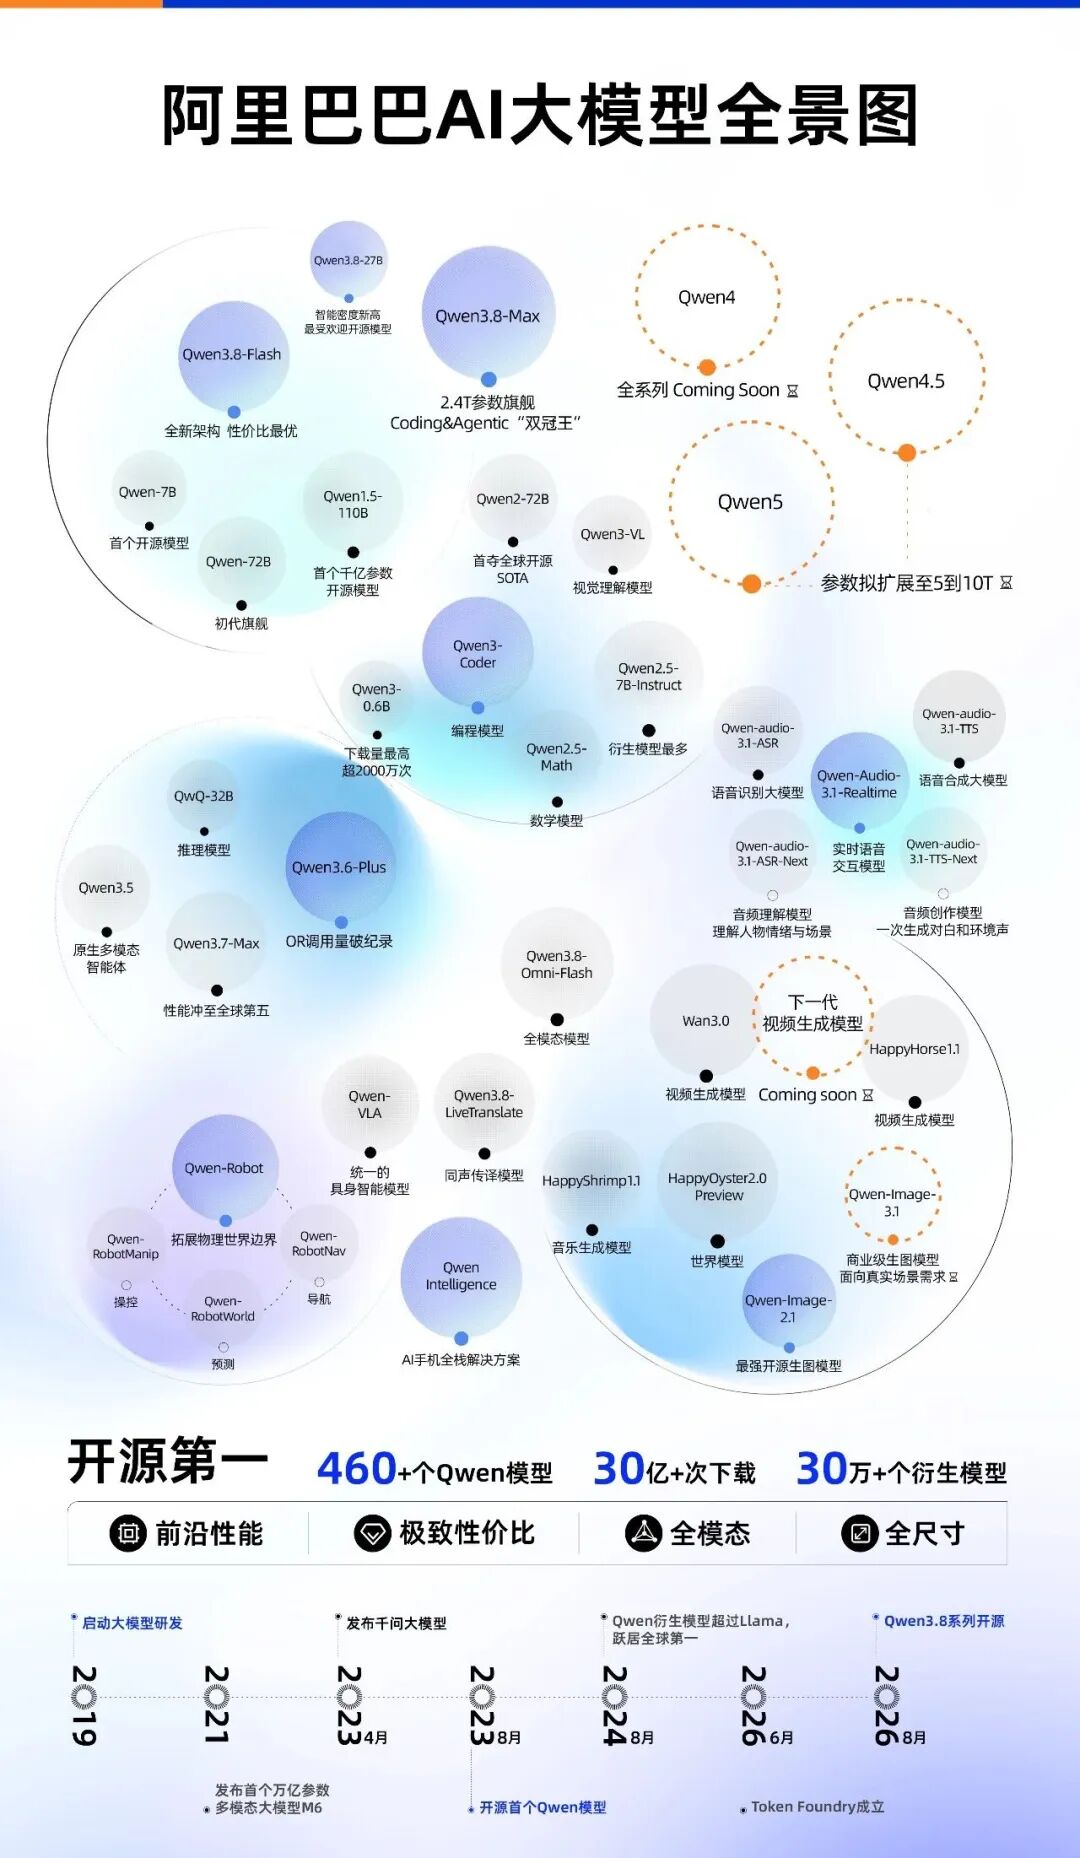
阿里是全线发力,因有尽有,很多方向都跻身全球一流梯队
除了最令人期待的 Qwen4-Max、Qwen4-27B,还有图像生成模型 Qwen-Image-3.1、音乐生成模型 Happy Shrimp1.1、世界模型 HappyOyster 2.0 Preview、语音模型 Qwen-Audio-3.1,基于下代架构的音频理解模型 Qwen-Audio-3.1-ASR-Next,音频创作模型 Qwen-Audio-3.1-TTS-Next,实时交互模型 Qwen-Audio-3.1-Realtime、同声传译模型 Qwen3.8-LiveTranslate
晚上就发现百炼已经上线了 Qwen-Audio-3.1-TTS-Next
但是,线上使用和调用 API 我觉得都有点麻烦,所以我写了一个本地音频创作工具:Qwen Audio Studio,定位“一人音频工作室”
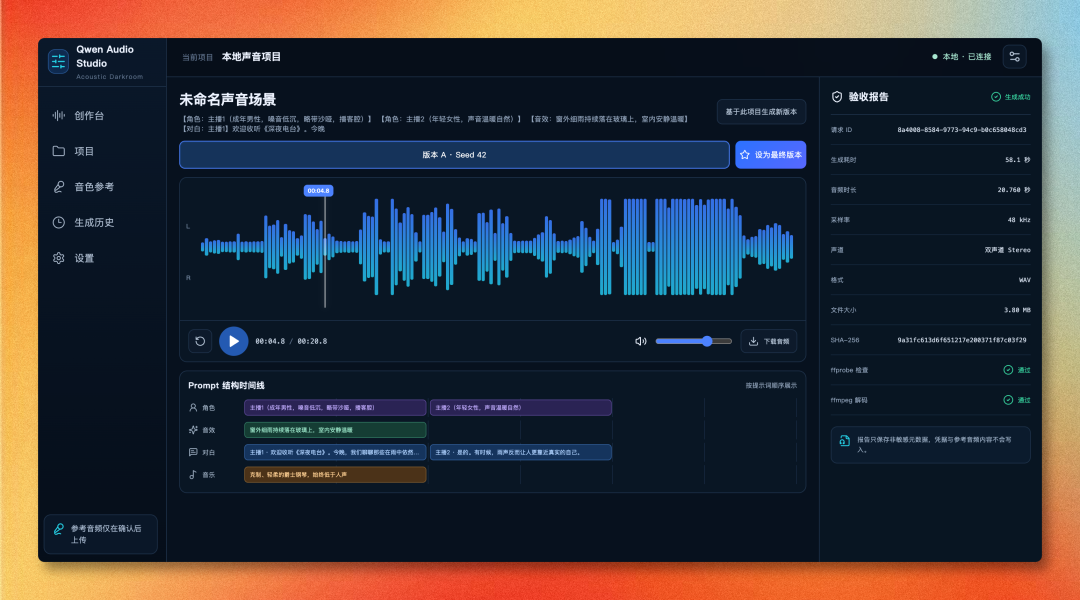
这个工具可以选择播客、广告、有声书、广播剧、游戏配音或旁白等 7 种创作模式,对应的提示词、创作说明和模板会自动切换
它支持角色对白、环境声、动作音效、背景音乐和参考音色,也能调整格式、采样率、声道、语速、音量与随机种子
生成后可直接试听、下载、对比不同版本
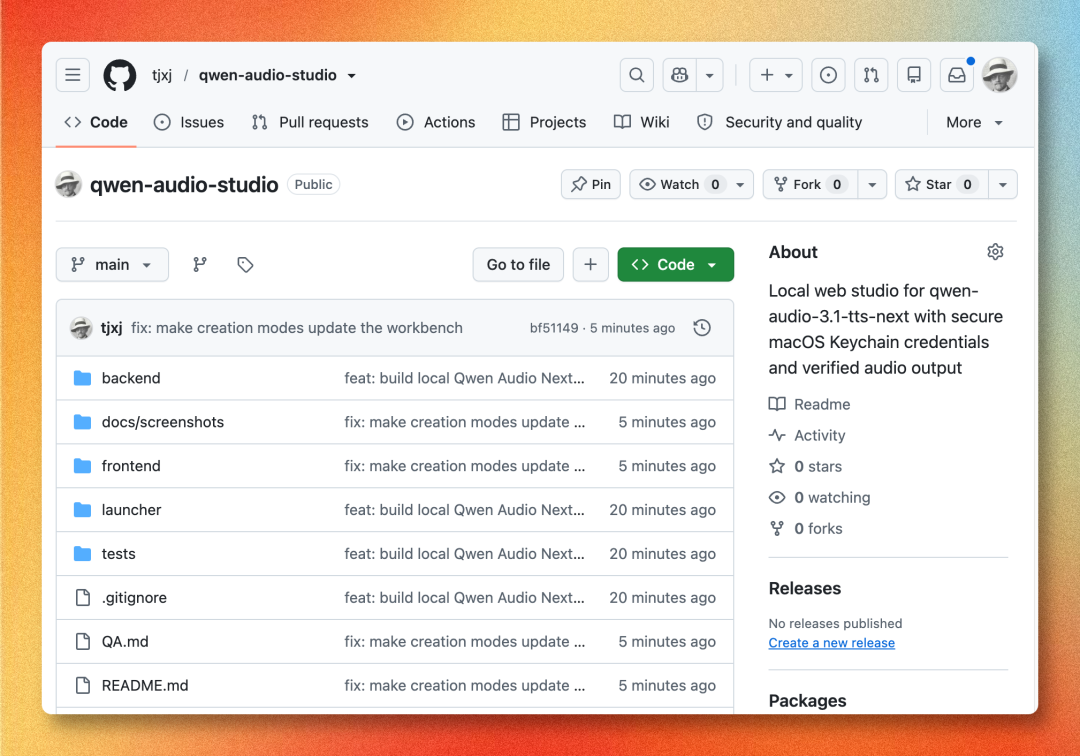
有需要的兄弟可以试试,已开源
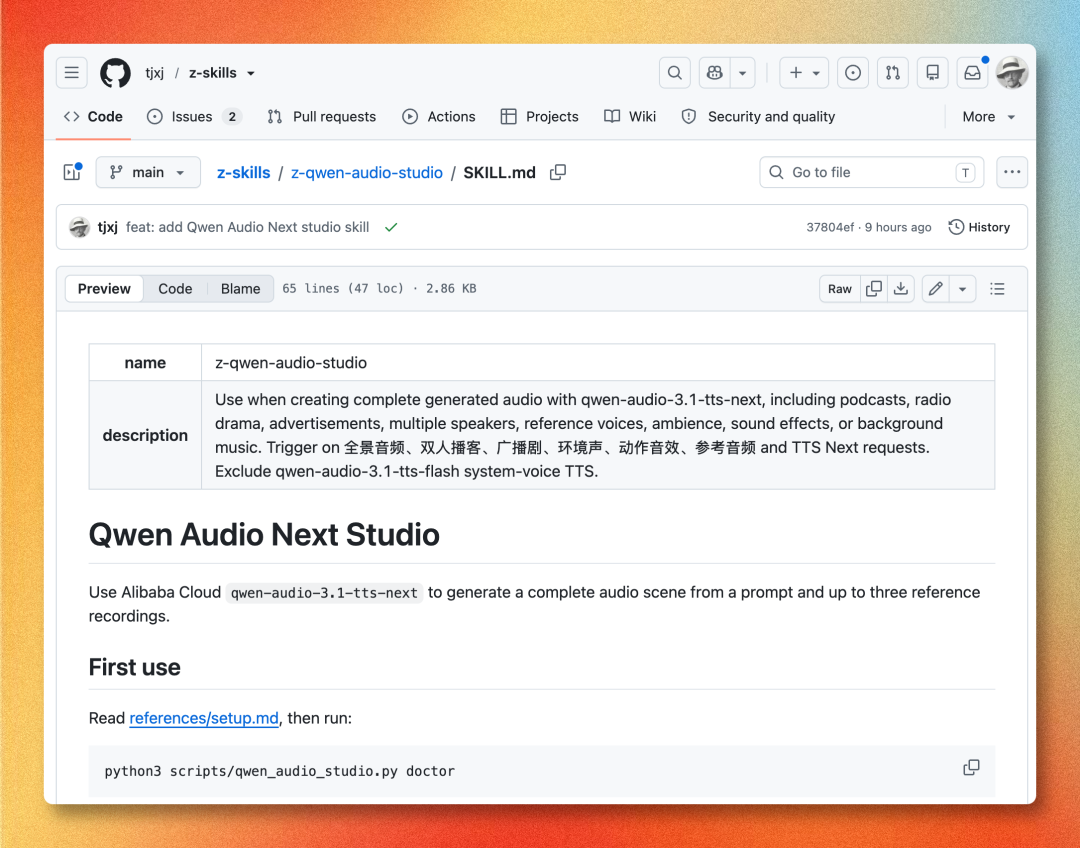
另外,我还做了一个专为 Agent 准备的自动化 Skills: z-qwen-audio-studio。只需描述想制作的播客、广告、广播剧或游戏配音,它就能整理角色、对白、环境声、音效与音乐,生成结构化 Prompt,并调用 qwen-audio-3.1-tts-next 完成制作,也已开源!
01 Qwen-Audio-3.1-TTS-Next
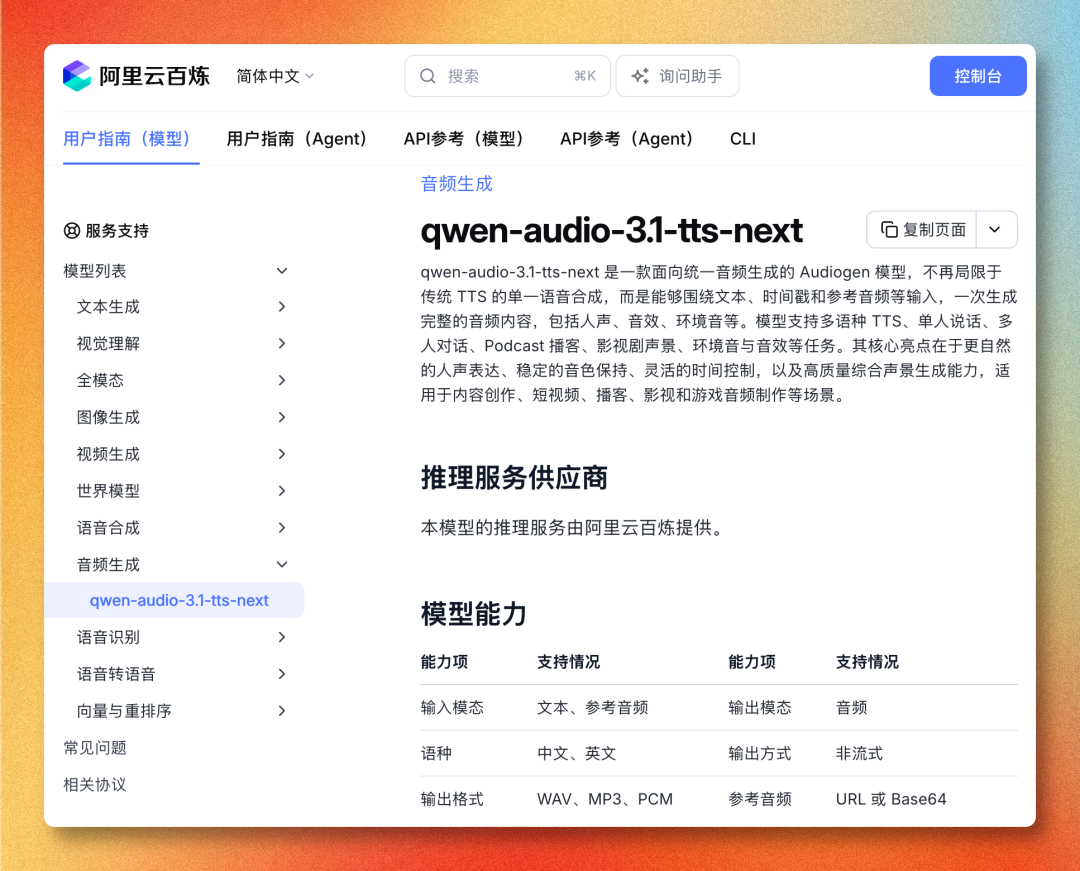
Qwen-Audio-3.1-TTS-Next 模型能力一句话总结:
给它一段剧本或者带动作描写的文字脚本,它能直接吐出融合了人声对白、动作音效、环境底噪甚至背景音乐的完整成片,并支持用户精准编排各个声音元素的登场顺序
多说无益,看下几个实测吧
场景一:原创悬疑短剧
测试提示词(Prompt):
广播短剧,电影质感,场景为暴雨深夜的街角便利店
环境声:外头雷雨交加,雨水重重砸在玻璃窗上
门被推开,伴随清脆的进店电子叮咚声,外头的雨声瞬间涌入,随后是收伞甩水的哗啦水滴声,门迅速关上,雨声明显被隔绝在门外,变成闷雷低鸣
店员(二十岁出头男性,嗓音透着熬夜的沙哑与疲惫,有气无力):欢迎光临,关东煮卖完了啊
顾客(五十岁左右中年男性,浑厚、低沉、极其平静,语速极慢):给我一份昨天的报纸
便利店背景里只有冰柜压缩机的微弱蜂鸣,店员敲击键盘的动作突然停顿两秒,吸了一口气道:大叔,您已经连续来买三十年了
紧接着窗外劈过一道沉闷的远雷
这个场景之所以刁钻,是因为它塞满了非常严苛的声学物理变化:
推门与关门之间暴雨声的剧烈衰减、进店收伞甩水的动态、门铃电子脆响、店员疲惫拖沓的招呼,以及关键悬疑台词出来时环境声能不能恰如其分地让路
场景二:独立游戏 NPC 交互
做游戏开发的朋友都知道,以往给 RPG 游戏 NPC 铺音频,要么用死板的纯干音,要么就得用中间件在游戏引擎里反复挂触发器
这次老章直接测试它能不能把人物台词与开放世界动态环境声合为一体:
测试提示词(Prompt):
游戏 NPC 台词配音,场景为微风和煦的村口大树下,古槐树叶沙沙作响
背景声:远处隐约的乡村公鸡打鸣与犬吠声、微弱溪流潺潺、远处孩童嬉闹声
NPC 老村长(70 岁男性,嗓音沧桑干哑、语速迟缓慈祥,透着深深的忧虑,伴随拐杖在泥地上轻微的顿地声):孩子啊,你来得正好。后山那边……昨夜又闹起了怪动静,大伙儿心里都慌得很。你本事大,替老汉我走一趟瞧瞧,村里老少,都指望你了。
类似场景我实测了很多,再放几个吧
雨夜末班车:三人对白融合雨声,呈现离别氛围
雨亭归伞:古风双人对话,雨声与风铃自然衔接
雪原机械师:NPC发布任务,寒风与机械声同步生成
02 生产力驱动
听完作品展示,咱们回到打工人的日常生产力上
如果真拿它当“一人音频工作室”,在面对真实商业交付和甲方的改稿折磨时,它抗不抗造?
精品咖啡店 20 秒声音广告
商业音频最忌讳从头到尾铺一段无关背景乐,它考验的是声音元素像精密齿轮一样的咬合感:磨豆机通电运转、高压蒸汽呲呲喷射、咖啡液滴落、瓷杯轻扣木桌,知性旁白恰到好处地切入
测试提示词(Prompt):
20 秒精品咖啡品牌声音广告,开场响起咖啡磨豆机的电动运转声,随后是咖啡机高压萃取蒸汽的微弱呲呲声,紧接着一声清脆温润的瓷杯放在木桌上的轻响
广告旁白(三十岁左右知性女性,温暖从容,语速舒缓):世界很吵,但这一刻,是属于你的安静
背景随之缓缓浮现轻柔舒缓的爵士钢琴弱音琶音,旁白轻声念出品牌:木雀咖啡,慢下来,闻见生活
甲方临时改需求:“我们不想要现代街边店的感觉,想要旧书店里开咖啡馆的质感。台词和旁白音色不要动,把背景底噪换成老木地板走动声与轻微翻书声”
直接修改提示词就行了。
深夜治愈系播客
播客最核心的是“呼吸感”与“陪伴感”,如果声音像播音员朗读或者机械客服,听众一秒就跳出去了:
测试提示词(Prompt):
情感播客节目,深夜陪伴风格。主播(28 岁男性,嗓音低沉温柔、语速放缓、带有一种深夜炉火般的安抚感)
背景声:舒缓柔和的深夜环境白噪音,带有窗外极微弱的细雨淅沥声与柔和的电台暖色轻音乐
主播台词:“现在是深夜十一点整。如果你这会儿还没睡,希望这段声音能陪你坐一会儿。今天无论遇到了什么糟心事,到这儿都翻篇了。把肩膀松下来,晚安,做个好梦。”(台词中间带有极微弱的叹息声与自然的停顿呼吸)
家族协同:泛音频理解与全双工智能!
以往传统语音交互最大的痛点,就是“抢话”和“误打断”:你话还没讲完只是中途思考停顿了一下,它就迫不及待抢话;或者背景里电视声稍微大一点,它就误以为在跟它搭话
Qwen-Audio-3.1 语音家族全新升级的 Qwen-Audio-3.1-Realtime,不仅更会听、会接话、懂情绪,还能在对话中调用工具完成任务。进一步增强的全双工实时交互能力,可以随时插话、打断,交流体验更接近真人通话。相关能力已应用于千问办公和 Qoder,并接入 QwenNote A2、QwenNote Eva 和千问 AI 眼镜等硬件产品
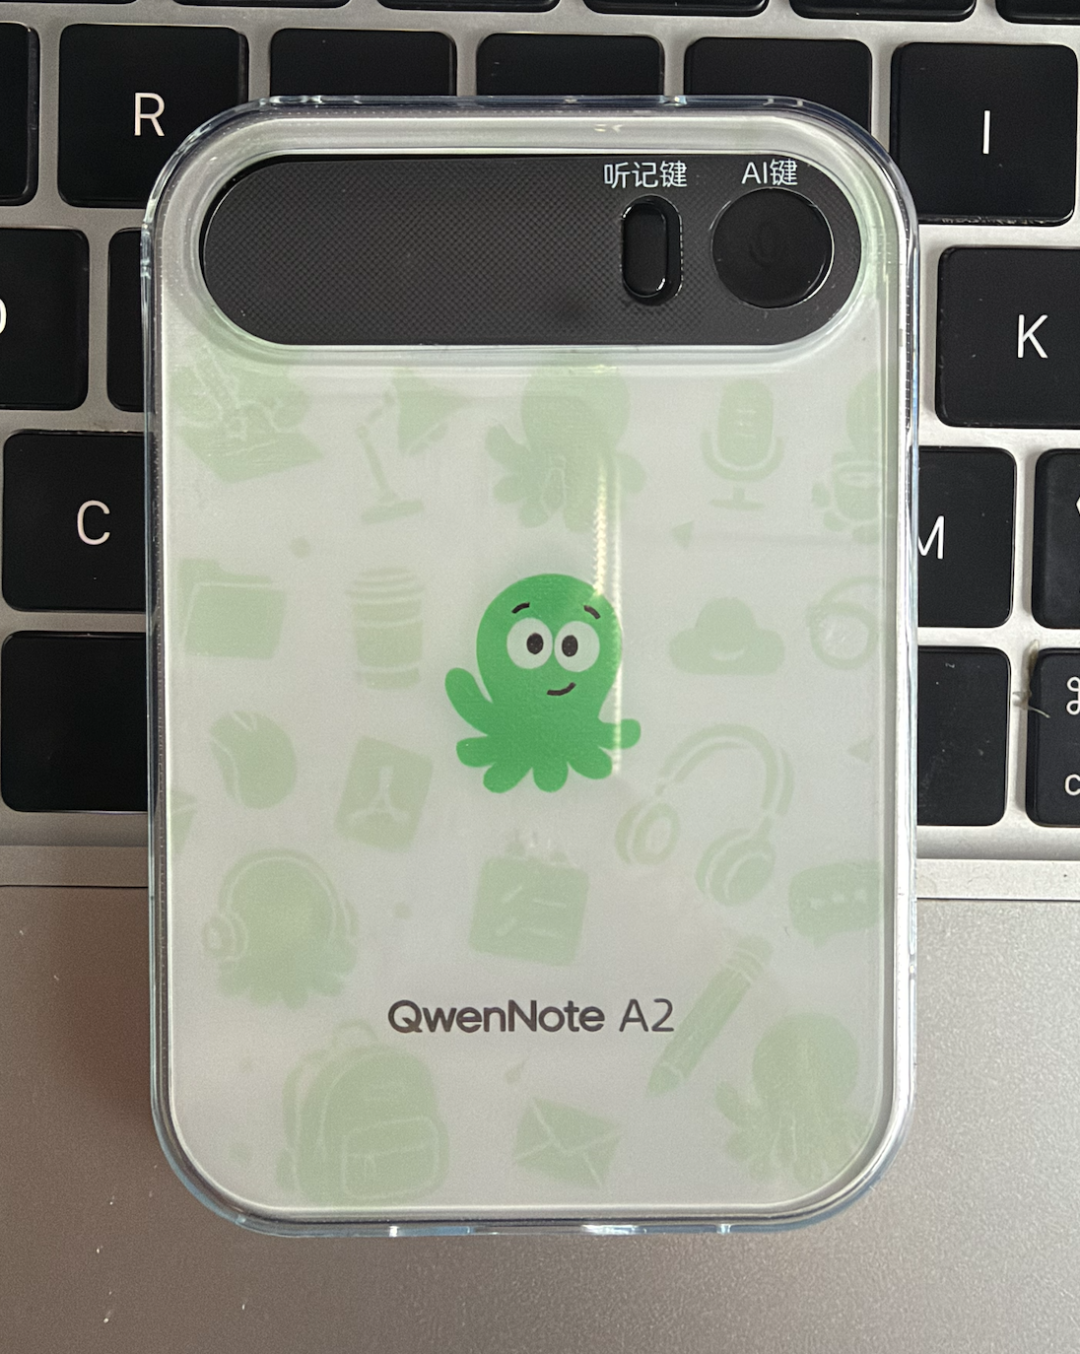
我之前实测过 Qwen3.5-Omni 改造蓝牙音箱:Qwen3.5 接入蓝牙音箱,联网搜索,秒变智能,现在有了支持随时插话、听懂情绪的 Realtime 能力,我已经在着手把我手头闲置的那台 M1 Mac mini 改造成全双工的私人桌面智能助理了,敬请期待
03 从工程拼装流水线,到原生端到端音频创作
经过这几轮实测,相信大家也能明显感受到这次技术迭代的分量
以往想要做出一期真正有沉浸感的音频作品,背后的流程极其繁重:
写完文案后,要找配音员录制干音,去各大音效库大海捞针搜集环境声与动作音效,再把几十条音轨拖进专业剪辑软件里,反复对齐气口、调均衡混响、做侧链压限闪避……主播、音效师、混音师、剪辑师四个工种接力,繁重的工程摩擦和协作门槛,直接把大部分创作者挡在门外
即使此前市面上有不少所谓的 AI 音频工具,也多半是把 ASR、传统单一人声 TTS 和现成素材库生硬拼凑在一起,不仅各模块之间接口脆弱,合成出来的声音也缺乏声场的真实感与交互流动
这次 Qwen-Audio-3.1-TTS-Next 最打动老章的,正是架构层面的范式跃迁:
它采用原生统一的端到端生成框架,把人声、音效与环境底噪直接融炼在同一个物理声场之中。你给它一段剧本,它还你一个有呼吸、有空间、有层次的声音世界
音频内容的创作门槛正在被彻底抹平,创作者彻底从繁重的多轨手工账中解脱出来,回归到最核心的叙事与创意,成为掌控全场节奏的声音导演
科技真正的魅力,就是把过去属于顶级录音棚的专业特权,轻盈地交到每一个坐在电脑前、怀揣灵感的普通人手中,让每个人都能轻松拥有自己的“一人音频工作室”
老章手搓的本地创作工具 Qwen Audio Studio 以及 Agent Skill z-qwen-audio-studio,代码与提示词模板都已经开源在 GitHub,欢迎兄弟们直接抄作业体验
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议

- 目前还没评论,等你发挥!