起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
体验驱动商业: AI 产品的体验评测思路


AI产品体验评测不能照搬互联网老套路。本文基于多次从0到1的实战经验,提出一套面向对话式大模型的评测体系:三层结构、三段旅程、四类影响因素,并详解如何通过真实用户、真实场景与AI特性测量创新,让评测结果可归因、可落地,真正驱动业务增长。
上一篇讲的是为什么 AI 产品需要体验评测,互联网的成熟体系不能照搬;这一篇重点讲「怎么做」:笔者基于在互联网行业多次从 0 到 1 搭建体验评测体系的实践经验,并参考 AI 相关文献,规划了一套面向对话式大模型(比如 DeepSeek 这类以多轮对话为主要使用形态的通用 AI 产品,下同)的用户体验评测体系。
本文主要回答两个问题:
- 这套 AI 体验评测体系的主要框架是什么,包含哪些内容?
- 它能带来什么价值?
一、这套体系是什么
1. 一张图看全貌:三层结构、三段旅程、四类影响因素
这套面向对话式大模型的用户体验评测体系的主干可以概括为三句话:三层结构、三段旅程、四类影响因素。
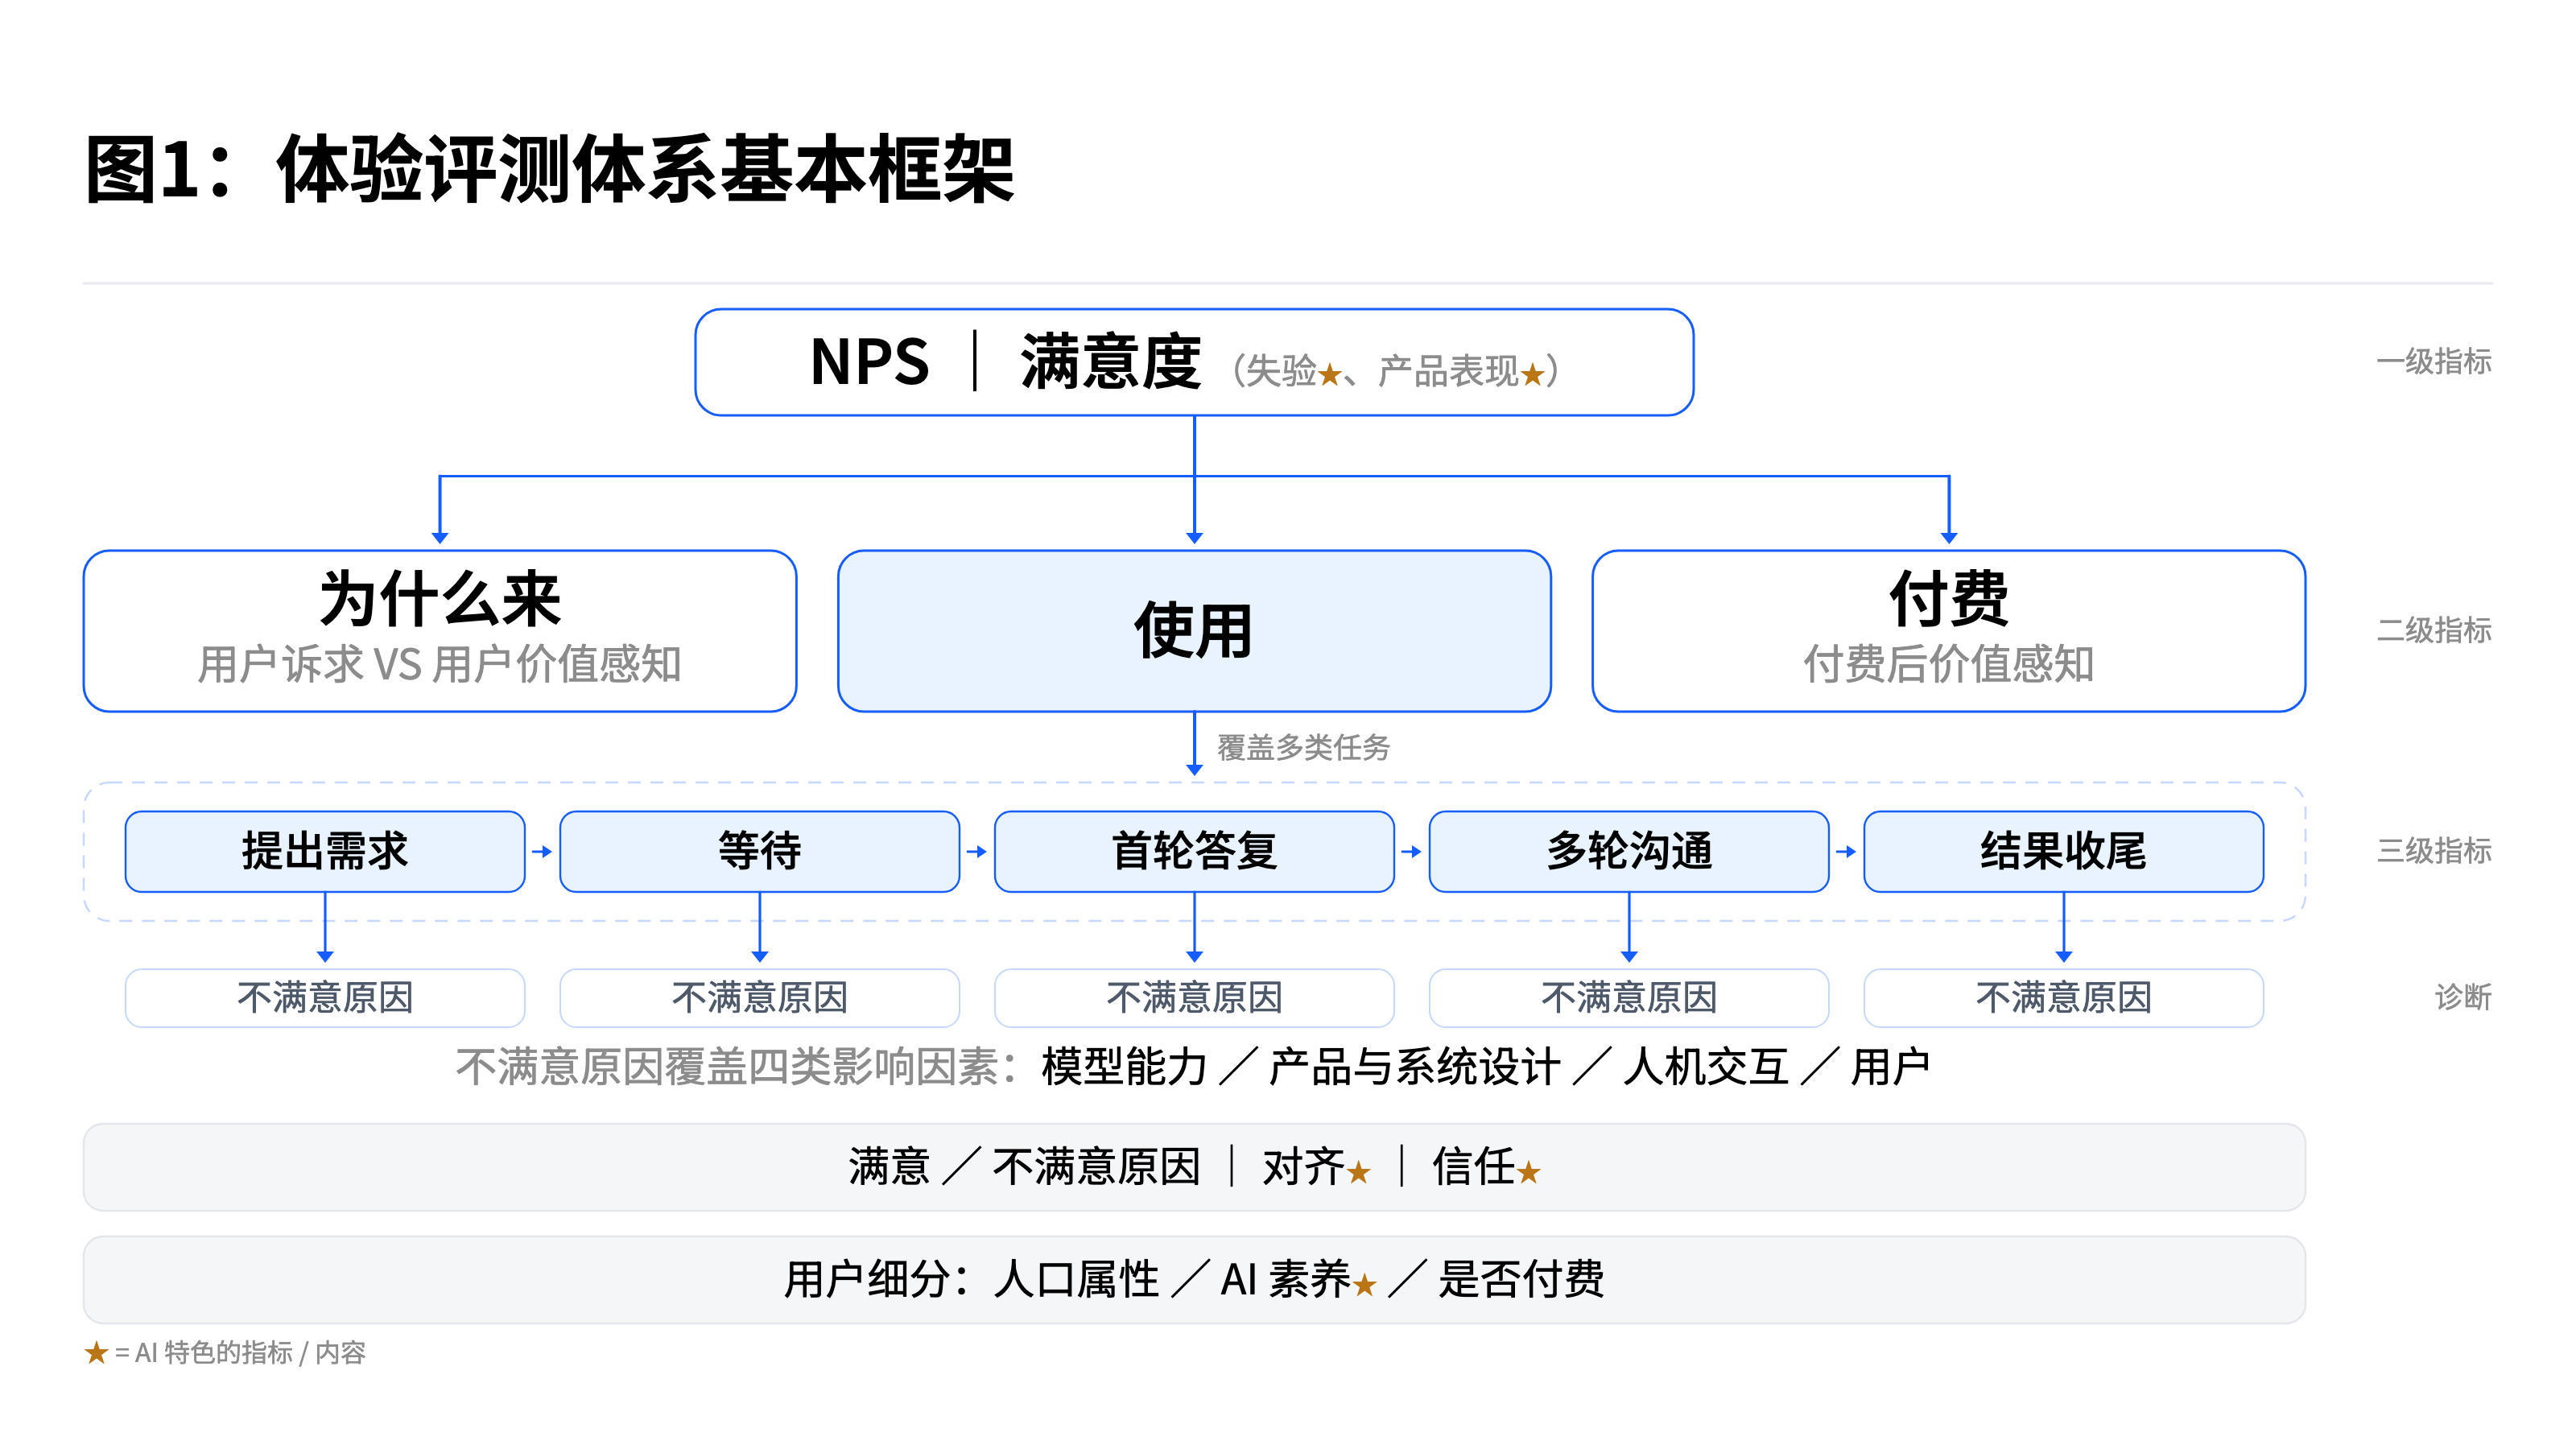
三层结构——从上到下,不断深钻,每一层回答不同的问题:
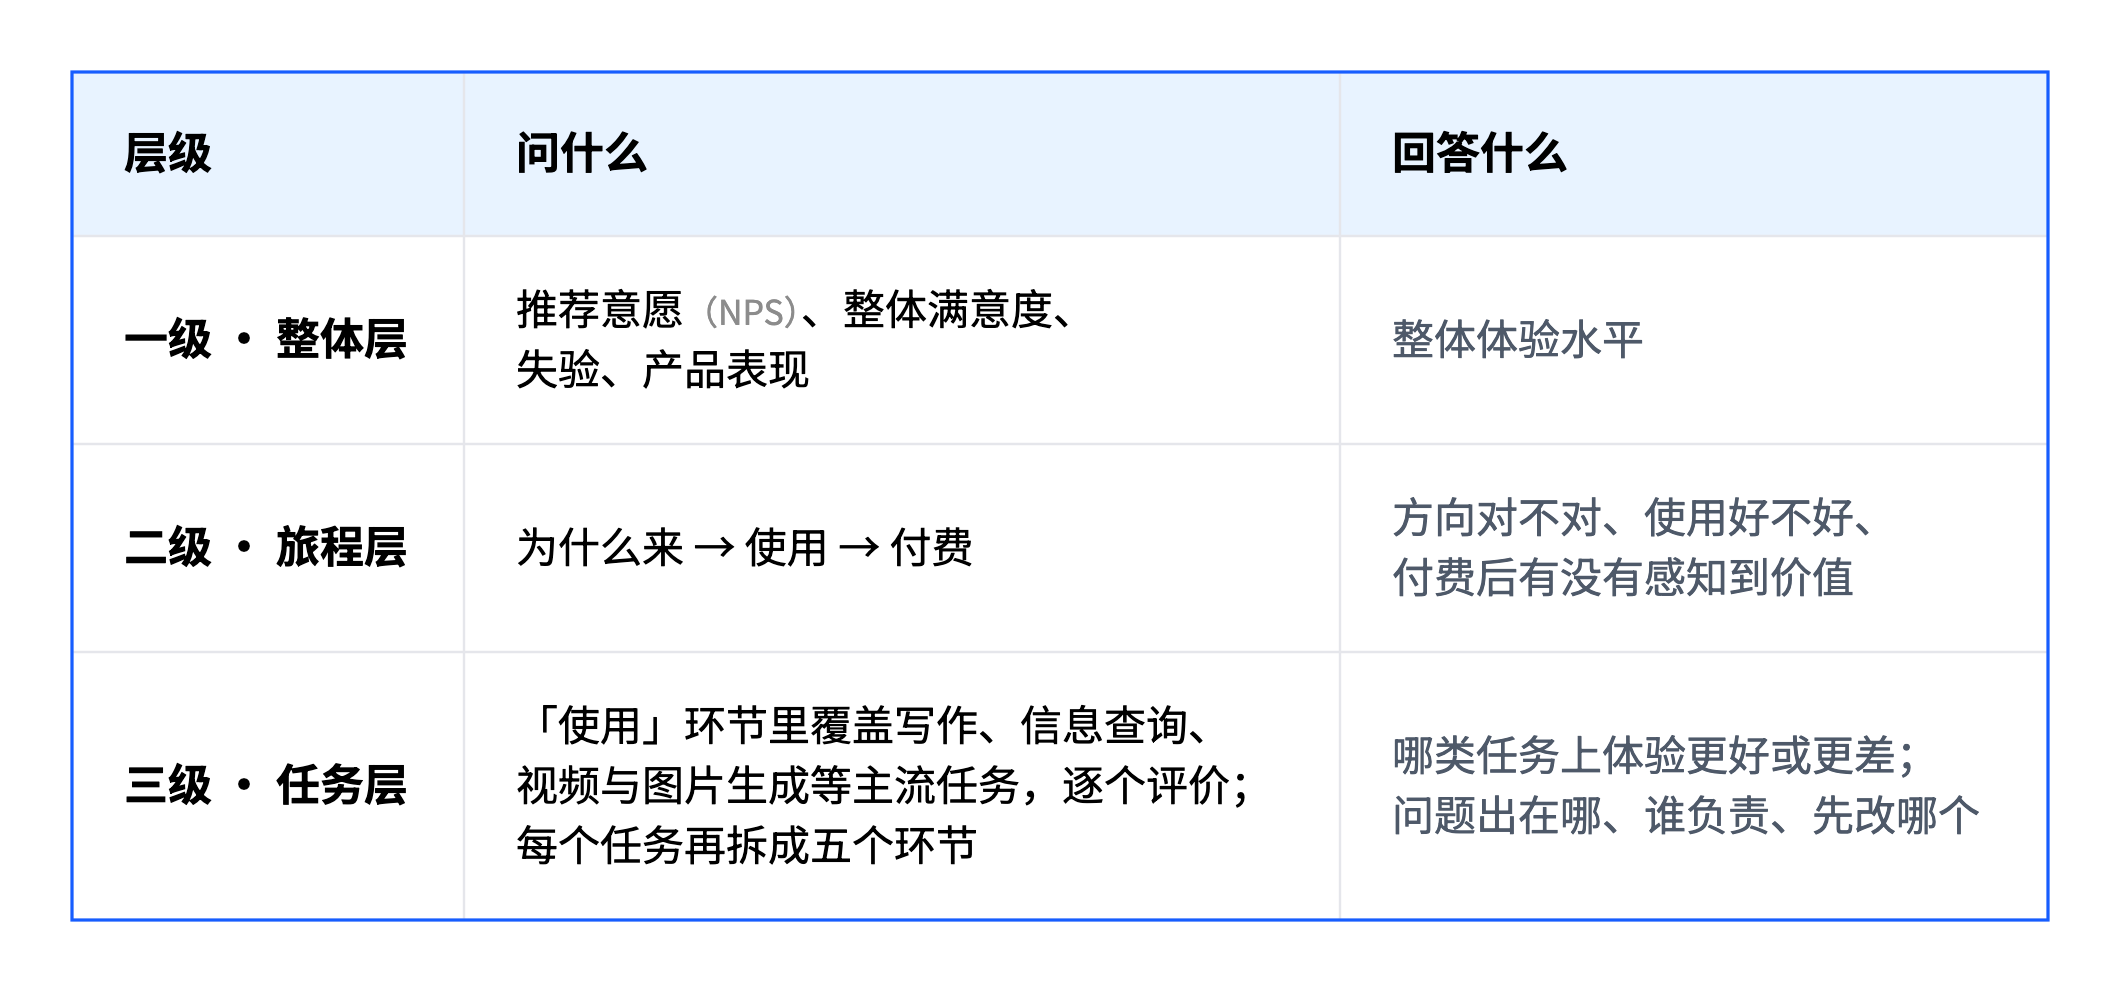
整体层:看清这个 AI 产品的整体体验水平,也可用于同类产品间比较,以判断竞争优劣势。
三段旅程:用户与一个 AI 产品的关系,分成三段:为什么来 → 使用 → 付费。
第一段目的是看方向,做的是业务方向诊断与机会探索,而不仅仅对现有产品功能、能力修修补补,毕竟如果方向偏了,机会错过了,损失远大于体验细节不理想;主要包含:
- 用户的核心诉求,产品有没有在承接?如果没有承接,这里是不是有机会?——这是机会探索;
- 如果承接了,再看用户最看重的是不是产品当前主打的,如果不是,原因是啥?——这一步对应业务方向诊断。
方向诊断后,再往下看诉求满足到什么程度、有哪些可优化的,这是第二段要回答的。
第二段是重点,是对用户实际使用体验的评估。这个模块会覆盖用户的主流任务——写作、信息查询、视频与图片生成等;每个任务单独评价,任务之间可以横向对比。具体任务可以再按使用旅程往下深挖,不同的任务会设计对应的内容,但主要框架基本都分五个环节:提出需求 → 等待 → 首轮答复 → 多轮沟通 → 结果收尾。
第三段是付费相关体验,主要看付费之后用户有没有感知到变化、感知到的价值如何。
四类影响因素——把影响用户具体使用体验的因素分成四类:
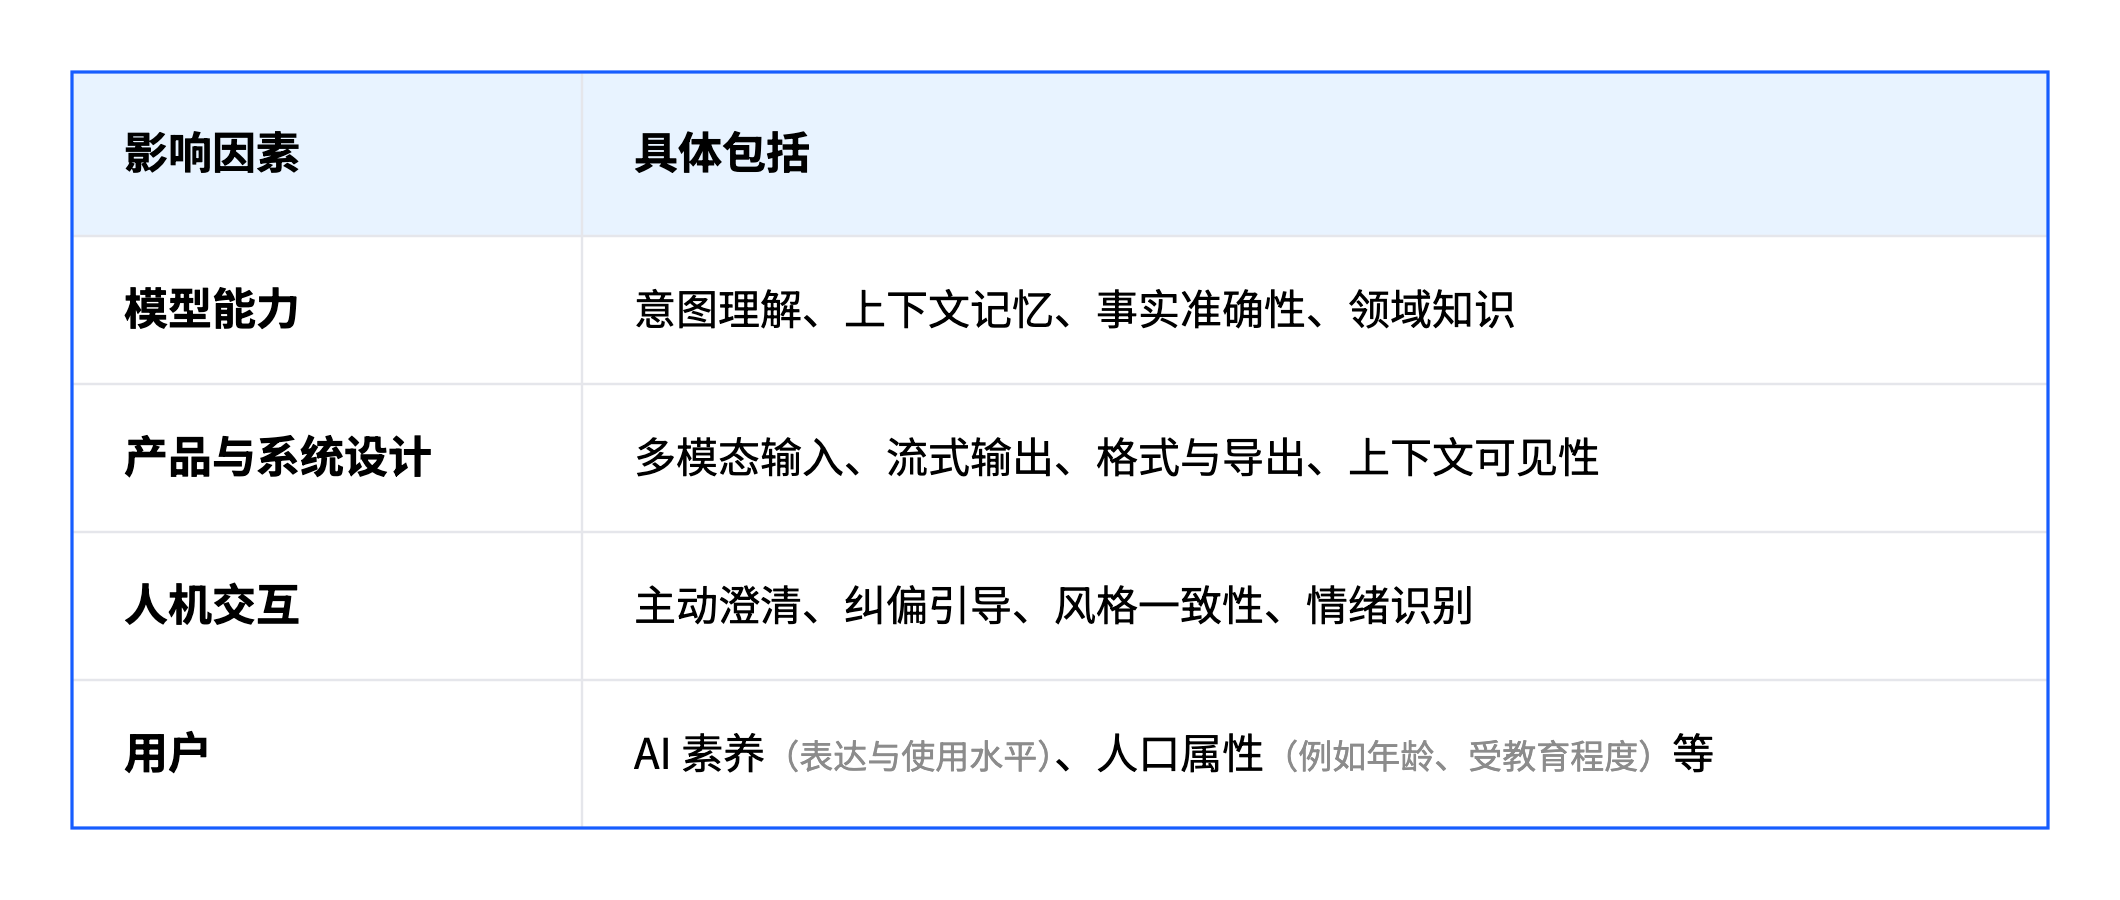
2. 这套体系适用于谁
这套体系面向对话式大模型产品,以已上线、有真实用户与后台行为数据的成熟产品优先。
有两点需要说明:
- 为什么以成熟产品优先。这套体系有四个数据源——问卷、使用行为、用户评论、对话记录;多来源数据可以相互印证、互为补充,帮助给出更深入、准确的洞察。尤其是问卷,要有足够多的样本量才具备可行性。已上线产品显然更容易拿到以上所需数据;当然,这套体系对于没有上线的产品也是有价值的,尤其是其中的评估指标、框架(按需选择,例如去掉付费相关的内容)用在内测、灰测阶段,也能帮助更早发现、解决问题。
- 它并不适用于所有 AI 产品。拆不出稳定使用旅程的产品,需要考虑其他的体验评测框架,例如按体验要素或功能来拆解。
3. 预计产出
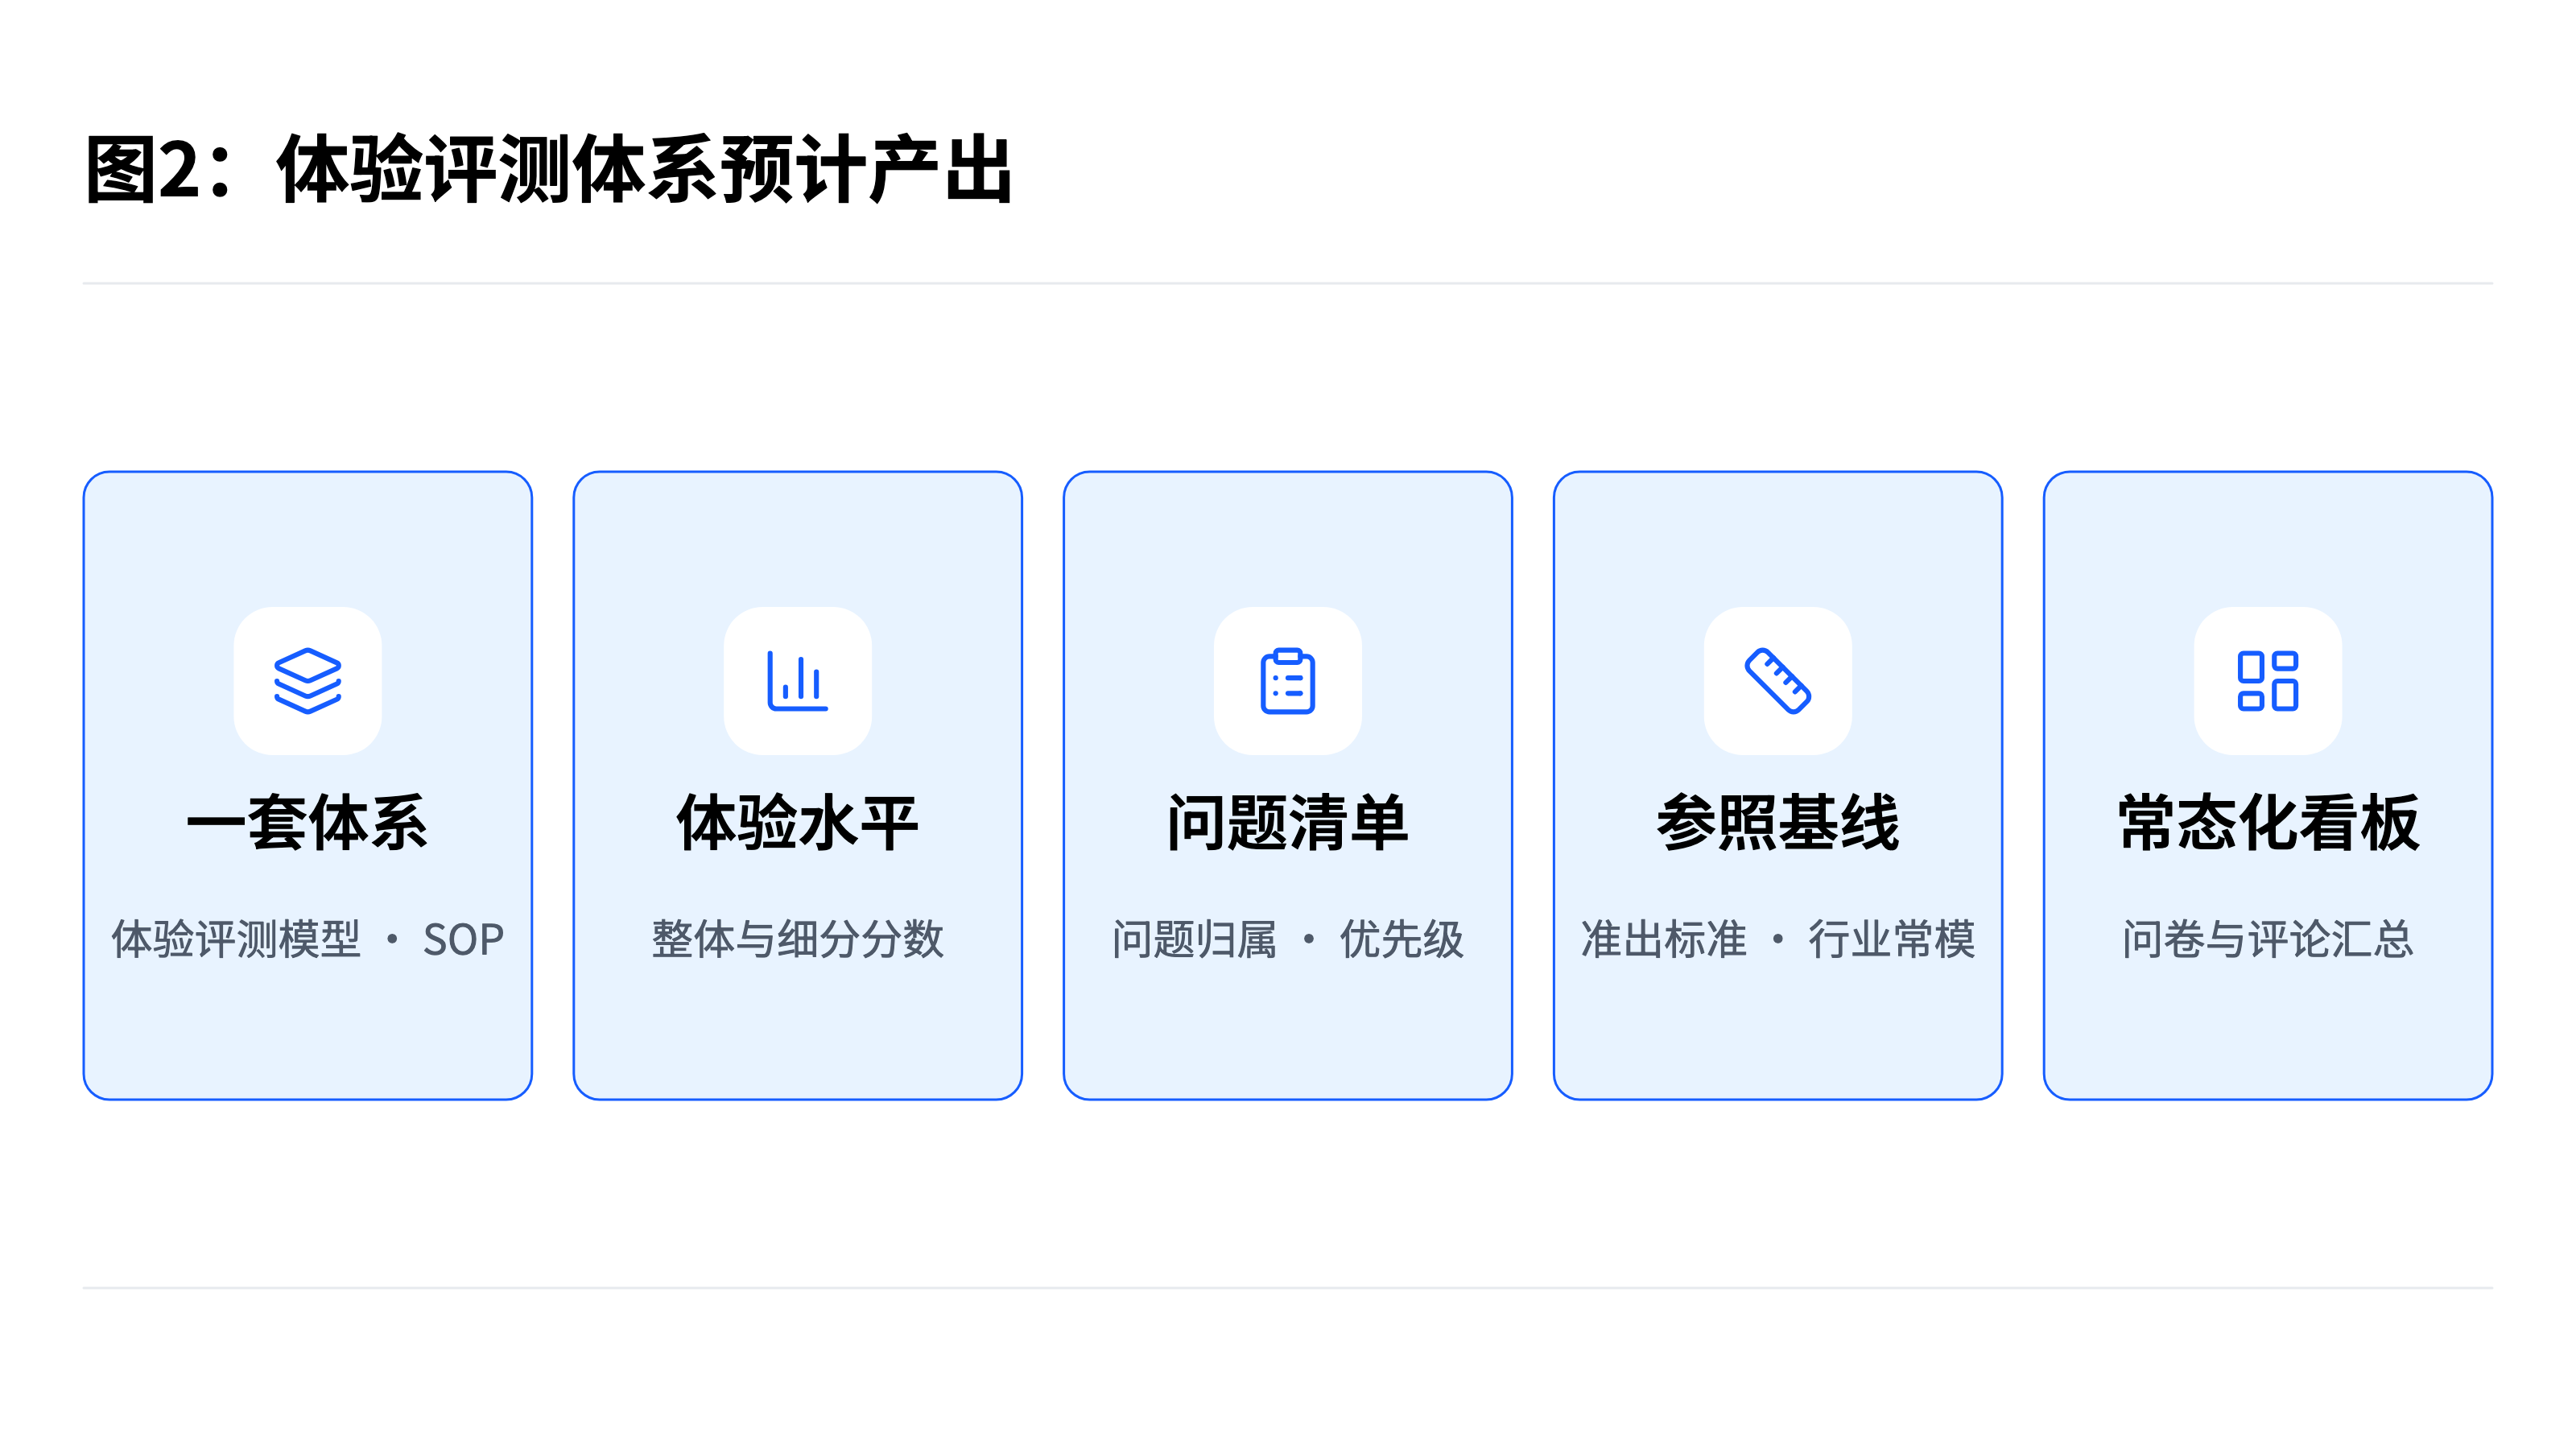
- 一套体系:体验评测模型(体验问卷、行为指标等);配套操作 SOP,包括问卷投放与分析、对话分析、评论打标等。
- 体验水平:整体水平;细分水平,按任务、旅程环节、人群等拆分。
- 问题清单:问题出在哪类任务、环节、人群;问题的性质与责任方;改善优先级。
- 参照基线:对内作准出门槛、监测预警线、周期目标值;对外作竞品对比、行业常模参照。
- 常态化看板:问卷、评论等按同一套评估模型打标,自动化收集分析,支持多维度下钻。
二、它能带来什么价值
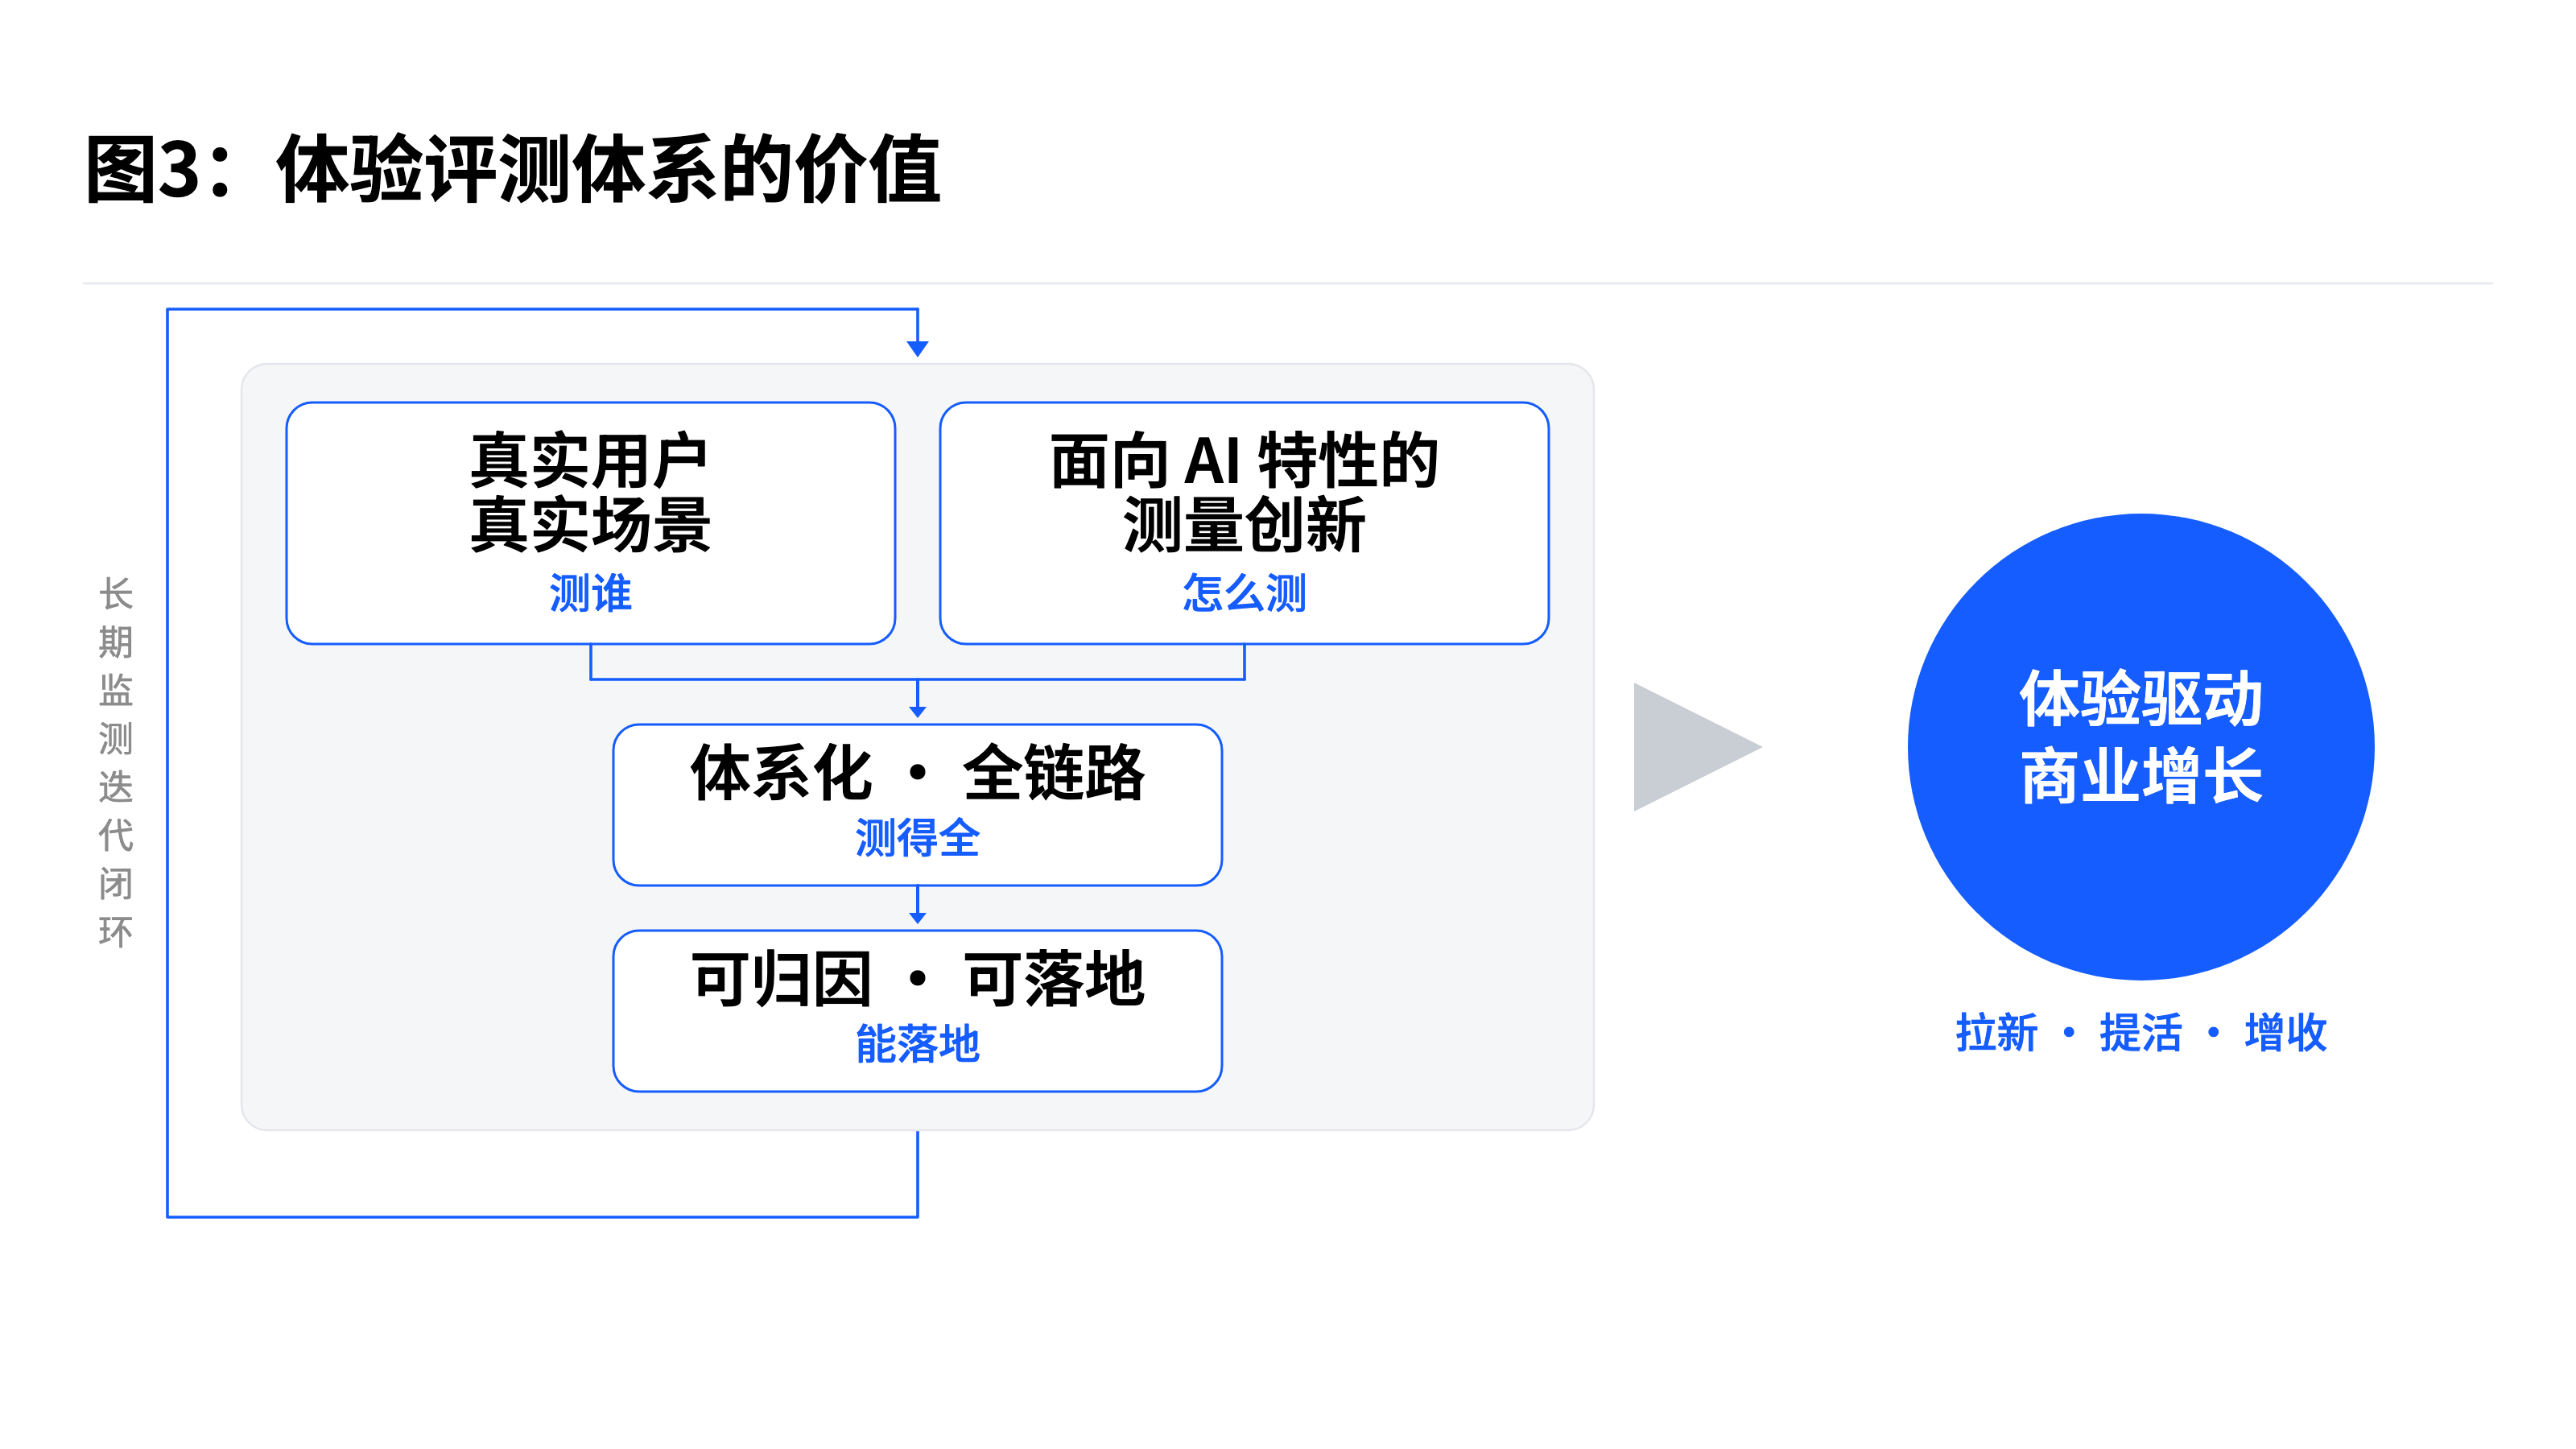
真实用户与真实场景决定测谁,面向 AI 特性的测量创新决定怎么测,这两点是基础。它们被体系化、全链路的框架组织起来,形成一条体验与业务的映射,从而实现体验评测结果可归因、可落地,驱动商业增长。
下面逐条介绍:每个价值意味着什么,以及为了实现它,笔者主要是怎么做的。
1. 真实用户、真实场景
这一点强调真实——它是拿到用户视角的准确结果的前提。只有测的人是真实用户,结论才能代表用户的真实心声。
1)真实用户
用户来源:只有真正使用过这个产品的用户才能参与评测。
用户结构:为了更全面、真实地代表大盘用户,本体系参考相关文献,选取了能影响用户体验的关键维度作为抽样框——人口属性(性别、年龄、职业等)、AI 素养、业务口径的用户分类(活跃与低活、付费与未付费);其中业务口径的分类按后台实际比例配比。
2)真实场景
本体系覆盖用户使用 AI 的主要任务与场景,以及影响体验的关键业务分工——产品、设计、营销、研发等。
2. 面向 AI 特性的测量创新
这一点强调「定制」——它同样是拿到准确结果的前提。AI 产品与互联网产品差异大,因此需要基于 AI 的产品特点,对测量模型的框架、指标、内容做针对性的调整。它分内容适配与方法适配两部分。
1)内容适配
- 框架:用户使用 AI 产品的旅程,基于用户的实际使用行为制定,以写作为例,整个过程分为五个环节——提出需求(说清要写什么)→ 等待(等它出稿)→ 首轮答复(拿到第一版)→ 多轮沟通(追问、补要求、让它改)→ 结果收尾(微调定稿或放弃)。
- 已知问题:幻觉与编造、上下文遗忘、谄媚、不认错、输出不稳定等 AI 体验问题,也会纳入调研,主要体现在不满意原因的选项中。
- AI 独有的研究内容:AI 素养、对齐、信任这类对体验有重要影响的新内容,笔者也参考文献,设计了相应的评估指标。
2)方法适配——主要从体验指标、研究方法、统计分析三方面入手。
体验指标:这里涉及内容较多,笔者仅以对满意度的调整为例,展示思路:
满意度是非常常用的体验指标,是用户预期与产品表现比较的结果。在互联网体验研究里,满意度得分往往被等同于产品表现,即某个产品满意度低,就得出结论:该产品不够好,一般不会去反思用户预期是否有问题;
但在 AI 产品里,用户预期的影响作用可能更大(毕竟 AI 是新产品,用户对 AI 的预期是不断变化的,且人群间差异很大),因此一个满意度低分,可能是预期本身不合理,也可能真的是产品表现有问题,只看满意度分不清背后的真正原因。因此在满意度之外,笔者参考文献增补失验与产品表现两个指标:失验把预期的作用拆出来,产品表现给出不含预期的产品评价分,两者配合,才能找出问题的真正原因。
研究方法:互联网产品做用户研究,主要通过访谈,来获取具体的使用细节、问题原因。但对话类 AI 产品不一样:一次使用就是一段多轮对话,细节多、内容量大,用户事后很难完整回忆当时为什么那样问、那样追问,回忆出来的信息既不一定准,也漏掉很多。因此在访谈之外,补充对话分析——直接看用户与产品之间的真实对话记录,以更细致、准确地理解用户的需求与问题。
统计分析:传统的体验指标是按「确定性界面」设计的——默认同样的输入得到同样的输出。但 AI 产品的体验有以下两个特点:
一是波动:AI 的表现并不稳定,同一个问题不同时候给的答案可能不一样,不同用户的感受相应就有差异;如评测只给一个平均分,会把「AI 表现一直平稳」和「结果忽好忽坏、平均下来还行」混在一起,错失真相。因此,除了看整体分,还要看评分的离散程度,据此侧面评估 AI 表现稳定性。
二是漂移:不仅仅是版本升级,AI 的体验水平还会因其他原因而变化;用户侧,对 AI 的预期在持续校准;产品侧,模型一直在迭代。只测一次,或者只对比发版前后的体验分数,看不出体验变化走向。因此,除了看整体分,还需要在多个时间点上反复测量,据此看清体验变化的趋势:是变好、还是变坏。
3. 体系化、全链路
这一点强调测得全、测得深。它是从评测内容搭建、分析到落地的一整套计划,能从整体下钻到具体问题:
1)横向:四个数据来源综合分析
- 互补:问卷数据、行为数据、评论内容、对话记录,每个数据源都有自己的优劣势;综合分析,能看到更多、更全的信息。
- 互证:基于多个数据源来帮助决策,增加信息的可信性与准确性。
2)纵向:一路下钻
- 整体层:给业务高层看整体体验水平与方向的大致判断。
- 旅程层:看三段旅程各自的表现——方向对不对、使用好不好、付费有没有感知到价值。
- 任务层(写作、视频生成等):让各任务负责人看清自己负责那一块的体验水平,也便于不同任务之间比较;再拆到五个环节,看清用户从头到尾的使用过程,便于更具体地定位问题。
4. 可归因、可落地
这一点强调结论要能实际服务于业务需要。测完给出的不只是一组分数,而要能清晰地回答:优势和短板分别在哪里、问题出在哪些任务环节上、该谁负责、先改哪个。
为了实现这个目的,笔者建立了一条体验与业务的映射,其分为结构与内容两方面:
1)结构上:以用户旅程为主线的分层评估框架
整套框架以用户旅程为主线,从上向下逐层覆盖影响用户体验的关键环节、角色、因素——产品、模型能力、人机交互等,目的在于让体验分/问题能按层级拆解、落到责任方。
2)内容上:建立起一条从用户诉求出发、回到用户体验的通路
首先,以用户视角拆解诉求与体验要素 → 与业务(功能/角色/任务/影响因素等)对应 → 将相关影响因素、功能等翻译成用户能懂的语言,制作成让用户评价的指标、选项 → 用评分、不满原因选择结果等诊断业务。
其中「与业务对应」分两部分:
一是用户诉求与用户价值感知的对比 → 业务方向诊断与机会探索;
二是对现有产品/功能的评价 → 使用体验的诊断。
以上四条搭建起了基础框架,但想让体验评测真正见效,还要把它变成一条长期监测、迭代闭环的链路,毕竟,AI 产品在不断变化、升级;单次测量往往不够细,还需要通过专项再深挖原因、探索对策;改动之后到底有没有效果,也要放到下一次体验评测里再评估。因此体验评测不是单次调研项目,而是一项「系统性工程」:发现问题、改进、再评估效果的链路,只有这样才能实现体验驱动商业增长。
三、垂直 AI 产品:可参考同一套框架,按业务微调
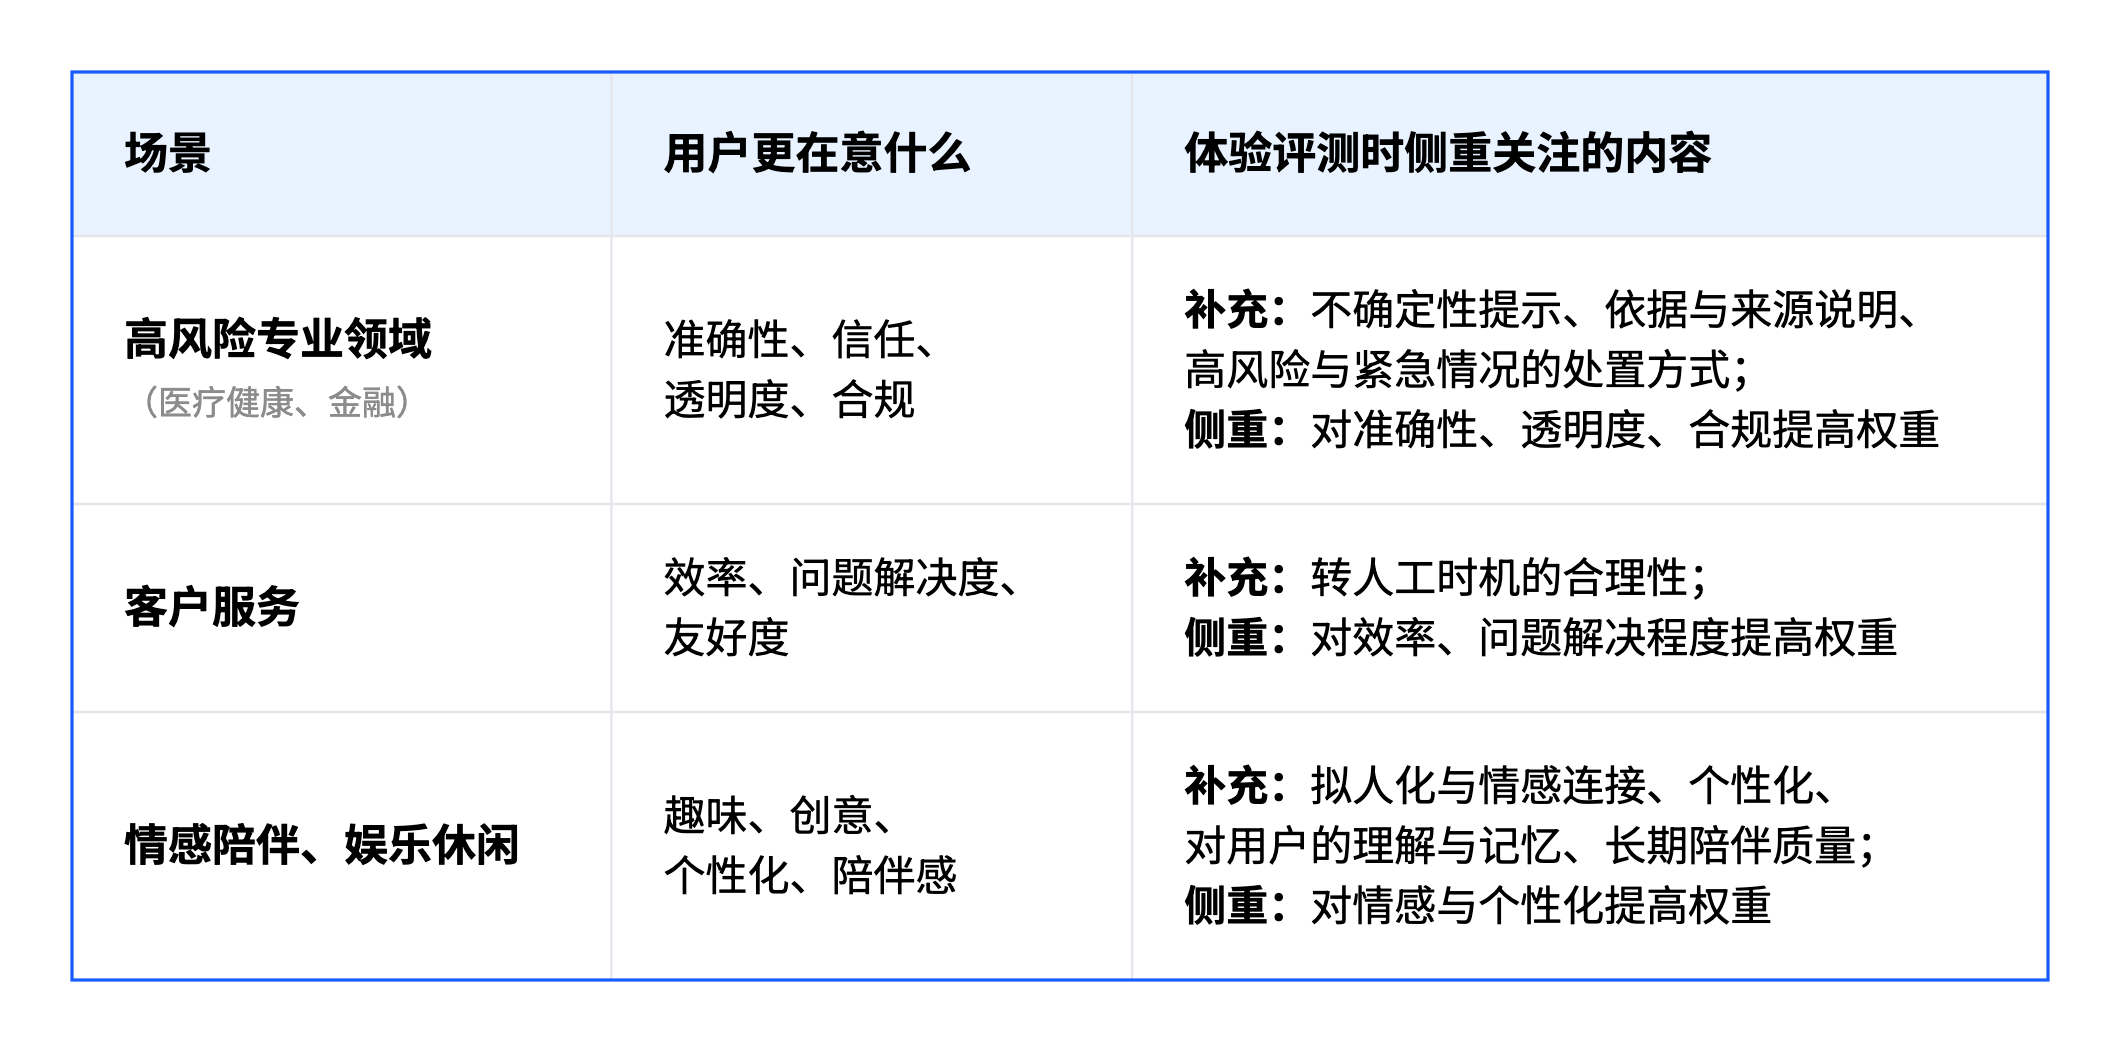
上文介绍的是一套面向通用对话大模型的体验评测体系。对于面向具体场景的垂直 AI 产品,比如医疗健康、金融、情感陪伴等,本体系依然有一定适用性,但不能照搬:可以在这套框架基础上,再按业务特点做适配。
适配主要有两个方向:
- 调整内容,基于用户的诉求和产品的功能特点等,增删指标或选项;
- 调整分析侧重,例如给更重要的指标更高的权重。
下面以三类较典型的垂直 AI 为例,展示适配的思路:如何调整内容、分析时侧重关注什么:
这一套体验评测框架对智能体(Agent)类产品也有借鉴意义。两者的交互形态都是多轮自然语言对话,用户对透明度、交互节奏、主动性、纠错方式的偏好也是相似的,这部分测量内容可以复用;但智能体把交互从对话延伸到了任务执行,还要补充新的测量内容,评估对象要从回复质量扩展到任务是否完成、步骤是否可控等,对应的旅程也需要重新设计。这部分内容笔者会另起一篇展开。
四、写在最后
前面讲的是这套体系包含哪些内容、具备什么价值,以及如何适配到更多业务场景。
不过坦白地说,AI 产品的体验评测还是一个比较新的领域,成熟的做法与共识仍在形成之中,这套体系也谈不上完善:它目前处于设计完成、尚未实投验证的状态,框架、指标、题目与归因映射都已就位,缺的是一个真实的业务场景把它用起来。效度与解释力究竟如何、哪些地方还需要调整,最终要在实际业务里跑过才知道。
此外,这套体系里还有一些可以展开的内容。比如:为什么在满意度之外还要补充失验与产品表现两个指标、AI 素养该怎么定义与测量、为什么按用户旅程拆解而不是按体验要素拆。这些会在后面几篇文章里再具体讨论。
如果这套思路对你在做的 AI 产品有参考价值,欢迎交流讨论。
附:本篇主要参考文献:
- Chatterji et al.《How People Use ChatGPT》(NBER WP 34255, 2025)
- Dakan & Feller《The AI Fluency Framework》(Anthropic, 2025)
- Amershi et al.《Guidelines for Human-AI Interaction》(CHI, 2019)
- Petrova et al.《Unpacking Human Preference for LLMs》(ICLR, 2026)
- Marconi et al.《Assessing Interaction Quality in Human–AI Dialogue》(MAKE, 2026)
- Fragiadakis et al.《Evaluating Human-AI Collaboration: A Review and Methodological Framework》(arXiv, 2024)
- Møller et al.《Metrics of Success: Evaluating User Satisfaction in AI Chatbots》(ICAAI, 2024)
本文由 @晚风 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!