起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
这 6 本 GitHub 上的开源 AI 宝典,那是相当有真东西。


六本在 GitHub 上开源的中文 AI 教材,从讲透 Agent 等于 LLM 加上下文加工具的《深入理解 AI Agent》,到把大模型算力账算明白的 AI Infra、蒲公英书第二版与通识版,以及谷歌 Agent 设计模式的 21 个模式中文译本。

01 《深入理解 AI Agent》
《深入理解 AI Agent:设计原理与工程实践》这本书挺不错的。
这个开源项目包括 PDF、配图、EPUB 和配套实验代码,现在有 4.9 万个 Star,还在持续更新。
我每天上下班就抽空看看,基本看完了。
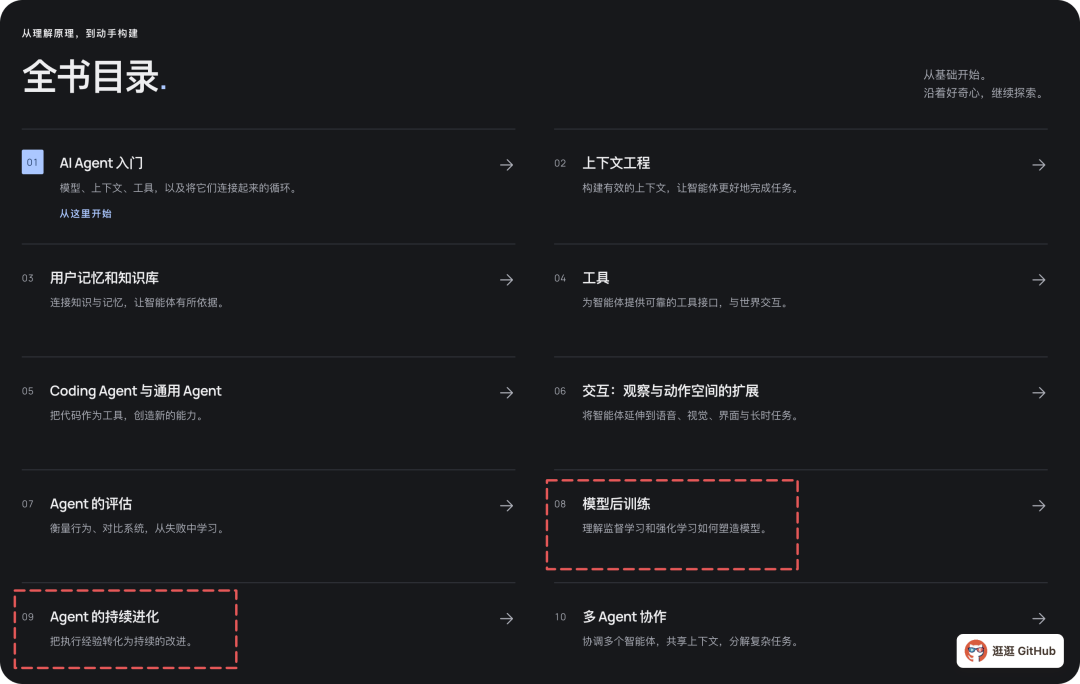
全书围绕一个公式展开:Agent = LLM + 上下文 + 工具。模型之外的工程能力 Harness 才是竞争力所在。
可以看下目录,除了基础的上下文工程、记忆、Tool 之外。
还讲了一些模型后训练、Agent 进化、多 Agent 协作的相关东西。
干货满满。
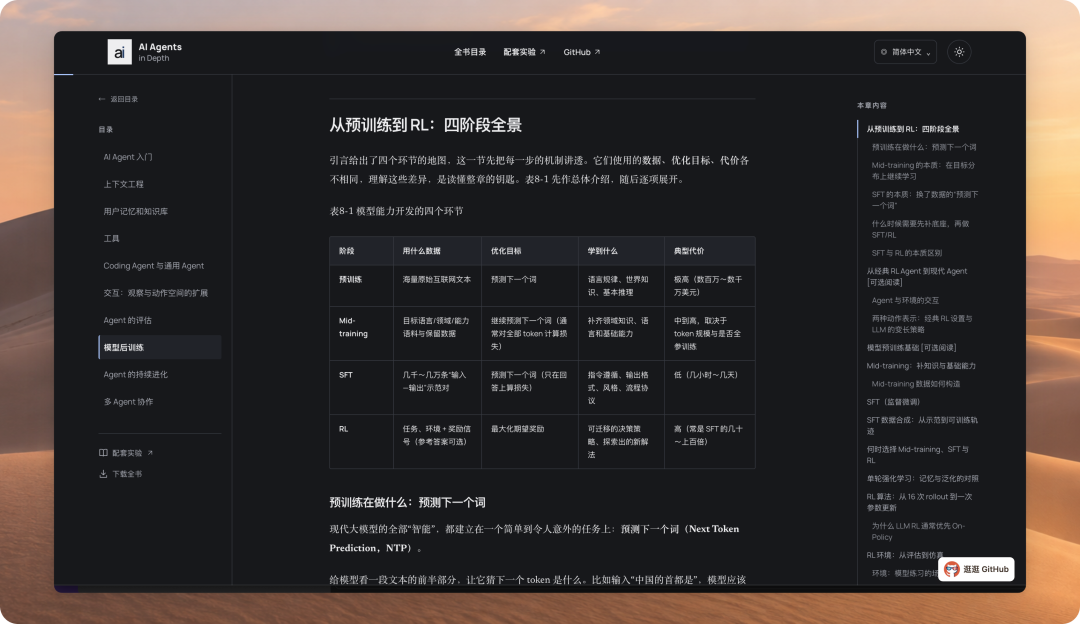
开源地址:https://github.com/bojieli/ai-agent-book
02 《深入理解 AI Agent》姊妹篇
在上面《深入理解 AI Agent》之后,开发者博杰又开源了《深入理解 AI Infra:量化分析与系统设计》。
现在 4600 多个 Star。
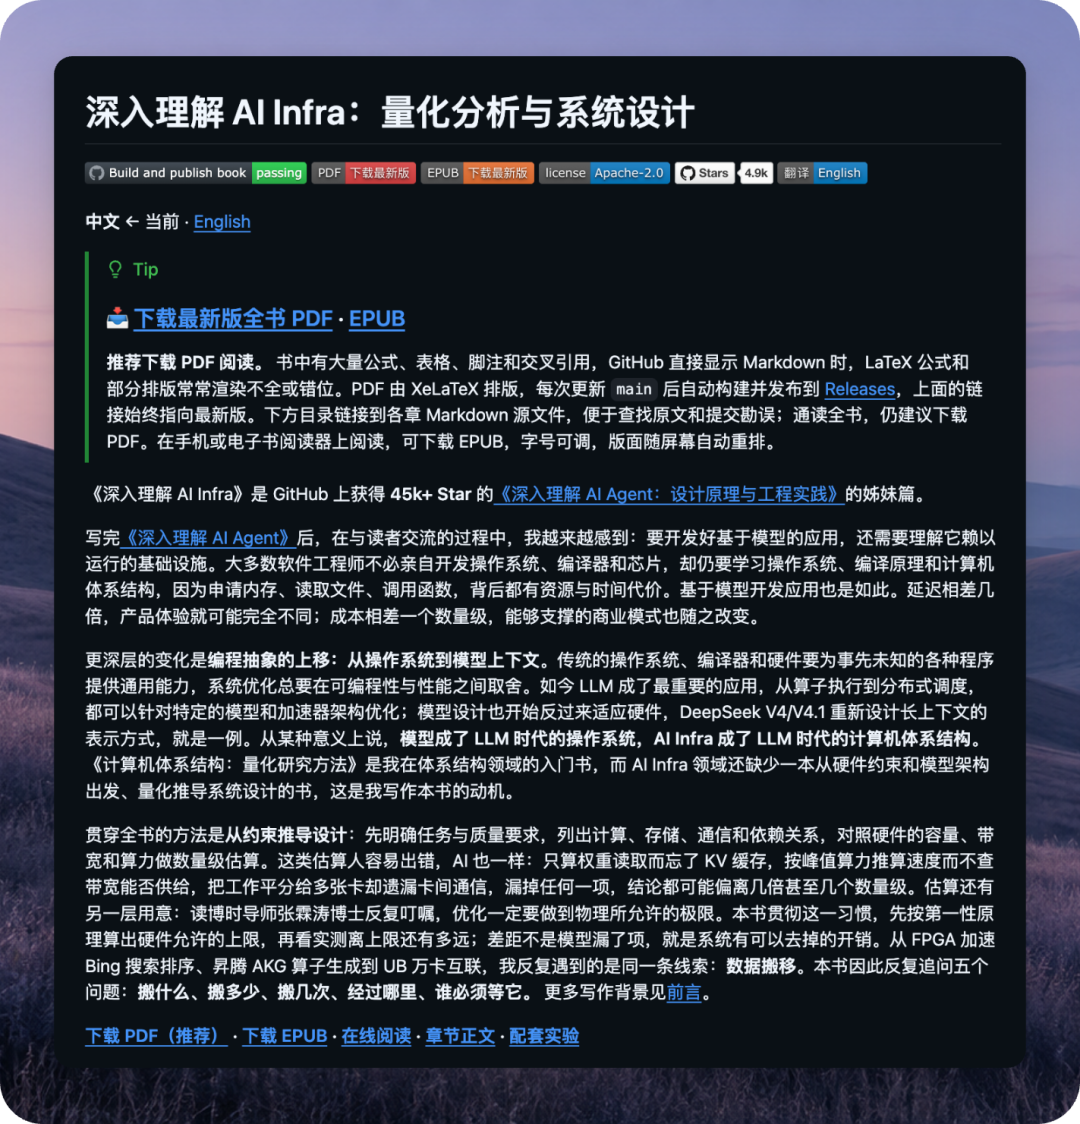
讲的是怎么把大模型跑起来要花的资源账算明白。
打个比方,开餐厅前你得算清一天来多少客人、厨房要多大、食材从仓库到餐桌走多远、哪个环节可能会有问题。
算明白了这些才知道怎么安排。
调用一次大模型背后也是显卡的调度啥的,这本书就是教你逐项估出计算量、显存、带宽和功耗。
再对照硬件真实能力去推导系统该怎么设计。
延迟差几倍体验就完全不同,成本差一个数量级,商业模式可能都不一样了。
所以这本书涉及架构、推理与训练负载、分布式推理、推理优化啥的。
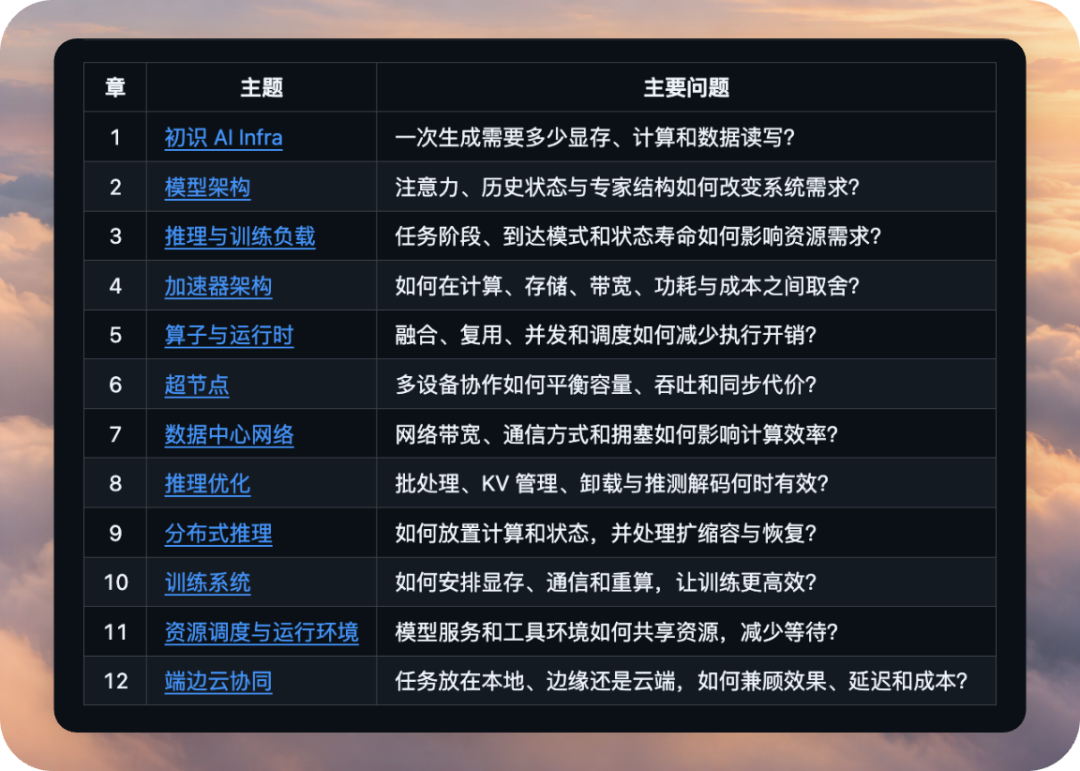
开源地址:https://github.com/bojieli/ai-infra-book
03 蒲公英书,出了第二版和通识版
邱锡鹏的《神经网络与深度学习》在中文圈被叫做蒲公英书。
第一版 2020 年出版之后,一直是不少人入门深度学习的第一本中文教材。
现在这个开源项目是第二版和通识版的电子稿,两个版本都能免费下载。
这个 GitHub 项目目前有 1.9 万个 Star。
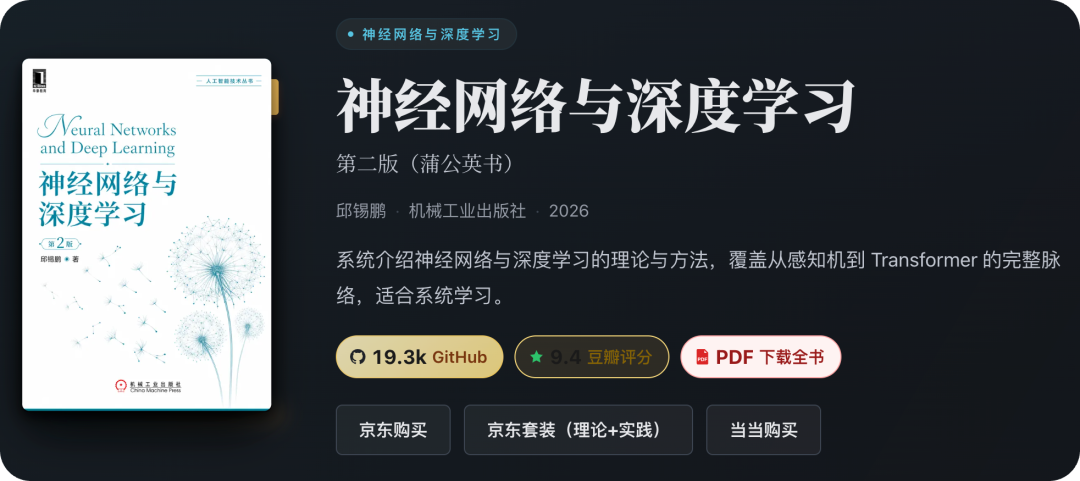
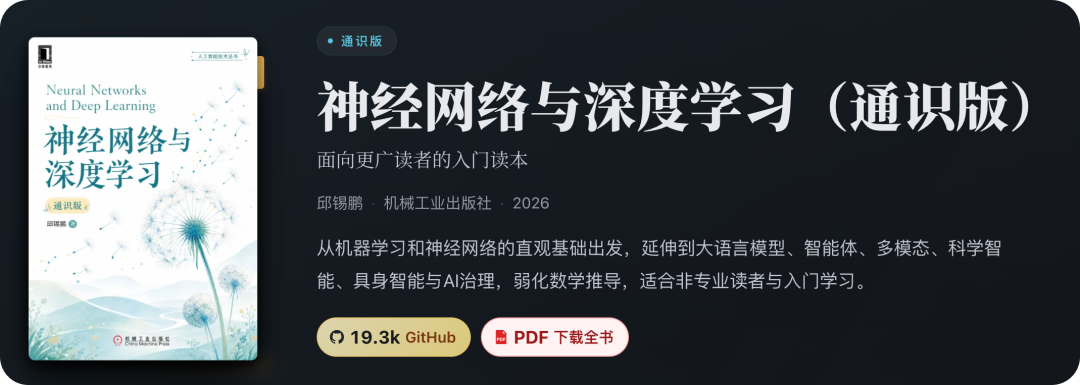
通识版是少一些公式,用故事、案例和生活里的类比来解释神经网络和深度学习。
第二版就更偏向系统学习理论。
可以先用通识版建立直觉再看第二版啃理论。
开源地址:https://github.com/nndl/nndl
04 从数学角度讲强化学习
《强化学习的数学原理》,这本书目前有 1.8 万个 Star。
从数学角度讲强化学习,作者的目的是让读者不只知道算法怎么跑,还能明白它当初为什么被设计成这样,以及为什么有效。
读这本书不需要任何强化学习背景,但可能需要有概率论和线性代数的基础。
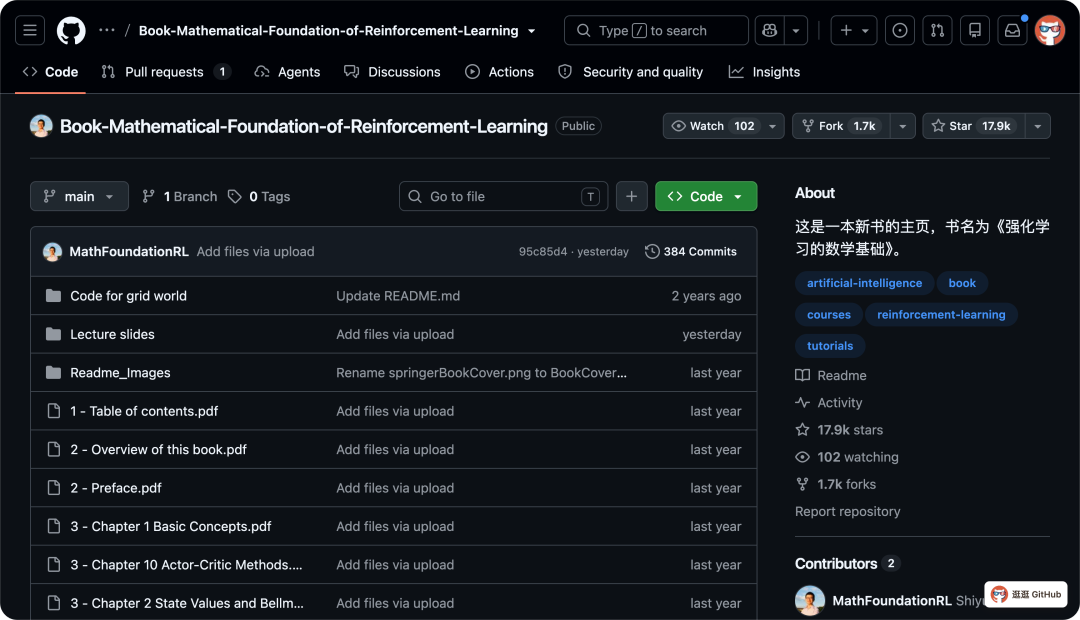
今年 3 月,伦敦政治经济学院的经济学讲席教授还写信给作者,说这本教材把强化学习讲得极为清晰,堪称一件艺术品。
美国南加州大学化学工程与材料科学副教授也来信,说书里对概念和算法的讲解深入浅出,很适合工程专业的学生。
两位学者分别来自经济学和化学工程领域,都在自己的课堂上用了这本教材。
中英文两套课程分别放在 B 站和 YouTube 上,全网播放量已经突破 270 万次。
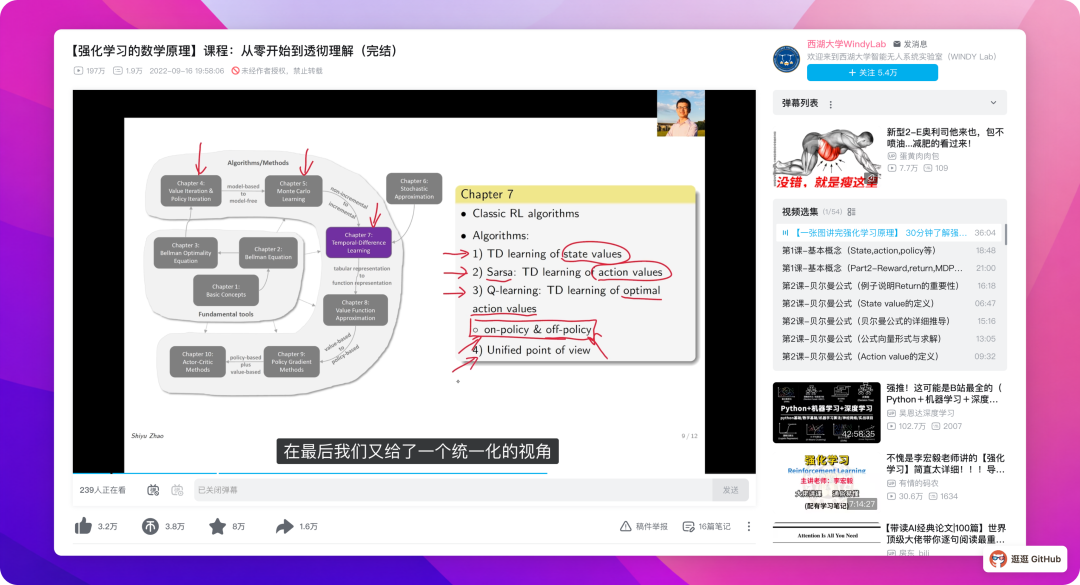
开源地址:https://github.com/MathFoundationRL/Book-Mathematical-Foundation-of-Reinforcement-Learning
05 谷歌那本 Agent 设计模式,有中文版了
在谷歌工作多年的老哥写了一本《Agentic Design Patterns》,把构建 AI Agent 的套路整理成 21 个设计模式。
作者自己也把电子版免费放了出来。
开发者 xindoo 牵头把它翻译成了中文,正文 21 章加 7 个附录全都译完,现在有 8K 多个 Star。
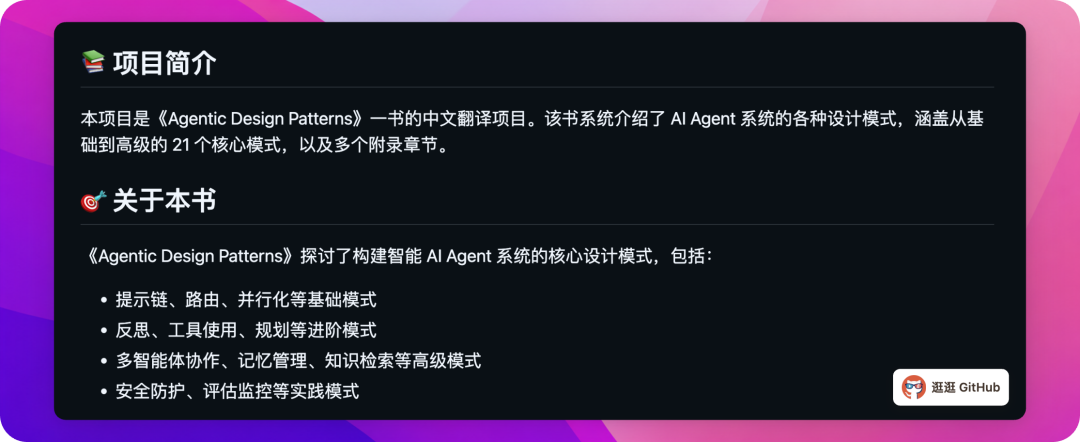
可以看看下面这个目录。
包括提示链、路由、并行化、工具使用、规划、多智能体协作等等核心的介绍。
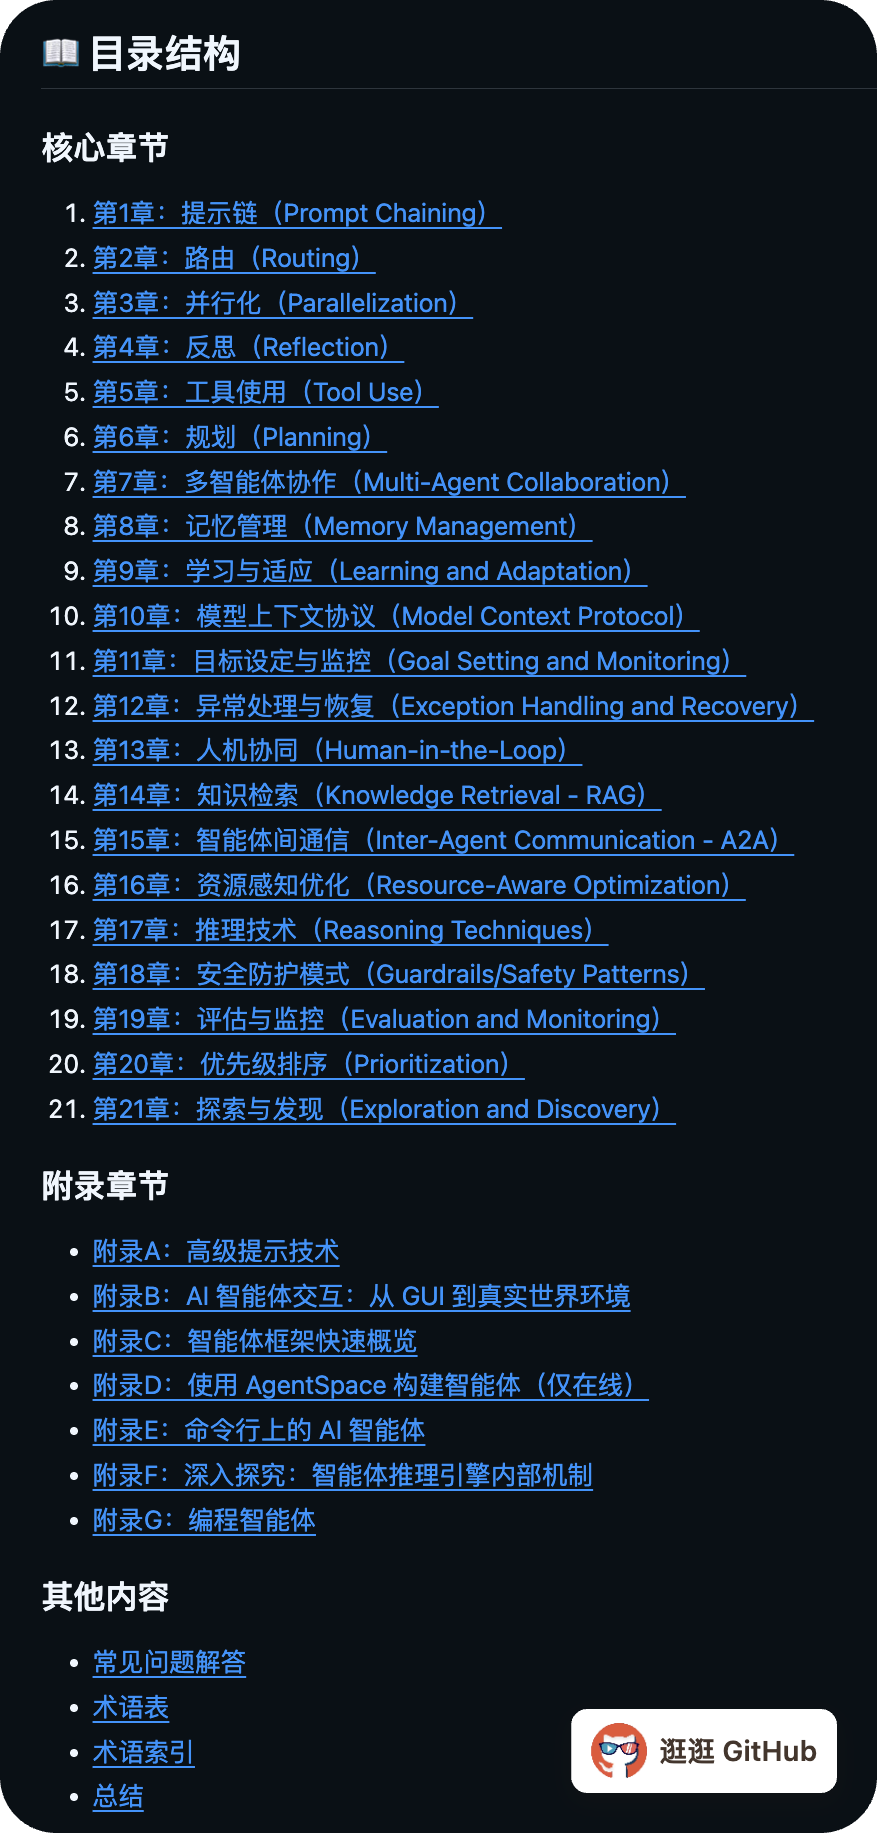
由浅入深。
后面几章就是比较复杂的场景,比如多个 Agent 怎么分工协作、记忆、 RAG 啥的。
还有一些偏工程落地的,比如安全防护、评估监控、资源感知优化啥的。
想读中文的话,浏览器访问 adp.xindoo.xyz。
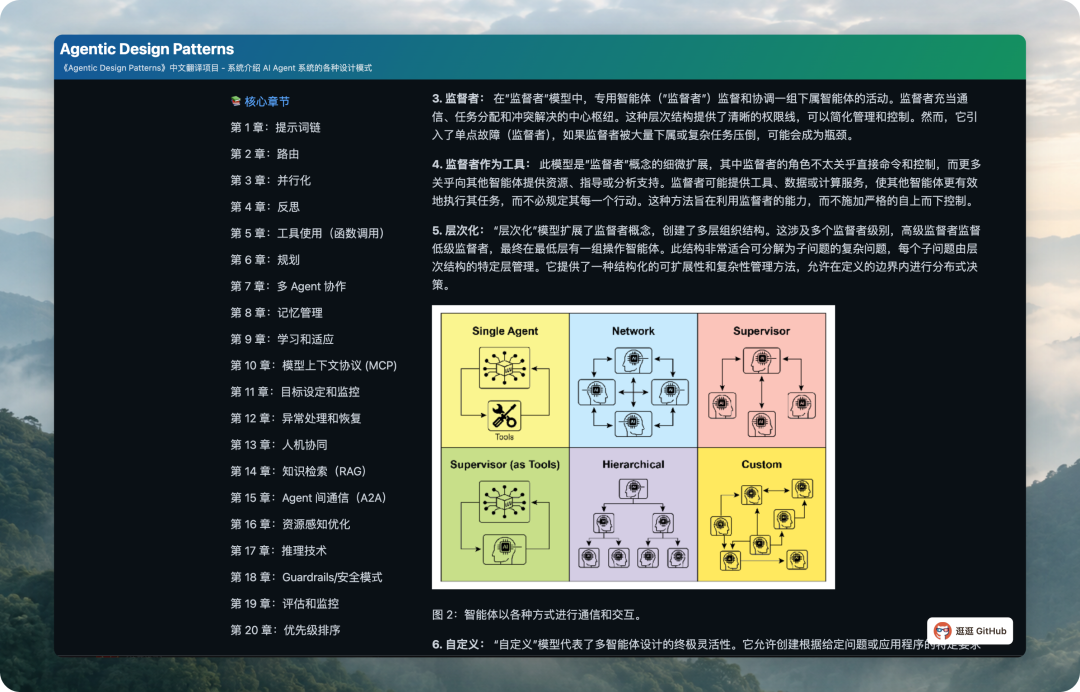
清华大学出版社的中文纸质书《Agentic 智能体设计模式》也在卖。
开源地址:https://github.com/xindoo/agentic-design-patterns
06 从 CartPole 讲到大模型对齐,还能在浏览器里训练
WalkingLab 开源的 Hands-On Modern RL 是一个开源的强化学习实战教程。
主要讲的是基础强化学习和大模型对齐、Agentic 系统。
现在 4400 多个 Star。
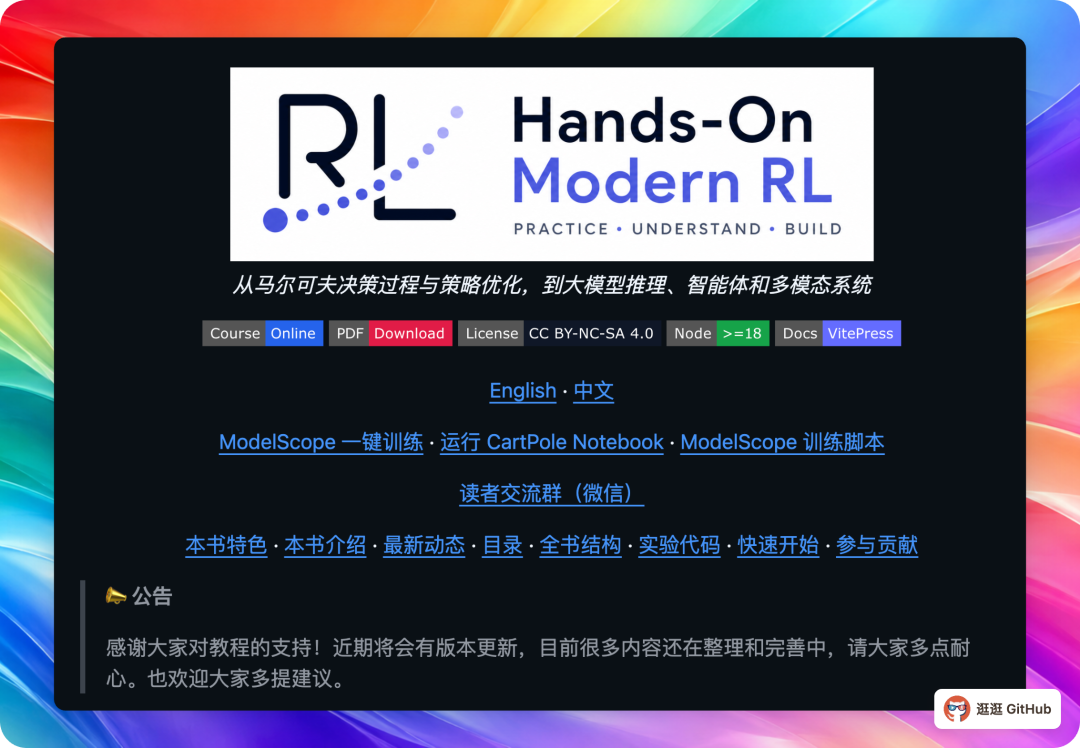
每章都围绕一个具体的实验展开。
先用 CartPole 倒立摆这样的小游戏让你直观理解强化学习里面的状态、动作、奖励是怎么回事,再逐步深入到 DQN、PPO、RLHF、DPO、GRPO 等现代算法。
内容覆盖非常全面,共 7 大部分 26 章。
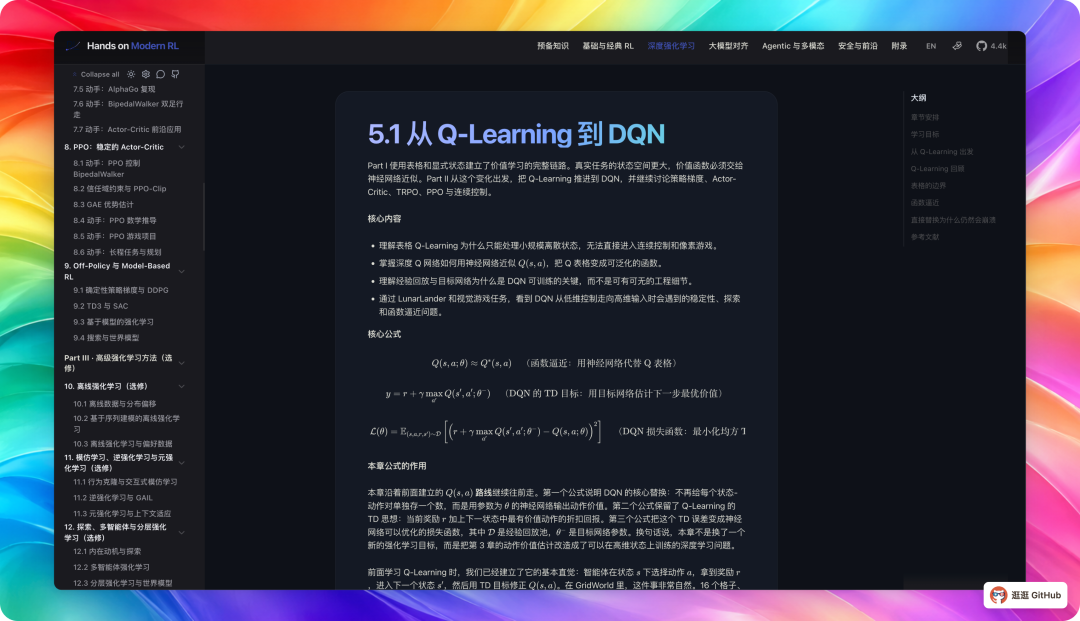
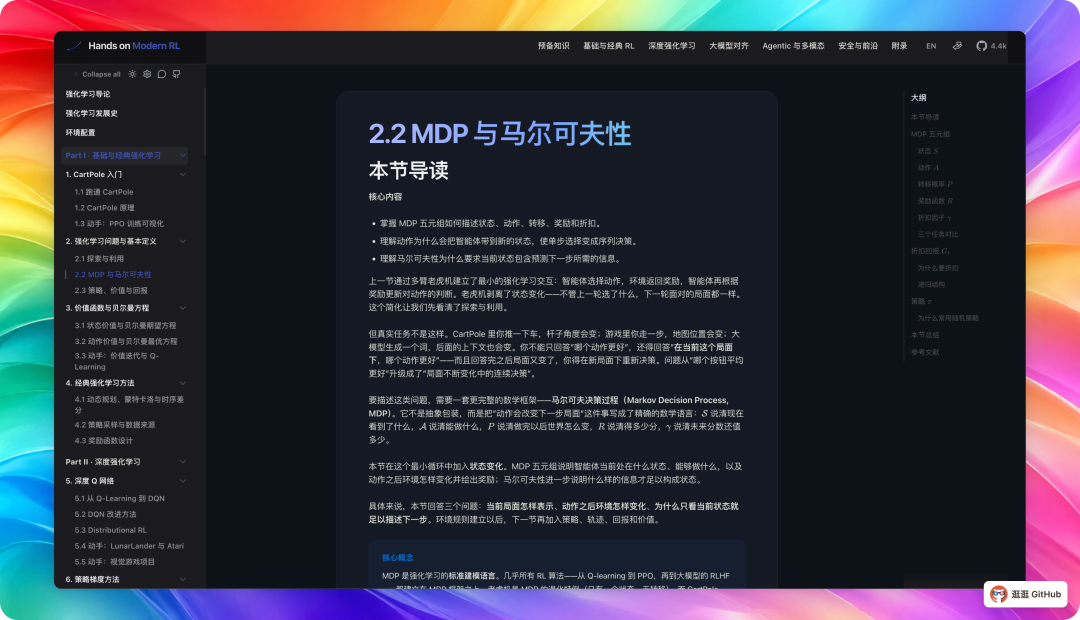
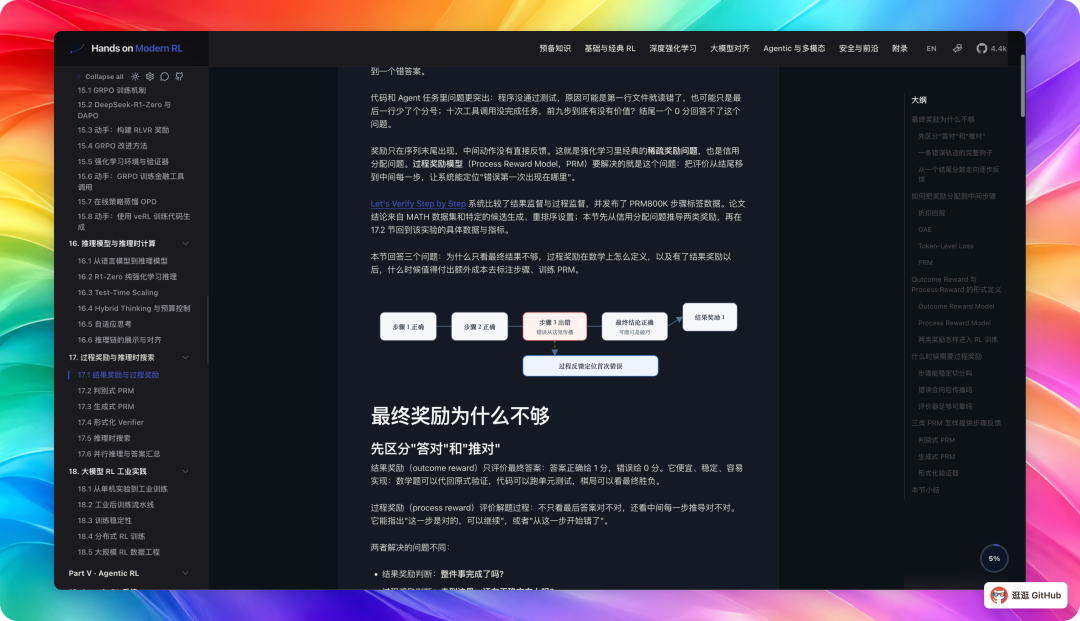
从经典的马尔可夫决策过程、价值函数、策略梯度,一直延伸到 LLM 后训练。
还包括工具调用 Agent、浏览器 Agent、视觉语言模型 RL,甚至具身智能和音频 RL。
每章都配有可运行的 Python 代码和真实的训练曲线,你可以亲自跑实验、改参数、观察结果,而不是只看公式推导。
开源地址:https://github.com/walkinglabs/hands-on-modern-rl
作者:逛逛GitHub 公众号:逛逛GitHub
本文由 @逛逛GitHub 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议

- 目前还没评论,等你发挥!