起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
AI 能听懂人话,为什么还需要“本体”?


当 AI Agent 开始走进业务系统,如何把 “客户”“有效订单” 这些概念讲清楚,就比接入更多工具更先值得解决。这篇文章将带你认识本体(Ontology):它不是什么高深技术,而是一种把业务概念、关系和规则明确表达、统一复用的方法,以及它为什么在 Agent 时代重新变得重要。
现在的大模型已经很聪明了,不仅能理解自然语言,还能写代码、分析数据,甚至调用工具完成任务。
但如果你问它:“我们公司上个月新增了多少客户?”
即使它能够访问公司的业务数据,也不一定能给出正确答案。因为它虽然知道什么是客户,却不一定知道你们公司如何定义“新增客户”。
最近研究 AI Agent 时,我经常看到一个概念:本体(Ontology)。
有的文章把它和知识图谱放在一起讨论,有的将它作为企业 AI 的语义层来介绍。
AI 能听懂人话,为什么还需要“本体”?
01 本体究竟是什么?
先从一个简单的业务场景说起。
假设我们要开发一套客户管理系统,需要管理客户、订单、合同等信息。
在开发之前,首先要明确几个问题:什么是客户?客户和订单之间是什么关系?什么情况下,一笔订单才算有效?
这些问题看起来很简单,但实际业务中,不同部门可能有不同的理解。
例如,市场部关注留下联系方式的潜在线索,销售部关注有明确购买意向的客户,财务部则更关注已经产生交易的客户。
订单也是一样。一笔订单创建成功,算不算有效订单?已经付款但后来全额退款的订单,还要不要计算?这些都需要企业根据自己的业务规则进行定义。
假设某家公司规定,成交客户是至少完成过一笔有效订单的客户,而有效订单必须满足支付成功、未被全额退款等条件。
我们不仅定义了“成交客户”和“有效订单”这两个概念,还建立了客户与订单之间的关系,并明确了相关业务规则。
这就接近本体所做的事情了。
本体是一种知识建模方法,它将特定领域中的概念、属性、关系及其逻辑含义明确地表达出来,让不同系统能够使用相同的语义理解这些知识。
例如,“客户”“订单”是概念,客户编号和订单金额是属性,客户拥有订单是一种关系,而有效订单的判定条件则涉及业务规则。
需要注意,并不是所有业务规则都必须写进本体,也不是把几个概念整理成文档就等于完成了本体建模。正式的本体还会强调概念与关系的形式化表达,以及相应的逻辑约束。
但理解它的基本思想,并不需要先掌握这些技术细节。
简单来说,本体关注的不只是系统存储了什么数据,还关注这些数据究竟代表什么。
02 大模型已经很聪明了,为什么还需要本体?
因为大模型掌握的通用知识,不等于企业内部的业务知识。
还是刚才的例子。
假设老板让 AI 统计上个月新增的成交客户。
大模型知道如何编写 SQL,也知道怎么统计数量,但它可能不知道,这家公司规定的成交客户必须完成过有效订单。
即使它知道成交客户的定义,也不代表它知道“新增”应该如何计算。
是按照客户注册时间统计,还是按照首次成交时间统计?如果客户上个月首次付款,这个月又发生全额退款,该怎么算?
这些问题没有统一适用的答案,需要企业根据自己的业务规则明确。
如果没有准确的定义,Agent 即使能够访问数据库,也可能选择错误的字段或统计条件,最终生成一份看起来合理、实际上却不符合要求的报表。
所以,问题不一定是模型能力不足,而是它缺少完成当前任务所必需的业务知识。
我们可以把相关定义写进提示词,也可以通过知识库、接口文档或者 Skill 提供给 Agent。
例如,明确告诉它:新增成交客户按照首次有效成交时间统计,具体筛选条件遵循企业的客户指标定义。
这样,Agent 就有了完成任务所需的业务上下文。
而本体提供了另一种思路:将领域中的概念、关系和语义规则明确组织起来,使不同应用能够复用这些知识。
不过,说到这里,我又产生了一个疑问。
这些事情,不就是传统数据建模一直在做的吗?
03 本体和知识图谱、数据建模有什么区别?
研究本体时,经常会遇到另外几个概念:知识库、知识图谱、数据建模,有时还会涉及数据治理。
它们确实存在联系,但关注的重点不同。
还是用客户管理系统举例。
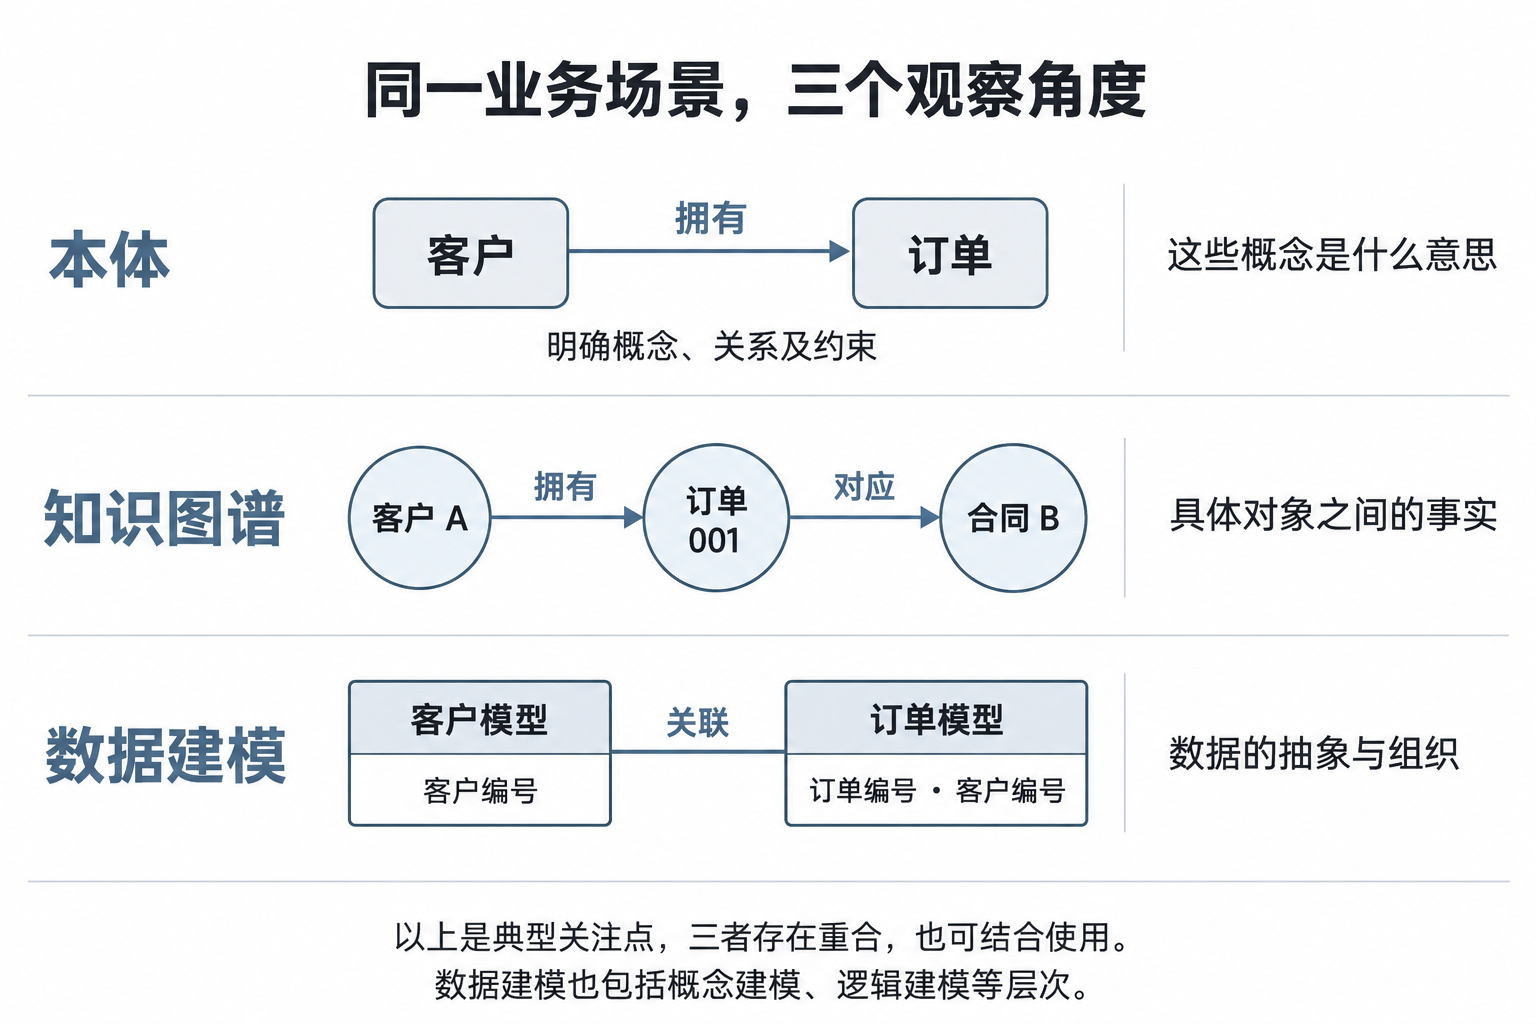
如果我们把企业的客户管理制度、销售规范、业务操作手册等资料整理起来,供员工或 AI 检索使用,就可以构成一个知识库。
如果进一步把具体客户、订单、合同等对象连接起来,例如“客户 A 拥有订单 001”“订单 001 对应合同 B”,就可以形成一张知识图谱。
而本体更关注这些事实背后的概念与语义。例如,什么是客户、什么是订单,客户和订单之间可以存在什么关系。
至于数据建模,传统软件开发同样需要梳理业务对象、属性和关系,再将其设计为具体的数据结构。
例如,通过客户表、订单表以及关联字段,将客户和订单的数据组织起来。
不过,数据建模并不只是设计数据库表,还包括概念建模、逻辑建模等不同层次。本体与其中的概念建模高度重合,但通常更强调形式化的语义表达、知识共享和逻辑推理。
最后是数据治理。
同一个客户在不同系统中可能拥有不同编号,如何确认它们属于同一主体?客户数据存在错误,应该如何处理?哪些人员可以访问这些数据?
这些问题涉及数据标准、质量、来源和权限等管理工作。
所以,我们可以简单理解为:知识库侧重组织知识,知识图谱侧重关联具体事实,本体强调概念与语义,数据建模关注数据的抽象和组织,而数据治理则关注数据资产的质量和规范管理。
当然,这只是各自典型关注点的区别,它们在实际应用中也会相互结合。
其中,我最感兴趣的还是本体与传统数据建模的关系。
因为研究到这里,我越来越觉得:
本体讲的很多东西,传统软件工程不是早就在做了吗?
04 本体是不是传统技术换了个名字?
一个设计良好的业务系统,本来就应该明确有哪些业务对象、对象具有什么属性、彼此之间有什么关系,以及需要遵循哪些规则。
传统的领域驱动设计(DDD)、概念建模等方法,也一直在处理这些问题。
本体并没有发明业务建模,它与传统领域建模确实存在大量重合。
那为什么还要专门讨论本体?
我觉得,一个重要原因是:有数据模型,不代表不同系统已经建立了统一的业务语义。
过去很多业务系统都是围绕自己的需求建设的。销售系统有自己的客户定义,财务系统有自己的统计口径,运营系统也有自己的业务规则。
这些定义各自可能都合理,但当多个系统需要共享数据、协同完成任务时,就容易产生理解上的差异。
本体提供了一种思路:将共用的业务概念、关系和语义规则明确表达出来,让不同系统可以复用这些定义。
不过,这种能力并不是本体独有的。如果企业已经通过领域模型、数据标准或指标平台解决了这些问题,也就没必要再建设一套重复的体系。
所以,与其纠结本体是不是一项新技术,不如关注它到底能解决什么实际问题。
而随着 AI Agent 开始进入业务系统,这些原本由传统应用使用的业务知识,又多了一类新的使用者。
05 为什么 AI Agent 开始关注本体?
过去,企业的业务定义主要通过数据库、代码和接口提供给不同应用使用。
现在,AI Agent 也开始直接查询业务数据、调用工具,甚至跨系统执行任务。这意味着,Agent 同样需要准确理解企业内部的业务概念和规则。
假设企业只有一个销售 Agent,接入了查询客户、查询订单、生成报表三个 Skill。
这时候,我们完全可以把客户定义、查询条件和业务规则写进 Skill 或 API 中。只要能够满足业务需求,就没有必要专门建设本体。
但如果企业逐渐增加了销售 Agent、财务 Agent、运营 Agent,情况可能就不一样了。
这些 Agent 都需要理解客户、订单、收入等业务概念。如果每个 Agent 都维护一套自己的定义,不仅会产生重复工作,还可能出现规则不一致的问题。
例如,企业调整了“有效订单”的计算规则,销售 Agent 已经更新,财务 Agent 却仍然采用旧口径。
这样一来,即使两个 Agent 都能够正常执行任务,最终的统计结果也可能不同。
这时候,就可以考虑把共用的业务知识抽象出来,形成统一的语义层。
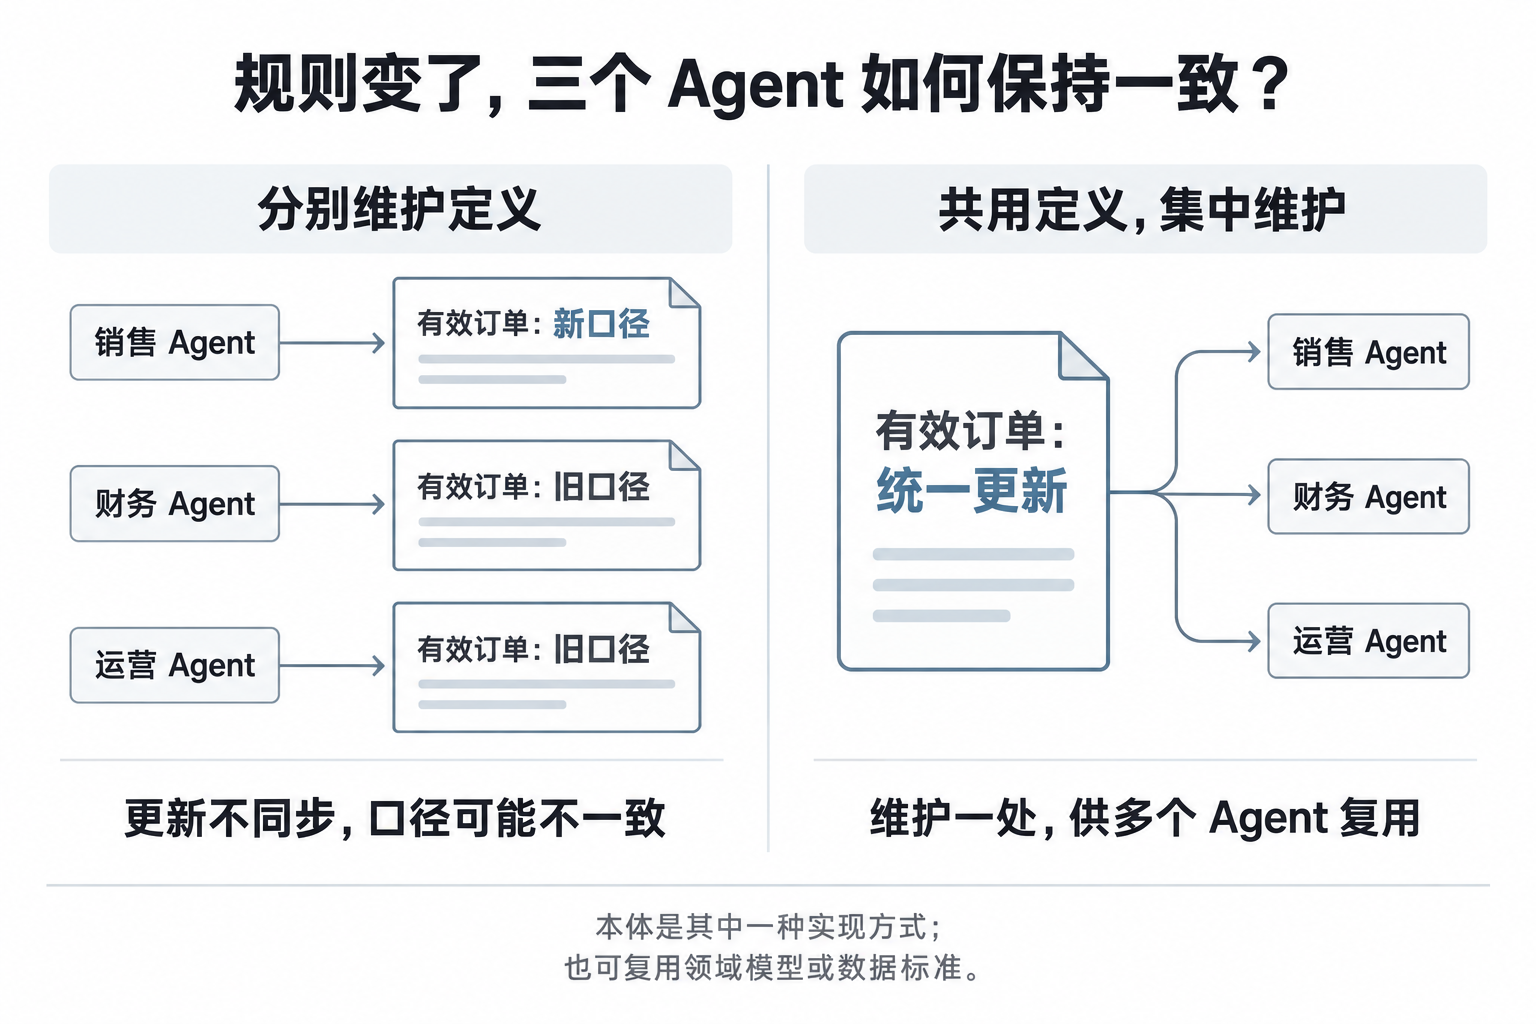
不同 Agent 可以共享相同的业务定义,再通过数据映射和查询服务访问实际数据。
本体可以用来构建这套语义层,但并不是唯一选择。如果企业已经有成熟的领域模型或数据标准,同样可以考虑直接复用。
而且,是否需要统一语义层,也不完全取决于 Agent 的数量。真正需要考虑的是业务复杂度、知识复用需求,以及统一维护能否降低成本。
结语
所以,我认为本体在 AI Agent 时代的价值,不是让大模型突然变得更聪明。
而是当越来越多的 Agent 需要使用相同的业务知识时,让这些知识能够被统一定义、管理和复用。
回到最开始的问题:AI 能听懂人话,为什么还需要本体?
因为听懂“客户”这个词,不代表知道一家企业如何定义客户。本体提供了一种明确表达和共享业务知识的方法,但它不是唯一的解决方案。
以前我们总想着给 AI 接入更多工具,让它能够完成更多任务。但在此之前,或许应该先想想,我们有没有把工具背后的业务知识讲清楚。
本文由 @产品不正经 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议

- 目前还没评论,等你发挥!