起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Kimi半年三次道歉:偷跑、停售、重置


K3.1 Pro 上线两天就发致歉公告,199 元档一条指令拉起 5 个子 Agent,十几分钟吃掉 5 小时额度。单价降了三分之一,单任务的 Token 消耗却成倍上涨,长程 Agent 正在把订阅套餐的计费逻辑逼到墙角。
模型变强以后,用户最先感知到的未必是回答质量,而可能是额度消耗速度。Kimi K3.1 Pro 上线后,长程 Agent 能力明显提升,但“烧额度”也迅速成为高频投诉,月之暗面在半年内第三次就限流和额度问题公开道歉。
这次争议的关键不只是服务故障,而是一个更棘手的工程问题:模型为了把任务做完,会主动拉起更多子 Agent、执行更多工具调用、生成更长的中间结果。模型单价下降了,单个任务的 Token 却可能成倍增长。开发者如果仍用普通聊天的计费方式管理 Agent,账单和用户体验都容易失控。
K3.1 Pro为什么会把额度问题放大
10 月 24 日,Kimi 发布 K3.1 Pro。两天后,平台发布致歉公告,承认会员使用期间出现限流和不必要的额度消耗,并给订阅会员重置月度总额的 25%。公告里还有一句很关键:平台正在减少不必要的子 Agent 调用和输出长度。
用户端的反馈非常具体。有 199 元档会员发出一条“审查项目架构”的指令后,模型拉起 5 个子 Agent,十几分钟就消耗了 5 小时额度;也有 699 元档用户在不到 2 小时内用完 5 小时额度,同时终端持续出现限流报错。
这不是 Kimi 第一次遇到类似问题:4 月 K2.6 发布后曾因限流和额度计算错误道歉,7 月 K3 发布后又因需求逼近 GPU 容量极限道歉并暂停新用户订阅。三次事件串在一起看,问题已经从单次故障变成了模型能力、算力供应和套餐设计之间的结构性冲突。
底座没有换,长程执行能力换了一个档位
K3.1 Pro 仍然建立在 K3 底座上。公开信息显示,K3 使用约 3 万亿总参数,每个 Token 只激活 896 个专家中的 16 个,激活参数约 1040 亿;注意力结构采用 KDA 混合线性注意力与全注意力层,按 3:1 交替,并支持 100 万 Token 上下文。
K3.1 Pro 的主要变化来自后训练阶段。Kimi 把强化学习扩展到数百个下游领域,同时优化 RL 框架、长上下文推理、训练效率、沙箱基础设施、调度系统和环境质量检查平台。
这类升级和“知识库多了一点”不是一回事。它更像是把模型训练成一个愿意继续做事的执行者:发现文件不对,会继续定位;依赖版本冲突,会尝试修复;程序启动失败,会去检查缺失组件。对于一次问答,这些动作可能显得多余;对于一个要运行数小时的工程任务,它们又是完成闭环的必要步骤。
真实任务里,模型为什么更能干也更费钱
独立开发者杳晦曾让 K3.1 Pro 从零生成一款桌面软件,界面要求融合洛可可、莫奈和慕夏的视觉风格。过去用 AI 完成类似项目,常见问题是代码写到一半中断、图片素材需要人工寻找、额度很快用完。
这次任务持续约 6 小时,模型自行搜集和加工图片素材,完成前后端代码,并处理了软件零件版本不匹配、文件放错位置、启动程序没有下载等问题。最终任务推进了 10 项,约消耗周额度的 14% 和月额度的 2.68%。
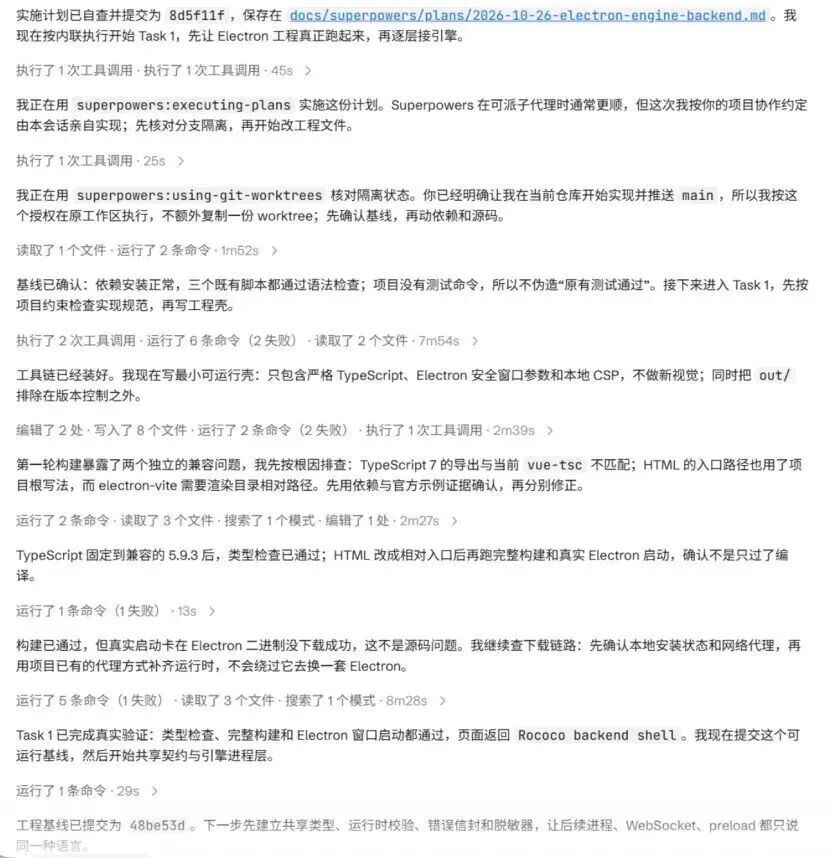
对开发者来说,真正有价值的不是“模型一次都不报错”,而是它能发现错误、解释原因、完成修复,并把结果交付出来。但每增加一轮排查,就会增加上下文、工具调用和输出 Token。Agent 的成本因此不再由单次回答决定,而由整个任务轨迹决定。
可以把一次 Agent 任务的真实成本写成:
任务成本 = 输入 Token
+ 输出 Token
+ 子 Agent 调用
+ 工具执行与重试
+ 上下文压缩与恢复
+ 人工审查和返工
如果只盯着模型的百万 Token 单价,很容易得到错误结论。更强的模型可能把成功率提高了,但也可能在一次任务里完成更多自检和探索;平台若没有预算、并发和最大步数控制,用户看到的就是“模型更聪明了,额度更不够用了”。
单价降了33%,总消耗却可能翻倍
当前公开价格中,K3.1 Pro 的输入 Token 为:命中缓存每百万 1.3 元,未命中缓存每百万 13 元,输出每百万 68 元,相比 K3 的单价下调约 33%。单看价格,这是一种积极变化。
但开发者实测同一任务时,K3.1 Pro 消耗约 144 万 Token,K3 只消耗约 61 万 Token,任务总量达到原来的 1.6 至 2.4 倍。价格下降并没有完全覆盖任务变长带来的增量,最终账单反而可能上涨。
这也是 Agent 产品最容易被忽略的地方:模型能力提升会带来更多“主动工作”。如果平台按照聊天消息收费,用户无法知道额度究竟花在主模型、子 Agent、工具输出还是重复重试上,出现争议只是时间问题。
建议在产品侧至少公开四项数据:
- 主模型与子 Agent 各自消耗了多少 Token。
- 每个工具调用产生了多少输入和输出。
- 哪些步骤是模型主动扩展,哪些步骤是用户明确要求。
- 任务失败、重试、回滚和人工接管分别发生了几次。
对于企业内部的代码 Agent,还应该设置单任务预算、最大子 Agent 数量、最大工具轮数和最长执行时间。达到阈值后暂停任务,让用户决定是压缩上下文、降低模型档位,还是继续追加预算。
跑分进入全球前列,商业化仍没有跑通
K3.1 Pro 的能力提升很有说服力。Artificial Analysis 智能指数给到 55 分,位列全球第 4;Terminal-Bench 4.0 得分 67%,成为该评测框架下的高位成绩。
但单次任务的能力排名,不能直接转化为稳定的订阅收入。长程 Agent 的真实成本动辄达到普通问答的数十倍,固定月费加额度的产品形态,很难同时满足重度用户的使用强度和平台的算力成本。
海外市场也给 Kimi 带来新的机会和压力。K3 已通过收入分成模式进入 Amazon Bedrock,之后又通过 Baseten 进入 OpenAI Codex 的企业付费结算体系。围绕微软、亚马逊和谷歌模型托管的收入分成合作,也出现了最高 30% 比例的相关说法,这些合作细节仍需以正式公告和合同落地为准。
同时,Kimi 还面临数据合规和竞争争议。Anthropic 曾指控约 30 万条 Kimi 用户请求被转发给 Claude,Kimi 随后公开否认并表示将采取法律措施。对于面向海外企业的模型平台,数据流向、模型托管位置、日志留存和第三方调用链,都会直接影响采购决策。
Agent时代需要新的计费和观测方式
Kimi 的困境并不只属于一家企业。Agent 任务天然会扩大 Token 消耗:它要读更多上下文,调用更多工具,运行更多验证,还要在失败后继续尝试。中国信通院给出的行业口径是,Agent 任务的 Token 消耗可能达到普通对话的 10 至 100 倍。
用户对价格的期待却越来越清晰:要么为明显更强的智力付费,要么选择极致低价的模型。中间状态最难解释,既不够便宜,也不能保证每次长任务都能顺利完成。
DeepSeek V4.1-Flash 发布后,错峰输入价格低至约 1 元/百万 Token;发布一周后,全球单周调用量达到 33.6 万亿 Token,环比增长 801%。这种低价模型会继续压缩基础任务的价格空间,也会迫使高端 Agent 产品证明自己的长程交付价值。
对平台和开发团队来说,下一步不是简单地把套餐额度加倍,而是让用户看懂额度花在哪里。一个合格的 Agent 控制台,至少要提供任务级账单、调用链、子 Agent 树、工具耗时、失败原因和结果回滚记录。
K3.1 Pro适合什么开发工作流
K3.1 Pro 更适合长上下文、连续执行和需要自我修复的任务,例如跨文件重构、从零搭建小型应用、分析大型仓库、生成测试并反复修复失败结果。普通摘要、简单问答和短代码补全不一定需要使用高消耗的长程模式。
接入时可以按任务风险做路由:低风险任务使用低成本模型;需要多轮工具调用的任务先设置预算和最大步数;涉及生产代码、数据库和外部消息的任务,要求模型输出计划和变更清单,再由人工或权限网关批准执行。
国内开发者如果需要将 Claude Code 等工具接入兼容 API,可以通过 Code80(https://code.ai80.vip/home) 配置 endpoint;模型版本、密钥权限、调用预算和生产审计仍由项目侧控制。
常见问题
K3.1 Pro比K3强在哪里?
主要提升在后训练和长程执行能力,包括更复杂的推理、更连续的工具调用、子 Agent 协作和错误修复,而不是简单扩大底座参数。
为什么模型单价下降,额度却消耗更快?
因为模型可能执行更多步骤、调用更多子 Agent、生成更长的中间结果。单价下降不一定能抵消任务总 Token 增长。
K3.1 Pro适合所有代码任务吗?
不适合。长程开发、跨文件重构和复杂调试更能发挥价值;短问答、简单补全和批量分类应优先使用成本更低的模型。
如何控制Agent烧额度?
设置单任务 Token 预算、最大子 Agent 数、最大工具轮数、最长执行时间,并记录每一步的调用成本和失败重试原因。
Kimi的海外商业合作都已落地了吗?
K3 进入 Amazon Bedrock 和通过 Baseten 接入企业付费体系已有公开说法;其他收入分成和云厂商合作仍应以正式公告为准。
国内开发者如何接入兼容 API?
可以通过 Code80 了解接入方式,但生产环境仍需自行管理密钥、权限、数据留存和审计。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议



- 目前还没评论,等你发挥!