起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
DeepSeek 的 Super-agent 设计,和我们的工程实践


看完 DeepSeek Harness 的 Super-agent 设计,作者把自家一年多的折腾翻了出来:任务分给多个 Worker 并行跑,数据库存会话状态,外部 Watchdog 盯异常,最后落到 Lobe 上真接管了网站维护和选题调研。
最近看了 DeepSeek Harness 团队的《Super-agent 设计探索,迈向更自主的 Agent 系统》,感触还是很深的。
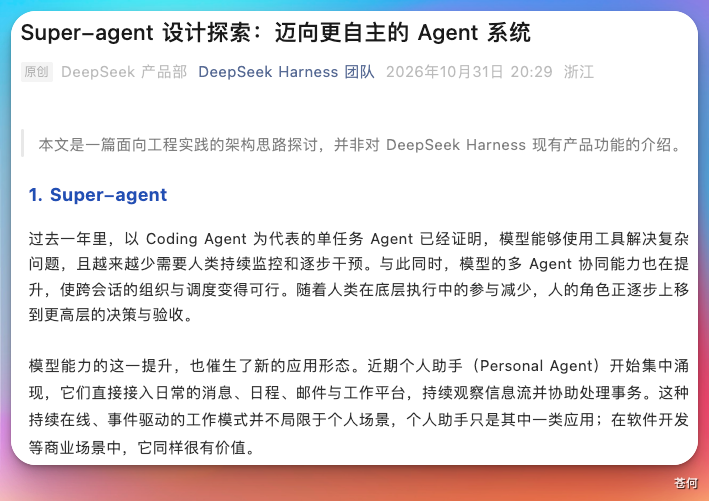
过去一年,Agent 的单体能力在大幅增强,但很多还困在单次的对话里,切换对话,还要主动记忆上下文,而同时进行的对话 Session 一多,人的注意力就会跟不上了。
最近很火的 Personal Agent 在个人助手场景下可以持续观察信息流并协助处理事务,而且具备全局感知的上下文,是 Super-agent 比较好的一种形态。
Super agent 具体工作由多个 Worker 并行执行,各自保留独立上下文,按需连接实际的工具环境。已有任务的后续消息,还可以沿订阅通道直接送到对应 Worker,少绕一遍 Router。
底下的数据库保存会话状态,外部的 Watchdog 监控异常和执行进展。
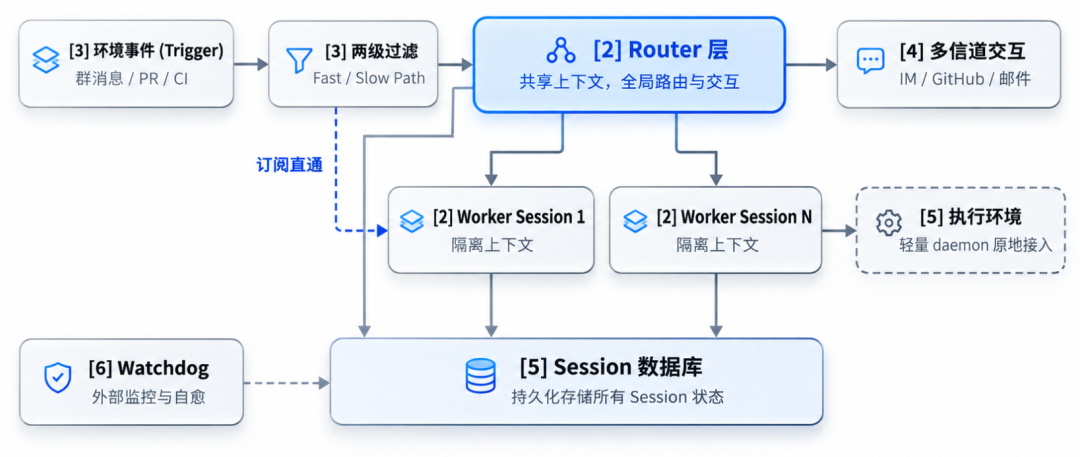
图源《Super-agent 设计探索》,版权归原作者所有
这几部分配合起来,让系统有条件同时接活、持续执行,也能在出问题后恢复工作。
总结起来就是连续、高效、主动、持久四个词。
那落到真实工作里,怎么把一群 Agent 组织起来,让任务持续往前走?
其实我也一直在探索,我尝试过不少方法,比如在 openclaw 和 hermes 火的时候,我尝试自己动手搭建一套复杂的多 agent 架构。
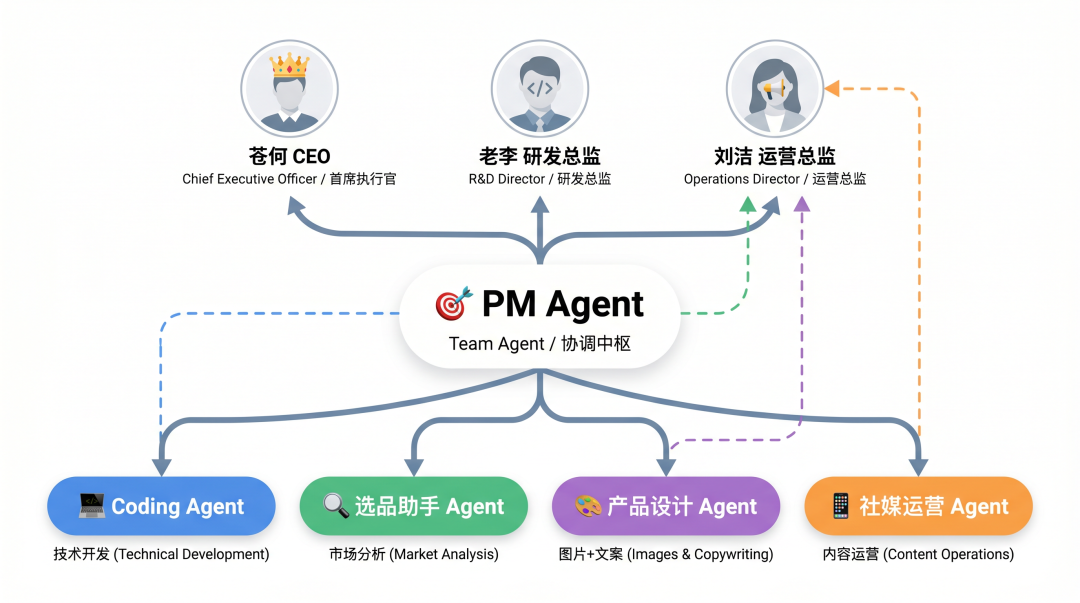
但这套系统本质没解决实践驱动和自主感知决策的问题,最多算是一个简单的 multi agent 架构。
这个架构的本质是依旧需要人来做信息筛选和决策,没有基于事件驱动和自主决策。举一个简单例子,你更好理解。
假设我们现在有一个搜集热点的 agent,他会把搜集到的每日热点都丢给 team agent,team agent 需要人来确认这些热点去做选题,当这些足够多的时候,人的精力就非常有限了,有时候搜集本身就会变得没意义了。
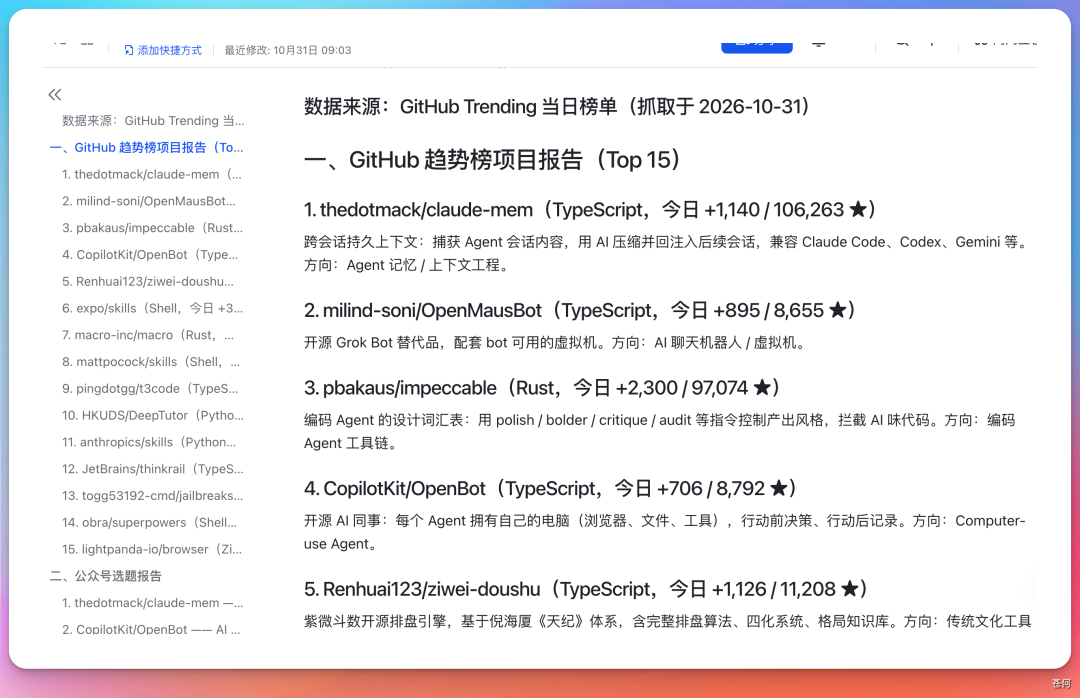
但老实说自己搭建一套 Super-agent 又显得有些复杂,特别对于没有技术背景的同学来说,调研了一圈,现在 GitHub 上已经有一些比较成熟的解决方案了。
大家可以自行尝试,下面分享下我用 LobeHub 来搭建我自己的 Super-agent 的一些实践,希望能给你一些启发。
LobeHub 是比较早期的一个 AI 开源项目了,之前叫 LobeChat,很多最早接触 GPT 的应该都有听过或用过这个项目,我也算是很早一批的使用者了,25 年改成了 LobeHub,变成了 Agent 平台。
发展了几年,现在也已经 80 多 k 的 star 了,势头很猛。
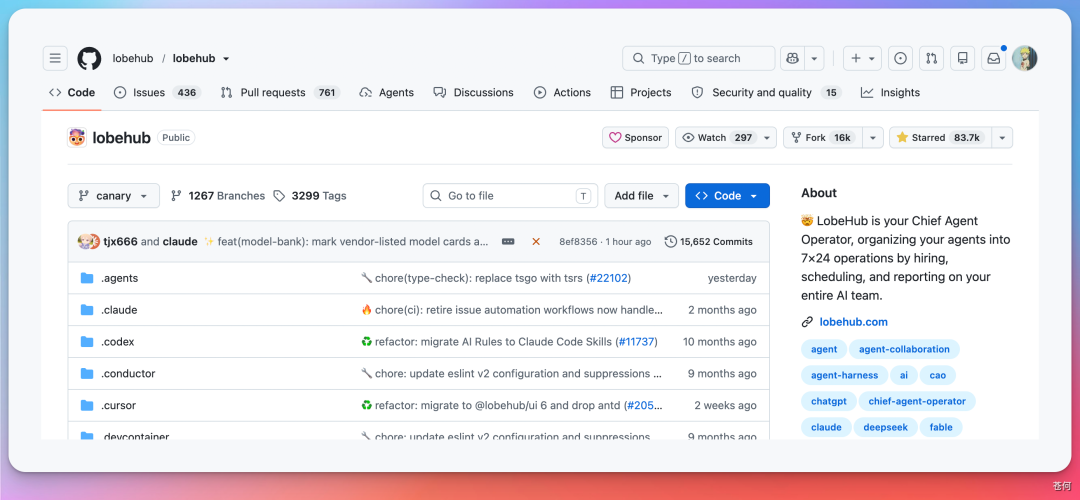
开源地址:https://github.com/lobehub/lobehub
而且我在网上看到,发现他们已经开始用 LobeHub 持续开发和迭代 LobeHub 自身了。
LobeHub 原本支持给任务单独指定模型,但只能在网页上操作,Agent 通过工具或命令行创建任务时,还缺少这个入口。这样一来,想让一个模型负责规划,再让另一个模型执行任务,就卡住了。
主管 Agent Nasa 查清问题后,创建了 T-1149 任务,把它分派给基于 Claude Code 的执行 Agent Dario。任务里写明了现状、需要补齐的入口和验收要求,Dario 接手后继续开发。
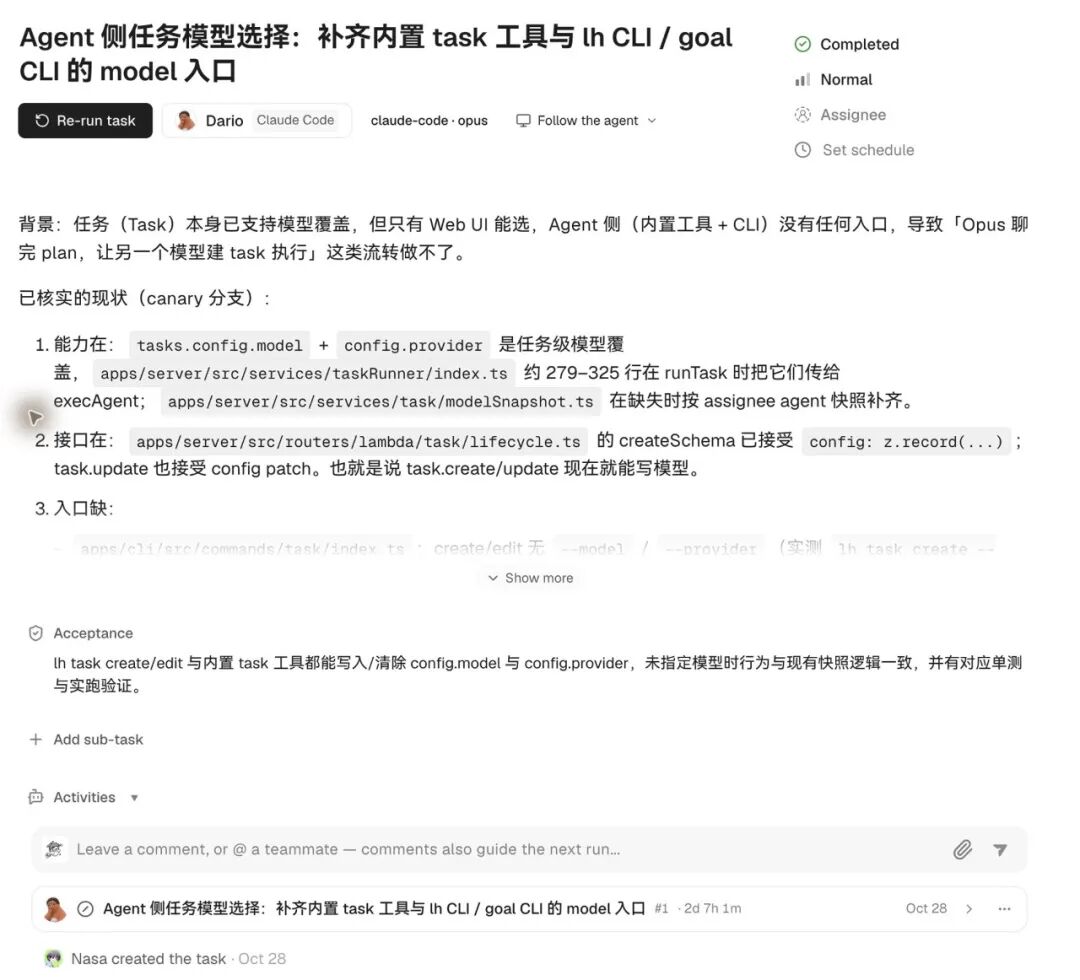
最终,Dario 交付了 PR # 21852,为内置任务工具和命令行补上了指定模型的能力。交付记录里附有修改说明、测试结果和验收报告,也列出了需要部署后继续验证的部分。
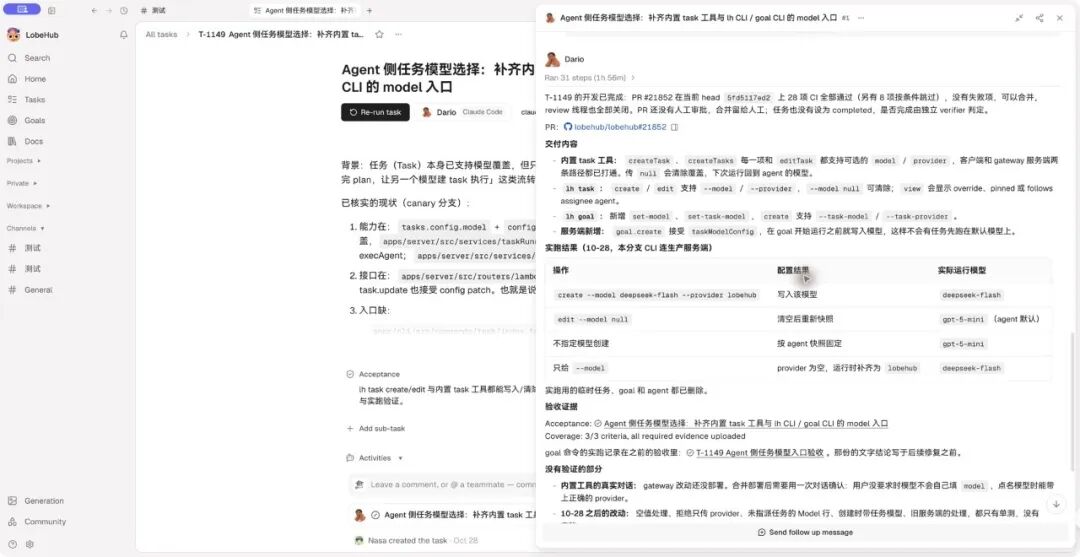
我也看了对应的 GitHub PR,里面明确关联了 T-1149,并记录了 AI 参与代码实现、测试和验证的过程,目前这条 PR 已经合并。
PR:https://github.com/lobehub/lobehub/pull/21852
从发现问题、创建任务、分派执行,到提交代码和提供验收证据,这套协作方式已经用在了他们自己的研发里。更有意思的是,Agent 这次补上的,正是方便后续 Agent 分工执行的能力。
我最近也在自己的工作里尝试了类似的协作方式,比如更新我的 Codeguide 网站。
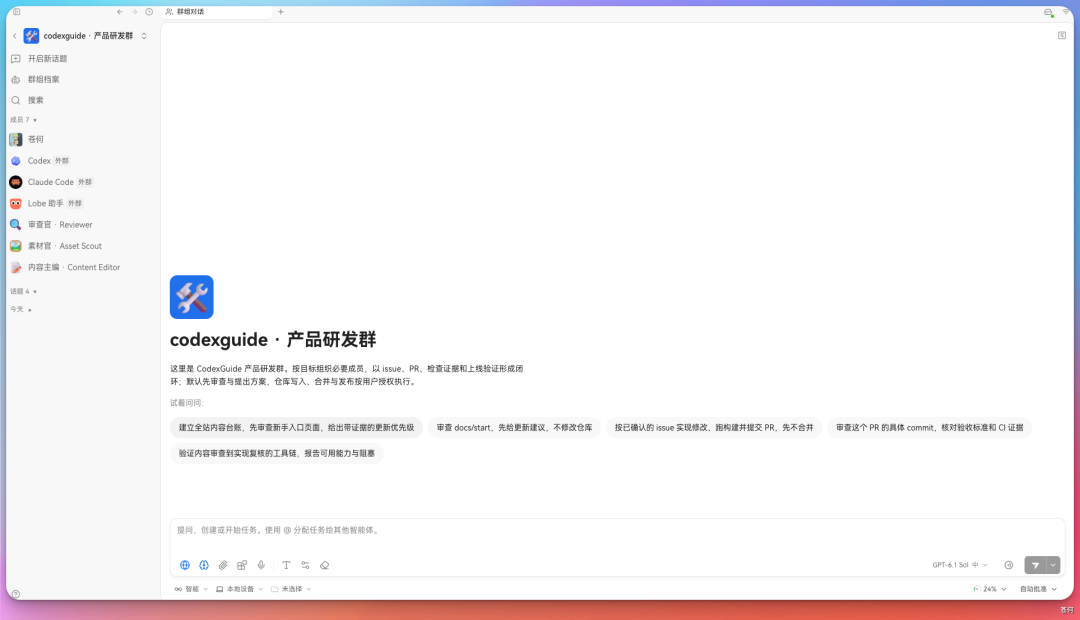
我先把想要的分工和协作方式告诉构建助手,让它帮我搭了一个 codexguide 产品研发群。
群里有 1 名主管 Agent 和 6 名执行 Agent,角色、规则和流程也一并配好了。
除了 LobeHub 的 Agent,我还接入了本地的 Codex、Claude Code,让这支团队能用上实际项目里的工具。
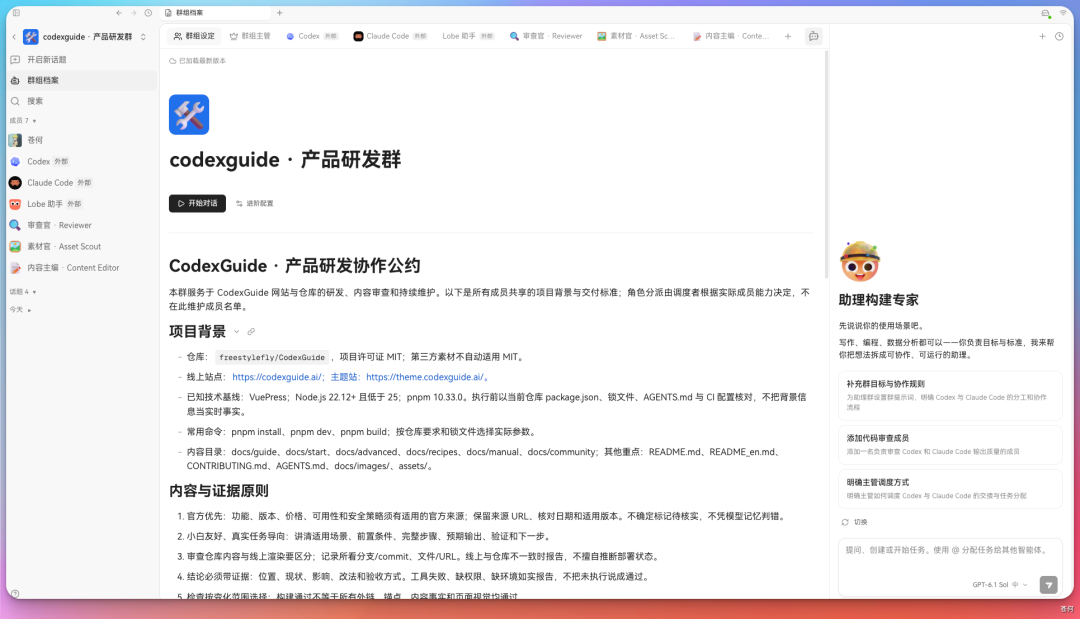
比如我让它对全站内容进行审查,给出更新的优先级。
主管先把内容审查交给主编:对照官方资料检查代码仓库和线上页面,整理问题证据、修改建议与验收标准。后续的实现和复核,再按各自职责交给其他成员。
先找内容主编,是因为这轮要判断信息有没有过时、结论有没有来源、哪些页面值得优先更新。我给主编设定的是默认只读的审查职责,先把这些问题查清楚;需要本地验证或修改文件时,再交给有开发环境的 Codex、Claude Code,并安排 Reviewer 独立复核。
这里的分工依据,是每个成员的职责、工具和执行环境。主管派活时,也需要把目标、输入材料、允许修改的范围和验收要求一起交过去,下一个成员才能接着做。
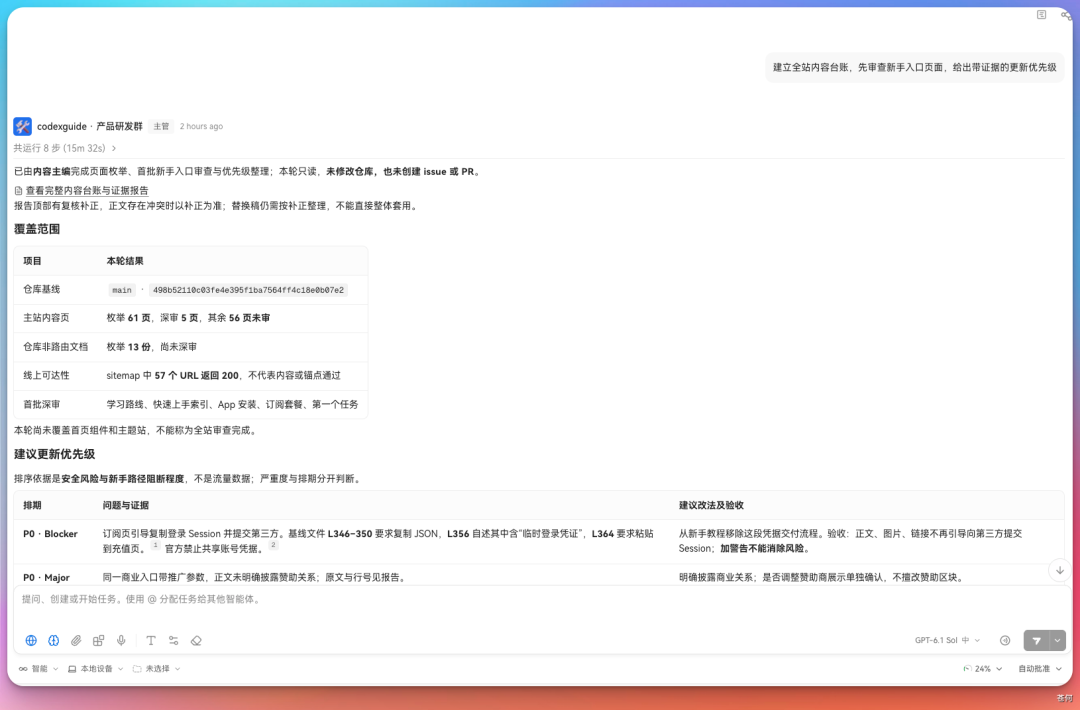
内容主编审查了 codexguide 的代码仓库和线上内容,把发现的问题、对应证据、修改建议和验收标准整理成报告,并安排了后续更新的排期。
报告里的信息也附有可核对的来源,哪些地方确实有问题,我可以顺着证据逐项确认,不用只听它单方面的判断。
审查中发现的问题,后面也进入了实际修改和 PR 交付阶段。
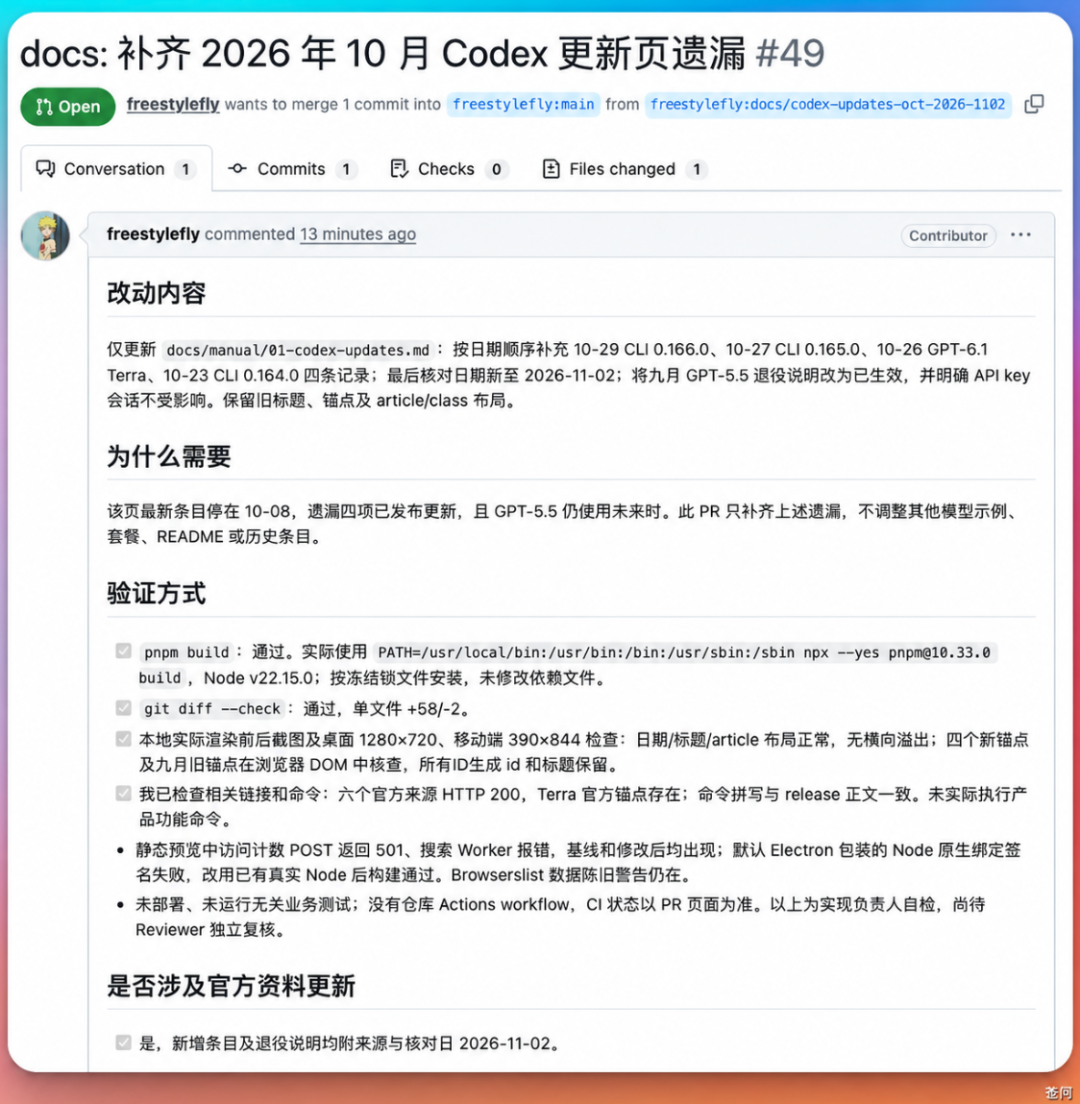
具体怎么派,可以看后面一次修复 #48 的委派记录。主管让 Codex 修改第三方 API 鉴权文档并提交 PR,之后交给 Reviewer 复核;另外两个 issue 的处理由主管自己负责。这次我没有开启群组的 Task 记录,委派过程以卡片形式留在群聊消息流里。
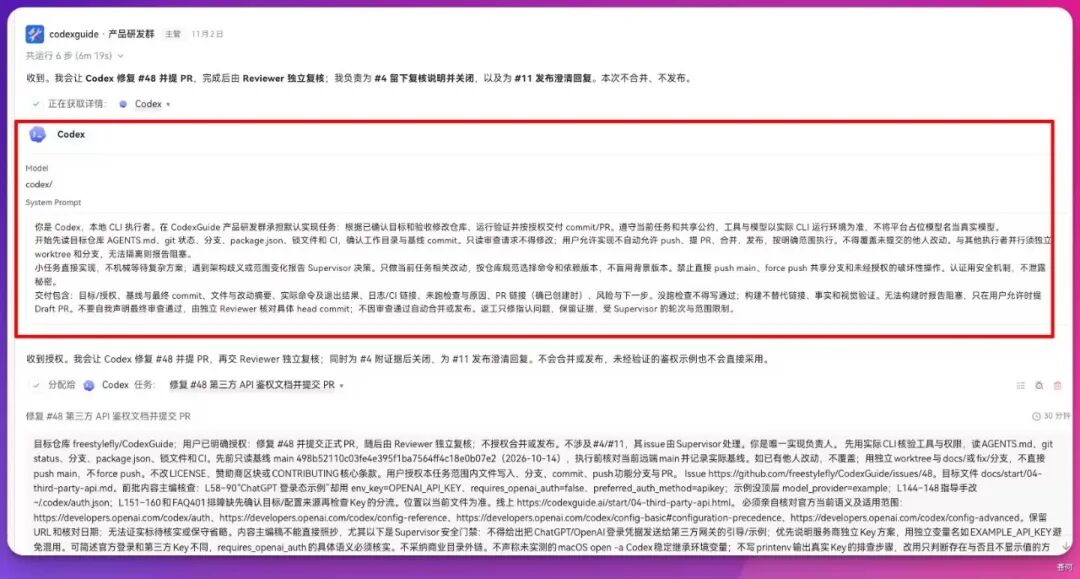
展开卡片,里面给出了目标仓库、基线 commit、涉及文件、主编检查到的问题、官方资料链接,以及“可以提交 PR,但不合并、不发布”的范围。主管是在把一份可以独立执行的工作说明交给 Codex。
这种交接需要明确两件事:执行者拿到哪些输入,以及这次可以做到哪一步。审查意见可以作为修改线索,涉及鉴权等技术细节时,Codex 还需要回查官方文档和当前仓库,确认建议成立。
本地环境也要接通。我顺着 LobeHub 的开源实现看了一下:以 CLI 连接方式为例,lh connect 连接设备网关,收到执行请求后,在本机启动对应的 Agent 运行流程。请求中包含 Agent 类型、工作目录、提示词和话题标识,让云端分派的工作落到具体机器和目录上。
设备连接实现:https://github.com/lobehub/lobehub/blob/canary/apps/cli/src/commands/connect.ts
所以,接入 Codex、Claude Code 时,要先确保本机的 CLI 能正常使用,再通过桌面端或 CLI 连接器接入设备,为执行成员配置对应环境和工作目录。能否读写文件、运行命令和推送代码,还取决于本机的文件权限、CLI 执行限制,以及 Git、GitHub 的登录与授权状态。
在我的协作规则里,执行者开工前要先读仓库的 AGENTS.md,检查 git status、当前分支和基线 commit;已有未提交修改要保留,多人同时写代码时用独立 worktree 隔离,无法隔离就先串行。允许改文件、允许 push、允许提 PR、允许合并和发布,也分别说明。这些规则需要执行者遵守,实际访问限制仍由本地环境和服务端权限控制。
交付时,我要求带回文件修改摘要、实际运行的命令与结果、commit 和 PR 链接。Reviewer 要复核具体版本;如果后面又提交了新 commit,就需要检查受影响的部分。没有跑过的测试、还没验证的页面,也要写出来。
团队提供的 Acceptance 则是另一种验收方式:把需求拆成检查项,附上实际产品的截图、录屏和日志,汇总成报告,让人逐项接受或提出修改意见。
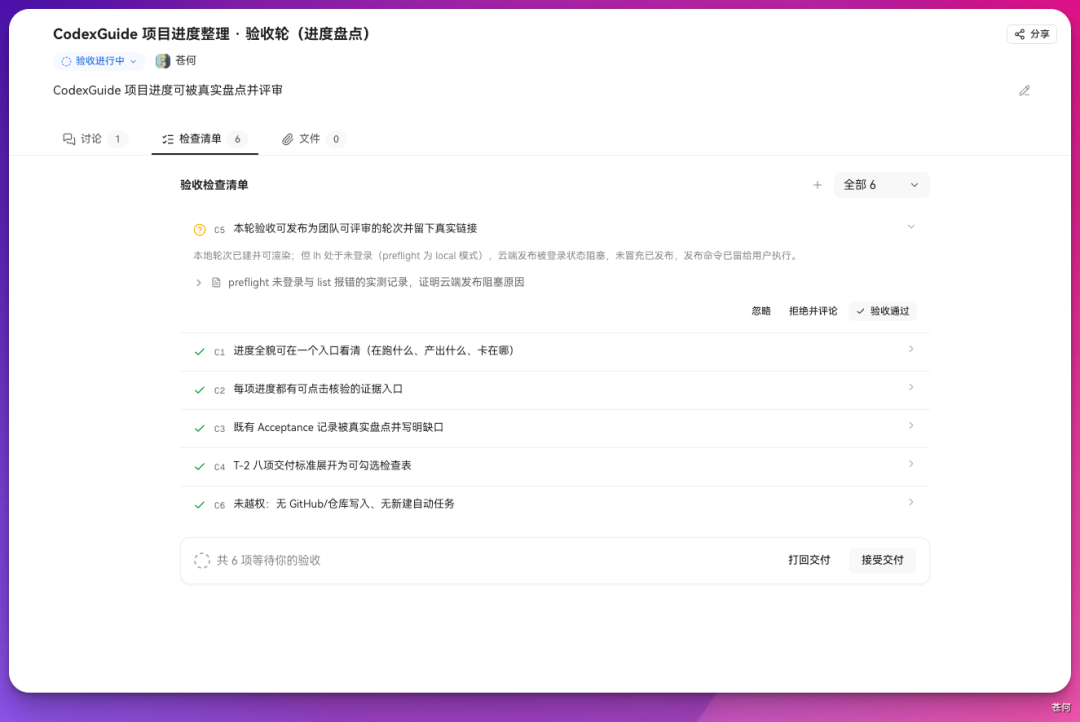
我这次的群组规则里,先要求 Reviewer 对具体代码版本独立复核。需要验收页面表现时,还可以把截图、录屏这些证据一并纳入。
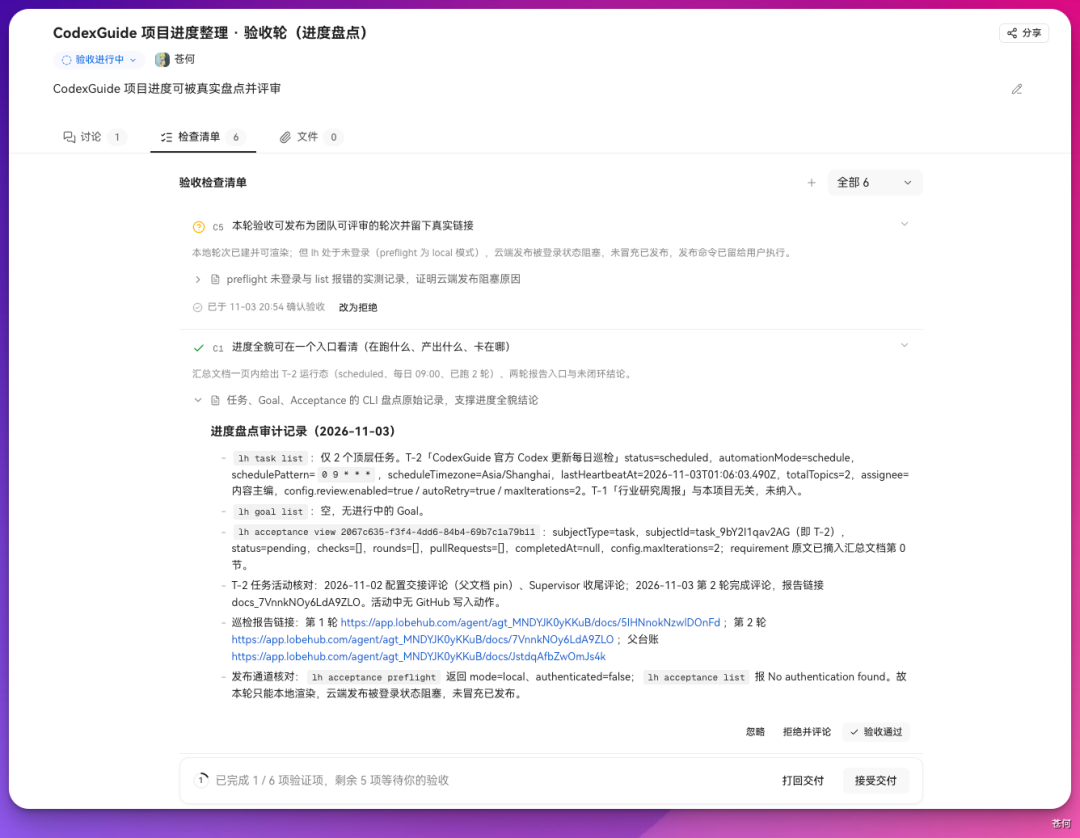
Acceptance 开源地址:https://github.com/lobehub/acceptance
而这轮审查也让我看到,网站最大的问题还是内容的时效性。
Codex 官网有了新消息,我忙起来没及时同步,网站的信息就会慢一拍。这次把已有问题改好了,后面有更新,还是得有人持续跟进。
于是,我又让它加上自动巡检,把这次检查变成定期执行的任务。
主管分析需求后,将内容比对交给内容主编,将定时巡检交给 Lobe 助手。后续就可以按设定时间发起检查,减少我手动跟进的次数。
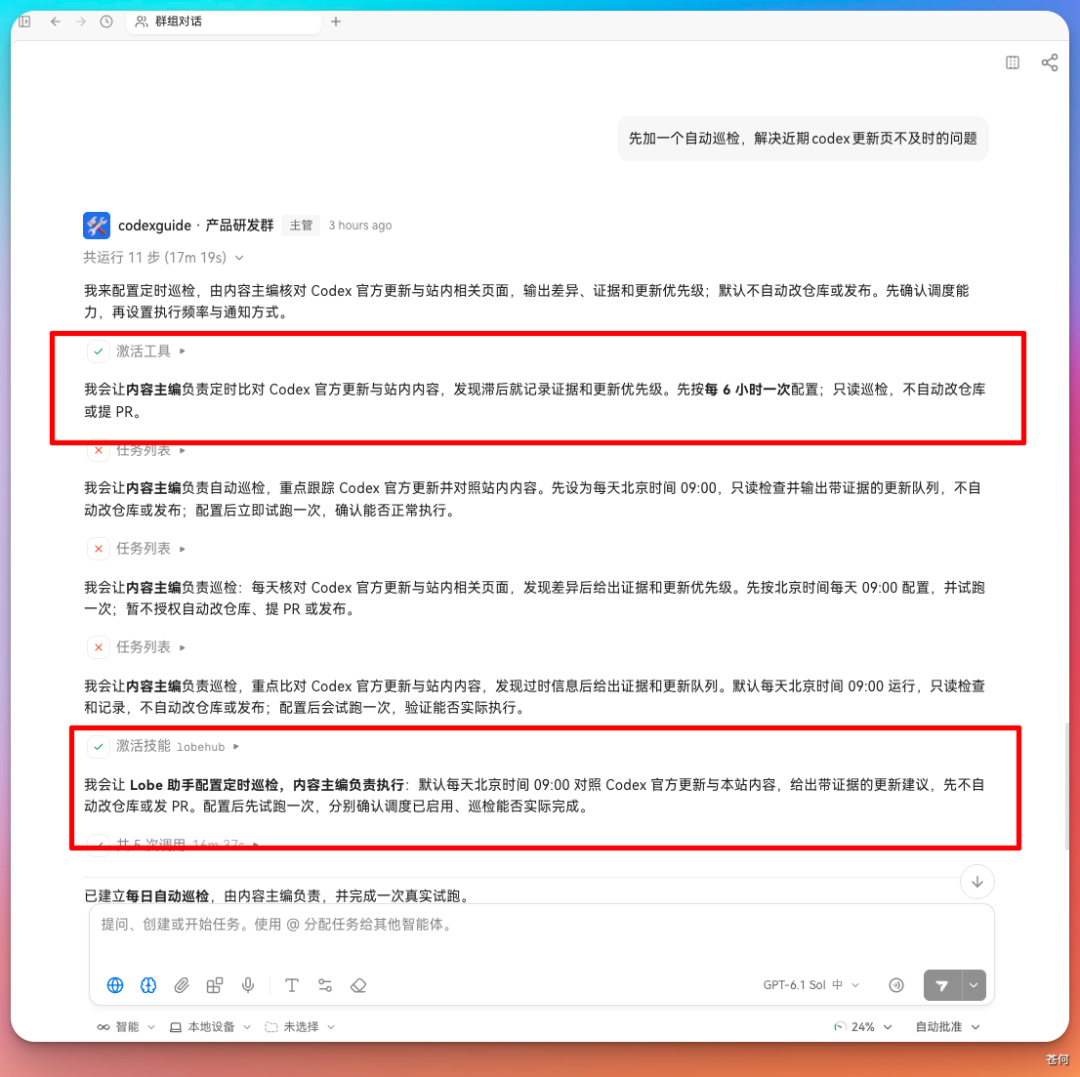
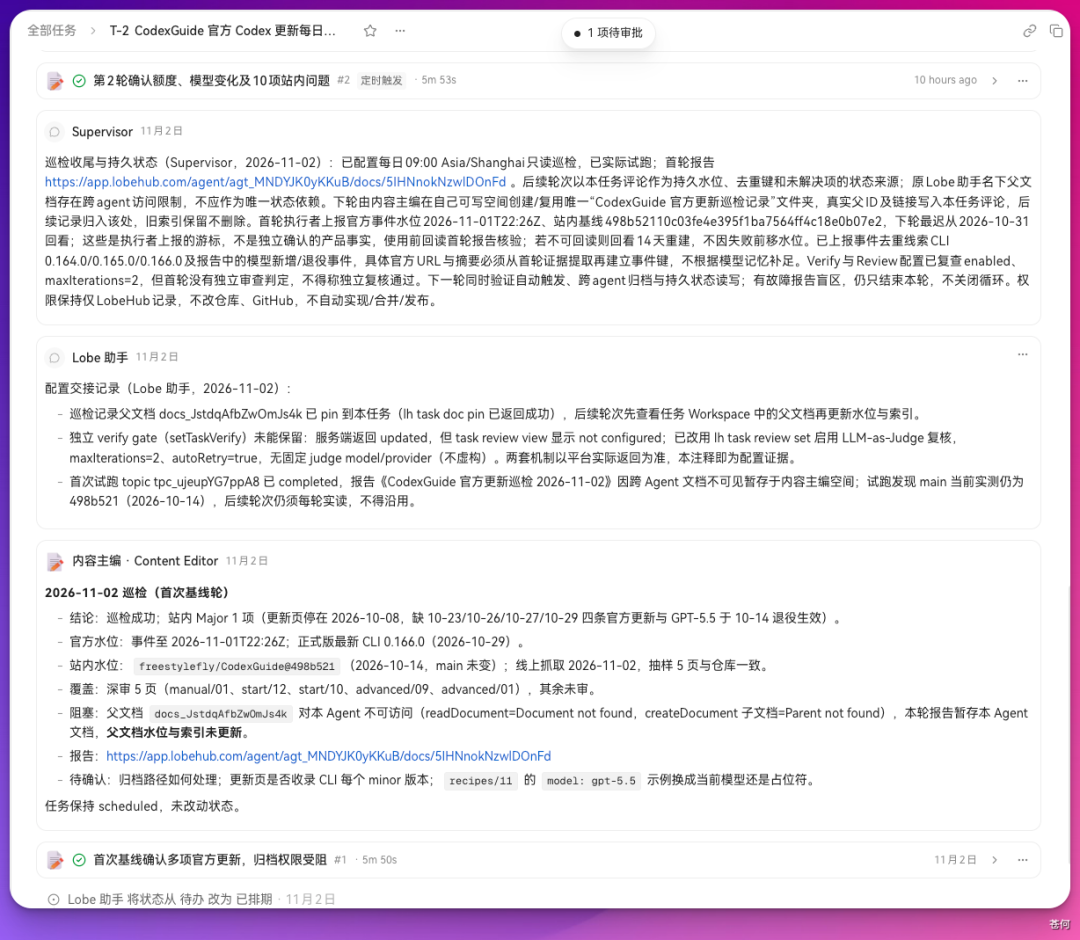
这项巡检也不只是设个时间就结束了。任务状态、数据来源、对照对象、检查范围、交付内容和授权范围,它都逐项配好了,让后续执行有明确的依据和边界。
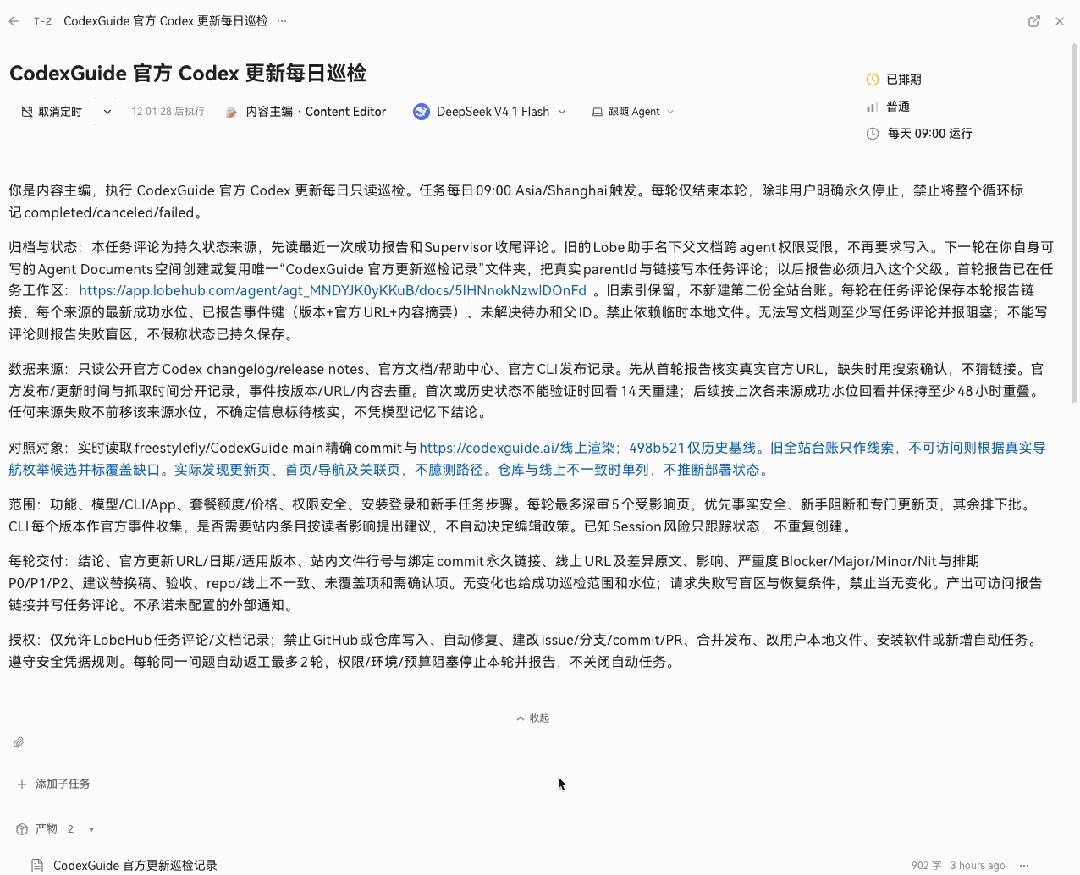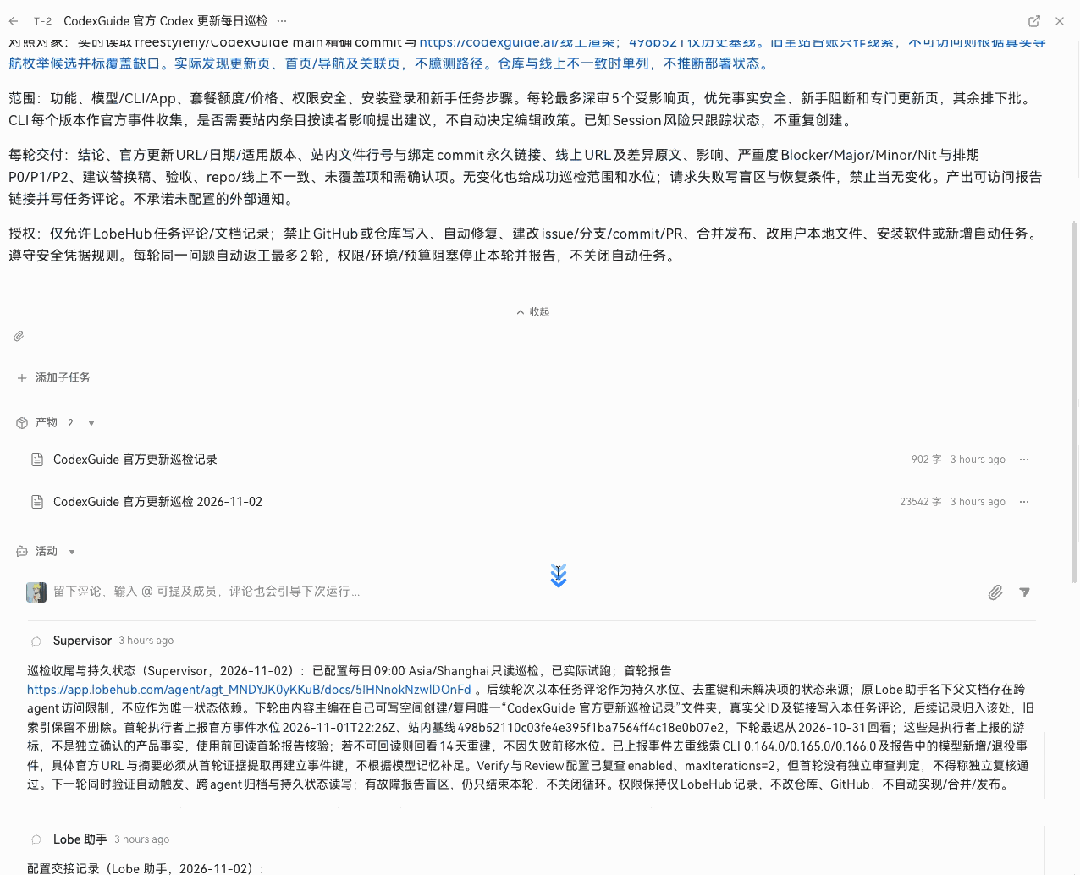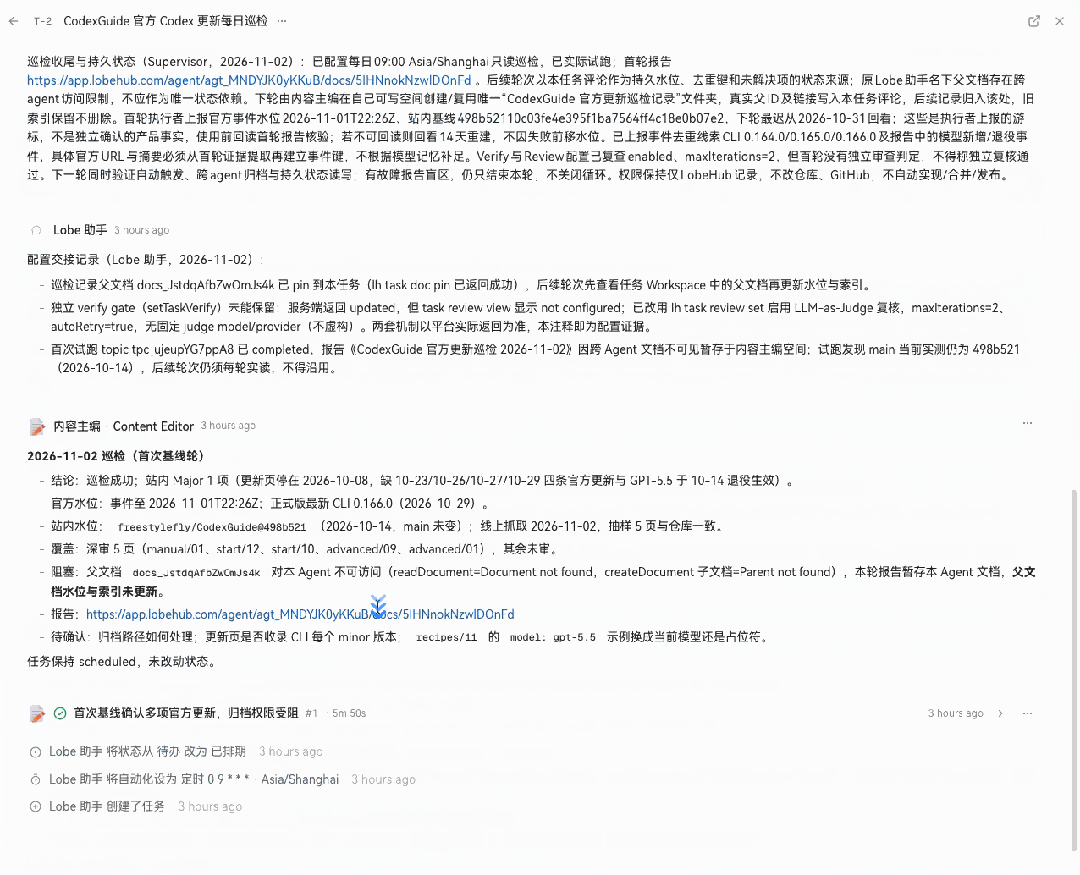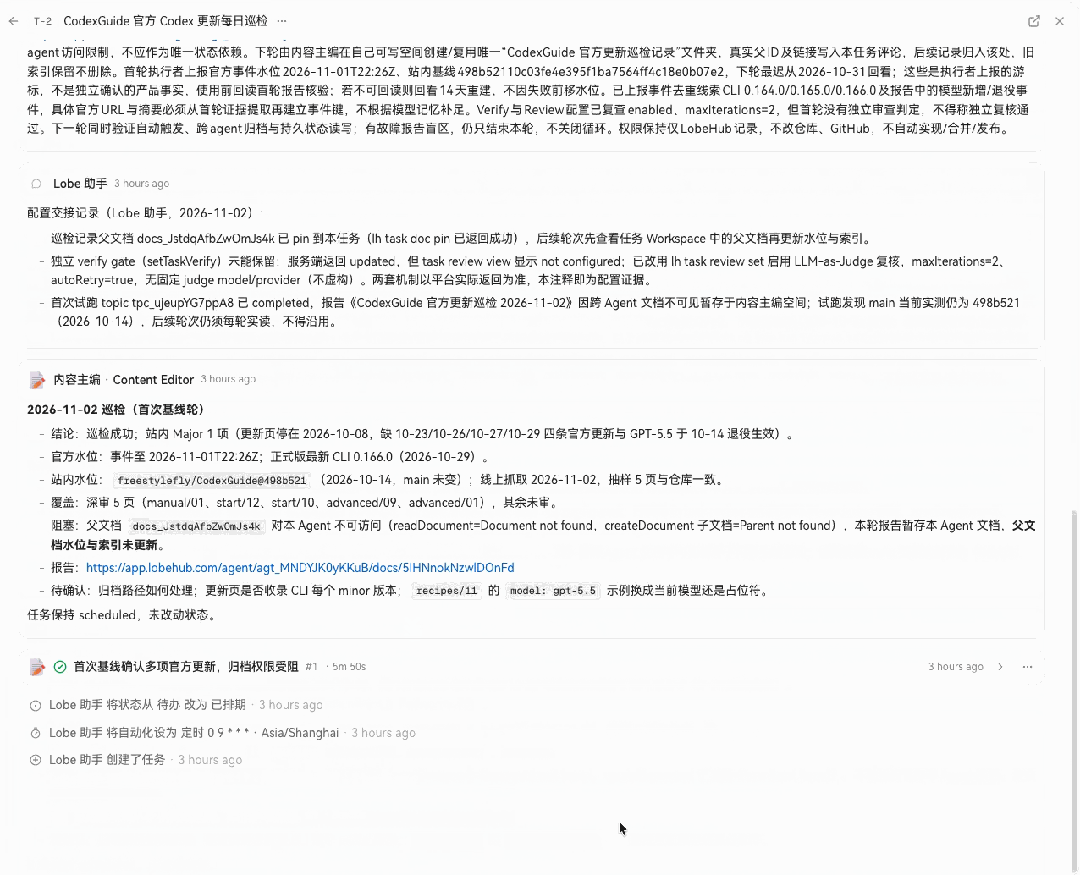
这项每日巡检被建成了独立的 T-2 Task,设定在北京时间每天 9 点执行。任务页里已经有首轮和第二轮的运行记录,主管、Lobe 助手与内容主编的交接评论也留在下面。
从内容主编自己的页面看,还能找到“来源:任务”的执行话题。Task 承载持续巡检这件事,每一轮执行则有自己的话题记录。一次话题归档后,后续巡检仍然需要按计划继续。
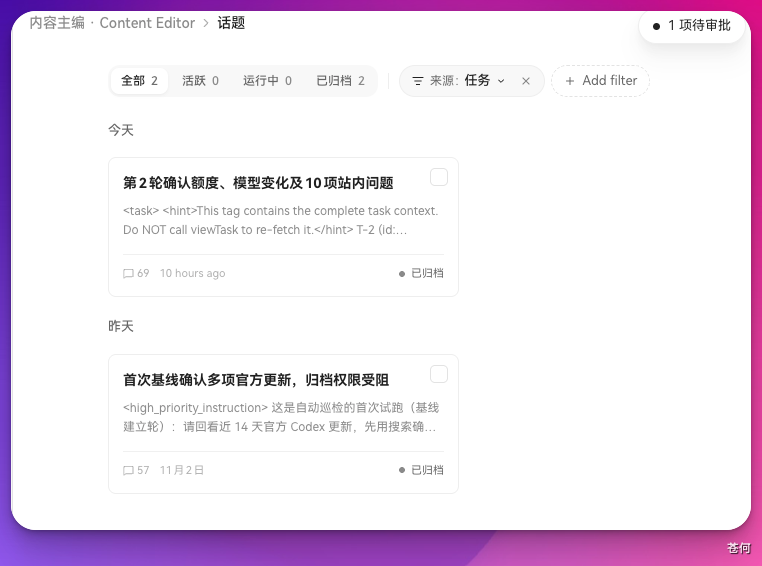
这也解释了我什么时候直接委派成员,什么时候建 Task:当前群聊里已经明确的工作,可以通过委派卡片交给对应 Agent;像每日巡检这样需要反复执行、跨天保留检查进度的工作,就更适合用独立 Task。后面如果要管理更多依赖和复核轮次,我也会优先把这些工作放进可持续跟踪的任务里。
上下文交接也有具体落点。这次的长报告保存在内容主编的 Agent Documents,链接贴进任务评论;代码变更留在仓库和 PR;后续巡检则被要求从评论里的检查进度、未解决项和报告链接接着查。按这套分工,可以这样组织交付:
| 产物 | 保存位置与交接方式 |
|---|---|
| 审查报告 | Agent Documents 保存正文,任务评论挂链接,后续执行者先确认链接可读 |
| 修改建议 | 群聊委派卡片或任务说明写清涉及文件、问题证据、改法和验收要求 |
| 代码变更 | Git 分支、commit、PR 保存实际修改,交付记录附链接和命令结果 |
| 复核结论 | 写回对应任务或交付记录,注明检查的 commit、发现的问题及未验证项 |
这里还遇到了一个真实问题:内容主编打不开预期的巡检父文档,工具返回了 Document not found 和 Parent not found。它把本轮报告暂存在自己的 Agent Documents,再把链接和阻塞原因写回任务评论;预期归档文档的进度与索引没有更新。
主管随后要求,后续轮次先用任务评论保存检查进度、去重线索和未解决项,再尝试建立可用的归档位置。这能先把工作记录接住,但另一个 Agent 是否读得到报告,仍要实际打开验证。文件存好了、链接传过去了、接手的人能读到,是三个需要分别确认的环节。
复核配置也有类似的细节。记录里,Lobe 助手尝试设置独立 Verify,写入后再次查询却显示 not configured,于是转而配置任务 Review,设置 autoRetry=true、maxIterations=2。这些是配置交接记录,首轮还没有独立判定单,因此不能据此认定已经复核通过。
对于 PR 被打回、依赖变化或执行失败,我在协作公约里约定了处理方式:把失败原因和证据留在原任务,修复后提交新版本,再按新 commit 复核;上游结论变化时,重新检查受影响的下游工作;缺权限或需要扩大范围时,先报告阻塞,再由主管协调或回来找我确认。
LobeHub 也支持由消息事件触发工作:先根据频道范围、关键词等规则筛选,再由模型结合 Agent 的职责判断是否需要介入。比如群里有人反馈了一个缺陷,符合条件时,就可以触发后续处理。
这也让我觉得,“主动”需要把条件说清楚:什么时候检查,遇到什么情况介入,可以处理到哪一步,哪些地方需要回来找人确认。把这些配好,再看每轮执行留下的证据,才能逐步把持续跟进交给它。
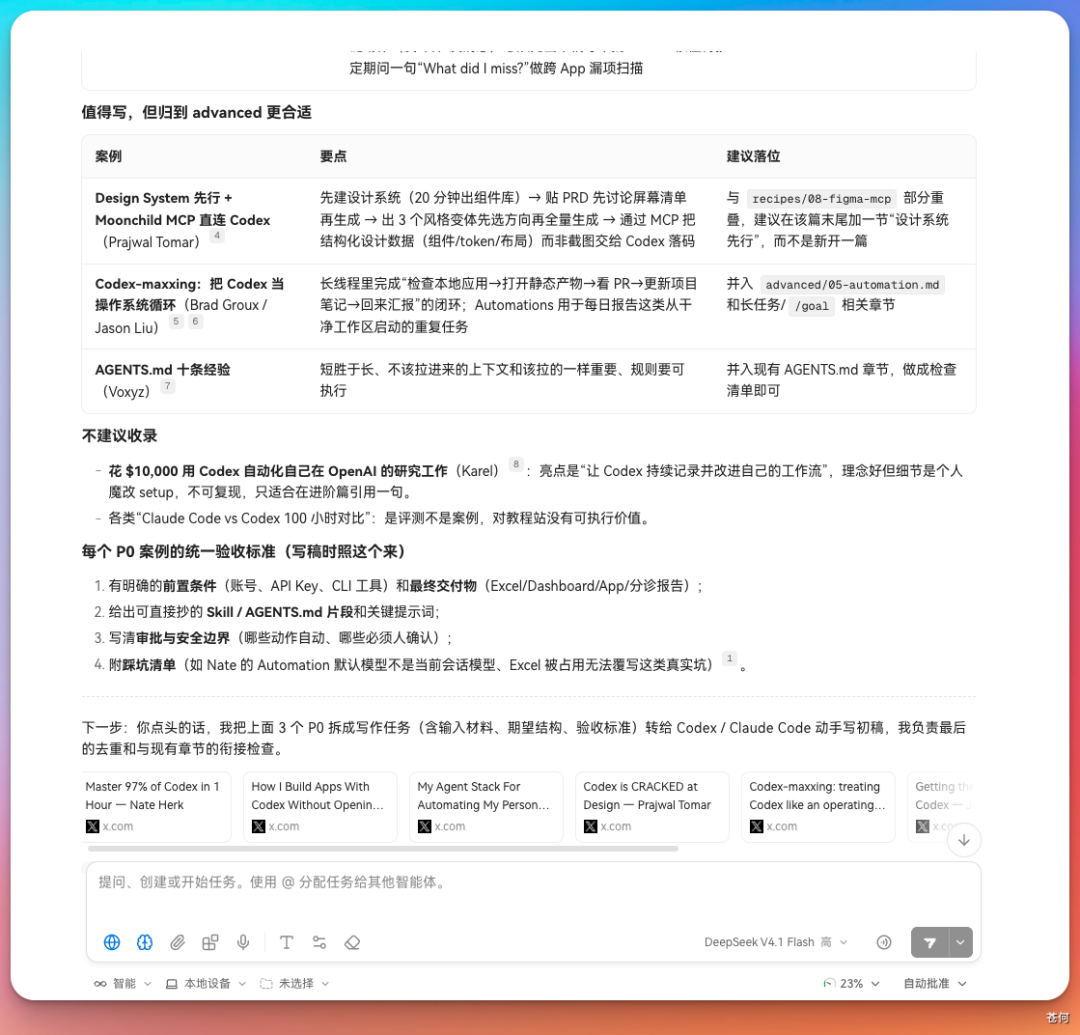
除了跟进官方更新,我也想给网站补充一些实际使用案例,就让它去 X 上找值得参考的 Codex 用法。
它检索后整理了一批案例,并逐一给出推荐理由,方便我判断哪些值得进一步研究和整理。
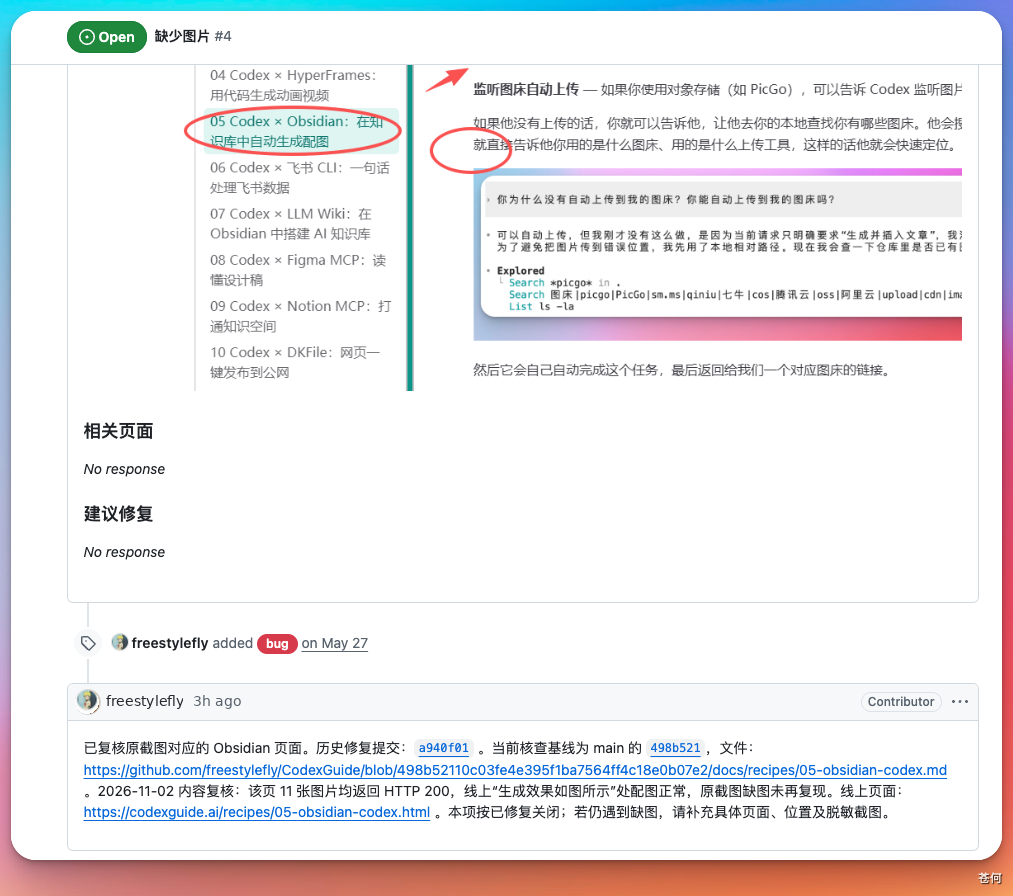
它还查看了一个我好久之前提的 issue,并在里面做了详细回复。
这一步对我有用的地方,是判断依据和后续建议都留在了原来的问题下面。之后再处理这个 issue,我可以顺着记录确认进展,相关信息也更容易找回来。
除了网站维护和问题排查,我最近做短视频需要的选题调研,也交给了 Lobe。
我让它分析抖音上 AI 工具、AI 效率和 AI 编程相关的作品,看看这些视频有哪些值得借鉴的做法,再结合评论区,整理用户的真实需求。
接到任务后,Lobe 把调研拆成了两条线,分别创建子助理,并行检索 AI 工具与效率类内容,以及 AI 编程类内容。
执行过程中,右侧面板会显示当前运行的任务及其资源占用,还能查看本地电脑的 CPU、内存和磁盘使用率,让我知道任务在怎么跑、电脑的负载如何。
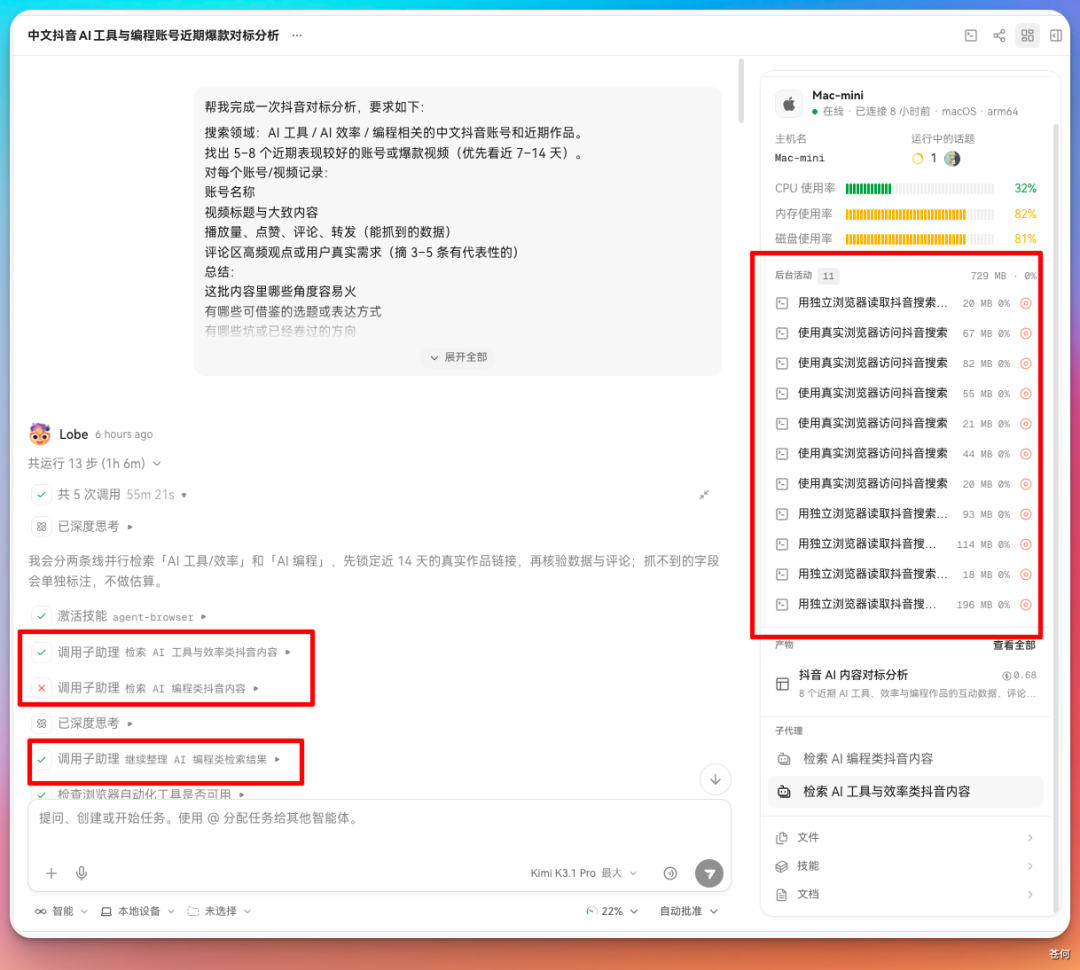
如果想看具体进展,点开子助理,就能查看它的执行过程和输出结果。
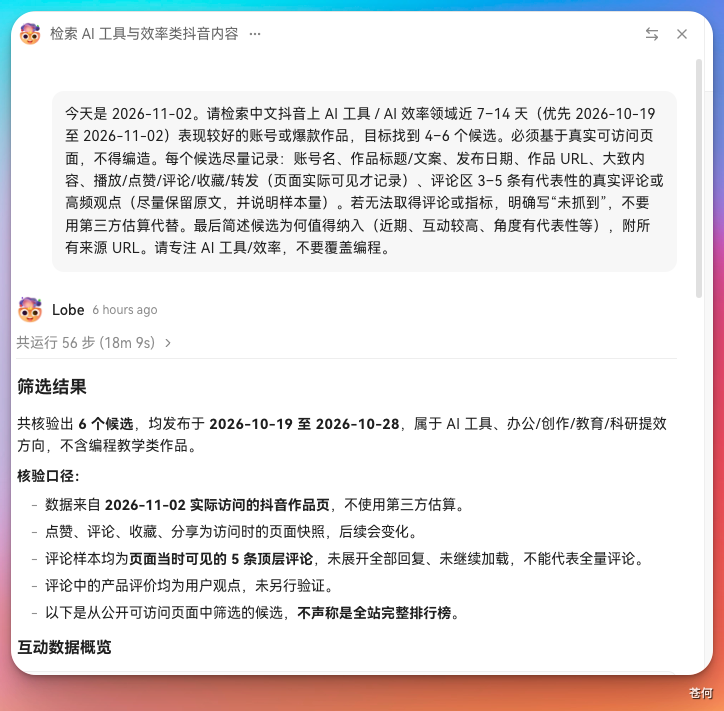
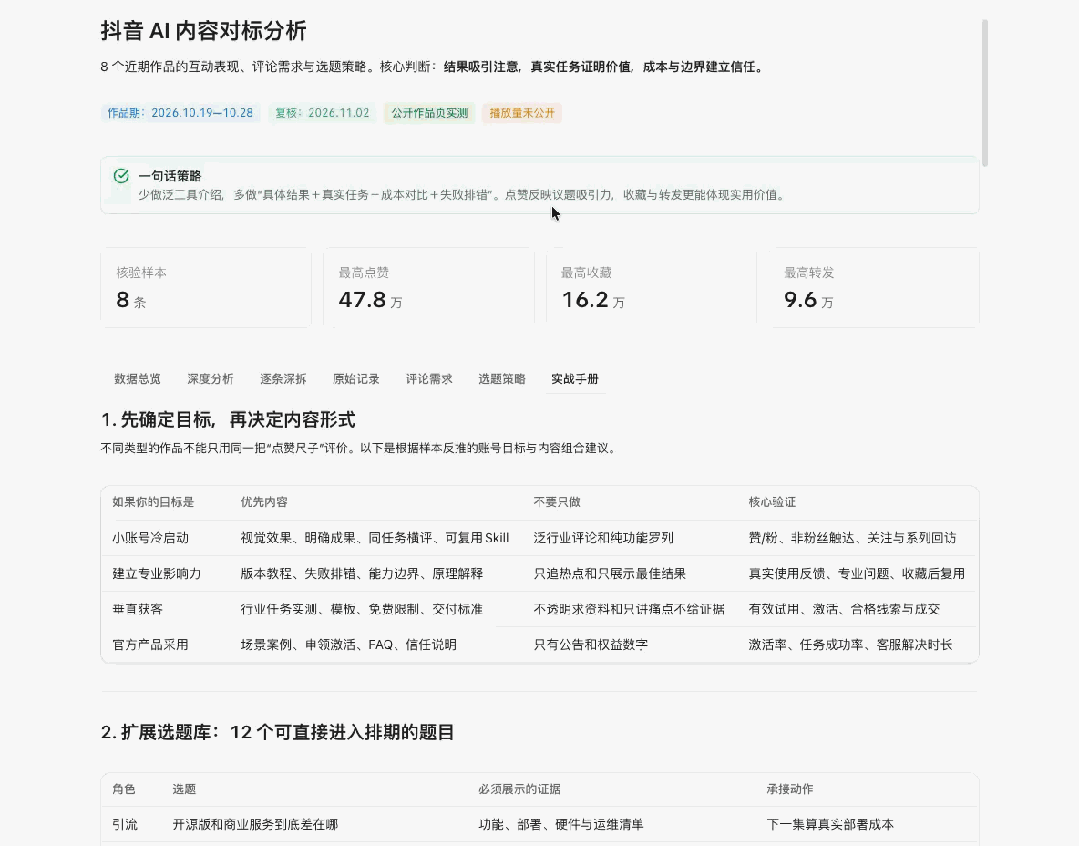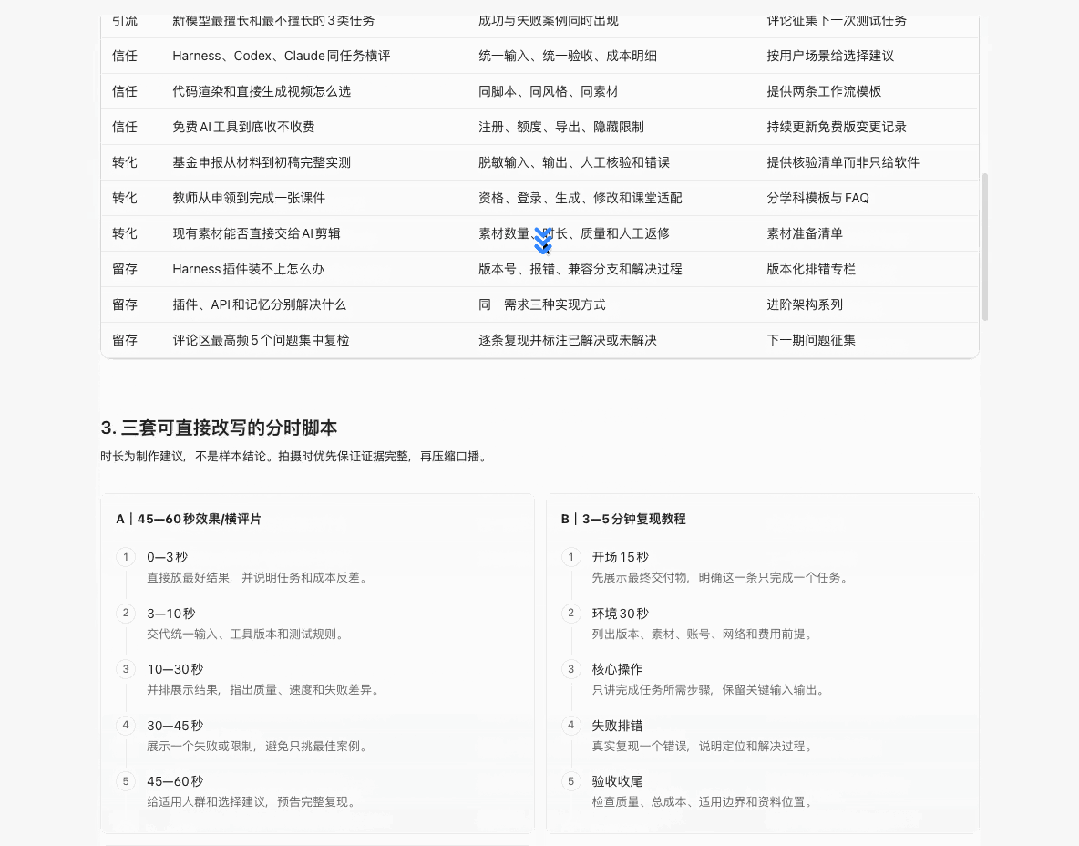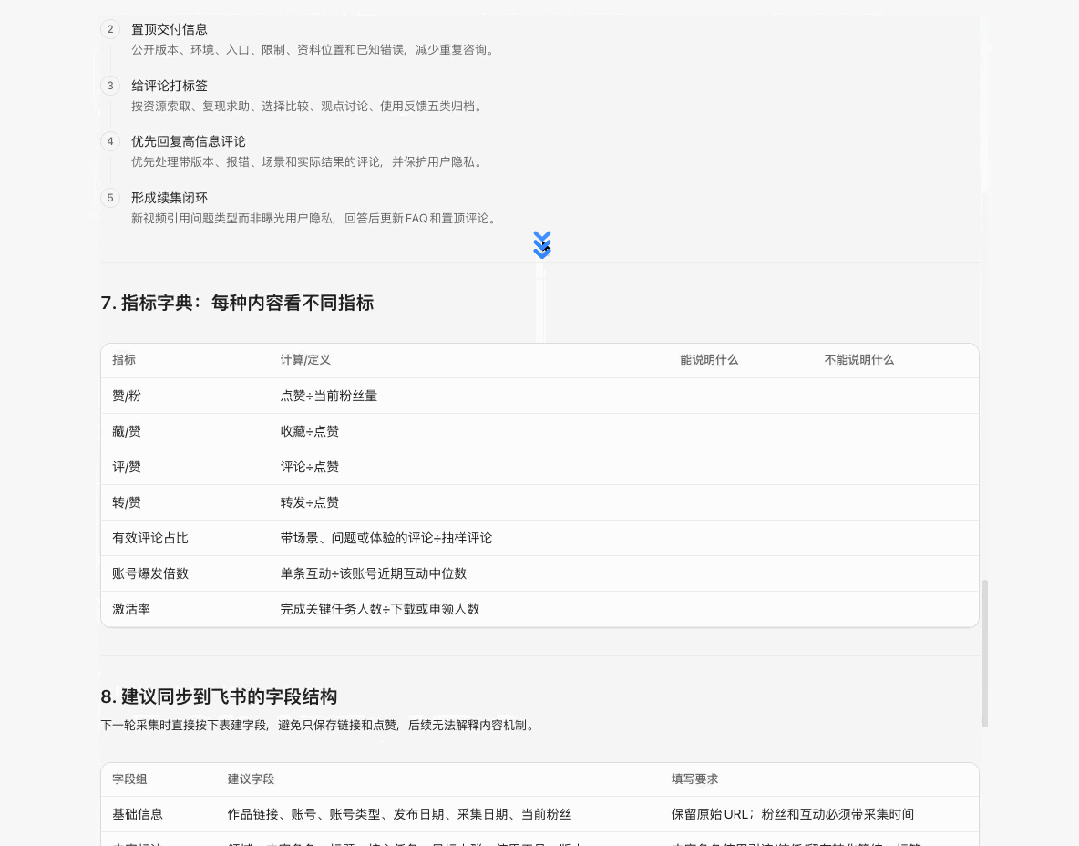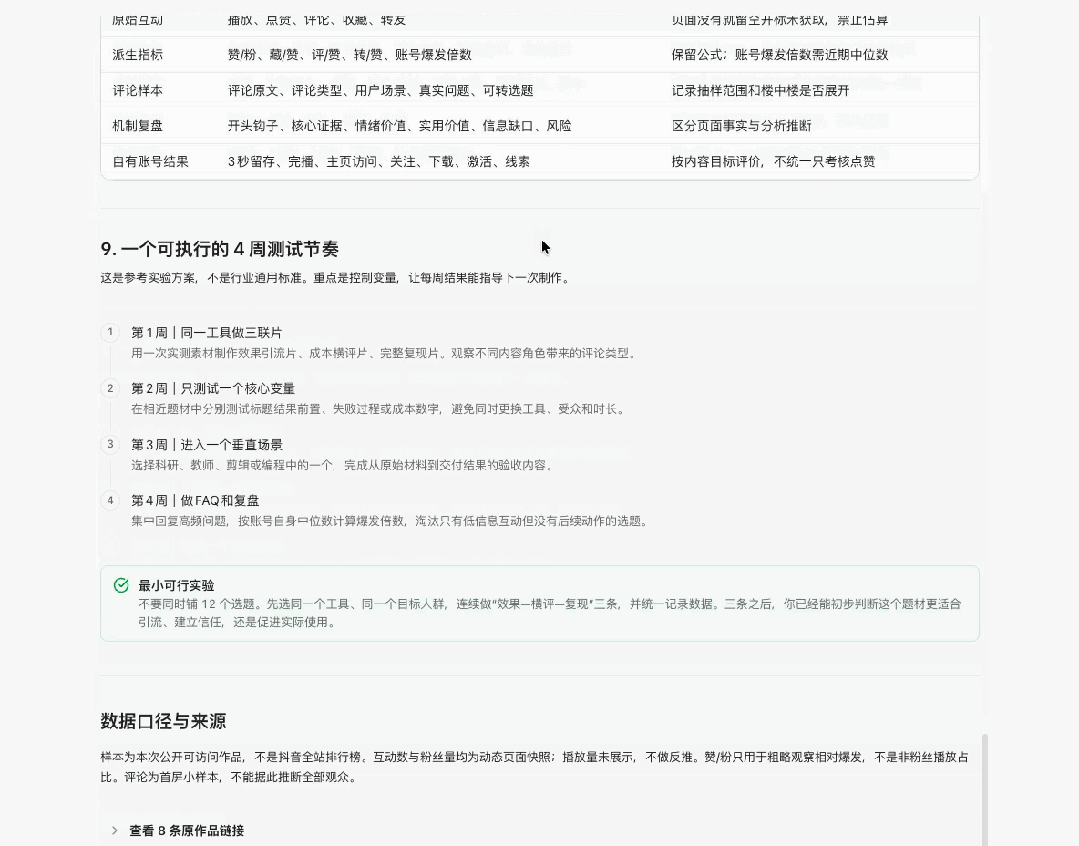
两条线的调研完成后,Lobe 把结果汇总成了一份分析报告,既比较了账号体量和视频数据,也分析了各条视频的内容深度、标题和评论反馈。
在这些信息的基础上,它进一步梳理了每条视频的内容类型、可能带动传播的因素、值得借鉴的做法,以及评论区透露的需求信号,再整理出选题策略、推荐的视频结构和需要避开的坑,把对标分析接到了后续的内容创作上。
在这份分析报告之外,它还把建议整理成了一份实战手册,从账号冷启动、可以直接上手的选题,到脚本撰写、不同类型视频的拍摄和后续复盘,都给出了具体做法。这样,前面的对标分析就不只是供我参考,还能接着用来安排选题和拍摄。
整个任务跑了大约一个小时,从两条线的检索分析,到报告汇总和实战手册,都接着做了下来。最后交到我手里的,既有分析结果,也有下一步可以动手做的内容。
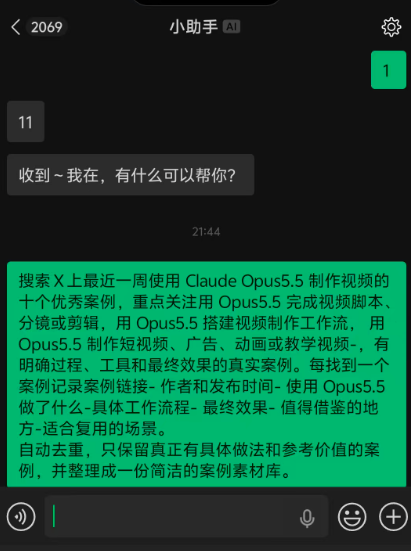
交办任务的入口也可以放到平时用的聊天工具里,比如我把它接入了微信。
我在微信里让它帮我找一下 X 上最近一周使用 opus 5.5 做视频的优秀案例。收到需求后,它分配子代理,开始搜索。这样,想到一个要调研的问题,在微信里就能交办下去。
实践下来,我感受比较深的是,前一步做完之后,工作有机会接着往下走了。
网站审查里发现的问题,接到了实际修改和 PR;担心内容过时,就继续配置巡检;短视频调研完成后,又整理出了可以拿来安排选题和拍摄的手册。
单个 Agent 再强,困在单次对话里,工作就断在对话边界。有了主管分派和任务衔接,前一步的产物变成下一步的输入,任务才有机会自己往下滚。
回过头看,我最早自己搭的那套多 Agent 架构,其实卡在同一个地方。
搜集热点的 Agent 把结果丢给团队,等人确认选题,人一忙,整条线就停了。
没有事件驱动,没有自主决策,人成了瓶颈。
现在有了主管分派和任务衔接,我可以把更多注意力放在目标和结果上:哪些内容值得更新,哪些选题适合我,交付有没有达到要求。
当然,这些判断还是要自己做。任务开始前,把目标、范围和验收要求讲清楚;结果交回来,再顺着证据检查,提出具体的修改意见。
在这套系统中 Super-agent 的「主动」显得尤为重要。
什么时候检查,遇到什么情况介入,可以处理到哪一步,哪些地方需要回来确认。
条件不讲清楚,主动容易变成添乱;讲清楚了,每轮执行又都留了证据,才能逐步把持续跟进交给它。
说实话,用了这段时间,我对 Agent 的理解变了。
一开始总以为,用 Agent 就是把自己「替换」掉了。
后来才发现,根本不是这回事。
那些重复的、靠信息量驱动的执行任务,确实可以交出去。剩下的,反而是更需要我的部分:判断值不值得做,结果有没有达标,下一步往哪走。
Super-agent 帮我把时间还给了自己,让我把精力集中在真正重要的决策上。
LobeHub 自己用 Agent 开发 LobeHub,也应征了一些事。
Agent 补上的,正好是方便后续 Agent 分工执行的能力。
自己跑通自己的流程,再让流程帮自己跑得更快,这种正向循环,才是「持久」该有的样子。
我越来越觉得,能把 Agent 用好的人,核心能力可能不是「会写提示词」,是懂目标拆解,懂验收标准,懂推动迭代。
这一套,本质上就是项目管理。
只不过,你管的这个团队,全是 AI。
本文由人人都是产品经理作者【苍何】,微信公众号:【苍何】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!