起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Claude已编写超90%的代码:Anthropic警告递归自我改进AI或将到来


Anthropic在S-1/A文件里披露,2026年9月代码库超过90%的贡献由Claude写成,工程师人均日代码量是2024年的45倍。数字很震撼,但它衡量的是贡献量而非有效产出,递归自我改进究竟走到哪一步?
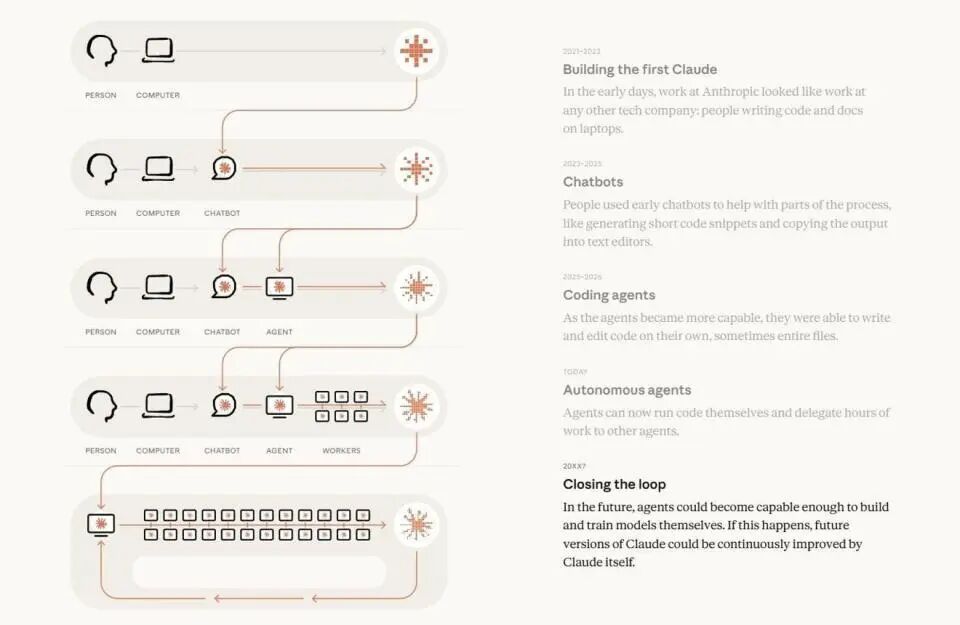
当 AI 只负责补全一行代码时,研发流程的边界还比较清晰:人类写需求,模型给建议,工程师审核并提交。现在,Claude 已经开始参与实验、训练数据处理、模型评估、安全审计和大规模代码编写,AI 辅助 AI 研发正在从局部工具变成完整工作流的一部分。
Anthropic 在提交给美国 SEC 的修订版 S-1/A 文件中披露,2026 年 9 月其代码库中超过 90% 的贡献内容由 Claude 编写;2026 年第三季度,每位工程师日均向代码库贡献的代码量超过 2024 年全年日均水平的 45 倍。
这两个数字很有冲击力,但不能直接等同于“工程师效率提升 45 倍”,也不能证明 Claude 已经自主完成下一代模型研发。真正值得开发者关注的是:当 Agent 开始参与自身迭代,代码审查、实验可复现、安全评估和人类审批应该如何重新设计。
90%的代码贡献,究竟说明了什么
Anthropic 披露的 90% 指代码贡献量,不是有效功能数量、生产事故率、研发周期或最终产品质量。AI 可以快速生成大量样板代码、测试代码、实验脚本和重构补丁,但这些内容仍然需要人类判断是否符合目标。
对代码 Agent 来说,更有价值的指标应该至少包括:
| 指标 | 需要回答的问题 |
|---|---|
| 首轮通过率 | 生成的补丁是否第一次就通过构建和测试 |
| 有效变更率 | 提交代码中有多少真正进入主分支 |
| 人工返工量 | 工程师需要删改多少无效或危险代码 |
| 回滚率 | AI 变更是否引发回退、事故或重复修复 |
| 端到端周期 | 从需求到稳定交付是否真的变短 |
| 安全缺陷率 | 自动生成代码是否带来新的漏洞和权限问题 |
日均代码量提升 45 倍,更像是研发活动被 AI 大幅放大了。放大后的产出如果没有更强的测试、审查和发布闸门,可能只是把更多代码更快地推向审查队列。
Claude已经参与模型研发闭环了吗
Claude Code 现在可以编写和运行程序,在较长时间内处理多步骤工程任务。Anthropic 还披露,Claude 已参与模型训练与研究,包括执行实验、生成和处理训练数据、自动化模型评估与安全审计,以及编写和审核代码。
这形成了一个研发“闭环”:模型越强,能够承接的研发任务越多;研发效率提升,又可能加快新模型迭代。闭环并不等于完全自动化,关键差别在于谁决定研究目标、谁判断实验价值、谁批准模型进入下一阶段。
一个更准确的工作流可以写成:
人类提出研究方向
-> Agent 拆解实验任务
-> Agent 编写代码并运行实验
-> 自动生成数据、评估和安全报告
-> 研究人员判断结果价值
-> 人类批准下一轮方向和发布决策
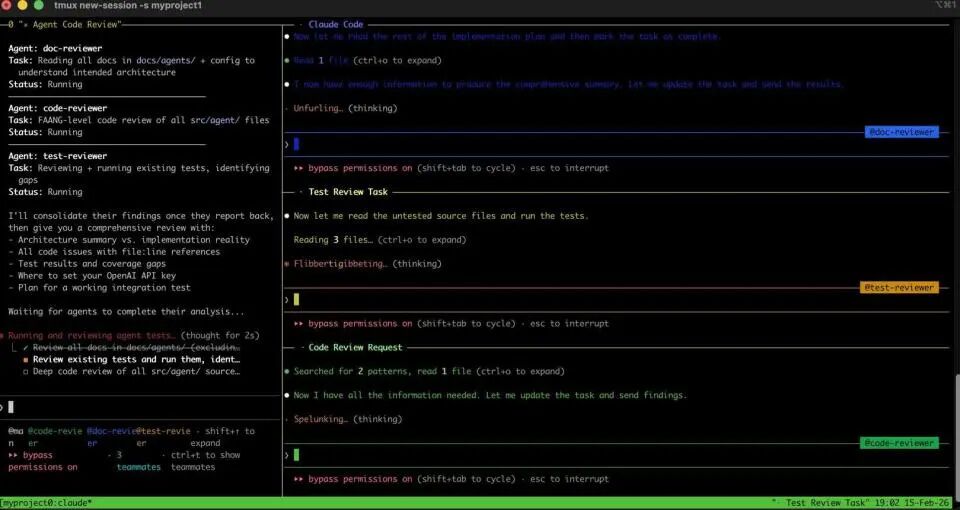
研究报告《当 AI 构建自身》显示,Claude 在目标和评估标准明确的实验执行任务中,已经能够匹敌甚至超过熟练研究人员。但在研判科研方向、筛选课题和作出全局判断方面,人类仍然占据明显优势。
这一区分对工程团队同样重要:可以让 Agent 自动跑测试、做基准评估和生成候选补丁,但不能让它自行决定什么是成功、哪些风险可以接受、哪些变更能够进入生产。
什么是递归自我改进
递归自我改进(RSI)并不是“模型会自己写代码”这么简单。更严格的判断需要看:AI 是否能够自主发现能力瓶颈,设计提升方案,执行训练或系统修改,评估结果,再把改进后的能力用于下一轮研发,并且这种循环能持续加速。
Anthropic 在风险因素中提到,公司可能很快达到《负责任扩展政策》(RSP)中“可归因于 AI 的急剧加速进展”标准,但同时明确表示,目前尚未认定现有模型已经跨过这一门槛,评估仍在进行。
按照 2026 年 7 月生效的 RSP 3.4 版本,研发自动化门槛有两条择一满足的路径:
- AI 模型以有竞争力的成本,完全替代公司全体研究科学家和研究工程师。
- AI 研发自动化使 AI 整体能力进步速度达到两倍。
第二条路径的比较对象既包括没有显著 AI 研发贡献时的预期速度,也包括历史上至少跨越三代模型的最快持续进展速度。这里的“翻倍”指整体 AI 能力进步速率,不是某位科研人员的个人效率提升。
这个定义避免了一个常见误读:代码生成更多、实验运行更快,并不自动等于递归自我改进已经发生。还要证明 AI 的研发贡献是能力加速的主要原因,而不是简单增加人员、扩容算力或改善一般生产率。
速度超过安全治理,会出现什么问题
Anthropic 对研发加速的担忧很具体:AI 参与自身迭代后,模型能力提升速度可能快于安全、对齐与安保措施的研发、验证和部署速度。
这会带来一种“滞后风险”。当团队发现能力增长已经明显加快时,可能已经落后了几轮模型迭代;而安全评估往往需要收集大量边界案例,无法完全跟上每次模型和工具链变化。
工程团队不能只给 Agent 增加一个“允许执行”的开关,而应该把研发闭环拆成多个隔离面:
- 实验环境与生产环境隔离,模型不能直接读取生产凭据。
- 训练数据、评估数据和红队数据分开管理,防止测试集泄漏。
- 模型生成的代码必须经过构建、测试、静态扫描和人工审查。
- 每轮模型变更保存版本、权重、提示词、工具调用和评估轨迹。
- 当能力指标出现异常增长时,自动触发暂停、复核和安全评估。
尤其要防止 Agent 修改自己的评估标准。如果执行模型可以决定哪些测试通过、删除哪些失败样本,评估结果就失去了独立性。安全评估器、基准数据和发布审批应该拥有独立权限。
人类监督不能只剩下最后一次点击
Anthropic 表示,目前不认为在缺乏有意义的人类监督或理解时,Claude 可以安全地自主设计和构建后续前沿模型。公司正在考虑更新 RSP,以确保人类继续掌握研发过程的控制权。
“人类在环”不能被简化成发布前点一次确认。高质量监督至少需要覆盖四个节点:
- 目标监督:人类决定为什么做这项实验,以及什么结果才有价值。
- 过程监督:人类可以查看 Agent 的工具调用、数据来源和中间状态。
- 结果监督:独立评估器验证结果,不能只相信执行模型自己的总结。
- 发布监督:模型、代码、权重和安全策略变更必须经过明确审批。
如果 Agent 一次运行几小时,监督者却只能看到最终报告,实际上仍然是“黑盒自动化”。对于高风险研发任务,系统应提供可暂停、可恢复、可回滚和可审计的控制面。
Claude Code进入研发团队后,权限怎么分层
Claude Code 这类 Agent 适合承担明确、可验证、可回滚的任务:生成测试、运行基准、分析日志、提出补丁、整理实验结果和更新文档。涉及生产发布、模型权重、训练数据和安全策略时,权限应该逐级收紧。
一个实用的分层方式是:
| 层级 | Agent可以做什么 | 必须保留的控制 |
|---|---|---|
| 只读分析 | 读取代码、日志和公开数据 | 路径白名单、脱敏、审计 |
| 隔离实验 | 修改临时分支、运行测试和基准 | 沙箱、资源限额、自动回滚 |
| 研究协作 | 生成实验脚本、处理训练数据 | 数据审批、结果复核、独立评估 |
| 模型变更 | 修改权重、训练配置或安全策略 | 双人审批、版本签名、发布闸门 |
国内开发者如果需要将 Claude Code 等工具接入兼容 API,可通过 Code80(https://code.ai80.vip/home) 配置 endpoint;代码权限、训练数据、模型权重、密钥隔离和生产审计仍应由项目侧管理。
现在最应该建立的观测指标
在递归自我改进真正成为现实之前,团队可以先把观测体系补齐。建议同时记录 AI 研发贡献和最终研发结果,避免只看一个“AI 写了多少代码”的漂亮数字。
研发自动化账本 = 代码贡献量
+ 有效变更率
+ 测试通过率
+ 实验成功率
+ 人工返工量
+ 安全缺陷率
+ 端到端交付周期
还要单独跟踪“模型是否在帮助改进下一代模型”:它调用了哪些训练工具,是否生成了训练数据,是否参与评估和安全审计,哪些决策仍由人类完成。只有把这些链路记录下来,团队才能知道 AI 参与研发是在提高效率,还是在扩大不可见的风险。
常见问题
Claude已经实现递归自我改进了吗?
没有。Anthropic 只是提示未来模型可能接近 RSP 中的相关门槛,并明确表示目前尚未认定现有模型已经跨过该门槛。
Claude编写90%的代码等于效率提升90%吗?
不等于。90%描述的是代码贡献量,不能直接代表有效产出、研发效率、代码质量或最终业务价值。
为什么AI参与模型研发会带来安全风险?
因为能力提升速度可能超过安全、对齐和安保措施的研发与验证速度,且滞后指标可能让团队晚于能力增长发现风险。
人类监督应该放在哪些环节?
至少覆盖研究目标、实验过程、评估结果和最终发布。人类不能只在最后一次点击时出现,还要能暂停、审查、回滚和追责。
Claude Code适合直接修改训练配置和模型权重吗?
不适合默认开放。应先在隔离环境中生成候选变更,经过独立评估、双人审批、版本签名和回滚验证后再考虑发布。
国内开发者如何接入兼容 API?
可以通过 Code80 了解接入方式,同时自行管理模型权限、数据留存、密钥、工具网关和审计日志。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自作者提供

- 目前还没评论,等你发挥!