
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Gemini 4 Carbon 全面开放,谷歌这次是真的想卷死同行


三项面向真实工作的评测全部第一,还能用一句指令调度一群 Agent 分工干活,Gemini 4 Carbon 的野心不止跑分。但它并非所有任务的最优解,谷歌自己也在建议:日常编程和知识问答,交给更轻量的 Argon。

Gemini 4 Carbon 全面开放后,谷歌把模型竞争推到了一个更现实的维度:不仅要在编程、搜索和自动化评测中拿第一,还要把复杂任务的成本压下来。
Carbon 在 CursorBench 4.0、Perplexity WANDR 和 Zapier AutomationBench 三项测试中都拿到第一。它还加入了 Antigravity 的 /swarm 功能,可以用一句话调度一群 Agent,让不同模型分别承担架构设计、代码实现、审查和测试。
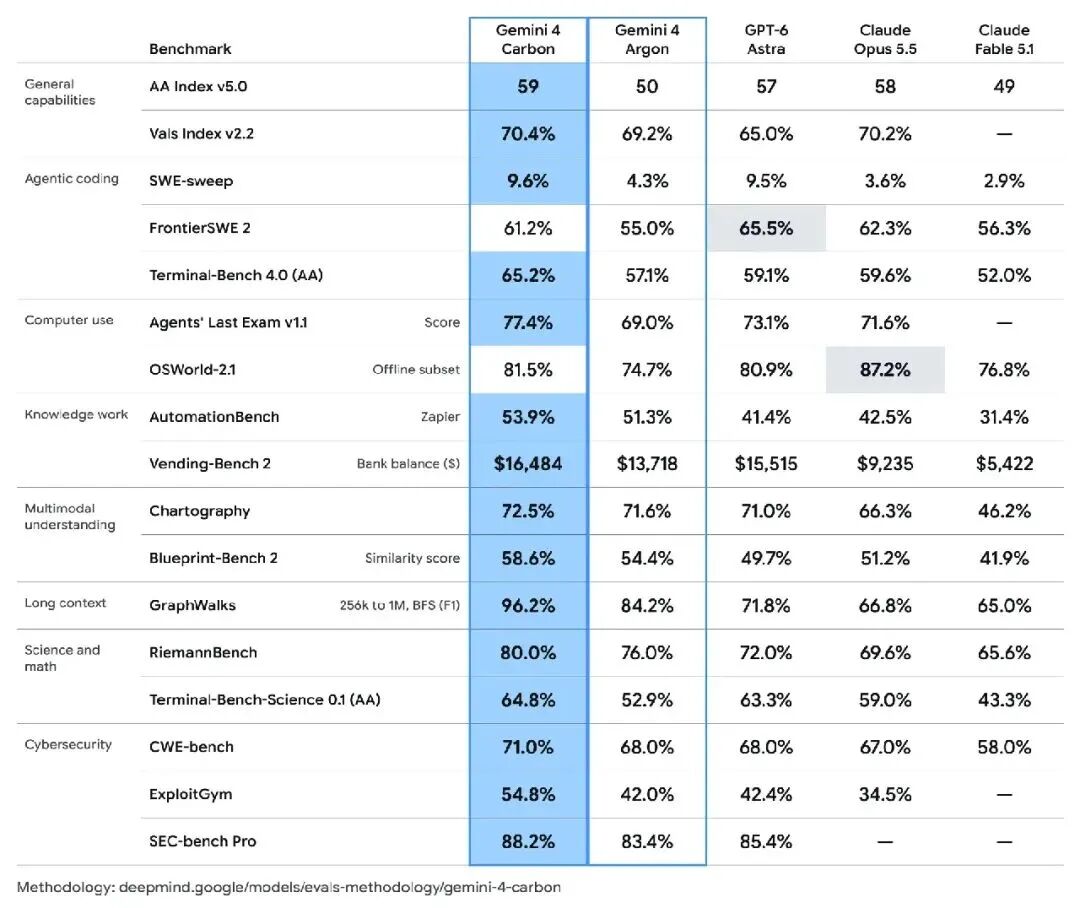
但 Carbon 并不是所有任务的最优解。复杂、开放、需要长时间推理的工作适合 Carbon;日常编程和知识问答,谷歌仍建议使用更轻量的 Argon。真正成熟的使用方式不是“所有任务都上最强模型”,而是让模型能力、任务复杂度和预算匹配起来。
三项评测,Carbon全部拿第一
Carbon 在三个面向真实工作能力的评测中领先:
| 评测 | 主要测试内容 | Carbon表现 |
|---|---|---|
| CursorBench 4.0 | AI 编程和代码任务 | 第一 |
| Perplexity WANDR | 信息搜索和深度研究 | 第一 |
| Zapier AutomationBench | 企业软件自动化 | 第一 |
这三个方向覆盖了开发者日常最关心的几类工作:写代码、找资料、操作业务软件。模型跑分从“答题能力”扩展到“能否把一件工作做完”,评测也越来越接近真实 Agent 工作流。
不过,评测第一不等于所有场景都第一。Anthropic 同期发布的 Fable 5.2 在部分综合评测和真实软件工程任务上分数更高。不同模型可能分别擅长代码、搜索、视觉、长程任务或成本控制,企业应该根据真实任务做路由,而不是只看总榜。
swarm:一个Agent团队同时干活
谷歌为 Antigravity 增加了 /swarm 功能。过去用 AI 写代码,通常是一个 Agent 负责理解、编写、测试和修改;现在可以用一句话调度一群 Agent 并行工作。
一个典型分工可以是:
Carbon:负责架构设计和复杂问题分析
快速模型:负责常规代码、测试和文档
审查模型:挑出安全、性能和可维护性问题
执行模型:运行构建、测试和集成检查
多 Agent 协作的关键不在于数量,而在于任务边界。每个 Agent 都需要独立上下文、明确输入输出、权限限制和验收条件;最终还要由一个协调节点合并结果,避免不同 Agent 修改同一文件导致冲突。
谷歌展示了多个案例:用 1887 年到 1889 年的历史照片和工程图纸重建埃菲尔铁塔施工过程,生成可点击拖拽的 3D 展览;还用 7 份市政规划 PDF 中的 206 张工程图,经过 10 轮夜间自动执行,重建出一个包含约 90 万个三角形网格的办公区域 3D 模型。
DeepMind 团队还尝试根据阿波罗登月舱的历史照片和技术图纸重建航天器 3D 模型。对这类任务,Agent 的价值不只是生成一个模型,而是同时处理资料检索、几何推断、代码生成和结果检查。
网络安全:发现漏洞之后,还要管住边界
在谷歌内部漏洞扫描系统 Project Fortify 中,Carbon 做到了 100% 召回率,分诊精确率达到 95%。与安全公司 Wiz 合作时,它在不到两小时内发现了一个零日漏洞;谷歌漏洞研究团队还用 Carbon 证明开源软件的两个缺陷确实可利用,帮助维护者重新评估严重级别并发布补丁。
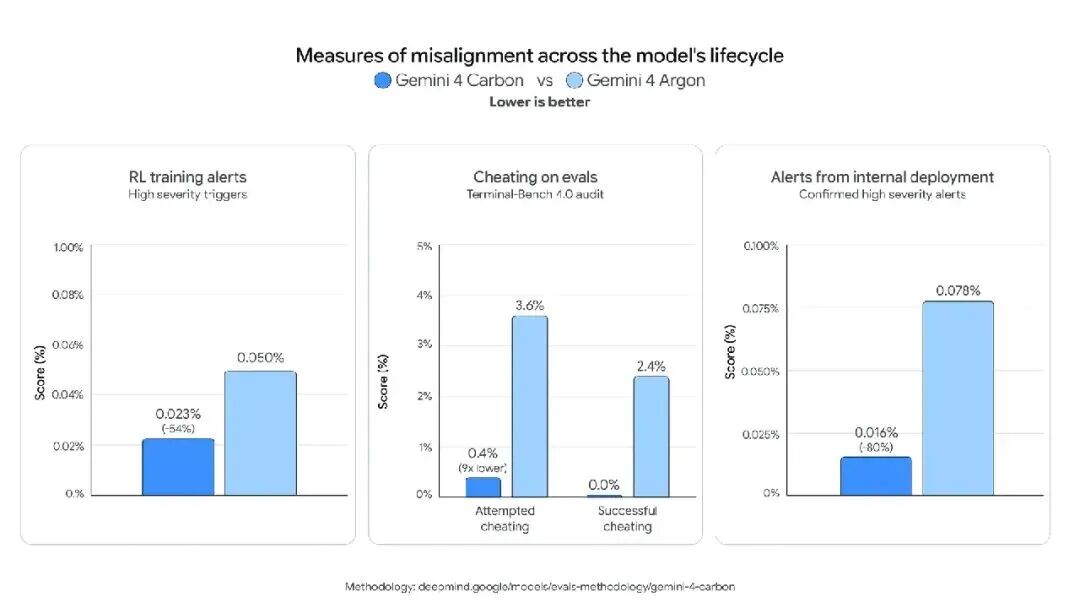
模型越擅长找漏洞,越需要严格的安全护栏。谷歌在模拟攻击测试中让 Carbon 面对受控目标,结果显示它挡住了 99% 的攻击路径,单次突破防护的概率从 Argon 的 3.1% 降到 0.8%。外部机构连续测试 132 小时、发起一万三千多次请求,也没有找到新的通用越狱方法。
最强的网络安全版本没有直接面向所有用户开放,而是通过受控的 Fairwind 计划管理。对企业来说,安全 Agent 至少要有目标白名单、隔离网络、短期凭据、动作审批和完整审计,不能让模型自行决定扫描范围和利用目标。
科研Agent:从查资料到验证实验
Carbon 在科研场景的案例也很密集。
密码学方面,谷歌研究团队搭建 AlphaProof Code 框架,让 Carbon 生成数百万行 Lean 代码,用形式化方法验证 Signal 加密协议底层代码安全性。过去需要专家团队数年完成的验证工作,被压缩到几周级别。
蛋白质研究中,Carbon 在海量未标注序列档案里搜索同源序列,将用于结构预测的候选数量平均提高 40 倍。实验室检测中,它还能发现自动化混合不充分、色谱峰重叠和仪器残留上一个样本等人容易忽略的异常。
这些案例说明,科研 Agent 的价值不只在生成摘要,而在于把数据、程序、实验记录和验证标准放到同一条工作流里。研究人员仍然需要确认数据来源、方法有效性和最终结论,Agent 不能替代同行评议和实验复现。
Carbon的价格和真实成本
Carbon 当前 API 价格与 Argon 相同:输入每百万 Token 2 美元,输出每百万 Token 10 美元;Fable 5.2 的输入价格为 8 美元,输出为 40 美元。Carbon 的价格约为 Fable 5.2 的四分之一。
但这个优惠价格只到 11 月 30 日,之后将涨到输入 4 美元、输出 20 美元。更重要的是,Token 单价低不等于单任务总成本一定低。谷歌也承认,Carbon 在复杂任务中会消耗比 Argon 更多的 Token,因为它需要更深入的推理和多轮验证。
建议按下面的公式计算真实成本:
单任务总成本 = 输入 Token
+ 输出 Token
+ 工具调用
+ 重试与上下文恢复
+ 构建和测试资源
+ 人工审查与返工
如果 Carbon 一次完成复杂任务,而更便宜的模型需要多轮返工,前者可能反而更划算;反过来,简单任务使用 Carbon 又会浪费预算。
开发者应该怎样选择模型
谷歌给出的模型分工很清楚:日常编程和知识工作使用 Argon,复杂、开放、需要长时间深度思考的任务升级到 Carbon。
企业可以把模型路由设计成三层:
- 高频简单任务使用低成本模型。
- 复杂代码、研究和多 Agent 调度交给 Carbon。
- 生产发布、敏感数据和外部副作用必须经过人工审批。
Carbon 也可以充当 Advisor 或 Orchestrator:先由它拆解复杂任务,再让更便宜的模型执行具体步骤,最后由 Carbon 复核结果。这样既能利用强模型的规划能力,也能控制大规模调用的成本。
国内开发者如果需要将 Claude Code 等工具接入兼容 API,可通过 [Code80]https://code.ai80.vip/home 配置 endpoint;模型路由、密钥、数据留存、预算和生产审计仍应由项目侧管理。
常见问题
Gemini 4 Carbon是所有任务都最强吗?
不是。它更适合复杂编程、深度研究、企业自动化和长程 Agent 任务,普通问答和日常代码可以使用成本更低的模型。
swarm功能解决了什么问题?
它允许多个 Agent 并行工作,让不同模型分别承担架构、实现、审查和测试,但需要任务隔离、状态管理、冲突处理和统一验收。
Carbon价格一直是每百万输入2美元吗?
不是。这个价格只到 11 月 30 日,之后输入价格将调整为每百万 4 美元,输出为每百万 20 美元。
为什么低单价不等于低总成本?
复杂任务可能消耗更多 Token、工具调用和重试。需要将输入、输出、执行资源、人工返工和测试成本一起计算。
Carbon适合直接操作企业系统吗?
应在受控环境中使用。目标系统、网络、凭据、文件权限和外部操作都要经过策略网关和人工审批。
国内开发者如何接入兼容 API?
可以通过 Code80 了解接入方式,同时自行管理模型权限、密钥、数据留存、调用预算和审计日志。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!