
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
从 Demo 到生产:给 LangChain 售后助手补上上下文、长期记忆、流式输出和可观测性


前两篇把一个售后助手搭了起来,加上会话记忆和结构化输出,它已经能处理一段真实对话。但接进业务系统还差几步:工具怎么知道当前用户是谁,长任务怎么先给一句反馈,出问题又该怎么排查。这篇补齐运行时上下文、长期记忆、流式输出和 LangSmith。
前两篇,我们从模型和工具开始,创建了一个售后助手。后来又给它加上了会话记忆、中间件、人工确认和结构化输出。
现在,这个助手已经能够处理一段售后对话了。如果我们要把它接到一个真实的业务场景里面,还有几个问题需要考虑。
比如,用户登录后问“帮我查一下我的订单”,工具怎么知道当前用户是谁?Agent 查询订单时,页面能不能先显示一条“正在查询,请稍后呢”的消息给到用户呢,而不是让用户一直等待?如果Agent最后给出的回答有问题,我们又该怎么排查呢?
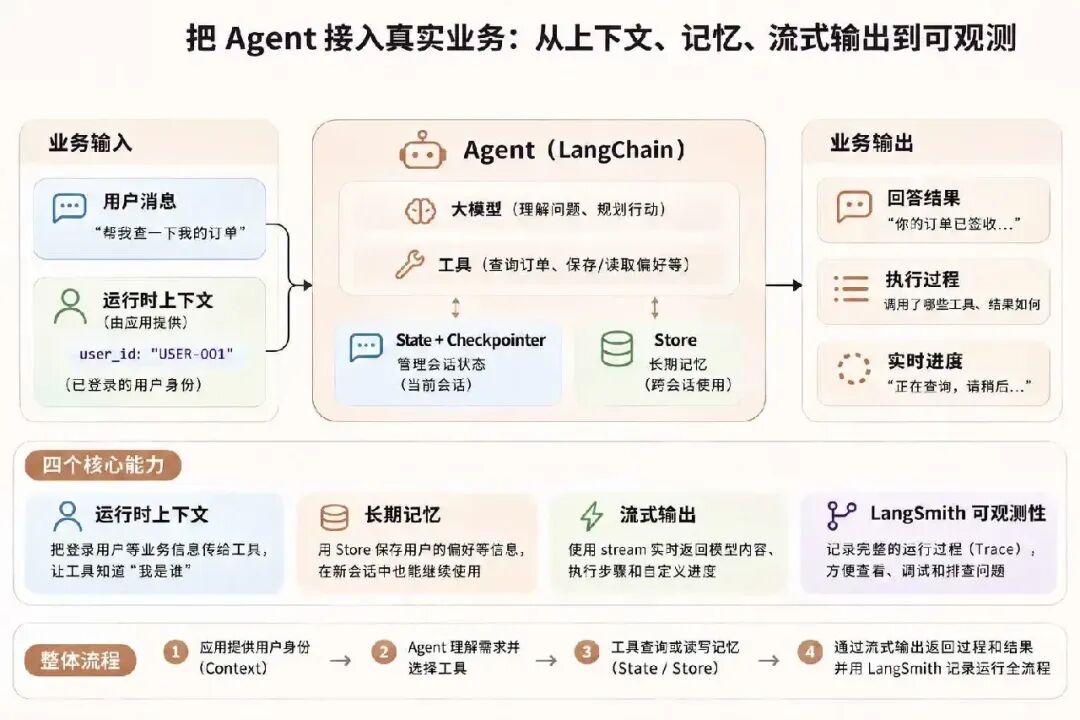
这篇文章,我们继续来看看 LangChain 的运行时上下文、长期记忆、流式输出和 LangSmith 。
运行时上下文
我们先来看查询订单的问题。
第一篇的工具接收订单号,模型需要从用户消息中提取订单号,再作为参数传给工具。但在一个已经登录的应用里,用户可能只说“查一下我的订单”,并没有提供订单号。
这时候,应用已经知道当前登录的是哪个用户。我们需要把这个信息交给工具,让工具去查询这个用户的订单。
LangChain 提供了 Runtime Context,也就是运行时上下文。我们可以先定义上下文包含哪些信息,在每次调用 Agent 的时候传进去,执行工具的时候,再从运行时对象中读取相关信息。
定义上下文和查询工具
下面先定义一个 UserContext 的上下文对象,里面只放用户编号:
from dataclasses import dataclass
@dataclass
class UserContext:
user_id: str
接下来定义查询工具。这里只做一个模拟,判断一个用户编号,并直接返回两项固定的订单信息:
import json
from langchain.tools import ToolRuntime, tool
@tool
def get_my_order(runtime: ToolRuntime[UserContext]) -> str:
“””查询当前登录用户的模拟订单信息。”””
runtime.stream_writer(“正在查询当前用户的订单”)
user_id = runtime.context.user_id
if user_id != “USER-001”:
return json.dumps({“error”: “未找到当前用户的订单”}, ensure_ascii=False)
runtime.stream_writer(“订单查询完成”)
return json.dumps(
{“order_id”: “ORDER-1001”, “received_at”: “2026-10-08”},
ensure_ascii=False,
)
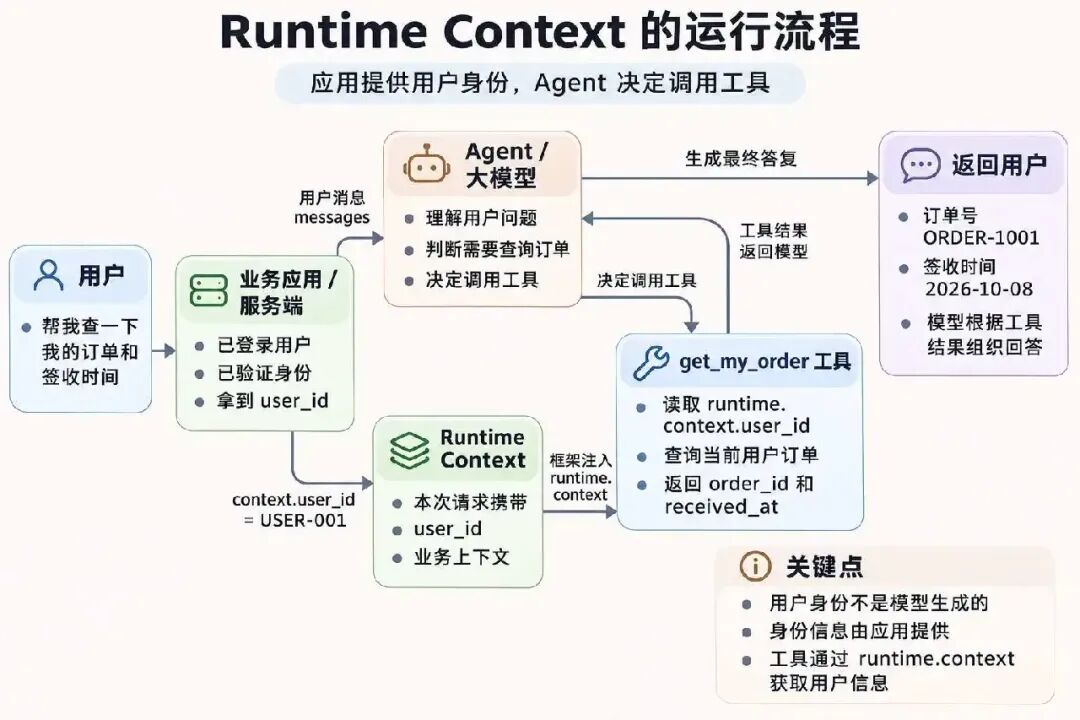
这个工具不需要模型填写生成用户信息,而是通过 runtime.context.user_id 获取。runtime 由框架在执行工具时注入。
我们还调用了两次 runtime.stream_writer,分别发送查询开始和完成的进度。runtime.stream_writer 是 LangChain 提供的一个自定义流式输出接口,主要用于在 Agent 执行工具的过程中,实时向外部发送一些消息,包括进度消息、状态信息、中间结果等
创建 Agent 时声明上下文
有了上下文和工具,就可以创建 Agent 了:
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
model = init_chat_model(“deepseek-flash”, model_provider=”deepseek”)
agent = create_agent(
model=model,
tools=[get_my_order],
context_schema=UserContext,
system_prompt=”你是售后助手。用户查询自己的订单时使用工具,依据工具结果回答,不要编造信息。”,
)
这里通过 context_schema=UserContext 声明运行时上下文的类型。接下来调用 Agent 时,除了用户消息,还要传入本次运行的 context:
result = agent.invoke(
{“messages”: [{“role”: “user”, “content”: “帮我查一下我的订单和签收时间。”}]},
context=UserContext(user_id=”USER-001″),
)
print(result[“messages”][-1].content)
整个过程可以这样理解:
应用传入用户身份 → 模型决定调用查询工具 → 框架把上下文注入工具 → 工具查询订单 → 模型根据结果回答。
模型负责决定是否使用工具,用户身份由应用提供。在真实应用中,这个身份应该来自服务端已验证的登录信息,工具或后端接口还需要根据用户信息检查访问权限。
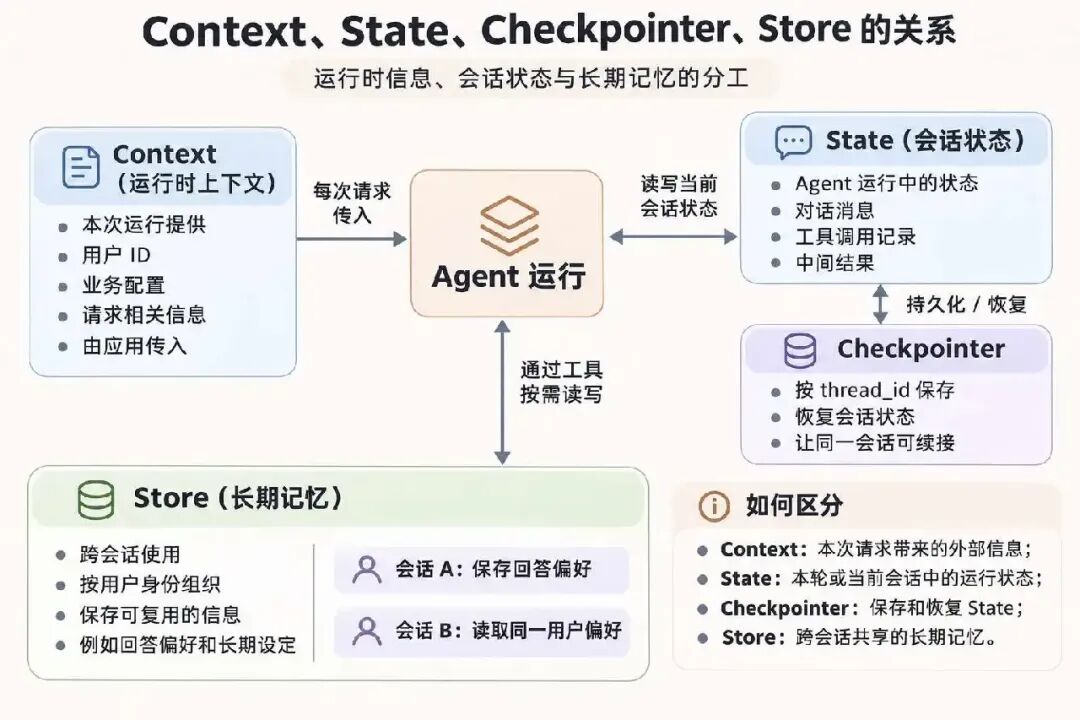
这里的 UserContext 是本次运行提供的信息。上一篇讲的 State 则用于保存 Agent 运行中产生的数据,比如消息历史。它们可以一起使用,State 记录对话过程,Context 提供当前请求需要的用户身份或其他业务数据。
长期记忆:跨会话记住用户偏好
前面我们通过 Context 把用户身份交给工具。知道用户是谁之后,我们还可以做一件事,保存这个用户希望 Agent 记住的信息,在下一次会话中重新读取。
比如,用户在售后对话中说:“以后回答售后问题时,先给结论,再说明原因。”随后,他打开一个新会话,问“我之前让你记住的回答偏好是什么?”,我们希望助手能读出刚才保存的内容。
上一讲介绍过 checkpointer 和 thread_id。如果使用同一个 thread_id,Agent 可以接着读取之前保存的会话历史。但这次用户开启了一段新会话,那么之前thread_id 保存的内容,我们就不能直接获取到,而且我们也不希望把上一段对话的全部消息都带过来,只需要记住用户这条回答偏好就行了。
这时候可以使用长期记忆。
短期记忆和长期记忆
我们先看下怎么来区分它们:
比如,用户刚刚提到的订单号可以留在当前会话的 State 里,方便后续使用,用户明确要求长期保留的回答习惯,则可以按用户保存,换一个会话后可以继续读取使用。
这里的“长期”说的是跨会话使用,数据能否在程序重启后保留,还取决于我们使用的存储方式。下面先用内存中的 Store 演示整个过程。
使用 Store 保存记忆
LangChain Agent 可以使用 LangGraph 的 Store 保存和读取长期记忆。Store 用 namespace 和 key 组织数据,保存的内容是一个字典。
我们先来看看 Store 读写方式
from langgraph.store.memory import InMemoryStore
store = InMemoryStore()
namespace = (“users”, “USER-001”)
store.put(
namespace,
“reply_preference”,
{“preference”: “先给结论,再说明原因”},
)
item = store.get(namespace, “reply_preference”)
print(item.value if item else “没有找到”)
这里用元组 (“users”, “USER-001”) 作为命名空间,把这个用户的记忆放在一起。`reply_preference` 用来标识其中的回答偏好,后面的字典则是要保存的内容。
读取时,把相同的命名空间和键传给 store.get。如果找到了记录,就可以通过 item.value 取出保存的字典,如果没有找到,`store.get` 会返回 None。
命名空间和键可以根据业务需要来设计。在这个例子中,只要使用同一个 Store,并根据相同的用户 ID 构造命名空间,就能通过 reply_preference 这个键读到之前保存的偏好。
让 Agent 保存和读取偏好
上面的代码由程序直接读写 Store。接下来,我们把读写操作封装成两个工具,让 Agent 在需要时调用。
下面继续使用前面定义的 UserContext。工具通过 runtime.context.user_id 获取当前用户,再通过 runtime.store 访问传给 Agent 的 Store
import json
from langchain.tools import ToolRuntime, tool
@tool
def save_reply_preference(preference: str, runtime: ToolRuntime[UserContext]) -> str:
“””根据用户明确提出的要求,保存用户偏好的回答方式。”””
store = runtime.store
if store isNone:
raise RuntimeError(“没有配置长期记忆 Store”)
namespace = (“users”, runtime.context.user_id)
store.put(namespace, “reply_preference”, {“preference”: preference})
return”回答偏好已保存。”
@tool
def get_reply_preference(runtime: ToolRuntime[UserContext]) -> str:
“””读取当前用户之前保存的回答方式偏好。”””
store = runtime.store
if store isNone:
raise RuntimeError(“没有配置长期记忆 Store”)
namespace = (“users”, runtime.context.user_id)
item = store.get(namespace, “reply_preference”)
if item isNone:
return”没有保存过回答偏好。”
return json.dumps(item.value, ensure_ascii=False)
保存工具接收模型提取的 preference,读取工具找到记录后,把偏好作为工具结果返回,模型收到结果后,才能在本次回答中参考它。
接着创建 Agent
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.store.memory import InMemoryStore
store = InMemoryStore()
checkpointer = InMemorySaver()
model = init_chat_model(“deepseek-flash”, model_provider=”deepseek”)
agent = create_agent(
model=model,
tools=[save_reply_preference, get_reply_preference],
context_schema=UserContext,
store=store,
checkpointer=checkpointer,
system_prompt=(
“你是售后助手。用户明确要求记住回答方式时,使用保存偏好工具。”
“用户询问已保存的回答偏好时,使用读取偏好工具并告诉用户结果。”
“不确定的售后政策不要编造。”
),
)
这里同时配置了 store 和 checkpointer。store 用来保存用户偏好,checkpointer 按 thread_id 保存各段会话的状态。它们各自负责不同的数据,可以一起使用。
用两个会话验证
现在让同一位用户发起两段会话。第一段要求保存偏好:
context = UserContext(user_id=”USER-001″)
first = agent.invoke(
{“messages”: [{
“role”: “user”,
“content”: “请记住:以后回答售后问题时,先给结论,再说明原因。”,
}]},
config={“configurable”: {“thread_id”: “conversation-1”}},
context=context,
)
print(first[“messages”][-1].content)
print(store.get((“users”, “USER-001”), “reply_preference”))
如果模型调用了 save_reply_preference,我们就能从 Store 中看到保存的内容。接下来换一个 thread_id,开启第二段会话:
second = agent.invoke(
{“messages”: [{
“role”: “user”,
“content”: “我之前让你记住的回答偏好是什么?”,
}]},
config={“configurable”: {“thread_id”: “conversation-2”}},
context=context,
)
print(second[“messages”][-1].content)
for message in second[“messages”]:
if message.type == “tool”:
print(“工具返回:”, message.content)
第二次使用了新的会话编号,因此不会通过 checkpointer 读取第一段会话的消息,它仍然会使用同一个 Store 和用户 ID。模型如果调用 get_reply_preference,工具就会找到之前保存的偏好,并把它交给模型。
记忆从哪里来,又保存在哪里
需要注意,Store 本身只负责保存和读取数据。它不会自动判断对话里什么内容值得记住,也不会自动把所有记忆交给模型。
在这个例子里,我们定义了保存和读取工具,并通过提示词告诉 Agent 什么时候使用。程序也可以在业务流程中直接调用 store.put,或者在请求模型之前由应用读取,再决定把哪些信息加入上下文。采用哪种方式,要看应用希望由谁控制记忆。
另外,示例中的 InMemoryStore 和 InMemorySaver 都保存在当前进程中。只要使用同一个 Store 实例,不同会话就能共享这条偏好。但程序退出后,内存中的数据会消失。如果需要重启后内容还在,就需要配置持久化的 Store。会话状态如果也要在重启后恢复,还需要配置持久化的 checkpointer。
流式输出:把 Agent 的执行过程交给应用
上面的例子使用 invoke。程序会等待 Agent 完成模型调用、工具执行和最终回答,然后一次性拿到结果。
但用户在页面上提问时,可能需要等好几秒。尤其是 Agent 要调用多个工具时,用户看不到它在做什么,很容易以为程序没有响应。
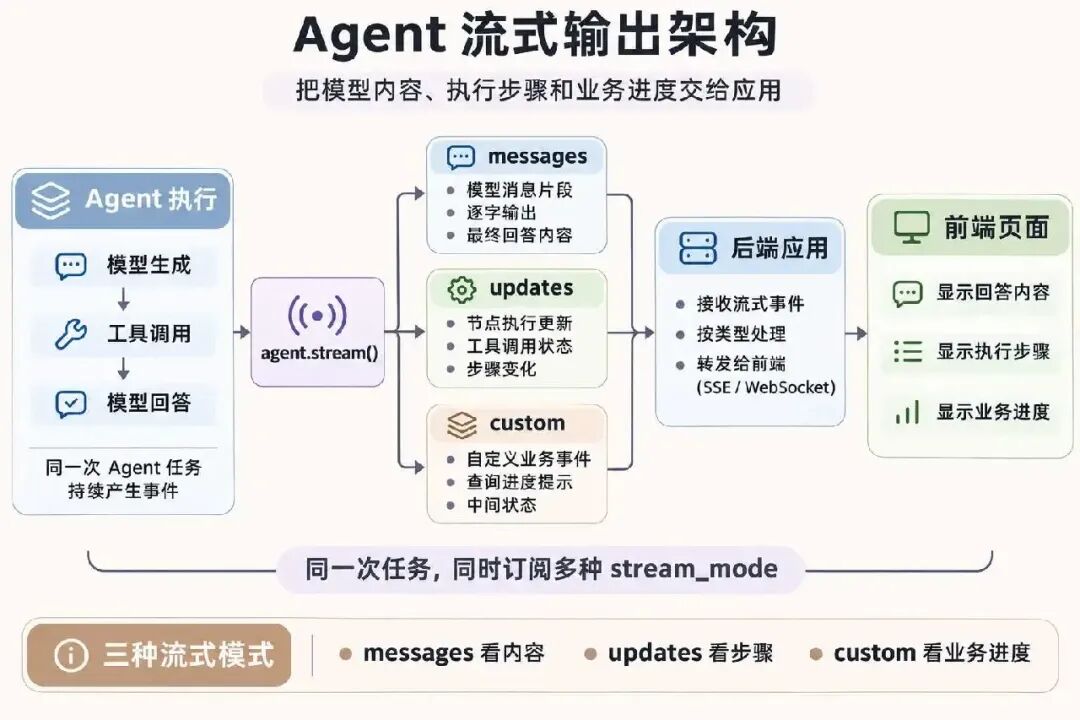
流式输出可以让应用在执行过程中陆续收到消息和进度。LangChain 的 stream 支持三种输出模式
逐步接收模型输出
先来看 messages。这里回到本篇开头查询订单的例子,使用带有 get_my_order 工具的 Agent。为了和前面的长期记忆示例区分开,先重新创建它,再把 invoke 改成 stream:
from langchain.messages import AIMessageChunk
agent = create_agent(
model=model,
tools=[get_my_order],
context_schema=UserContext,
system_prompt=”你是售后助手。用户查询自己的订单时使用工具,依据工具结果回答,不要编造信息。”,
)
inputs = {“messages”: [{“role”: “user”, “content”: “帮我查一下我的订单和签收时间。”}]}
context = UserContext(user_id=”USER-001″)
for event in agent.stream(
inputs,
context=context,
stream_mode=[“messages”],
version=”v2″,
):
message, metadata = event[“data”]
if isinstance(message, AIMessageChunk) and message.text:
print(message.text, end=””, flush=True)
print()
这里使用 version=“v2”,每个事件都是带 type 和 data 等字段的字典。messages 事件的 data 中包含消息片段和元数据,我们取出其中的文本,收到一段就打印一段。
这些片段来自 Agent 执行过程中产生的模型消息,不一定全是最终答复。模型生成工具调用时,也可能产生工具调用片段。
查看 Agent 执行步骤
如果我们还想知道模型请求了什么工具、工具什么时候返回,可以接收 updates:
for event in agent.stream(
inputs,
context=context,
stream_mode=[“updates”],
version=”v2″,
):
for node, update in event[“data”].items():
for message in update.get(“messages”, []):
if getattr(message, “tool_calls”, None):
names = [call[“name”] for call in message.tool_calls]
print(f”[{node}] 请求工具:{names}”)
elif message.type == “tool”:
print(f”[{node}] 工具 {message.name} 已返回”)
模型节点完成一次调用后,如果消息里有 tool_calls,我们就能看到它请求了哪些工具,工具节点返回后,也能收到对应的工具消息。
发送自定义进度
前面的 get_my_order 已经调用了 runtime.stream_writer。现在把 custom 加到流式模式中:
for event in agent.stream(
inputs,
context=context,
stream_mode=[“custom”],
version=”v2″,
):
print(“进度:”, event[“data”])
当模型选择调用工具时,应用可能依次收到“正在查询当前用户的订单”和“订单查询完成”。
上面我们了解了流失输出的三种模式,每执行一次 agent.stream(…),都会重新发起一次 Agent 任务。实际应用中,如果希望同一次任务同时返回文本、步骤和进度,可以一起订阅:
for event in agent.stream(
inputs,
context=context,
stream_mode=[“messages”, “updates”, “custom”],
version=”v2″,
):
if event[“type”] == “messages”:
message, metadata = event[“data”]
# 按应用需要处理模型消息片段
elif event[“type”] == “updates”:
update = event[“data”]
# 处理 Agent 执行步骤
elif event[“type”] == “custom”:
progress = event[“data”]
# 展示工具发送的业务进度
使用 LangSmith 查看 Agent 的执行过程
有了流式输出,用户可以在任务运行时看到进度。开发时,我们还经常需要回过头检查一次运行:模型收到了什么,选择了哪个工具,工具返回了什么,最后又是怎么回答的。
前一篇我们使用中间件记录过工具执行日志。除此之外,LangChain 还可以把 Agent 的执行过程发送到 LangSmith,以 Trace 的形式查看。
一次 Agent 运行会产生一条 Trace,其中可以包含多次模型调用、工具调用及它们之间的层级关系。对于售后助手,我们就可以沿着这条记录,查看用户的问题、工具调用参数、工具返回和最终回答。
配置追踪
先到 LangSmith 官网创建账号和 API Key。然后在运行示例的终端中设置:
export LANGSMITH_TRACING=true
export LANGSMITH_API_KEY=”你的 LangSmith API Key”
export LANGSMITH_PROJECT=”langchain-after-sales-demo”
上面的 LANGSMITH_PROJECT 适用于项目制工作区,用来指定记录发送到哪个项目。如果使用 Agent 制工作区,需要先在 LangSmith 中创建 Agent,再通过 LANGSMITH_AGENT_ID 和 LANGSMITH_AGENT_ENVIRONMENT 指定目标。
设置好后,重新运行上面的例子
运行结束后,到 LangSmith 中打开对应项目,就可以查看这次执行的 Trace。可以先找到整次 Agent 运行,再依次展开模型和工具调用,看看模型有没有调用 get_my_order,工具返回了什么,以及最终答复是否使用了查询结果。
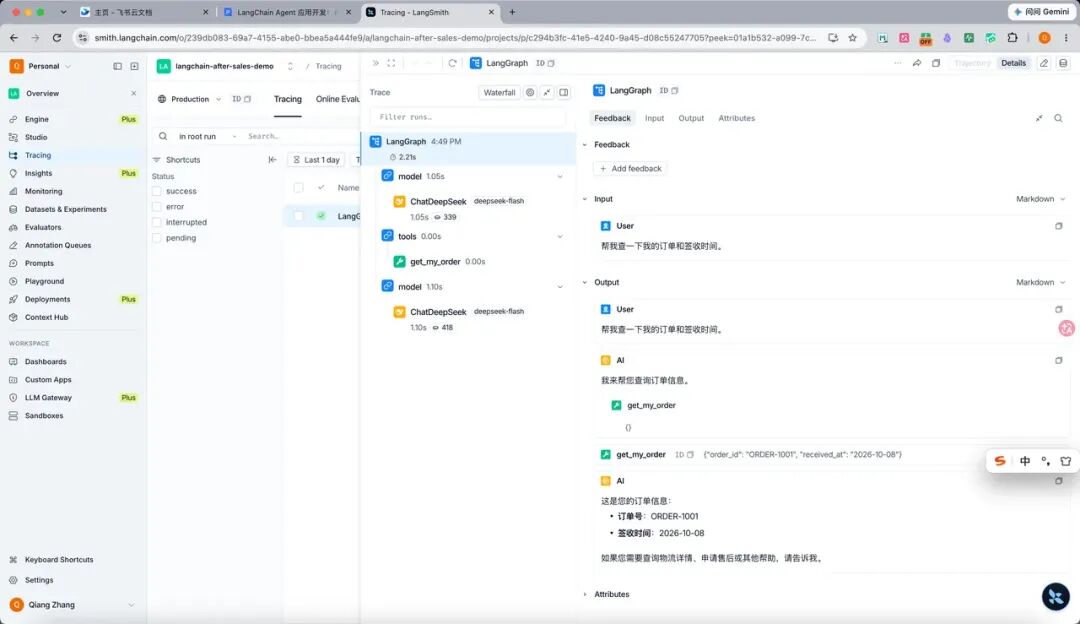
如果没有看到工具调用,也可以先看模型的响应:模型可能没有选择使用工具,或者调用在到达工具之前就失败了。
为什么没有在代码里引入 LangSmith
看到这里,可能会有一个疑问:我们没有在售后助手代码中写 import langsmith,也没有在模型调用前后手动添加记录,LangSmith 是怎么拿到执行过程的?
因为我们使用的是 LangChain 的 create_agent、模型和工具。LangChain 的执行过程已经接入了追踪机制,启用追踪后,框架会在这些组件运行时收集信息,并通过 LangSmith SDK 发送出去。
这个项目安装 LangChain 时,langsmith 作为依赖一起安装了。所以,基本追踪不需要我们在每个模型和工具调用位置再写一遍埋点代码,但底层仍然会使用 LangSmith SDK。
可以把过程理解成:
执行 Agent → LangChain 记录模型和工具等步骤 → LangSmith SDK 发送记录 → 在 LangSmith 中查看 Trace。
自动追踪覆盖的是已经接入追踪机制的执行过程。如果工具内部又调用了普通 Python 函数,工具这一层可以被记录,但这个普通函数不一定会单独显示为一个步骤。想进一步查看它,可以手动添加追踪。
为普通函数添加追踪
比如,查询订单工具内部有一个 query_order_database 函数。我们希望在 Trace 里单独看到这次查询,就可以使用 LangSmith SDK 的 @traceable:
import json
from langchain.tools import tool
from langsmith import traceable
@traceable(name=”查询模拟订单数据”)
def query_order_database(order_id: str) -> dict:
“””模拟数据库查询。”””
if order_id != “ORDER-1001”:
return {“error”: “未找到订单”}
return {“order_id”: order_id, “received_at”: “2026-10-08”}
@tool
def get_order_info(order_id: str) -> str:
“””根据订单号查询模拟订单。”””
return json.dumps(query_order_database(order_id), ensure_ascii=False)
这里的 get_order_info 是 LangChain 工具,query_order_database 则是工具调用的普通函数。给后者加上 @traceable 后,开启追踪并实际执行这段代码时,LangSmith 会为它记录一个单独的运行步骤,方便我们在工具调用内部继续查看。
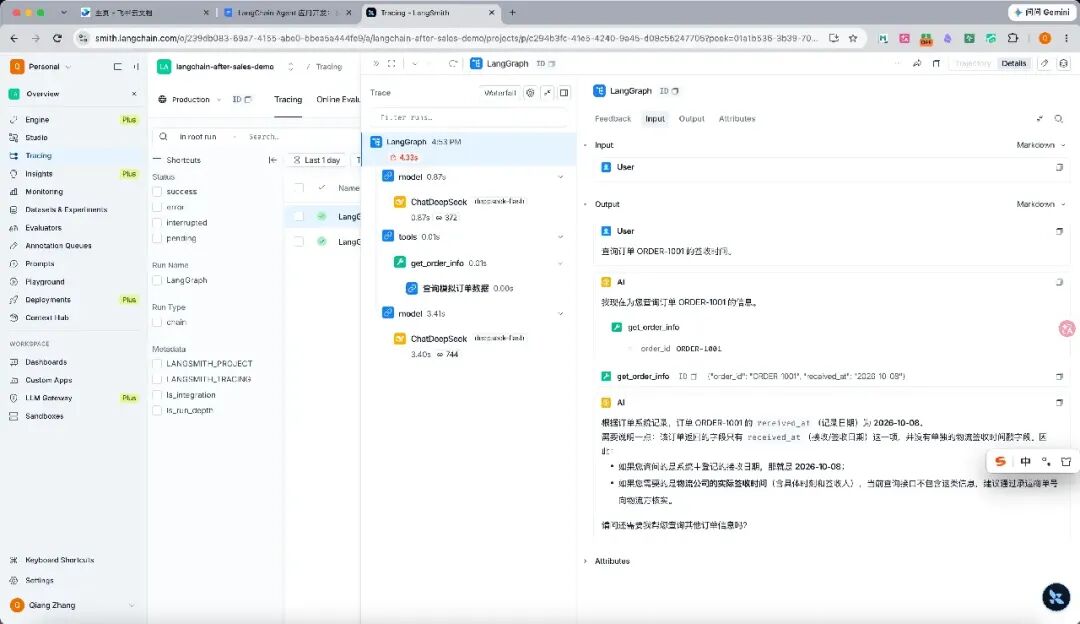
如果模型调用了 get_order_info,可以在对应 Trace 中展开工具步骤,查找名称为“查询模拟订单数据”的子步骤。
@traceable 并不是每个工具都必须加。已经由 LangChain 记录的模型和工具调用,先看自动生成的 Trace 就可以,需要单独观察普通函数或更细的业务步骤时,再为那部分代码添加追踪。
写在最后
到这里,我们的售后助手又向应用走近了一步,应用通过运行时上下文提供用户身份,工具可以查询订单,也可以跨会话保存和读取用户偏好,Agent 执行时,页面可以接收模型内容、执行步骤和工具进度,出现问题后,还可以通过 Trace 查看整个过程。
这三篇文章从模型和工具开始,一路搭建到能够管理状态、控制执行并观察运行过程的 Agent。后面如果要接入知识库、构建更复杂的流程,还可以继续学习 RAG、LangGraph 和 LangChain 的其他能力。
本文由人人都是产品经理作者【叶小钗】,微信公众号:【叶小钗】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。


- 目前还没评论,等你发挥!