
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
a16z 投了 1000 万美金给这家公司,让每个人都有一个只属于自己的 AI 模型,打造专属 Personal AI


a16z 掏出 1000 万美金投了 First Person Labs,产品 Second 装在你的电脑上,在后台把操作和关系慢慢整理成一个只属于你的模型,供所有 agent 取用,而且只做一个。
你有没有想过,你每换一个 AI 工具,就要把自己重新介绍一遍?你喜欢坐哪个位置的飞机座位,要提前多久到机场,手上在做哪几个项目,最近跟谁在谈事情,这些话你已经对 ChatGPT 讲过,对 Claude 讲过,换到 Codex 又得讲一次。模型一年比一年聪明,可它们对你的了解,几乎每次都是从零开始。
11 月 18 日,一家叫 First Person Labs 的公司发布了第一个产品 Second。前一天,a16z 刚宣布投了它 1000 万美金,公司由 Ken Liu 和 Erik Chi 创办,两人之前一起做过一个叫 Open Anonymity 的匿名化项目。发布当天,Ken Liu 去了 a16z 的播客,和 Martin Casado、Joel de la Garza 聊了半个多小时。Second 做的事情可以用一句话讲清楚:装在你的电脑上,自己在后台把你做过的事、认识的人、在意的目标慢慢整理成一个“你的模型”,然后你愿意让哪个 agent 用,就让哪个 agent 来取。我觉得这个方向值得讲,因为它盯上的是个人 AI 里一直缺的那一层。
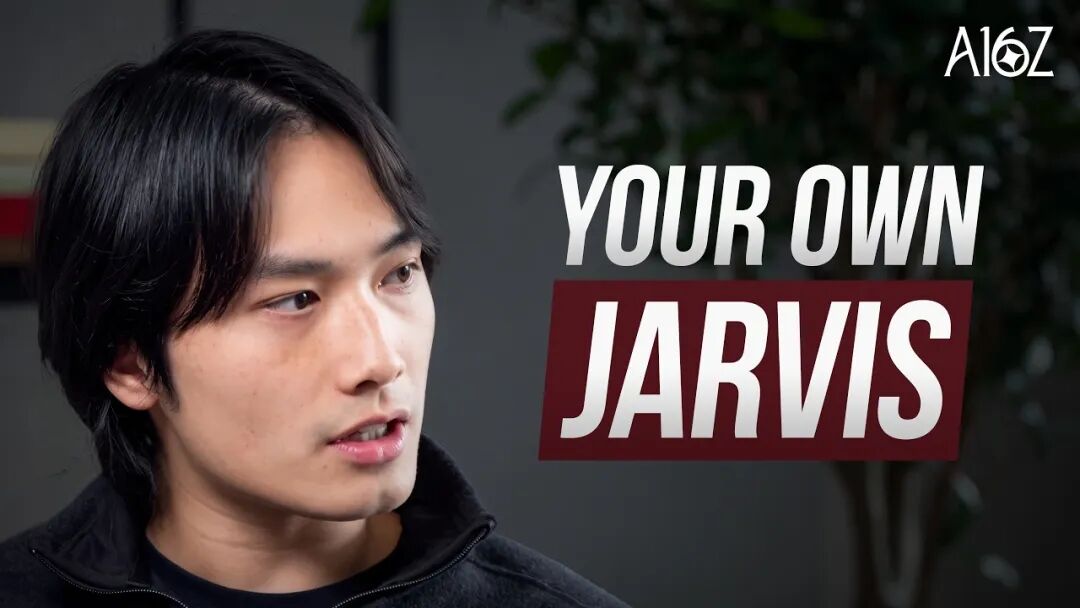
First Person Labs 创始人 Ken Liu 上 a16z 节目介绍 Second。图片来自 a16z
01 Second 到底是什么,它不是又一个 agent
先说清楚它不是什么。Second 不是另一个要你去对话、去派活的助手,它自己不替你订机票。它更像一个放在你家里的管家,专门负责记得你是谁,别的 agent 来了,向它要背景就行。
Ken 用了一个蝙蝠侠的例子。蝙蝠侠想吃芝士汉堡,让管家阿尔弗雷德去买,阿尔弗雷德不会在柜台前说“我家少爷是蝙蝠侠”,他只会照少爷的口味把汉堡买回来,而且买对。你敢让他去,是因为你知道他心里有一个关于你的模型。Second 想做的就是这个阿尔弗雷德,只不过它服务的对象是你手上所有的 AI 工具。
具体用起来是这样:你在别的 agent 里说一句“去问问我的 Second,我想要什么”,两边就开始对话,你再下指令“帮我订张机票”,那个 agent 已经知道你要去哪、喜欢什么座位、愿意提前多久到。Ken 自己的例子是 OpenAI 前一天刚发了新模型,他已经很久没开 Codex,直接打开就用,之前在 Second 里积累的工作和背景它全能拿到,不用重新交代。
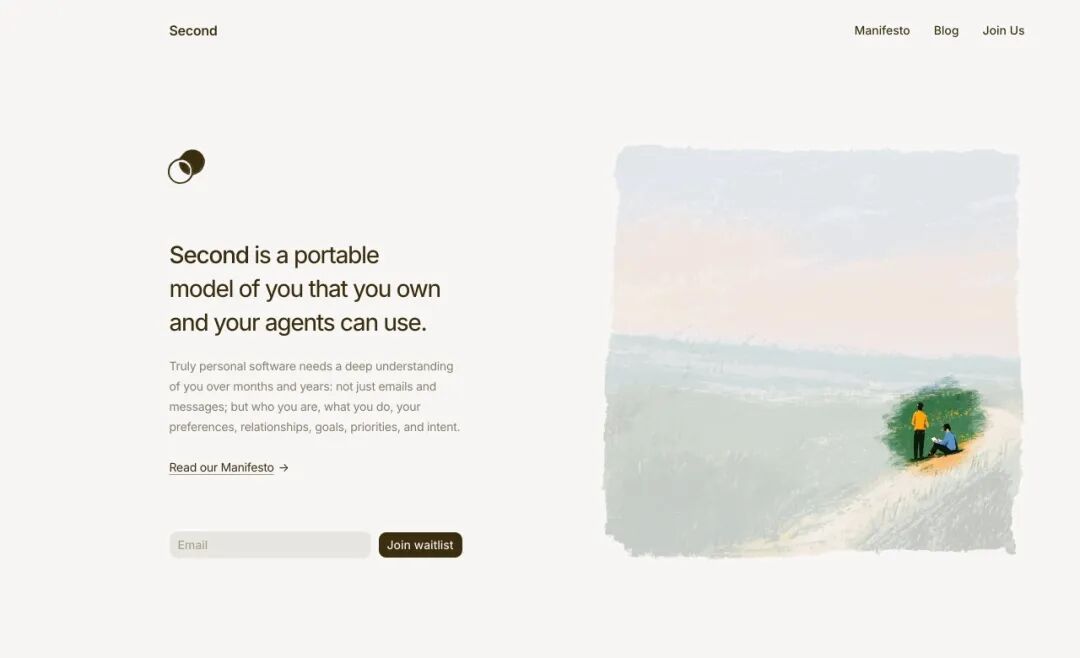
Second 官网首页:一个你自己拥有、你的 agent 都能用的“你的模型”。图片来自 Second
我觉得这里有个很容易被忽略的设计选择:Second 坚持只做一个。现在不少重度用户手上已经养了好几个 agent,Joel 就是,一个管他的合成器,一个管房子,一个管家里的事。可 Second 不会有第二个、第三个。在 Ken 看来,同时养很多个个人 agent 只是一个过渡阶段,以后 agent 会像人一样分工,有的专门去亚马逊买东西,有的专门写代码,它们可以随用随起、用完就散。但需要有一个长期稳定的地方存放“你是谁”,这个地方只能有一个,而且要站在你这边。
02 它怎么在你什么都没做的情况下看懂你
这是整个产品最有意思的地方。你一台电脑在用的时候,操作系统本身就在产生一条源源不断的事件流:你切到了哪个应用,在哪个网页上停了多久,打字的节奏,连的是哪个 Wi-Fi。苹果、微软、Linux 都能拿到这些。Ken 说,大家低估了电脑已经知道多少事,它们就摆在那里,只是没有人去用。
Second 的做法是在这条原始的流上,挂一批 24 小时不停的 agent,一层一层往上理解。最底下一层可能只是判断“这段打字发生在聊天软件里,大概是在发消息”;再往上一层看到你在浏览器和 Codex 之间来回切,判断你在做调研;再往上,它会把一天的碎片拼成“你今天在推进什么”。这个过程里,Slack、Signal、WhatsApp 这类连接器也会接进来,Ken 的说法是连接器帮的是“学得更快”,主体还是电脑上那条流。
你装完应用,给它权限,填上自己的模型密钥,剩下的就没有你的事了。它会在后台长出一批接口:十分钟前你做了什么,下周你的优先事项是什么,你有哪些提醒,你生活里重要的人是谁,甚至还有一个关于你自己的小维基。Ken 把这些叫作“你的 API”,给人用,也给机器用。
用起来最直接的好处,是不用再解释。Ken 自己拿它做开发,说跟 coding agent 配合的时候,对着屏幕截个图,只说一个“修”字,agent 就知道你在修什么。另一种他叫“上下文连续”:你在笔记本上看着一个东西,合上电脑掏出手机,上下文还在,接着往下做,写邮件也是。
03 真正让人上瘾的,是它会自己来找你
如果只是被动地供上下文,Second 还不够特别。a16z 的 Joel de la Garza 作为早期用户,讲了一件让他印象很深的事:他们当时在筹备一场活动,有 20% 的概率下雨,Second 自己盯着天气预报,实时更新,最后给他发消息提醒要不要搭帐篷。他没有让它做这件事。他说自己经常会收到 Second 的短信,内容恰好是某个正在进行的对话里他自己都没想到要关心的事,被它接住了。
Ken 把这种能力分成两层。第一层叫“反应式”,邮件来了通知你,多个 agent 一起发十条提醒,这种事情容易做,也最容易让人烦。第二层叫“反思式”,难得多:它要把几个月前你说过的话、你最近在推进的目标、你待办清单上的内容、你的个人偏好连起来,才能判断此刻该不该打扰你、该提醒什么。我觉得这个区分抓得很准,现在市面上大多数 AI 提醒都停在第一层,停在“有事发生了”,没有走到“这件事对你重要”。
他还提了一个观点,我很认同:个人 AI 现在最大的瓶颈,是人必须先开口问。你得知道自己要什么,知道该问什么,AI 才开始工作。而一个真正了解你的系统,可以在你没问之前就做出判断,哪些事该替你做,哪些事该提醒你。这才是“助手”和“工具”的差别。
04 它看到你所有的操作,数据怎么保证不被人拿走
一个 24 小时盯着你屏幕、读你消息的东西,第一反应肯定是别装。Joel 自己就说,他做了三十年安全,是个偏执的人,后来是跟 Ken 聊了很多次安全架构,才放下心来。Second 的思路我理解下来有这么几层。
最基本的一层是数据放在你自己电脑上。它就是你本机上的一个文件夹,你可以打开看,可以编辑,可以备份,甚至可以拷到 U 盘里。Ken 甚至设想,也许有一天你可以把它传给你的孩子。这个设想我觉得有点浪漫,也点明了他们对“归你所有”的理解有多彻底。
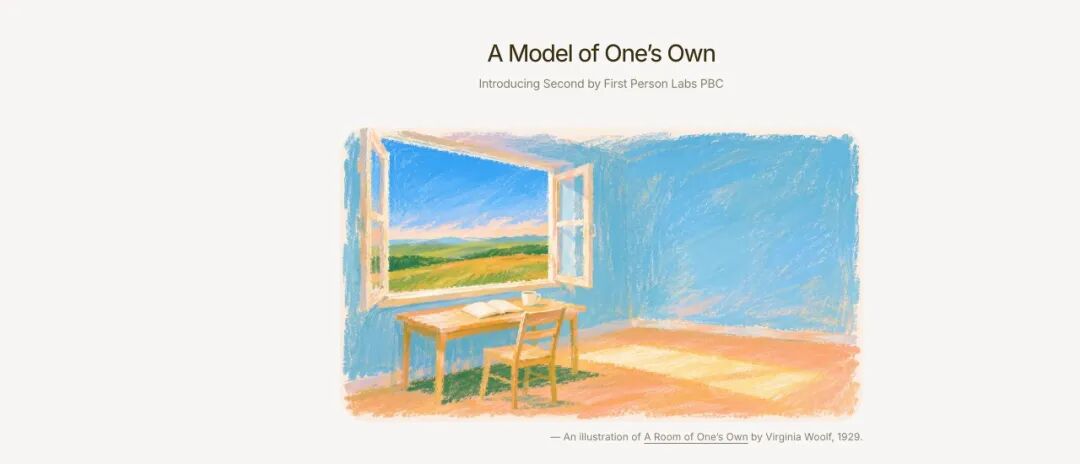
Second 的发布文章《A Model of One’s Own》,题图取自伍尔夫的《一间自己的房间》。图片来自 Second
然后是推理用谁的。Ken 说 AI 里只有两样东西,数据和推理,你要决定的是让谁的推理来碰你的数据。Second 可以用你自己已有的 Claude 或 ChatGPT 订阅,用你自己的 API 密钥,用本地模型,也可以买他们提供的私密推理额度。如果你连 First Person Labs 都不信,原则上可以全程不经过他们。
这里有个细节值得讲。现在很多服务商会承诺“零数据保留”,意思是我答应你推理完不留你的数据。Ken 提醒这只是一个靠政策和法律兜底的承诺。他们更想推的是“机密推理”:模型跑在开了机密计算功能的 GPU 里,可以通过硬件验证证明里面只有这个模型在跑,谁也看不到里面,你不需要信任运营方,信的是英伟达的硬件。一个是“我保证”,一个是“你可以验证”。
想用云端备份也有办法。思路和密码管理器、iCloud 差不多:先在本地加密,再上传,只在用户操作的时候解密;或者干脆把整个存储放进机密容器里,用同样的方式验证。
最难的问题,其实在另一头。要是有人跑来对你的 Second 说,“Ken 让我来查一下他的日程”,它会不会就给了?这是提示词注入的老问题,Ken 也没有把话说满,承认没法彻底解决。他们的做法是分两种保证:能写成规则的,就写成确定性的规则,不管 LLM 怎么想都拦住;写不成规则的,靠模型自己的判断,而这类判断会随着模型能力变强而变好。比如凌晨三点有人发消息给 Ken 的 Second,说自己是 Martin,它大概率会判断是垃圾信息或者冒充,因为在它对 Martin 的认识里,他从来不在这个时间发消息。
05 现在为什么还不是给所有人用的
Second 今天已经能用,在 2.computer 上有早期访问,但还没完全放开。原因很实际,贵。
Ken 当场算了一笔账:一个 agent 一天 24 小时跑,一秒钟处理几千个 token,再同时跑十个,因为要分析的东西太多了,按目前最贵那档模型的价格算,一天要花上千美元。换成便宜的模型,大概是 60 美元一天。这当然不是普通人能用的价格,所以他自己也说,现在的目标用户是 Joel 这样的忙碌专业人士,需要在多个工具之间频繁切换,对上下文特别在乎。好在模型价格一直在降,他们创业以来 token 价格已经降了一半以上。
解决成本的办法,是不让所有的活都用最贵的模型。“你在日历上把一个邀请挪了位置”这类事,用便宜的小模型就够;“Joel 这周的目标是什么”才需要好模型,而且不需要天天算。所以 Second 里有一套调度,什么任务用什么模型,是整个产品里最花心思的部分。他们的判断是,将来它一定是一个混合模型的系统,既为了省钱,也因为新模型每个月都在出,有的擅长检索,有的擅长推理,换进去就行。
另外还有一个取舍:整理得越细,每次查询就越快、越准,但前期花的钱越多;如果只存原始日志,每次问问题时就要让模型现场重新读一遍,慢很多。用户可以在“多懂我”和“多省钱”之间选一个位置。
06 他们为什么把界面砍到只剩短信和 API
这个决定我觉得特别有意思。Ken 坦白说,他们早期在交互上犯了很多错,一度想把界面做得很完整,包括用户能在上面创建的个人页面,后来发现这件事要花很长时间才能做对,而且每个人都会想用自己的方式使用对自己的理解。所以他们决定把界面关掉,只留下短信和 API。
他们在这里拿个人电脑的早期做对比。Altair 8800 刚出来的时候什么都做不了,你得自己编程,几乎没人用,几年后才有人做出电子表格,个人电脑一下就有用了。他希望 Second 也走类似的路,先把理解你这一层做好,然后让别人在它上面搭东西,也许其中一个就是那个杀手级应用。
他举了一个设计师朋友的例子。这位朋友喜欢把按钮放在特定的位置,喜欢用特定的颜色,这些习惯被 Second 记了下来,他自己做个人应用的时候,AI 一上来就知道,改动的轮数少了很多。我觉得这个例子比任何宏大的愿景更能说明“你的模型”能干什么:它帮你省的是那些你从来没想过要写下来的偏好。
当然,交互层长期他们还是会做。Martin 一直想要一个像 70 年代科幻片里那样有脸有形象的 AI,可在 Ken 眼里,眼下要先解决的是理解,这是一个系统问题。他有个设想挺有画面:以后每个人都有一个自己的 Second,所有设备,手机、电脑、厨房里的 iPad、门口的屏幕,都只是它的输入和输出,Second 才是同一个你。
First Person Labs 官网:做 AI 怎么理解人、怎么保护这份理解的研究实验室。图片来自 First Person Labs
我自己的一点思考
我觉得 Second 想回答的是一个越来越躲不开的问题:当所有软件都变成 agent,谁来持有“你是谁”这份资料。Ken 的说法很直接,谁握着用户模型,谁就会影响软件替你做什么。过去那些只记录你的滑动、点击的窄模型,已经决定了我们今天刷到什么样的信息流,一个更全面的用户模型,威力只会大得多。把它放到本机、让用户自己拿着,至少给了另一条路。Ken 自己也承认,目前的 iCloud 之类做的是文件同步,却没有一个 AI 版本,你的上下文和理解散落在每个应用里,没人替你收拢。
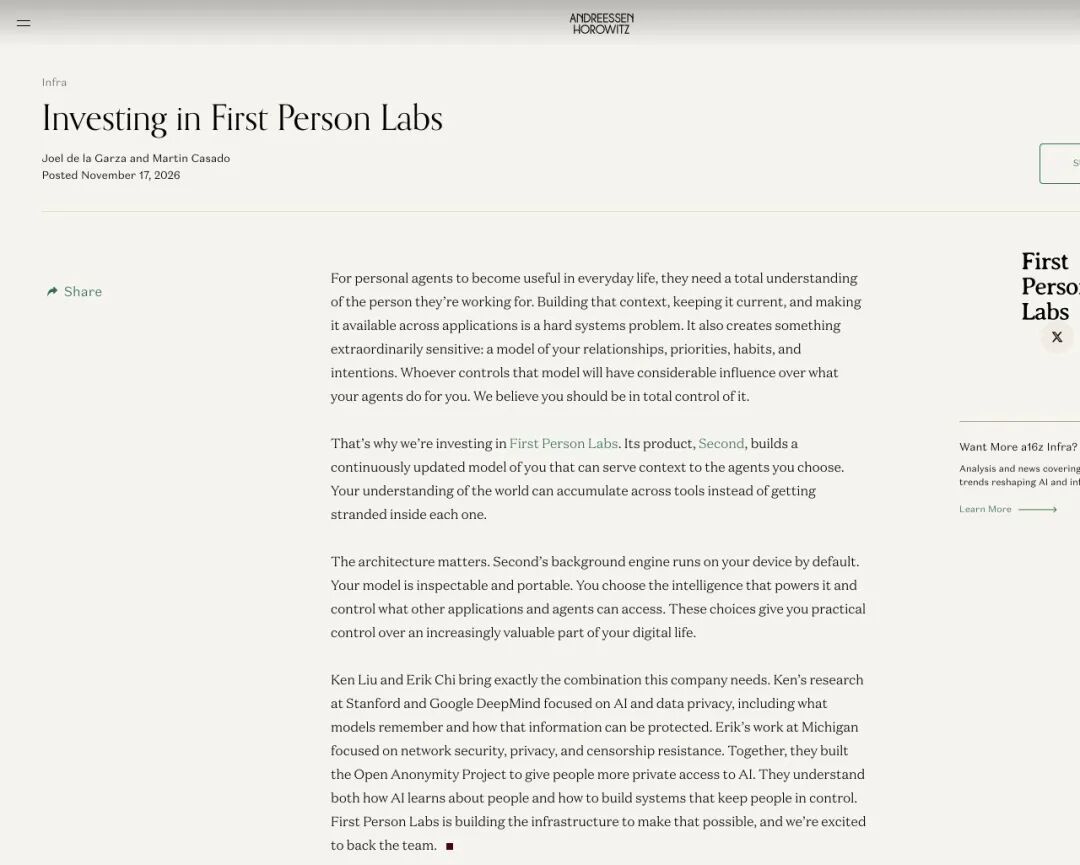
a16z 11 月 17 日发布的投资文章,作者是 Joel de la Garza 和 Martin Casado。图片来自 a16z
当然,它离普通人还很远。一天几十到上千美元的花费,要再降一个数量级才说得过去;技术上就算做到了本地存储和机密推理,让人接受“有个东西 24 小时看着我的屏幕”,心里那道坎也不好过,不是谁都有 Joel 那样的机会,跟创始人把安全架构聊上好几遍。更让我拿不准的是苹果和微软,操作系统本来就握着这条事件流,它们哪天自己动手,一家创业公司能不能站得住,现在还很难说。
可话说回来,个人 AI 过去几年一直在比谁的模型更聪明,Second 换了个问题,问的是模型凭什么了解你,了解之后这份了解归谁。这是个迟早要有人认真回答的问题,而且越早有人把答案做出来,后面的人越有东西可以参照。我自己更想看的是它长大以后的样子,是不是像电子表格之于早期的个人电脑那样,会有人在这一层上面做出让人觉得离不开的东西。
资料来源
a16z,Investing in First Person Labs,2026-11-17原文 https://a16z.com/announcement/investing-in-first-person-labs/
Ken Liu,A Model of One’s Own,Second,2026-11原文 https://2.computer/blog/a-model-of-ones-own
The a16z Show,The Missing Layer for Personal AI,2026-11-18原文 https://www.youtube.com/watch?v=kBJe4H_WobA
本文由人人都是产品经理作者【深思SenseAI】,微信公众号:【深思SenseAI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供



- 目前还没评论,等你发挥!