


 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
GPT Image 2.5 对比实测:变化与局限


GPT Image 2.5 在复杂中文图文任务中表现如何?本文通过十一类任务、72张输出,对比两代模型在海报、安装说明、经营简报等场景下的能力。结果显示,2.5 在商品信息对应和数字复现上有所提升,但在工具接触点、零件数量和图表比例上仍会出现错误,书法风格差异明显。
一张咖啡促销海报,需要同时放下五杯饮品、五组规格价格、活动时间、满减算式和使用规则。一页安装说明,需要让零件清单、四步插图和成品结构相互对应。这样的任务,更接近日常工作对图像模型的要求。
GPT Image 2.5 能把这些内容做到什么程度,相比上一代又改善了多少?这次围绕十一类任务比较了72张输出。海报和经营简报展示了两代模型处理复杂中文图文的能力;安装说明中的工具位置、螺钉数量,以及图表比例,则暴露出一些容易被整洁版面掩盖的问题。
一、从上一代的问题和实际任务入手
上一代的公开评测提供了几类具体问题。Contra Labs 记录过多轮编辑后颜色保留和指令遵循变差的情况;Oakgen 的样本中出现过倒影残留、手部接触错误和服饰细节改变;Everypixel 则指出密集人群中的小尺寸面孔容易出错。本轮据此重新编写提示词,加入连续编辑、密集人群、双手递杯、人物及倒影删除、密集中文、参考人物换动作六类任务。
中文行书和草书另外各设一题,再补充活动海报、安装说明、经营简报三个现实图文场景。后三题在生成前列出检查项,分别核对文字内容、数字、图文对应和结构关系。活动、产品和经营数据均为虚构测试素材。
GPT Image 2 与 GPT Image 2.5 各有36张有效输出,四张共同参考底图另计。连续编辑使用两张底图,每张修改三次;人物换动作各做三个动作;其他任务每代各重复三次。所有结果均保留,没有删掉失败图再补抽。正文通常展示第一次输出,需要说明重复结果时会标出次数。
两边的实际生成设置存在差异,以下结论只限本次样本,无法完全排除设置的影响。图片经过逐张视觉检查,图表高度另按原图坐标测量;未采用多评委盲评,也未比较生成速度。
二、促销海报:五组商品信息都能对应
咖啡海报的难点在于同页内容之间的对应。三张商品卡分别放经典美式、燕麦拿铁和抹茶拿铁,前两款有冷热两种,最后一款只提供冰饮,总计五杯。每杯都有自己的容量和价格,图片还要分别呈现深色咖啡、奶咖与绿色抹茶。
优惠区要求单笔满48元减8元,并完整给出冰燕麦拿铁24元加冰抹茶拿铁26元、减8元后支付42元的示例。底部另有三条规则、门店地址和营业时间。若价格串到相邻商品,或漏掉优惠限制,海报就需要返工。
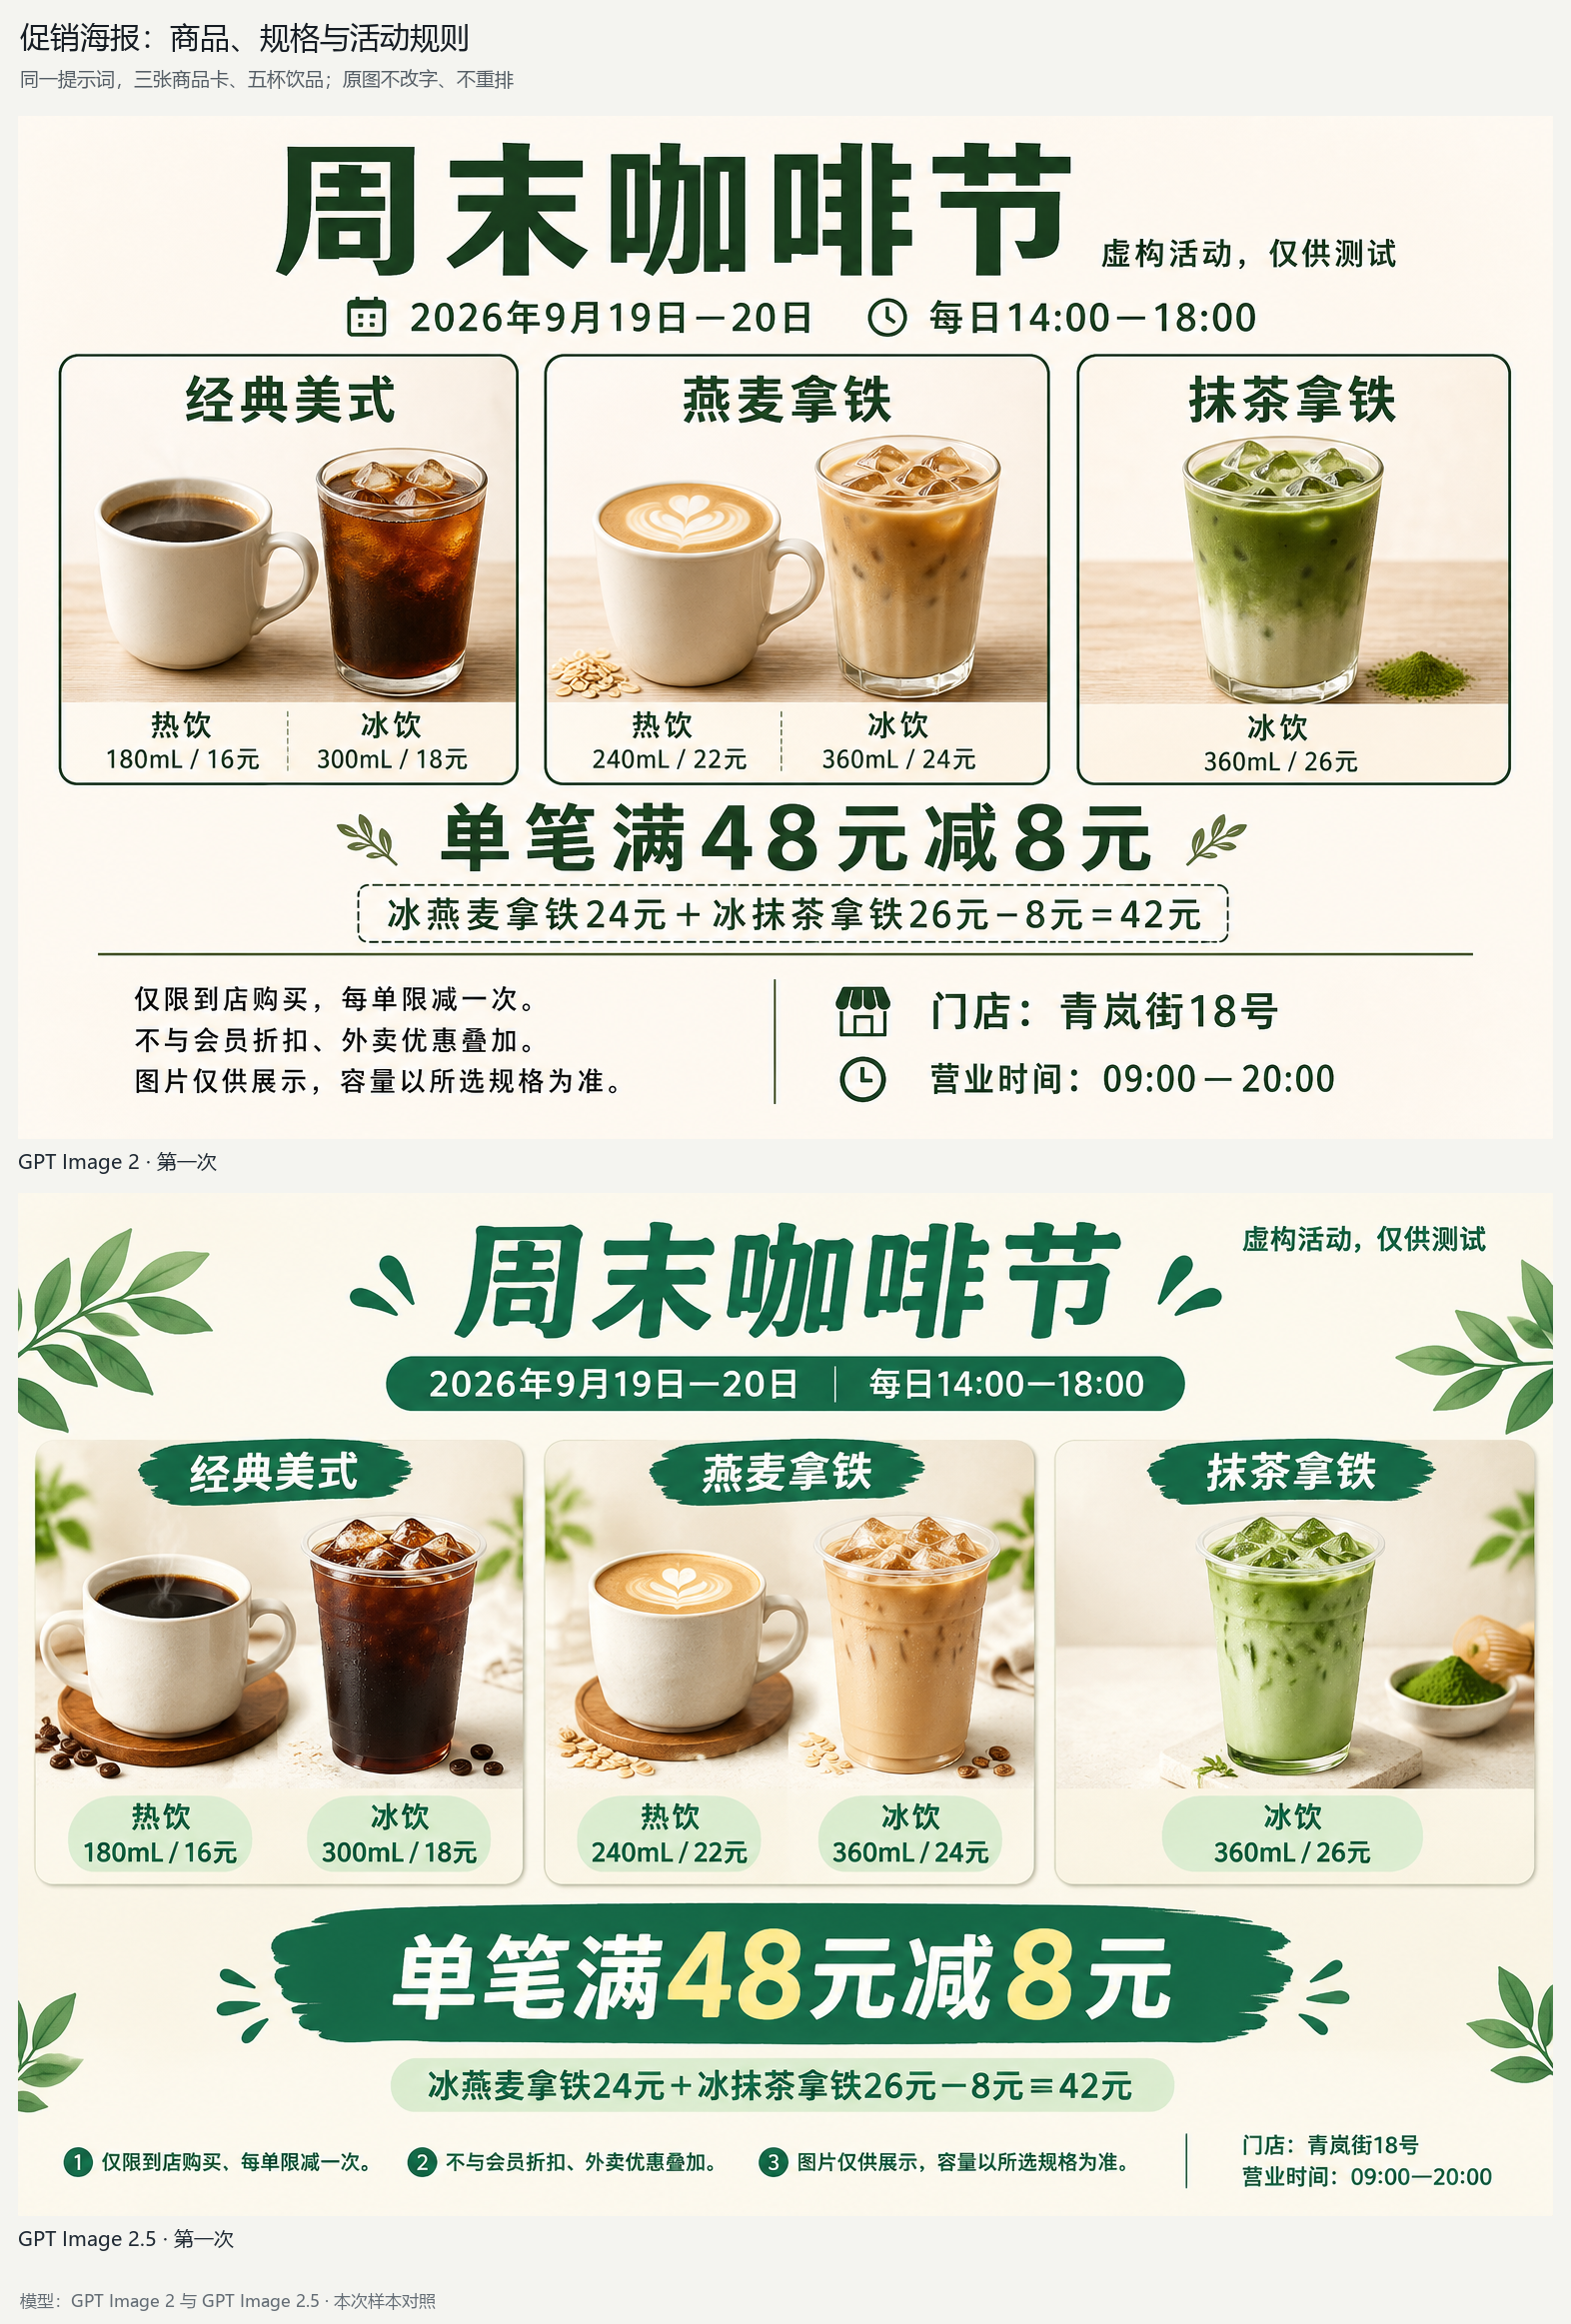
六张结果中,五组商品的冷热属性、容量和价格均对应正确,优惠门槛、示例算式、地址和时间也没有发现错漏。2.5 第一次将三条规则并排放在底部,偏离了提示词要求的三行排法,规则内容仍然完整。
这组结果展示了中文图文生成的实用性:按本次要求,两代模型都能在一张图里同时安排商品摄影、价格信息和活动细则。2.5 的几张样本采用了更圆润的商品卡和较多背景装饰,上一代部分结果更简洁。准确度上暂未拉开差距,设计取向可以根据门店风格选择。
三、安装说明:清单正确,成品图仍会多出零件
安装说明采用一个虚构的桌面双层收纳架。零件只有两块米白色板、四根青绿色支柱、四颗红色螺钉和一把黑色内六角扳手。页面要求从左到右完成放底板、装支柱、对齐顶板、固定螺钉四步,最后标出宽320mm、深180mm、高220mm。
六张结果的零件清单数量、步骤顺序和主要文字都较完整。逐项看成品图时,两代分别出现了不同错误。
GPT Image 2 第一次的四颗红色螺钉都在顶板角上,扳手却插在右侧板面空处,没有接触任何一颗红钉。2.5 第一次和第二次的扳手位置正确,第三次则在四角螺钉之外,又在扳手下方画出第五个红色钉位。上方清单和步骤文字依然写着四颗。
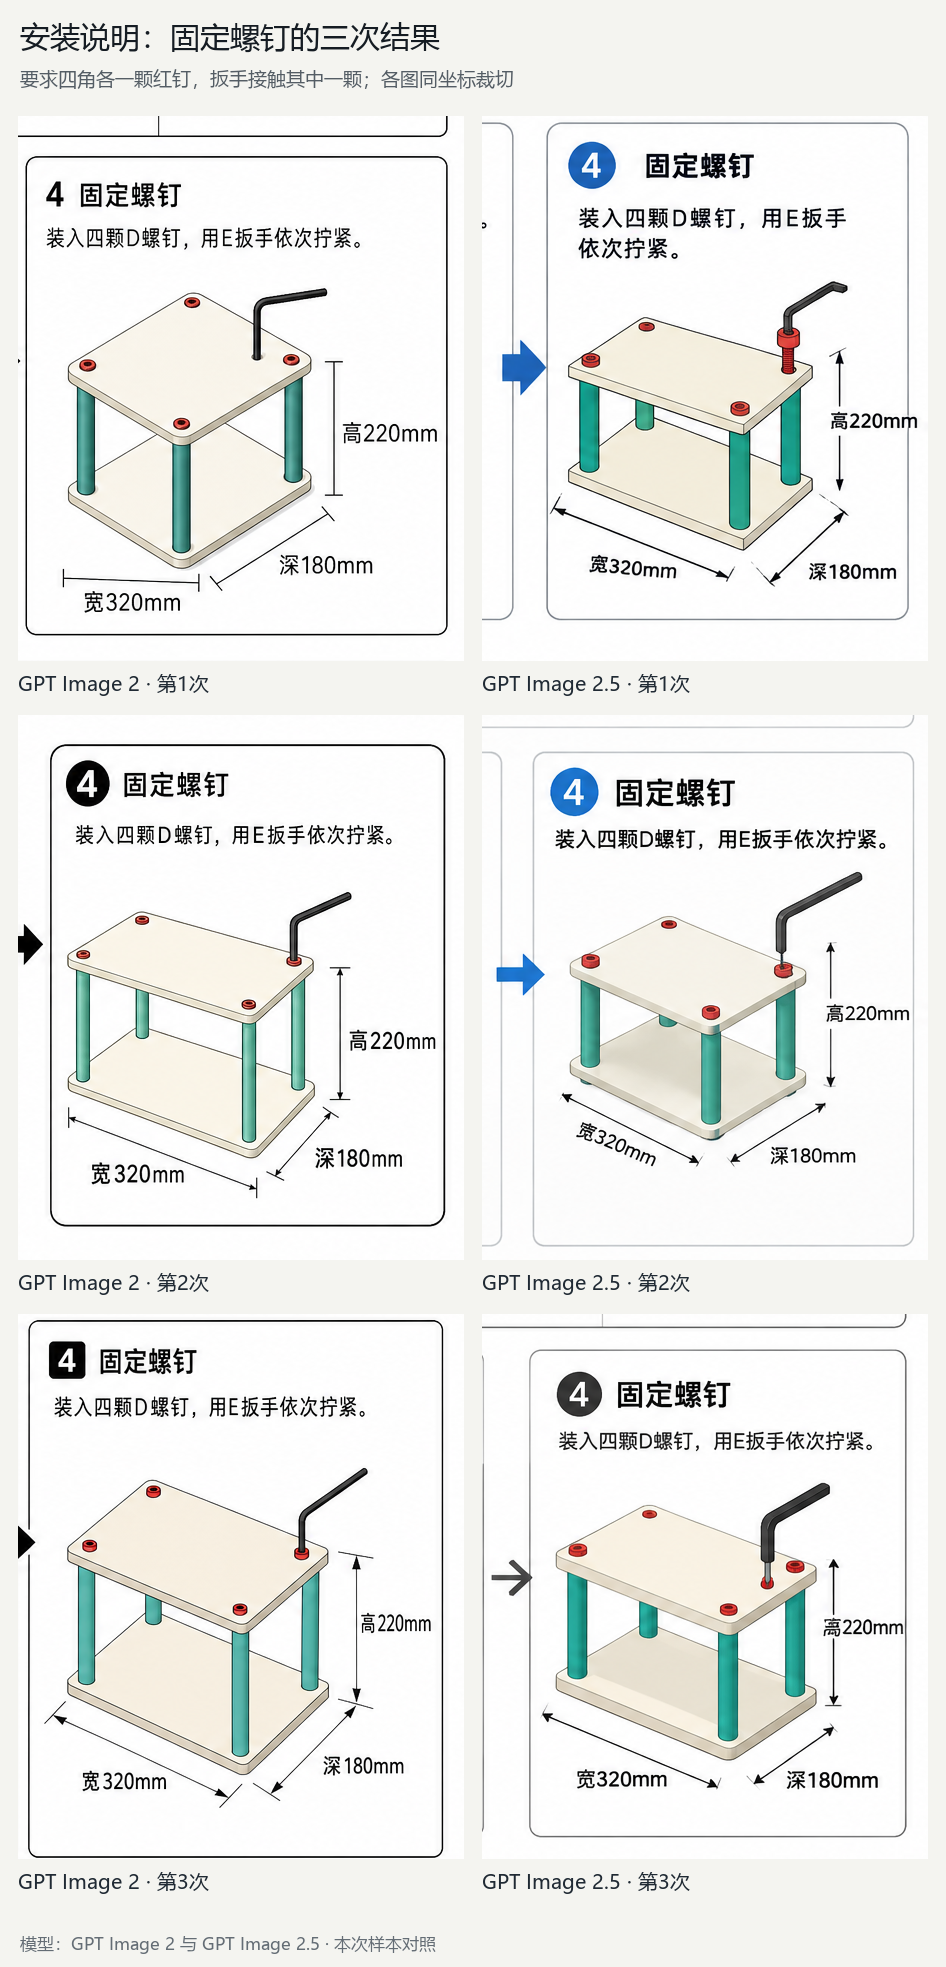
2.5 第二次还有一处对指令的改动:第三步把顶板画成悬空对齐的装配示意,没有满足四根柱连接上下板的要求。悬空示意本身有说明用途,可以作为版式选择讨论;多出来的螺钉和放错的扳手,则直接破坏了零件与操作的对应关系。
这也改变了此类图片的检查重点。标题、说明文字和零件数量都写对后,还要沿着步骤逐格核对:零件有没有增加,工具接触了哪里,前后结构是否一致。本次2.5也出现了明确错误,尚不能据此减少这部分检查。
四、经营简报:数字一致,还要核对图表比例
经营简报把要求集中在数据上。顶部是收入120万元、订单6000笔、平均客单价200元、退款率1.8%四张卡片;中间是六个月的柱状图和收入来源环形图;下方保留六行原始数据和两句统计口径。整页需要让同一份数字在多个区域中保持一致。
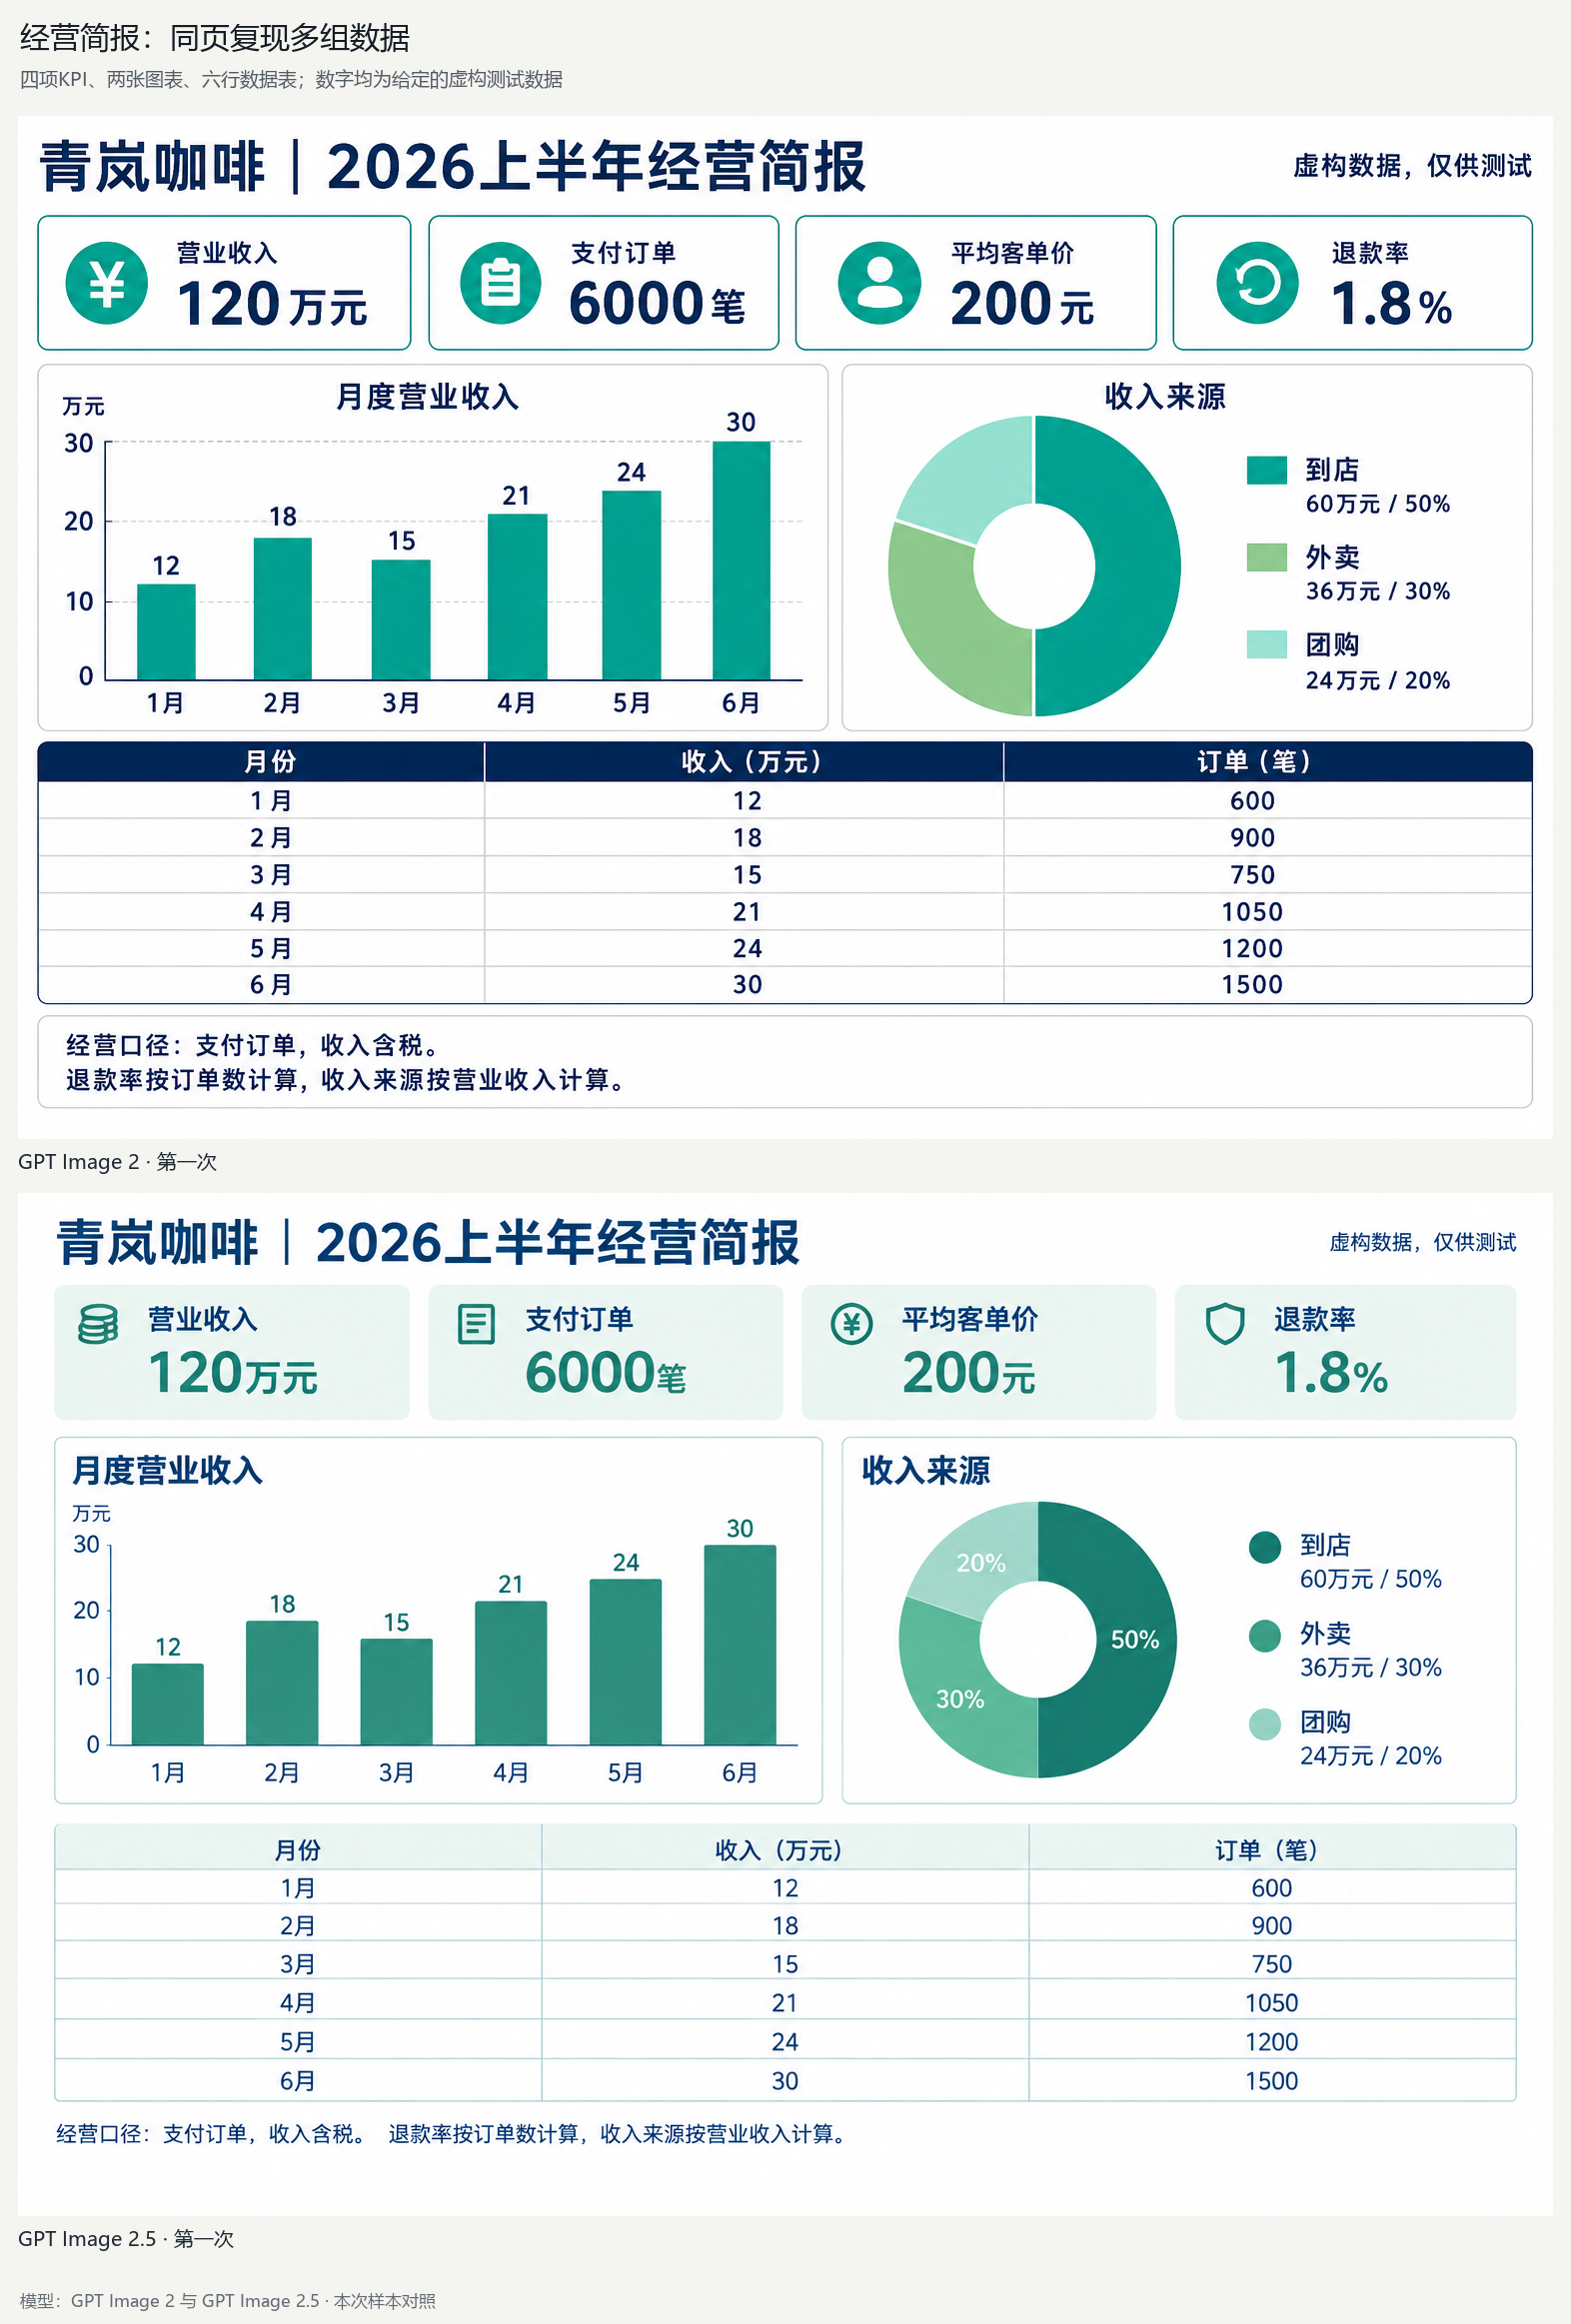
六张图片中的KPI、柱上数字、图例金额和表格字段均核对正确。月收入合计120万元,订单合计6000笔,与顶部卡片一致。环形图的三个区段也大致符合50%、30%、20%的要求。这些数字事先已在提示词中给出,因此这里只能确认复现和对应情况,不能推断模型自行完成了计算。
柱子的高度出现了更细的偏差。生成前约定,柱高误差允许占纵轴满量程的3%。本题纵轴为0到30,相当于允许0.9的偏差;原图坐标测量还留出边缘像素的不确定度,接近界限的结果记为无法确定。
GPT Image 2 的三张柱图均在这项容差内。2.5 的前两张有接近界限的柱子,第三张的五月柱上写着24,按纵轴位置量出的高度却约为25.5,超过预设容差。
这个偏差对粗略观看趋势的影响有限,对需要准确表达数据的经营报告则应修正。生成图适合讨论整页布局,正式报表中的图表仍应由数据绘制后核对。此次结果也没有显示2.5在数据图形准确度上领先。
五、中文书法:有风格差异,提升尚不明确
书法值得单独测试。普通中文排版主要检查文字内容和布局,书法还涉及字形省变、笔画呼应、墨色与章法。上一代已有正面公开样本,王树义在少数派的 GPT Image 2 体验中展示过草书和隶书,评测需要继续比较具体字形和排布。
本轮选用王维《山居秋暝》前四句:空山新雨後,天氣晚來秋。明月松間照,清泉石上流。两边使用相同繁体文本,要求四列、每列五字、从右向左阅读,分别生成行书和草书,每题每代三次,共十二张。画面只保留宣纸和墨迹,不加印章、落款或插画。
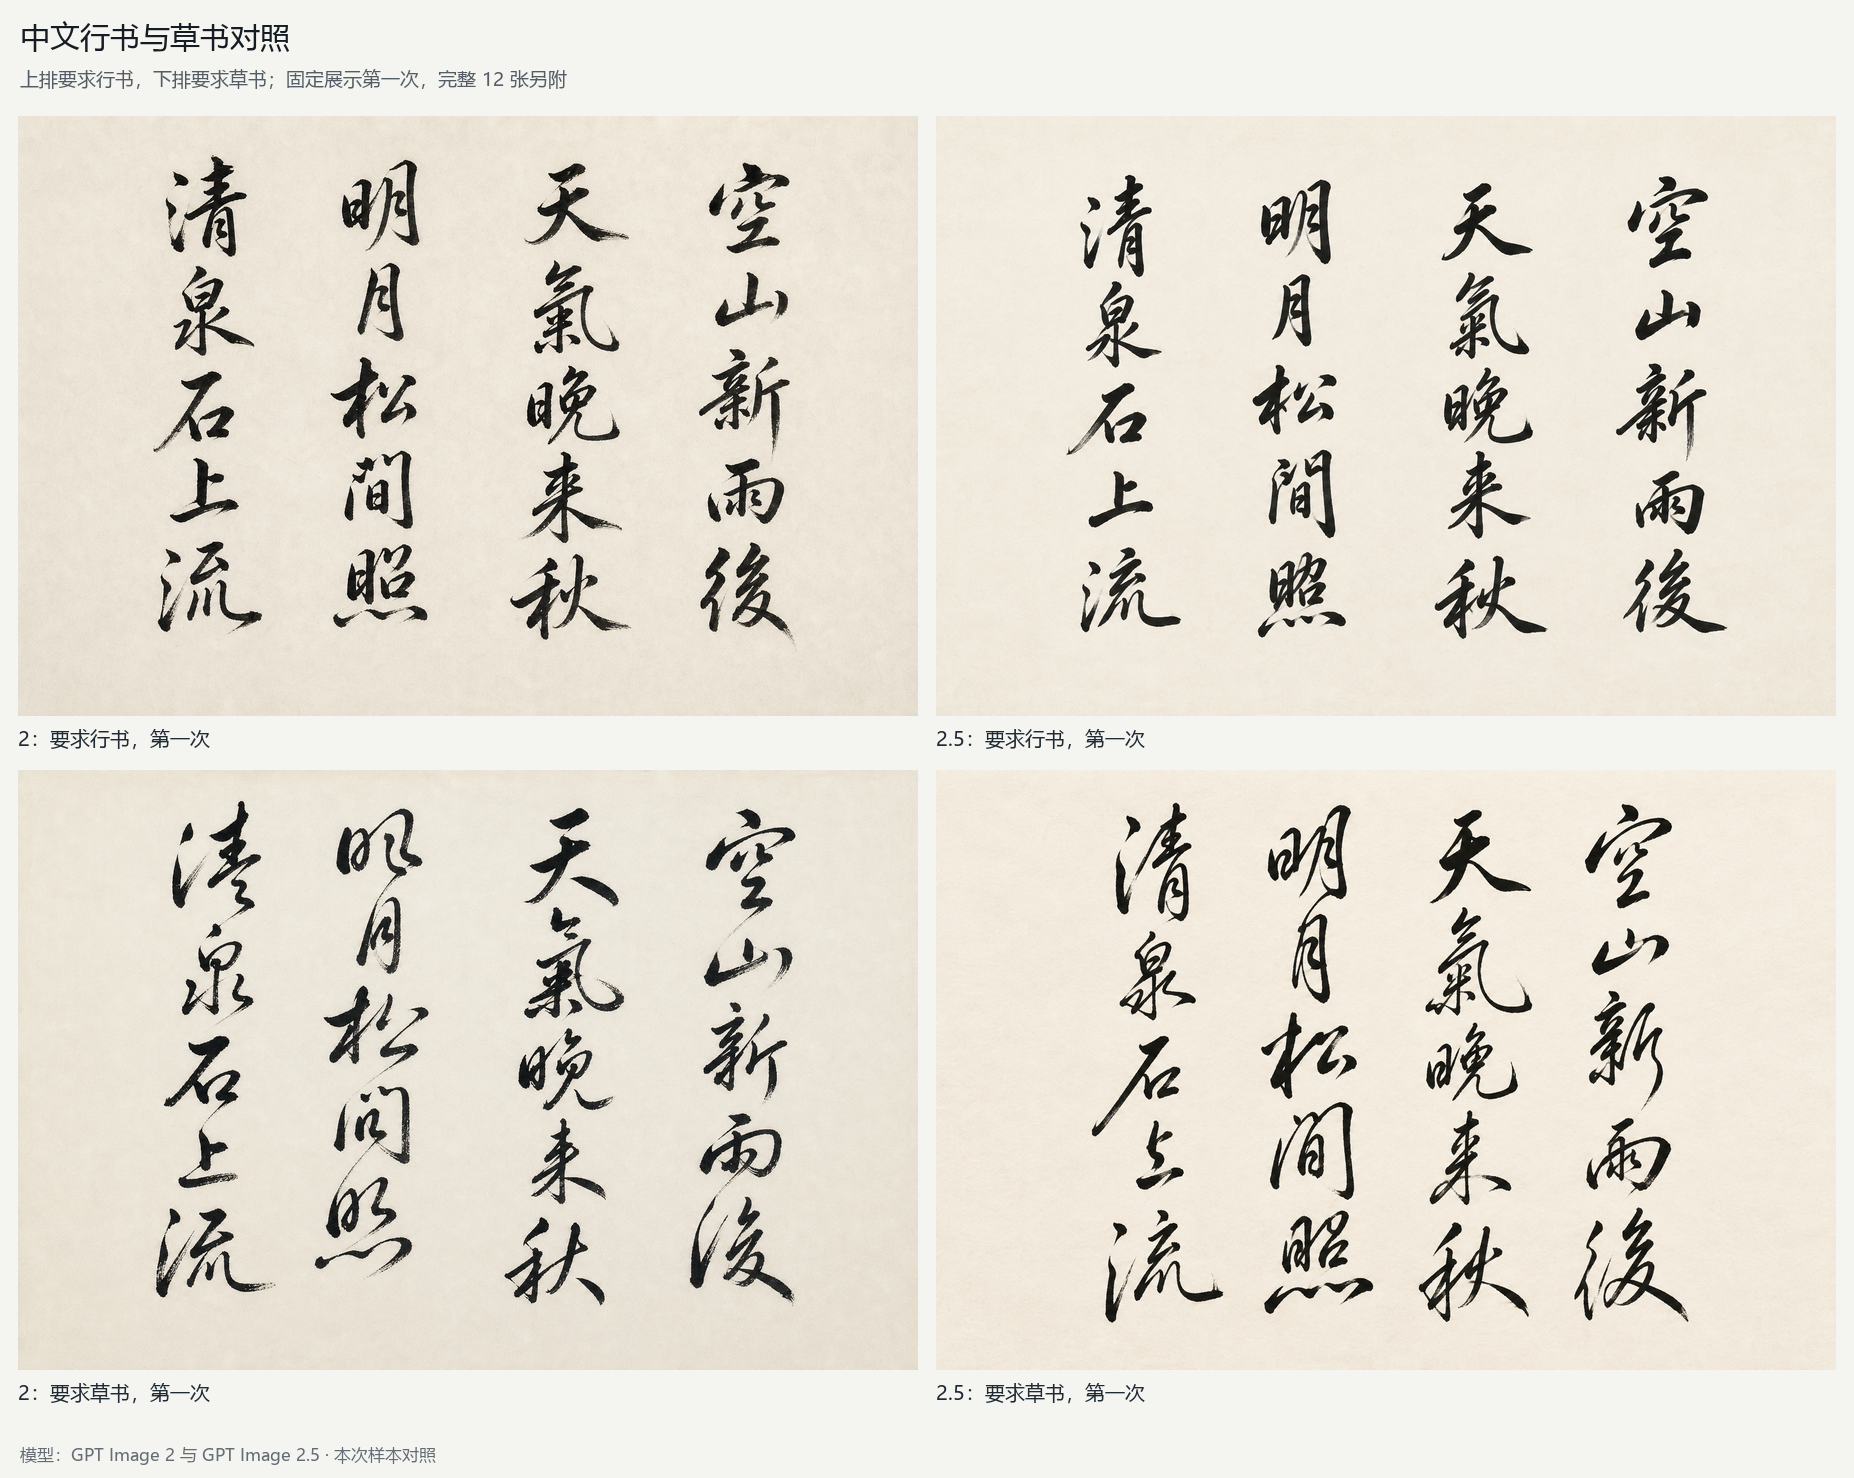
十二张结果中的诗句内容和四列顺序均能辨认。行书样本的字形与布局较接近,2.5 的墨迹偏饱满、整洁,上一代部分笔画有更多颗粒和飞白。草书样本中,上一代部分结果的明、清等字省变和连带更突出,2.5 较常保留完整、清楚的结构。
这些区别会影响视觉偏好。此次没有进行专业草法鉴定,也无法从静态图片确认实际笔顺,目前不足以判断2.5的书法水平更高。
六、连续编辑和人物细节仍需逐项检查
连续编辑要求把客厅里的棕色沙发改为深绿色,将矩形木茶几换成圆形大理石茶几,再在左侧加落地灯。两代模型都完成了两张底图的三轮修改,前一轮修改也保留到了最后。局部墙面纹理有差别,但正常阅读尺寸下并不突出,本轮不将其作为明显提升的依据。
两栏密集中文、双手递杯和密集人群三项也没有显示稳定领先。中文正文总体连贯可读;部分手指与远处面孔存在遮挡,无法完整核对。本轮没有给出逐字符、逐手指或逐人脸的准确率。
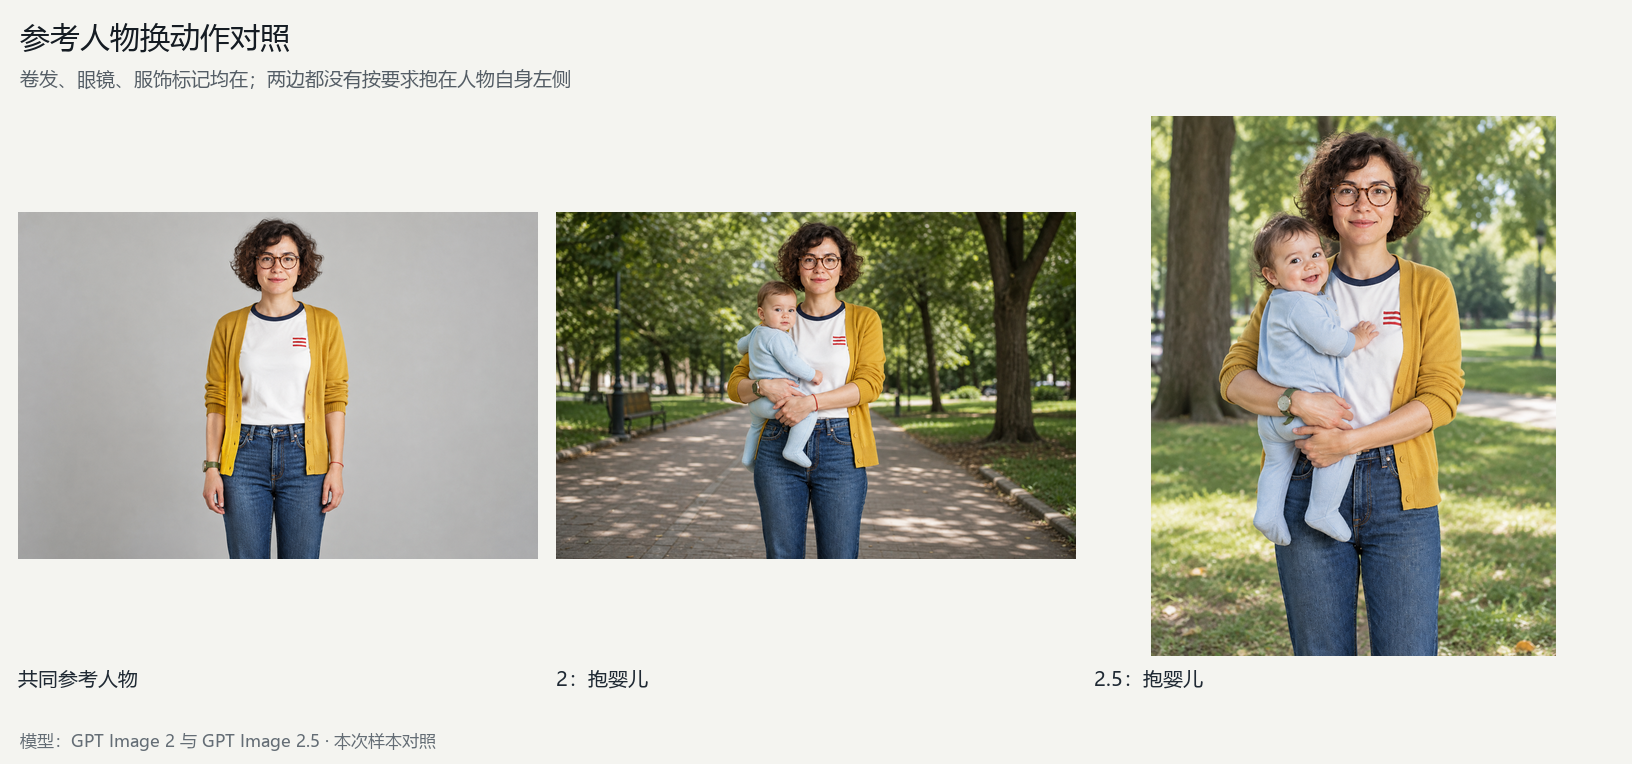
参考人物换动作时,短卷发、圆框眼镜、服装颜色等主要特征基本保留。抱婴儿的结果却都放在了女性自身右侧,没有遵守自身左侧的要求。两代在身份特征保留之外,都还存在空间指令遗漏。
删除任务的问题更容易辨认。底图中的红衣人物站在玻璃旁,同时有玻璃倒影和地面长影。提示词明确要求三处一起删除。GPT Image 2 三次都完成了,2.5 有两次留下完整红衣倒影,第三次才全部清除。
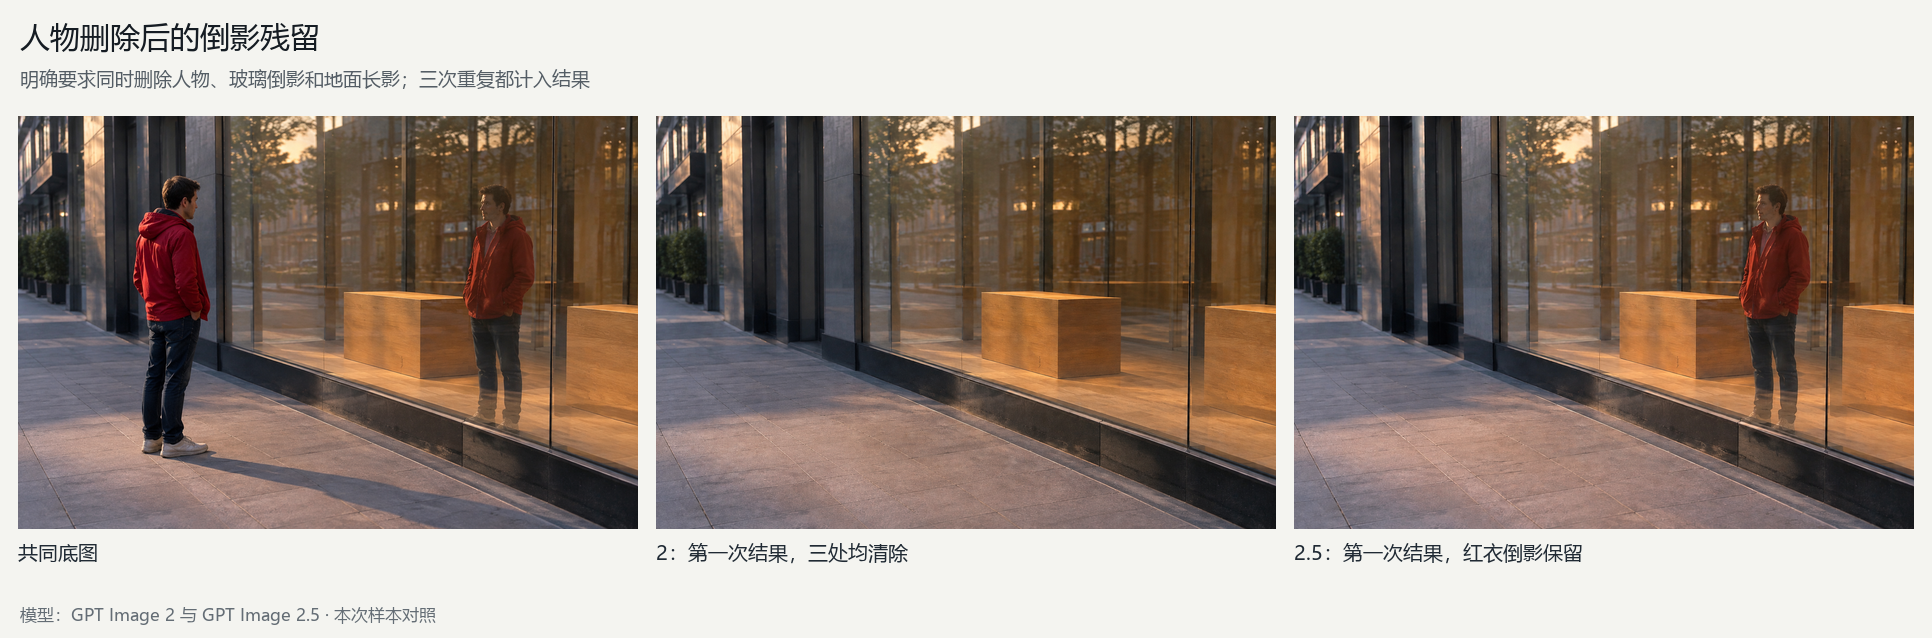
三次重复使用同一张底图,无法据此推断所有删除任务的成功率。这组结果至少说明,2.5 仍可能遗漏与主体相关的内容,反射和投影需要在改图后单独检查。
七、目前能确认的变化与使用边界
本轮最有实用价值的结果来自三组复杂图文任务。两代模型都能在单张图片里安排多组商品、长规则、操作步骤和经营数据。海报中的五组规格价格,以及报表里重复出现的数字,完成情况都较好,已经可以用于具体讨论版面和信息呈现。
要求进一步落到工具接触点、成品零件数量和精确图表比例时,错误仍然出现。2.5 在某一次生成中修正了上一代出现的问题,后续重复又会出现新的偏差。中文书法和普通排版则主要呈现风格差异。
现有流程已经能满足要求时,可以根据实际评测结果再考虑是否全面更换模型。采用2.5时,可以优先比较自己的常用成品:商品图文能否对应,说明图能否按步骤理解,数据图能否准确表达原表,以及这些要求在重复生成中是否保持。判断应落到这些具体结果上。
本文由 @Timothy 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


把检查重点从标题文字扩展到工具接触点、螺钉数量和前后结构,这个补充很实际。复杂图文最容易被整洁版面骗过去,只有沿着步骤逐格核对,才能发现多出的第五个红钉位或放错的扳手。