
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
赚到了,Gemini 4 发布,又高又硬!碾压GPT-6 Astra、Claude Opus 5.5!


谷歌跳过发布会,直接放出新一代旗舰 Gemini 4 Argon。最狠的一刀在输出侧:单次生成上限拉到 100 万 Token,缓存命中后输入价只要 0.10 美元。文章还拆了它在 DeepSWE、Vals Index 的成绩,和用它重构谷歌基础设施的复盘。
熟悉老章的兄弟们都知道,整个九月份,我和谷歌 Gemini 之间的爱恨情仇
我可是真花了 199 刀买了 Gemini Advanced 年会员,结果被糟糕的上下文遗忘、死板的代码输出以及莫名其妙的账号区域报错气得够呛:谷歌 Gemini 3.8 Flash 又赢了吗?我最后悔的,就是买了 Gemini 年会员
后来谷歌桌面客户端迎来重大升级,我抱着“既然年费交了就物尽其用”的想法,把客户端下载下来仔仔细细摸索了一遍,结果发现那个所谓的 Spark Agent 与本地文件联动极其鸡肋,左侧大片空白、中间层级割裂,点击文件夹居然只是系统弹窗,我又忍不住发了一篇:谷歌 Gemini 桌面客户端,实测,有惊喜,但不多
直到九月中旬,我秉持着勤俭持家不浪费的原则,把 Gemini 3.8 Flash 接入 Antigravity CLI 里真刀真枪跑活儿,才当场被惊艳到了:代码逻辑极度严密、上下文吞吐丝滑、响应速度飞快,审美与执行力更是出奇的高,甚至连限额都极其耐造,我赶紧在公众号公开认错:《我要向 Gemini 3.8 Flash 道歉!》我要向 Gemini 3.8 Flash 道歉!Antigravity CLI 中完全不一样
就在前天,我的 Gemini 终于要回本了,开发了一个 macOS 原生客户端,已开源!一文中我拉着 Gemini 3.8 Flash 带着 SwiftUI 彻底重构了开源客户端,当时还在文末跟大家开玩笑:
“我的 Gemini 年会员终于要用回本了,听说内部代号的 Gemini 4 即将发布,要是真把各路神仙按在地上摩擦,那咱这 199 刀可就血赚了”
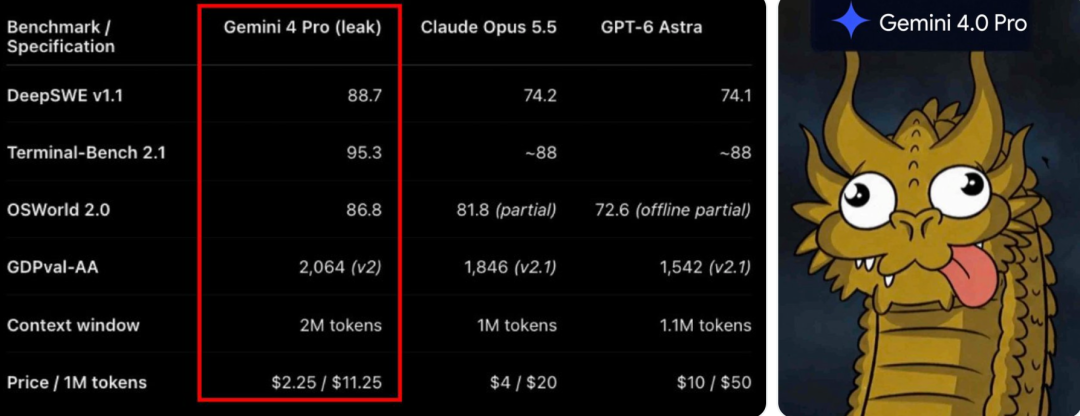
老章这张嘴可能真被开过光
今天凌晨,谷歌 DeepMind 没有任何预告,没有提前倒计时,甚至连发布会演讲都省了,直接在官方博客甩出了一颗重磅炸弹:
全新一代前沿智能模型——Gemini 4 Argon(代号:氩气),正式解禁!
仔细研读完官方公布的全套评测报告、内部实战工程复盘以及前沿安全白皮书,我深吸了一口气:
这次谷歌掏出来的完全是另一套物种,它彻底跳出了过去两年行业里“在聊天框里教 AI 做打工人”的初级游戏,径直杀进了工业级大型复杂系统的重水区
一、100万 Token 输出极限:长程工程智能体的质变分水岭
在探讨具体技术细节前,我们先聊聊当前大模型在实际生产中最致命的工程痛点
大家平时在日常开发或重度办公中使用大模型,最痛苦的体验往往来自以下几点:
- 单次输出被腰斩:主流前沿模型的输出限制通常卡在 4K 到 16K,个别顶格到 64K,一旦要求它输出一套完整微服务、多文件重构方案或者数万行数据迁移脚本,吐到一半就卡壳
- 碎步交互导致幻觉倍增:由于模型无法在单次运行中跑完完整闭环,工程师不得不人工介入,在下方输入“继续”、“请接着写”,导致上下文在拼接中不断漂移,最后生成的代码前后矛盾、接口对不上
- 缺乏长程试错与仿真空间:模型没有足够的思考轨迹(Thinking Budget)去构建内部虚拟环境,无法在输出前自己做单元测试、分析报错日志并完成自我重构
而这次 Gemini 4 Argon 带来的第一个毁灭性升级,就是把单次生成的最大输出 Token 限制直接拉爆到了 100 万(1M Output Tokens)!
请大家务必注意这个参数的本质差异:以往厂商宣传的百万上下文,绝大部分指的是“输入上下文(Input Context Window)”,也就是能喂给模型多少资料;而 Argon 这一次做的是百万输出(Output Tokens),是允许模型自身单次自主生成、推演高达上百万 Token 的完整成果!
【单次输出 Token 上限演进】
传统大模型主流水准: 4K – 16K Tokens (只能编写单个函数或短小片段)
上一代前沿极限: 64K Tokens (勉强支持单个完整脚本或简易模块)
Gemini 4 Argon 工业跃迁:1,000,000 Tokens (单次交付完整系统工程、大型库重构、闭环推演)
当模型拥有了单次 100 万 Token 的连续推理空间,整个工程协作的范式发生了颠覆:
Argon 可以在一个孤立的仿真沙盒内,自主拉起多轮复杂的思维链,调用代码编译器,反复阅读汇编层输出,自己编写测试用例跑回归,中途遇到崩溃自动回滚并修正方案,直到把一整套经过严格实测检验的工业级工程代码一口气交付出来
与此同时,谷歌还打出了一套极其激进的成本牌:
- 基础输入定价:$2 / 100 万输入 Tokens
- 基础输出定价:$10 / 100 万输出 Tokens
- Prompt Caching 缓存:享受高达 95% 的断崖式减免,命中缓存后输入价格仅需 $0.10 / 100 万 Tokens(折合人民币只要几分钱)!
对于那些动辄需要把数百兆源码库、全套企业规章、海量监控日志常驻在上下文中的工程智能体集群而言,这种定价策略直接把原本高不可攀的计算成本砸到了地表
官方在发布报告中直接给出了综合评测大图,横跨软件工程、企业金融法律知识工作、多模态全景感知与网络攻防四大战场:
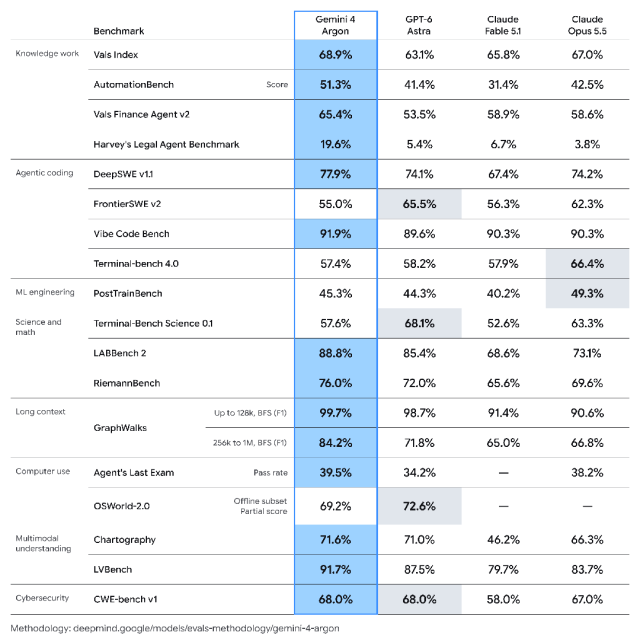
Gemini 4 Argon 官方综合评测大表:长程任务全面霸榜
为了让大家更加清晰地理解这套架构的底层运作逻辑,老章特别梳理了这张长程工程智能体的运转体系图:
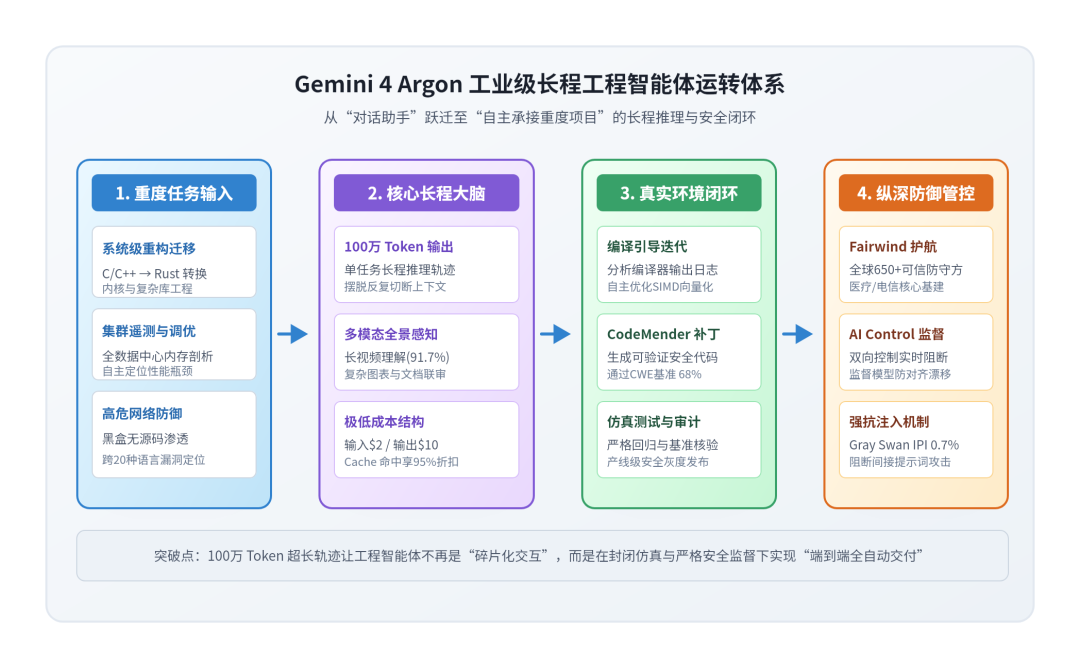
Gemini 4 Argon 工业级长程工程智能体运转体系
二、自家产线上的真实战役:用 Argon 重构谷歌基础设施
大模型的发布材料大家早已见怪不怪,实验室跑分往往充满水分
但谷歌这次最狠的地方在于:在向外界公布之前,他们已经在自家全球最严苛的生产环境中,让 Argon 智能体集群秘密服役了数个月,并且直接晒出了三场极其硬核的攻坚实战
战役一:全数据中心集群遥测分析,狂省 1 PiB 内存
谷歌拥有全球最庞大、密度最高的数据中心集群之一,成千上万台服务器日夜运转,内存资源是支撑搜索、云服务、视频流媒体的最昂贵基础设施
长期以来,海量微服务之间的内存碎片化、隐藏对象泄漏、不合理的缓存释放策略,一直是困扰基础架构团队的顽疾
谷歌直接将一组 Argon 智能体派驻进数据中心运维神经中枢,让它们自主读取、分析全网服务器的 Profiling 遥测海量数据(fleet-wide profiling telemetry)
以往需要几百名资深 SRE 工程师耗费数月抽样排查的内存瓶颈,Argon 智能体集群在持续推理中自主建立起了全集群对象生命周期拓扑图,精准锁定了数千处低效代码,并自主编写了内存优化补丁
这一套战果直接让财务部门笑逐颜开:
- 目前首批优化上线后,已在生产环境中实打实释放出 300 TiB 物理内存
- 随着整套补丁在全网节点的灰度推进,预计总计将节约 500 TiB 到 1 PiB 的可用内存!
这绝非虚拟跑分,而是直接为数据中心省下了价值数千万美元的高性能服务器采购预算
战役二:80万行系统微内核向 Rust 迁移,硬核重构底层音视频解码
系统级编程领域目前正在经历一场历史性迁徙:为了根除内存安全漏洞,必须将数十年来用 C/C++ 堆砌的基础设施改写为 Rust
但在实际工程中,这种改写极其痛苦:不仅需要严格保证对外接口行为绝对一致,更难的是如何在获得 Rust 内存安全的同时,不损失手写 C/C++ 极致的硬件性能
Argon 智能体集群直接接管了谷歌内部多项底层基石库的大迁徙任务,覆盖范围从小巧高频的 re2 正则库,一路扩展到了谷歌下一代操作系统 Fuchsia 的核心——整整 80 万行代码的 Zircon 微内核!
最精彩的案例发生在开源 AV1 视频解码核心 libgav1 的工程重构中:
- 传统的 Rust 移植版本为了满足安全检查,往往难以直接发挥 CPU 底层向量化能力,运行速度远落后于精心优化的 C++
- Argon 智能体接手后,直接面对多达 32,000 行复杂的底层 SIMD 汇编向量化代码
- 它并没有机械地生搬硬套,而是自主启动了数百轮由性能分析引导的编译实验(profile-guided experiments),一行行精读编译器生成的机器汇编代码
- 最终,Argon 构思出了一种极为精妙的安全 Rust 语法结构,让 LLVM 编译器能够 100% 自动识别并激进生成向量化指令!
经过严苛的逐帧比对,重构后的 Rust 视频解码器输出画质与原始 C++ 分毫不差,运行速度比原先的 Rust 移植版暴涨了整整 2.7 倍,性能几乎完全追平了手写优化的 C++ 代码!
在具备绝对内存安全的前提下实现性能无损飞跃,这种极度细致、枯燥且高难度的系统工程,正是长程推理能力的终极体现
战役三:量子计算算法时空开销几分钟内压缩 40%
在量子计算领域,算法能否在当前嘈杂中等规模量子(NISQ)设备上运行,完全取决于量子比特数(Qubits)与量子门深度(Gates)相乘的时空资源总开销
Argon 智能体在面对极度晦涩的量子算法子程序时,在短短数分钟内就重新编排了量子门路径,把学术界此前历经数年研究公开发表的基线指标,直接砍掉了 40%!
三、真实经济生产力霸榜:攻克金融、法律、长视频与跨软件业务
从代码底层回到企业级知识工作,Argon 展现出了前所未有的全景统筹能力
1. 软件工程长程推理:DeepSWE v1.1 斩获 77.9%
在当前衡量大模型解决真实 GitHub 仓库复杂 Bug、跨文件重构能力的权威基准 DeepSWE v1.1 中,Argon 取得了 77.9% 的历史最高成绩:
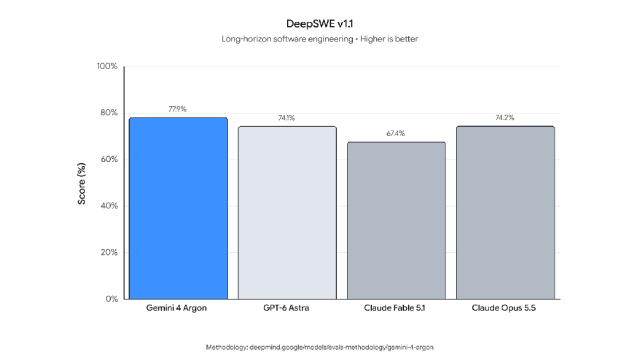
DeepSWE v1.1 长程软件工程评测:Argon 斩获 77.9% 顶尖成绩
这项测试绝非简单的 LeetCode 刷题,它直接把整个开源大项目的完整代码库、历史 issue 描述、复杂的构建环境一起扔给模型,要求它自己定位根因、修改代码并跑通全部回归测试用例,77.9% 的成绩意味着绝大部分日常工程工单已经完全具备自主交付的成熟度
2. 全球经济价值综合指标:Vals Index 强势夺魁
评估一个前沿模型,不能只看技术宅喜欢的参数,更要看它在实体经济中到底能创造多少商业价值
Vals Index 榜单专门按照美国 GDP 中各行各业的实际贡献权重,对大模型在金融分析、商业编程、法律事务、财税核算四大高附加值领域的综合表现进行量化加权,Argon 毫无悬念拿下了全球综合经济价值第一:
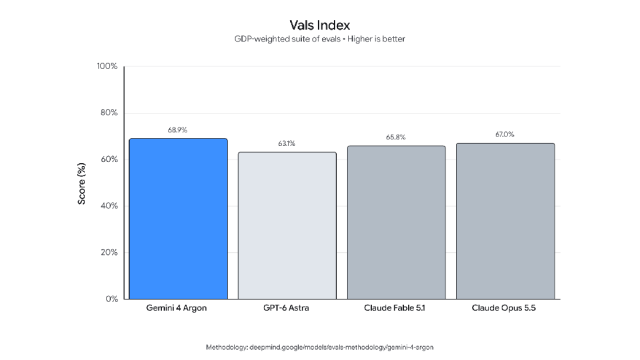
Vals Index 经济生产力综合榜单:Argon 登顶第一
3. 金融智能体深度推演:Vals Finance Agent v2 领跑
在需要跨越数百份财报、行业研报、宏观经济数据进行多步推演的金融智能体评测中,Argon 展现出极强的抗噪能力与严密的逻辑链路:
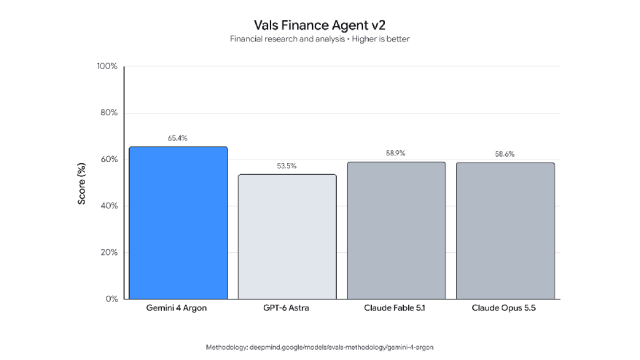
Vals Finance Agent v2 评测:复杂金融研报与多步推演
它不再只是摘抄财报上的表面数字,而是能自主穿透财务附注,核算折旧摊销逻辑的合理性,并结合上下游供应链数据给出极具深度的研报初稿
4. 严谨法律起草与证据链审查:Harvey’s Legal Benchmark 登顶
在由顶尖法律科技独角兽 Harvey 主导的专业法务评测中,Argon 在长篇合同审查、跨境合规条款比对以及诉讼证据链整理上全面霸榜:
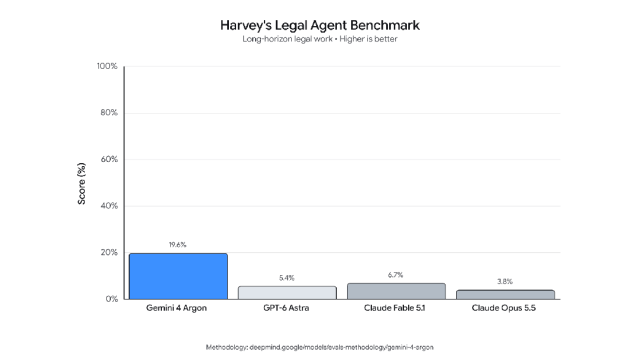
Harvey’s Legal Agent Benchmark 评测:专业法律文书与证据链梳理
5. 跨系统端到端业务执行:AutomationBench 成功率破半
在 Zapier 权威发布的 AutomationBench 复杂业务自动化评测中,Argon 需要自主跨越多个外部 SaaS 应用(如数据库、CRM、邮件、日程、表单),处理复杂的长链路业务审批流,最终以 51.3% 的成功率高居行业榜首:
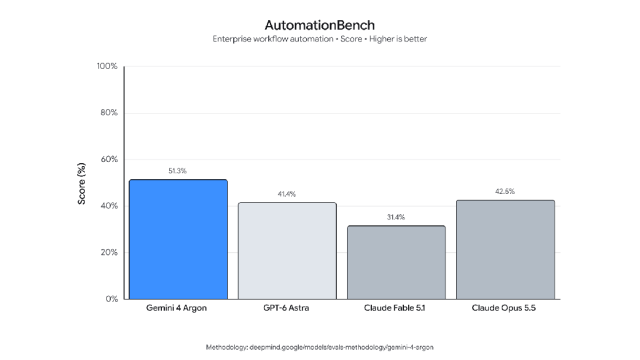
AutomationBench 真实跨软件业务自动化执行评测
6. 长视频多模态全景感知:LVBench 拿下 91.7%
知识工作不仅仅是处理文字,更多时候充斥着大量的录屏会议、现场实况、监控影像以及错综复杂的图表
Argon 在超长视频理解评测基准 LVBench 中拿下了惊人的 91.7%,支持以 1 FPS 的采样率无损消化长达数小时的超大视频流,无论是在长视频的第几十分钟闪过的一页架构草图,还是监控视频中细微的行为变化,都能做到毫秒级精确定位并纳入推理逻辑
四、终极底牌:网络防御自动化修补与黑盒渗透核武器
如果说上面的各项能力已经足够惊艳,那么 Argon 在网络安全防御领域的突破,则彻底拉开了它与市面上所有同类产品的代际差距
以往的 AI 讲到网络安全,基本停留在给程序员做“代码安全审计提醒”,或者在聊天框里给运维人员解释某个 CVE 漏洞的原理,这种纸上谈兵的能力在面对瞬息万变的网络攻击时显得苍白无力
而 Gemini 4 Argon 是第一款真正具备全自主漏洞挖掘、无源码黑盒验证,并且能够直接生成工业级可用修补补丁的前沿大模型
1. CWE-bench v1 安全漏洞修补夺冠
在衡量大模型修补软件安全漏洞真实能力的基准测试 CWE-bench v1 上,Argon 以 68% 的单次通过率并列全球第一:
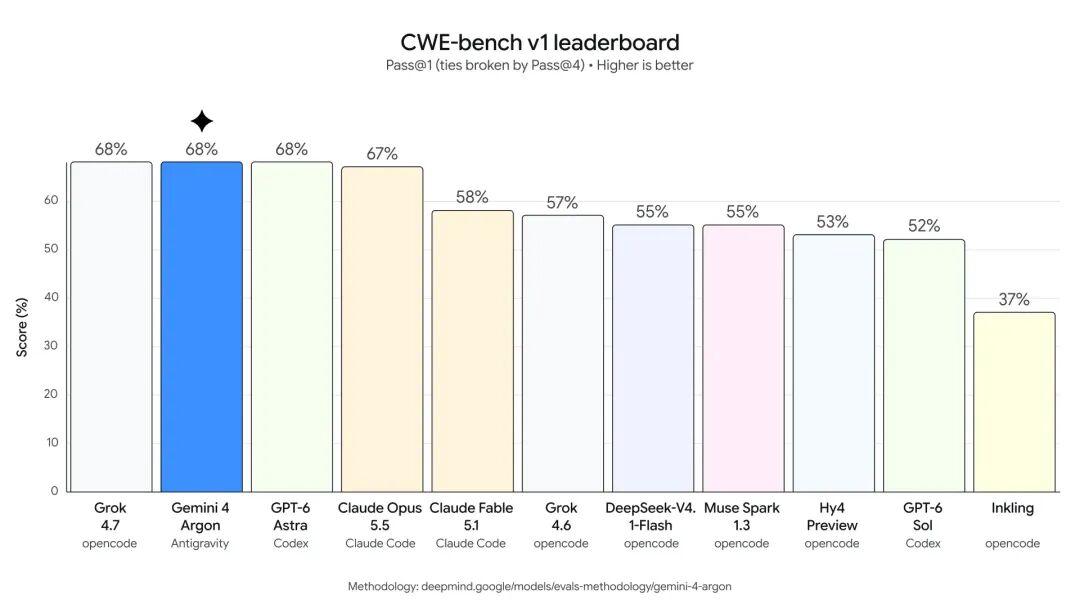
CWE-bench v1 安全漏洞修补基准榜单
这意味着面对 CWE 体系下错综复杂的内存溢出、注入隐患、权限绕过等致命缺陷,Argon 能够在不破坏原有业务逻辑的前提下,全自动输出通过语法检验与回归测试的生产级补丁
2. 真实漏洞挖掘与黑盒渗透实战
在谷歌内部涵盖 20 种主流编程语言的历史开源项目漏洞库测试中,Argon 的漏洞自主检出率达到了恐怖的 85.8%
更令人震撼的是在无源码环境下的纯黑盒渗透测试表现:
云安全领头羊 Wiz 将真实互联网运行的 Web 资产接入测试环境,在不给模型任何后端源代码的情况下,仅凭外部接口交互和运行行为,Argon 对目标资产攻击面的测绘、高危漏洞识别以及验证证据生成率高达 70.9%:
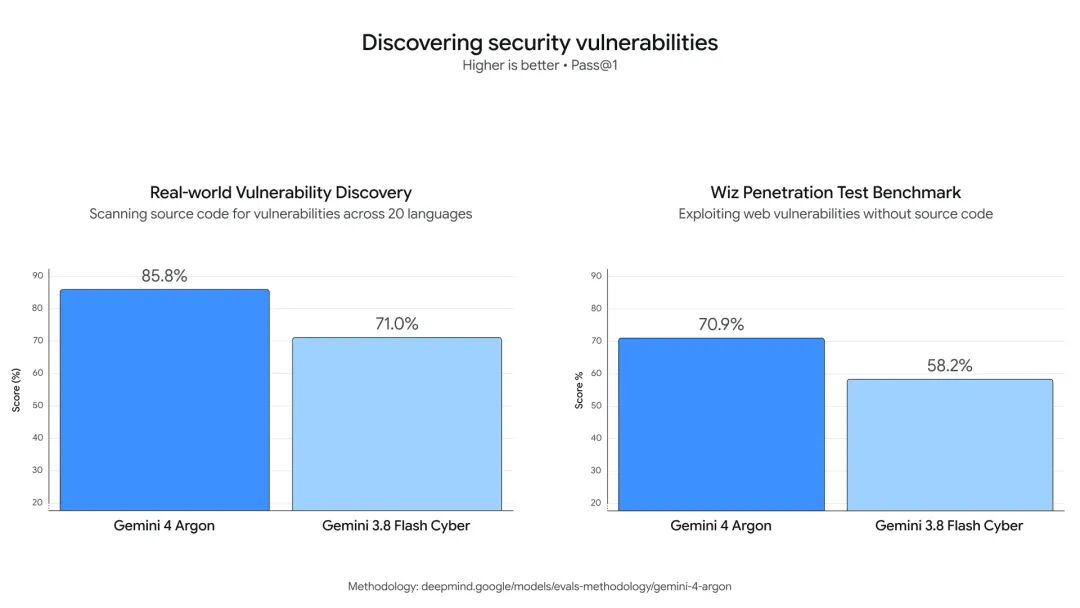
真实代码漏洞与无源码黑盒渗透测试表现
Wiz 在全球知名的“Scan for Good”关键公共基础设施保护公益行动中,深度引入了 Argon 进行实战巡检
结果在刚刚接入的一套全球数百家医院正在重度使用的医疗核心软件中,Argon 自主揪出了一个深藏多年的高危漏洞,该漏洞一旦被黑客利用,将导致海量患者的病历数据、绝密个人健康档案全面泄漏;而此前包括 GPT 系列、Claude 系列在内的多款前沿大模型,在审查该软件时全都漏掉了这一隐患
3. 极强的免疫力:Gray Swan 间接提示词注入(IPI)
安全智能体在真实网络中执行任务时,最怕遭遇黑客精心布置的“网页陷阱”——黑客在网页或数据包里隐藏恶意 Prompt,诱导智能体叛变泄露权限
在业内最严苛的间接提示词注入基准 Gray Swan 测试中,Argon 在攻击尝试深度达到 k=15 的极端情况下,攻击得逞率被死死死压制在 0.7%,抗恶意诱导与抗劫持能力稳固得如同一座地下堡垒:
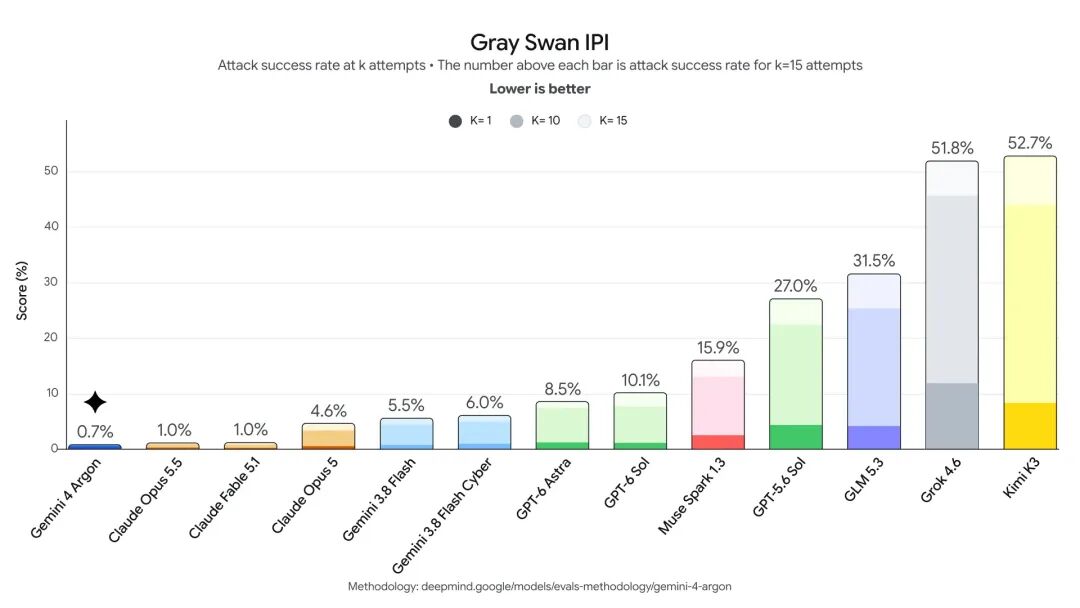
Gray Swan 间接提示词注入攻击防御评测:攻击得逞率仅 0.7%
总结
我更新了antigravity cli,发现 /model 还没有上线 gemini 4,实测要等等了,11月我的年会员要到期了,如果 Gemini 4 真的强如此,那还是赚到了
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议

- 目前还没评论,等你发挥!