
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
生鲜商城AI接待小助手,从意图识别到满意度(下)


生鲜客服场景中,AI助手如何做到既省钱又可控?本文拆解一套五层分层路由架构:从FAQ精确匹配、业务API直调、RAG检索到大模型兜底,再到人工介入,层层过滤,让60%流量零成本秒回,成本直降90%。更有三级级联意图识别与真实对话案例,展示产品落地中的细节与智慧。

上篇讲了定位和意图识别:怎么从咨询数据里判断出要做”自助路由型智能助手”而不是”AI客服”,以及那六步链路怎么把”你妈这榴莲坏了cnm,单3792到底几点能送到啊”这种话拆解、路由、预取。
意图识别是分拣员,分拣完送进不同流水线。这篇讲流水线本身:每条路上的活儿怎么干的、怎么衡量干得好不好、最后账面上到底省了多少,也是整个项目里、最有意思的部分。
一、背景:为什么生鲜客服不能”一个大模型包打天下”
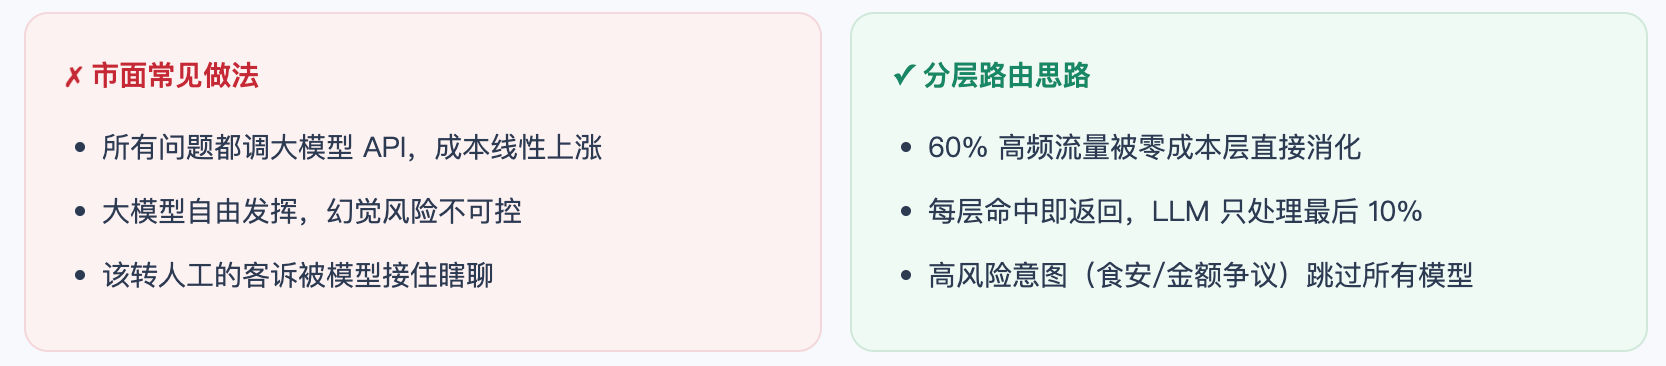
市面上大部分 AI 客服的做法是:所有问题都丢给大模型。这么做有两个致命问题——贵,所有问题都调 API;不可控,大模型会幻觉,而客服场景里一次幻觉可能就是一次投诉升级。
我们的思路反过来:成本从低到高、可控性从高到低,分层路由,每层命中即返回,不命中才下沉。而这套架构的第一道闸门,就是意图识别。
二、整体架构:五层分层路由
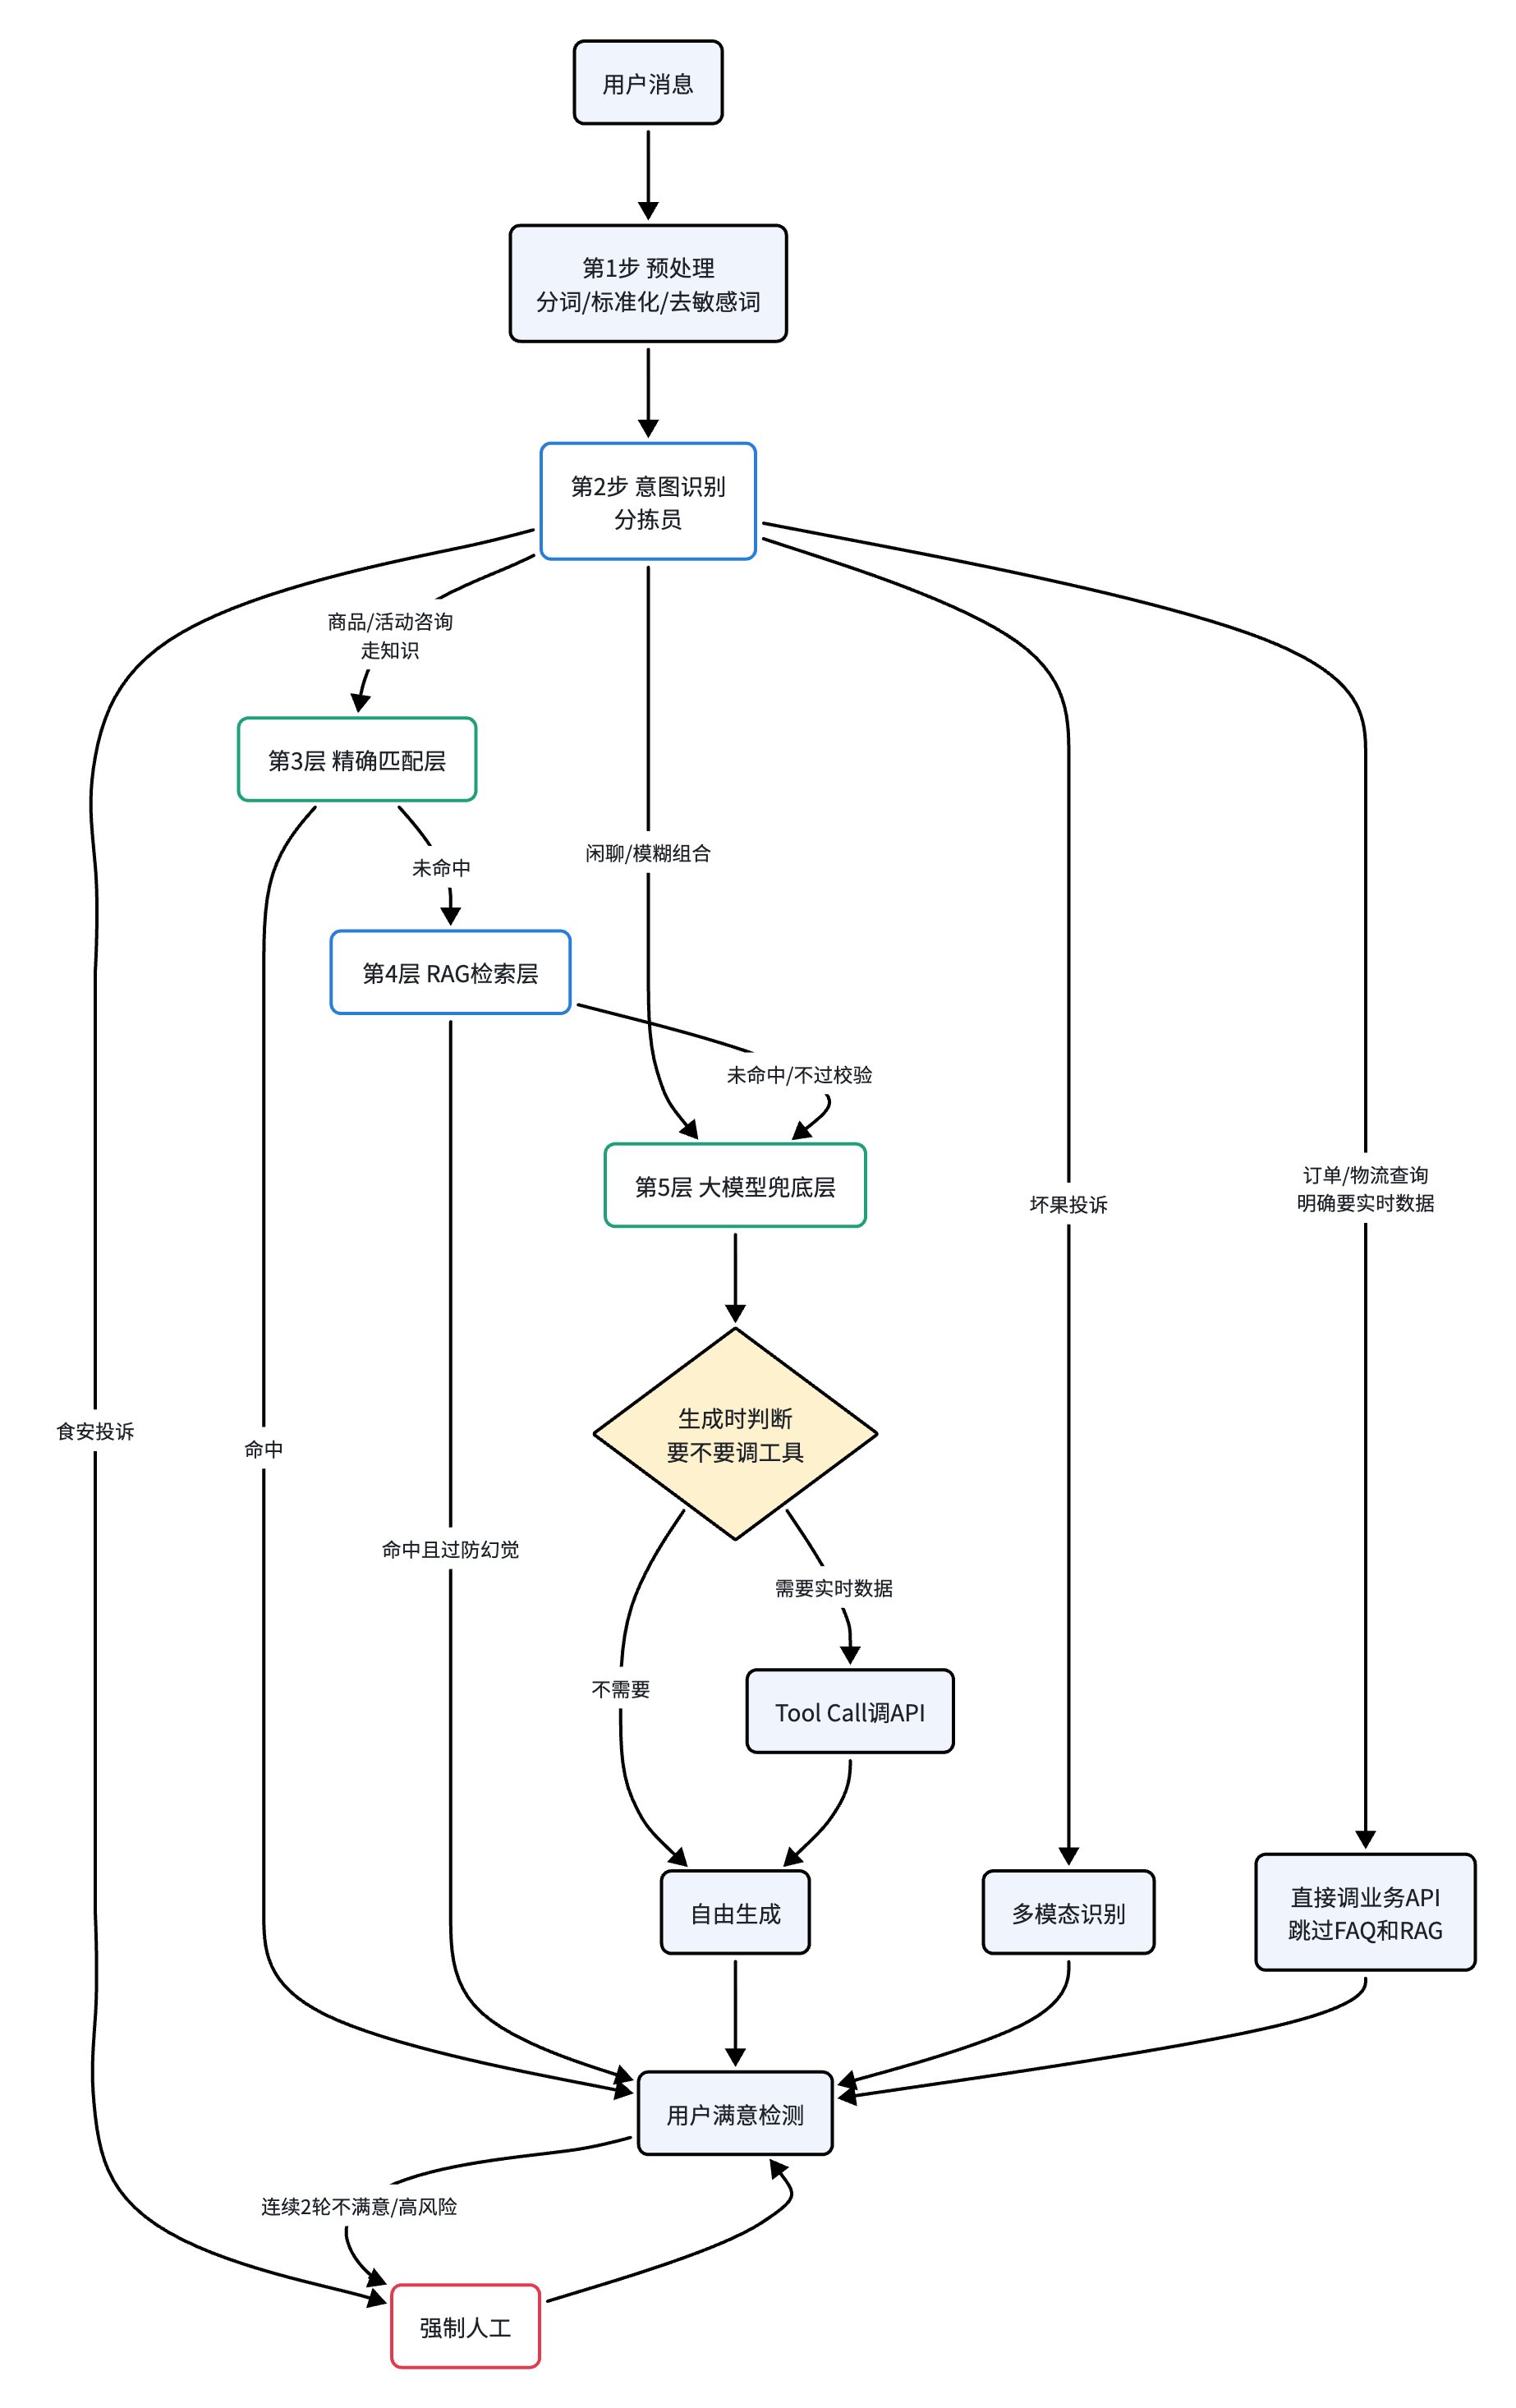
整个系统的骨架是一张漏斗:流量从最便宜的层往下漏,越往下越贵。上篇说的”能规则不模型,能小模型不大模型”,落地就是这个结构。
从上到下数:
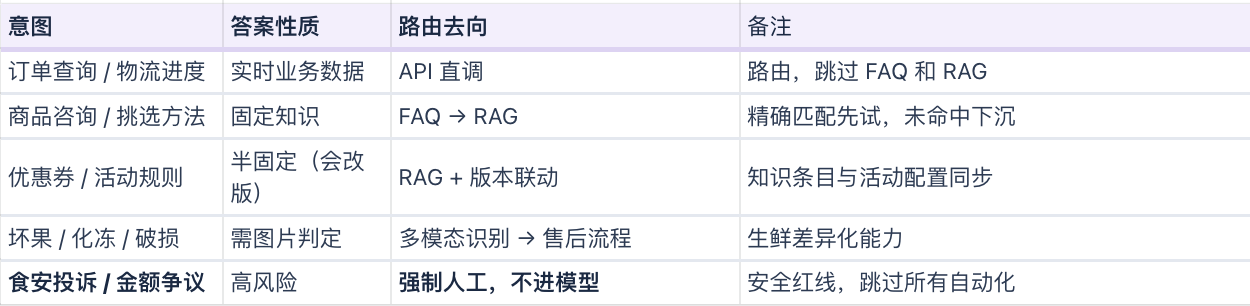
第一层,FAQ精确匹配:消化 40-60% 流量的性价比之王
高频意图内部做细匹配,查的是一张FAQ库——”标准问题 → 标准答案 + 预计算向量”的映射表。注意它不是业务数据库,就是一张问答对。
这层最容易被低估。很多人以为FAQ匹配就是关键词比对,其实我们用的是双路召回:BM25抓字面命中,向量相似度抓换了说法的问法,两路加权融合,分数过0.95阈值就直接返回固定话术。毫秒级、零幻觉、零成本。
为什么能秒回?因为向量是离线预计算的。新增FAQ条目的时候就算好存进表里,用户消息来了,只需要算一次这条消息的embedding(几十毫秒),再做N次余弦相似度计算(微秒级)。
意图分类之后,高频意图内部做细匹配:查 FAQ 库(一张”标准问题 → 标准答案 + 预计算向量”的映射表,不是业务数据库)。双路召回保证不漏——BM25 抓字面命中,向量相似度抓换了说法的问法,加权融合后过 0.95 阈值,直接返回固定话术:毫秒级、零幻觉、零成本。
FAQ条目怎么挑?三道筛选缺一不可:频次高、答案稳定、不依赖实时数据。
- “怎么挑榴莲”频次高答案稳定——进;
- “今天特价”天天变——不进;
- “今天能送到吗”要查物流——不进
——它们各走各的路,谁也别抢谁的活儿。
第二层,业务API直调。
订单物流这类查询,意图和槽位都齐了,直接调接口取数,套话术模板返回。不需要任何模型参与推理。
第三层,RAG检索。
商品咨询、政策类优惠券问题走这层。查知识库,拼上下文,交给模型生成。语义匹配,答案跟着品类季节走的问题只有这层接得住。
第四层,大模型兜底。
复合意图、长尾问题,带上下文直接问大模型。贵,但只接漏下来的百分之十几。
第五层,人工。
客诉、食安、金额争议,识别到就直通,中间不经过任何自助层。
这套分层跑稳之后,60%的流量被零成本层秒回,只有10%到20%真正碰到大模型。后面成本降90%,根子就在这里。
三、核心:怎么分类——三级级联,成本从低到高
这是意图识别的分类引擎。不是选一种分类方法,而是三种方法级联,每一级只处理上一级搞不定的部分:
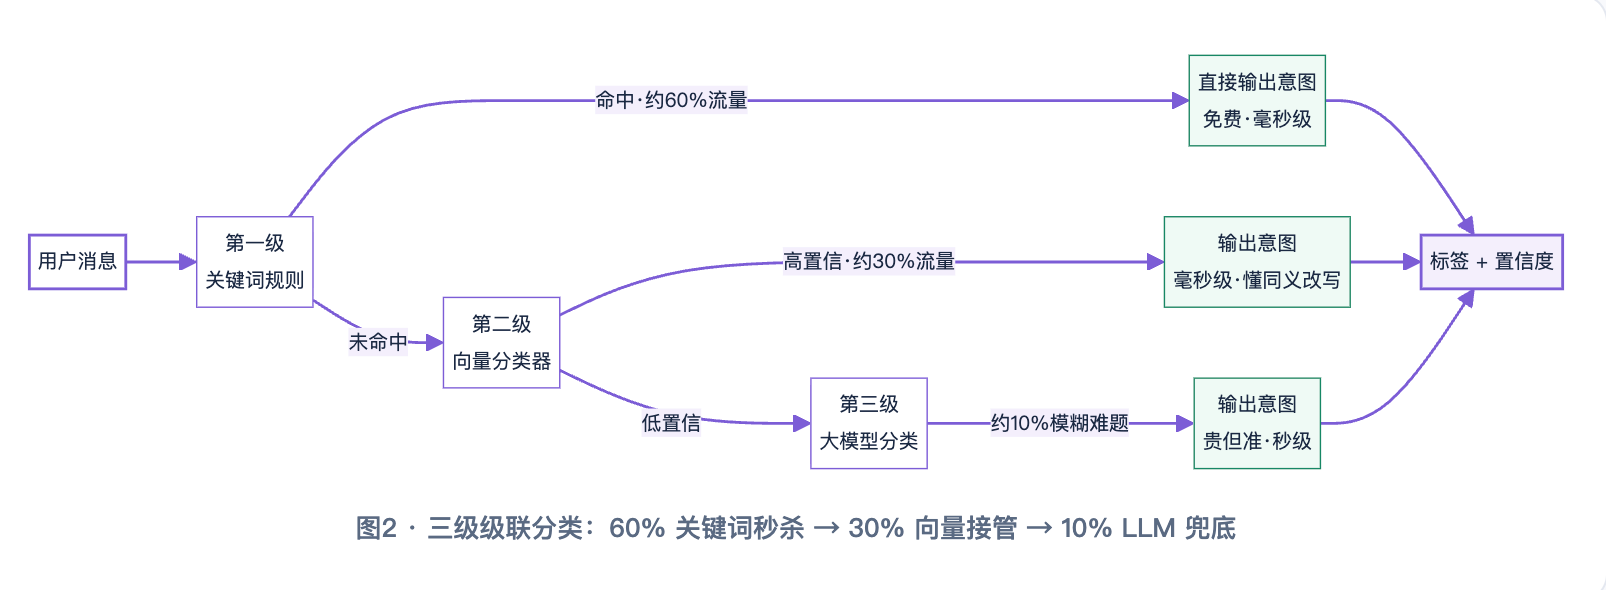
第一级:关键词规则(免费的数量级)
维护一张 {意图: [关键词]} 字典,分词后统计命中。关键细节是词带权重:”退款”是强信号词(权重 2.0),”榴莲”是弱信号词(0.8)——用户提到榴莲不一定是问售后,可能问保存方法。加权命中才判意图,避免字面撞车。
第二级:向量分类器(主力)
把标注好的历史问题转向量,训练分类器(SVM 最简单、BERT 微调最准)。原理一句话:语义相近的句子在向量空间位置相近——”退款到账没”和”钱什么时候退”落在一起,和”榴莲怎么保存”隔得很远。它接住关键词接不住的口语化、同义改写,毫秒级返回。
第三级:大模型分类(兜底)
给 LLM 一个带意图清单和 prompt,处理前两级都低置信度的模糊难题——比如”帮我看那单能不能改配送时间再退个券”这种复合意图。贵但准,只用在刀刃上。
四、输出不是标签,是”标签 + 置信度”;路由靠映射表,不靠分类器
第一,分类器输出的是概率分布,不是单一答案。最高概率就是置信度。分类器不是神,模糊问题硬分一定错——带置信度才有降级的余地,这是准确率的防线。
第二,分类和路由职责分离。意图识别只贴标签;真正决定走哪条路的是一张预先配好的“意图 → 数据源”映射表。判断标准只有一条:这个意图的答案是实时变化的业务数据,还是固定不变的知识文档。前者配 API,后者配 FAQ/RAG。改路由只改配置,不重训模型。
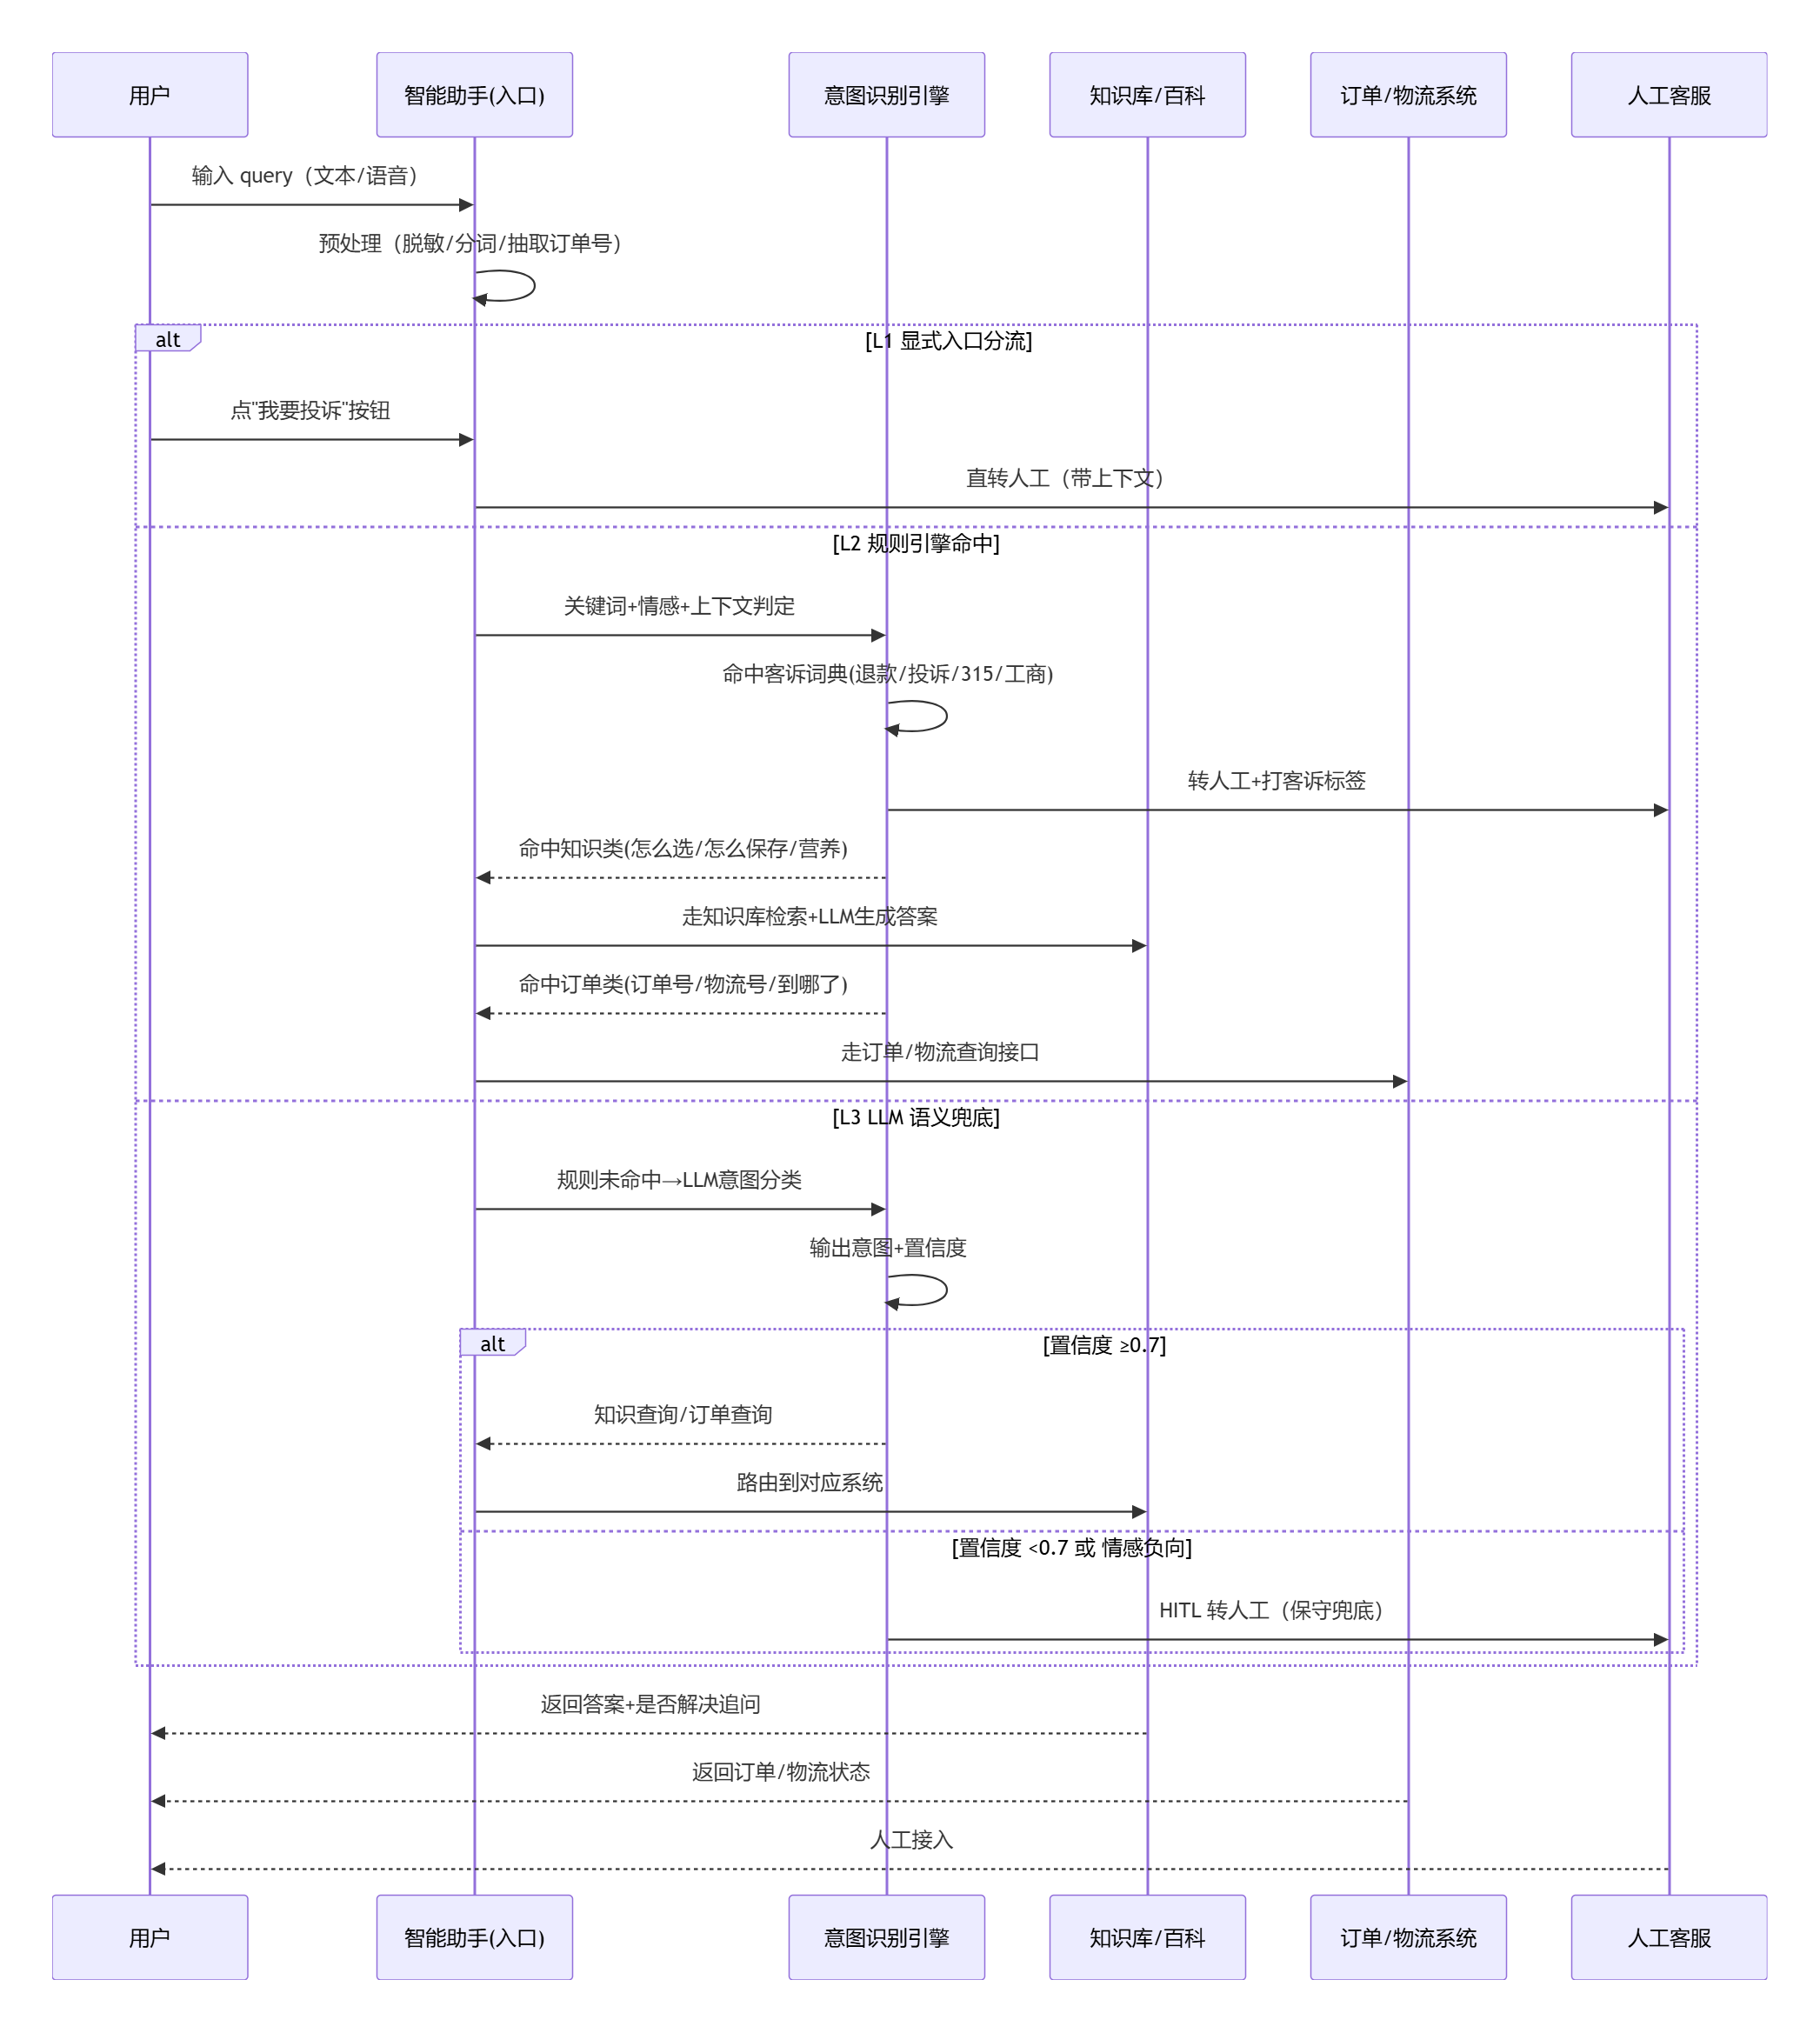
① 输入预处理
用户输入 query → 助手自己做一步“脱敏/分词/抽取订单号”,就是文中的预处理层:不转发给任何人,自己先滤一遍、把订单号槽位抠出来。
②显式入口分流
用户直接点了“我要投诉”按钮——不用识别,带着上下文直转人工。这是把“用户自己举手”当作最高优先级信号。
③ 规则/引擎命中
助手把消息递给意图识别引擎,做“关键词+情感+上下文”判定,命中谁走谁:
- 命中客诉词典(退款/投诉/315/工商)→ 转人工+打客诉标签
- 命中知识类(怎么选/怎么保存/营养)→ 走知识库检索+LLM生成答案(RAG那条路)
- 命中订单类(订单号/物流/到哪了)→ 走订单/物流查询接口(API直调那条路)
④ LLM 语义兜底
规则没接住的长尾,丢给 LLM 做意图分类,输出“意图+置信度”,里面还嵌套了一层 alt:
- 置信度 ≥0.7 → 正常路由到知识库或订单系统
- 置信度 <0.7 或情感负向 → HITL 转人工保守兜底(HITL = Human-in-the-Loop,人在回路)
⑤ 收尾(三条虚线)
返回答案/是否解决问题、返回订单物流状态、人工接入——三条返回路径对应上面三种去向的终点。
五、实操比理论复杂的多
对话一:订单查询,走API直调。
用户:我上周五买的那个单子咋还没消息啊
助手:帮您查到了——订单BG2026100301(车厘子2盒+贝柱500g),当前状态:仓库已出库,配送中,预计今天18:30前送达。
用户:能不能快点,晚上要用
助手:已收到您的加急备注。生鲜配送时效受行车路线影响,暂时无法插单改派,但系统已标记您的订单为优先配送备注。如果18:30前未送达,您回复”超时”,我直接帮您申请延迟赔付。
第二句值得停一下。”能不能快点”是个模糊请求,做不到插单,但也不能干巴巴说”不行”。回复里做了三件事:承认请求、说明约束、给出兜底承诺。这种话术是我们从客诉复盘里一条条攒出来的。
对话二:商品咨询,走RAG。
用户:榴莲选哪种好,我不会挑
助手:挑选榴莲主要看三点:一看尖刺——刺粗而疏、能捏动的熟度好;二闻底部——有浓郁香味的是好果,有酒精味说明过熟;三看裂口——轻微裂口是熟透信号,裂太大容易进细菌。如果您偏好口感,金枕头偏清甜,猫山王偏浓郁。
注意这是下单前咨询。人工坐席答不出这种专业度的一致性,知识库可以。
对话三:优惠券,这组是重头戏。
用户:满199减50的券能跟新人券一起用吗
助手:满199减50属于店铺券,新人券属于平台券,按当前规则可以叠加使用(店铺券先抵扣,平台券后抵扣)。活动截止到10月15日,以结算页实际抵扣为准。
用户:那我的券为什么昨天用不了
助手:帮您查了下账户:您有两张券——新人券(满99减20,10月3日已过期);满199减50(未达门槛,您当前购物车金额为156元,还差43元)。所以昨天不能用的原因应该是金额没到199。需要我帮您看下当前有哪些凑单商品吗?
第一句是政策类,查RAG就够(那个知识块带版本号,跟运营活动配置联动,活动一改规则自动更新)。第二句是这组对话的戏眼:”为什么用不了”意图识别给不出答案,必须查账户实时状态——触发工具调用去查券系统API,拿到”过期+未达门槛”两个具体原因,答案才有说服力。最后那句凑单建议,是转化思维:把一个投诉场景变成一个加购钩子。
对话四:客诉,直通人工加等待窗口四动作。
用户:你们发的西红柿全是烂的!!什么垃圾品质
助手:实在抱歉!收到的果蔬不新鲜是我们的问题,已为您优先接入人工客服,前面还有1位,预计等待约2分钟。
助手(等待期主动发):等待期间方便的话,请把订单号和西红柿照片发我,客服接入后可直接为您处理退款/补发,不用重新描述问题。
用户:(发送照片)
助手:照片已收到。质检会同步给客服。人工客服小王已接入——您好,看到您的订单BG2026100207,西红柿确实存在品质问题,这边直接为您办理全额退款+5元无门槛券补偿,2小时内到账,您看可以吗?
第一句命中客诉意图(情绪词”烂””垃圾”加利益受损),跳过所有自助层直通人工。然后是秒级情绪确认(道歉加排队人数加预计时长)、等待期预收集(订单号加照片,正好喂给多模态坏果初筛)、坐席接入时上下文全在屏上——开口就是解决方案。
对话五:模糊地带,中置信给选项不硬猜。
用户:这贝柱吃了拉肚子 助手:非常抱歉听到这个情况。想先跟您确认下您的需求——
- 咨询贝柱的食用注意事项
- 反馈个人身体不适,需要退款/就医费用协商 您可以回复数字,或直接说说您的想法。
这句话卡在知识查询和客诉之间,置信度不够就不硬分。宁可多问一句,不能猜错方向——往轻了猜漏掉客诉是舆情风险,往重了猜把普通咨询转人工是浪费坐席。
六、上线效果
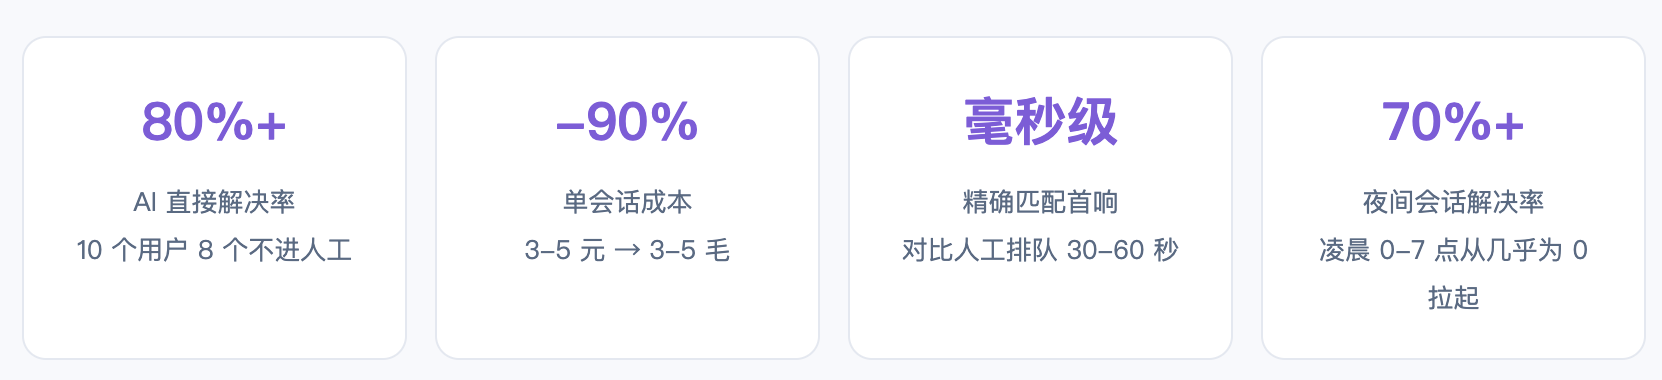
- 人工解决率从100%降到20%——10个用户里8个AI直接搞定,不进人工
- 单会话成本从3-5元降到3-5毛——根子是分层路由,六成流量零成本层秒回
- 首响时长从30-60秒到1-2秒级——用户不用再排队
- 夜间解决率从0到70%以上——凌晨零点到七点从留言等天亮,变成全天有”人”秒回
- 客诉响应不升反降——坐席从机械查询里解放出来,专处理食安、金额争议这类真问题,最需要服务的用户反而更快被接住
- 大促峰值排队200人到零排队——AI无限并发,纯人工永远做不到为一次大促临时招200个客服
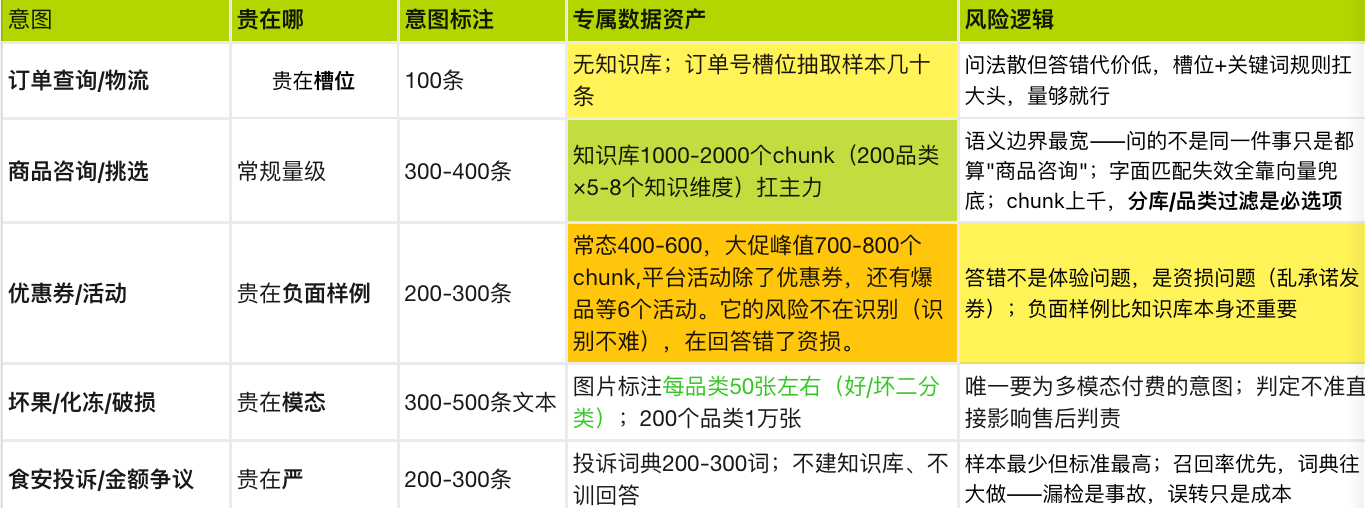
七、分类训练数据集
八、写在最后-选型问题
模型选型:不追求最先进,追求最够用
是每个环节在成本-延迟-准确率三角里选最靠近原点的那个解。能规则不模型,是因为规则在确定性任务上和模型一样准,但便宜三个数量级;能小模型不大模型,是因为小模型在你自己的数据上微调之后,在特定意图空间里不比大模型差,但快五十倍、便宜一百倍。大模型只用在最后 10%——那些真正需要强推理的模糊难题,那才是它该待的地方。
本文由 @Totoro畅 原创发布于人人都是产品经理,未经许可,禁止转载
题图来自 Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!