起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
诗词、字典、古籍:三个中文开源数据宝藏


中文互联网上有一批开发者,把散落在典籍里的诗词、字典与古籍整理成规整的 JSON 与 CSV。chinese-poetry、chinese-xinhua、daizhigev20 三个仓库覆盖全唐诗宋词、成语字典与 4.8GB 民间古籍,可直接当语料。
在数字技术日新月异的当下,中文互联网上的一批开发者,正悄然用工程代码为诗词、字典、古籍建立现代索引。
他们将散落在历代典籍里的辞章、字典与诗篇,化作干净规整的 JSON、CSV 和纯文本。这些项目没有复杂的算法炫技,却凭借极其扎实的基础数据整理,成为自然语言处理、古典文化应用以及当今各类大模型 Agent 背后不可或缺的基础。
无论你是古典文化的爱好者、数字人文学者,还是正在寻找中文优质语料的开发者,以下三个项目都值得常驻于你的收藏夹与硬盘之中。
01 chinese-poetry:把全唐诗宋词装进 JSON
项目地址:https://github.com/chinese-poetry/chinese-poetry
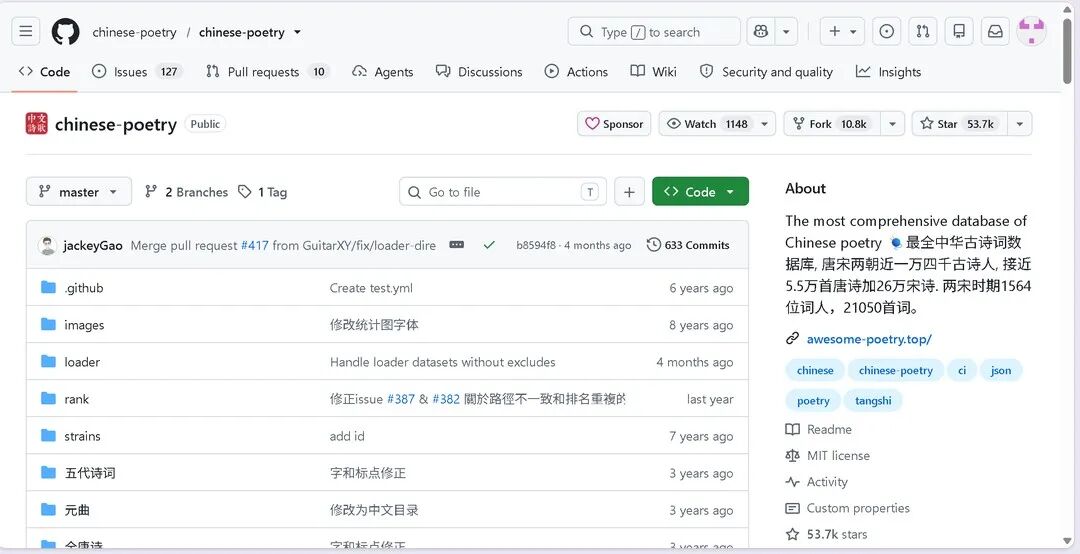
chinese-poetry 是一个收录多种中文古典诗词与文集数据的开源项目,该项目在 GitHub 上斩获了超过 5.3 万颗星标。
项目的初衷非常纯粹:通过现代技术将文集结构化为便于解析的 JSON 文件,消除古籍与现代代码之间的壁垒,降低开发者构建诗词类应用的门槛。
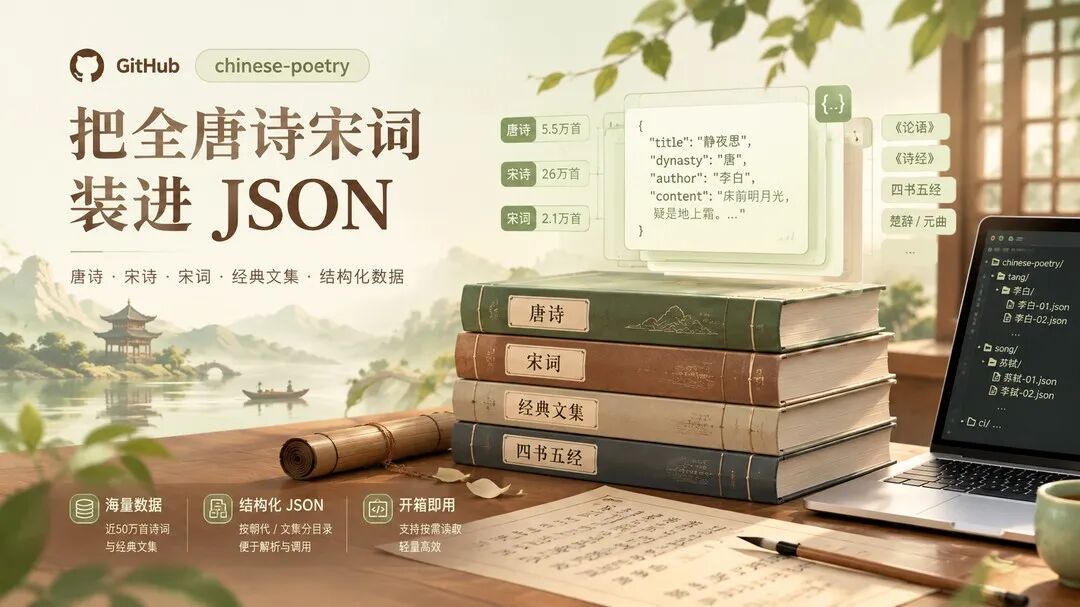
涵盖的数据矩阵:
- 诗词体量庞大。收录唐诗约 5.5 万首、宋诗约 26 万首,覆盖唐宋两代近 1.4 万位诗人;宋词收录 2.1 万余首,涉及 1564 位词人。
- 经典谱系齐全。除唐诗宋词外,仓库还系统收纳了《论语》《诗经》、四书五经、蒙学经典、明代小品文《幽梦影》、楚辞、元曲、五代《花间集》乃至纳兰性德词集等。
- 开箱即用的分卷组织。每个文集或朝代均设有独立目录,内部按作者或卷帙拆分为独立的小型 JSON 文件,兼顾了程序按需增量读取的效率与轻量化需求。
划重点
31.5 万首唐宋诗 + 2.1 万首宋词,加上从《论语》到纳兰词的完整经典谱系。一个仓库,就能撑起诗词类应用的整层数据。
02 chinese-xinhua:汉字、词语、成语与歇后语
项目地址:https://github.com/pwxcoo/chinese-xinhua
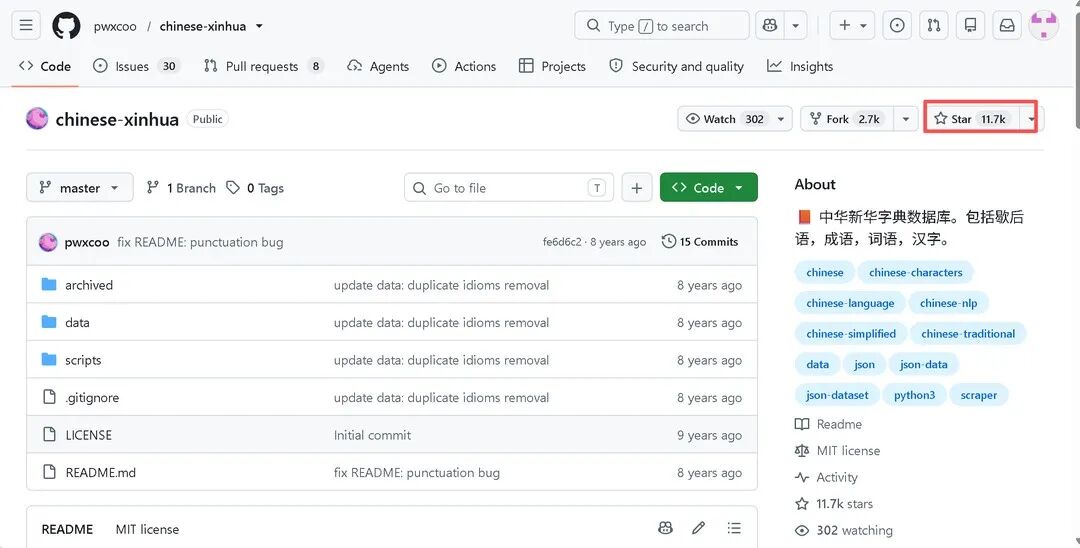
现代汉语自然语言处理的一大痛点,是基础词典的闭源与碎文化。chinese-xinhua 的起源颇为有趣:作者原本只打算做一款成语接龙小程序,因苦于找不到结构清晰且公开透明的基础词典数据库,便自行从各大公开站点抓取清洗,最终整理出这套极高人气的通用字典库。
该项目目前收获了 1.1 万 Star,已成为中文分词校验、文字游戏开发与汉语教学工具的经典基础设施。
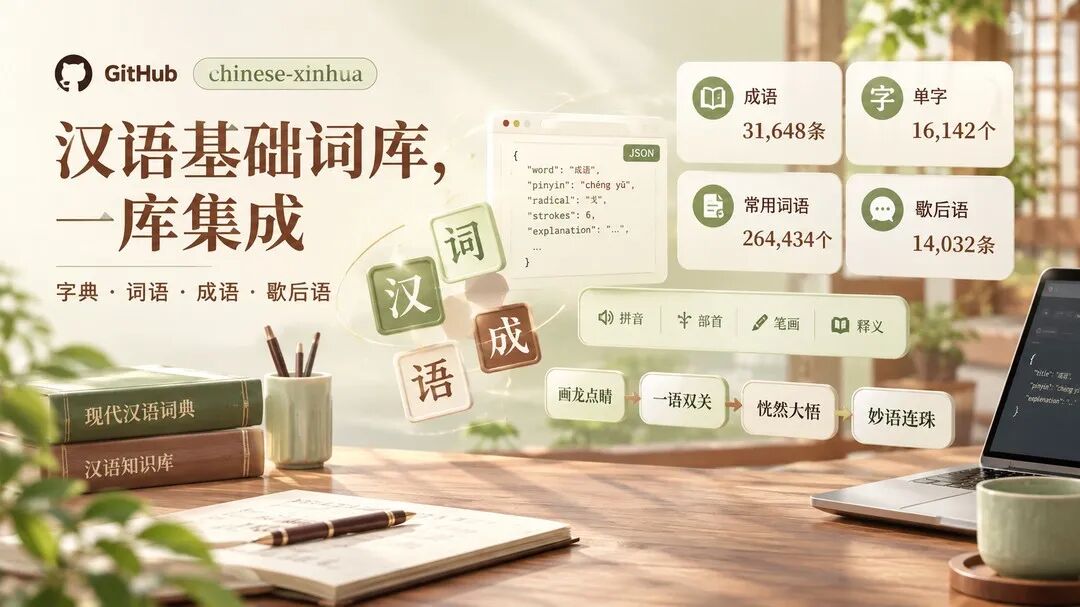
核心数据一览
所有数据均集中于 data/ 目录中,字段设计直观干练,极易导入各类数据库。
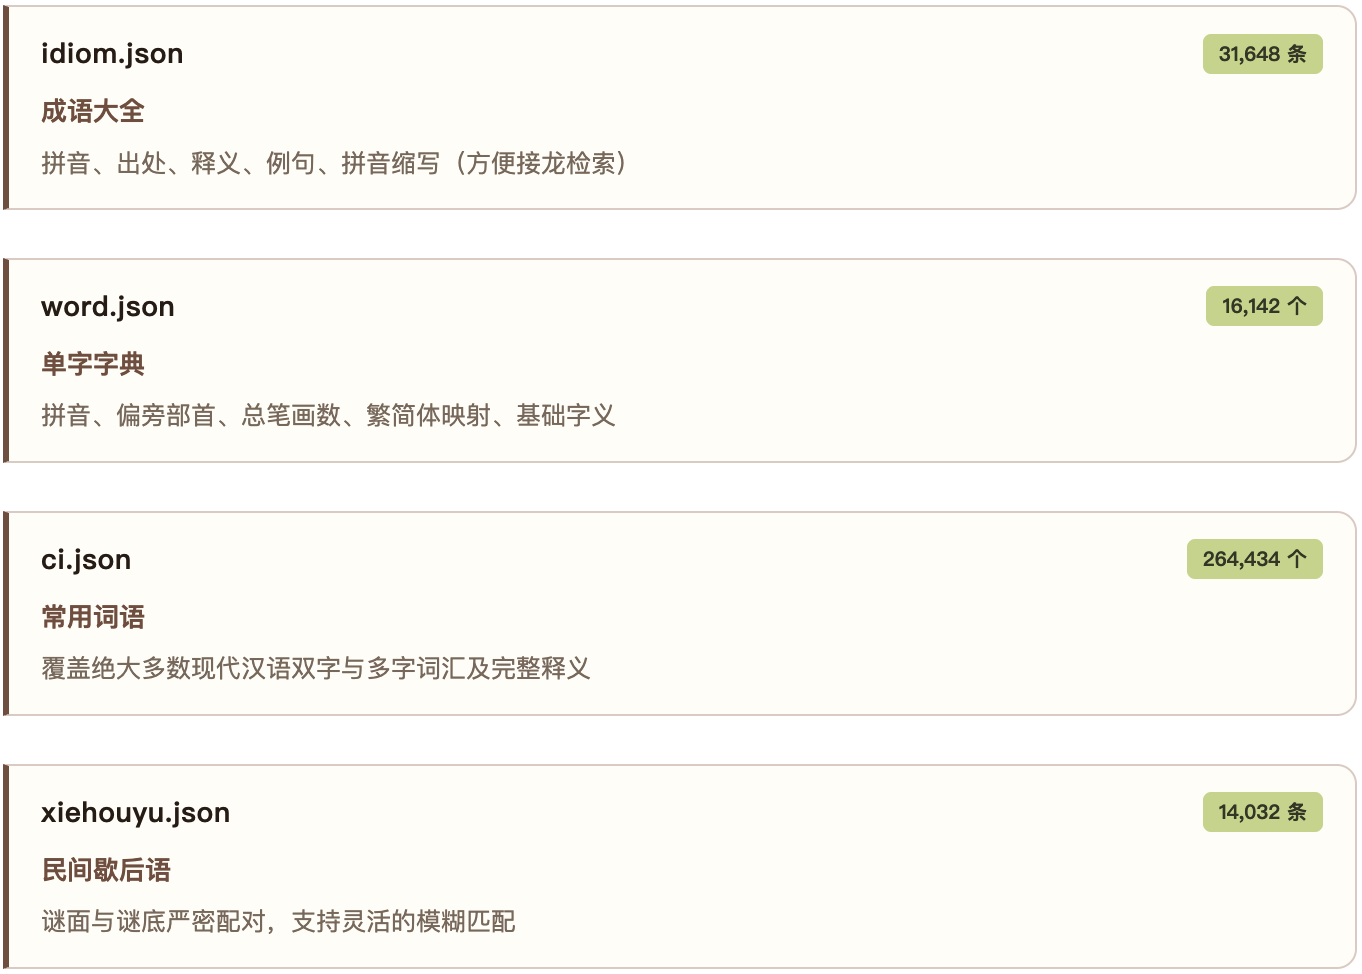
划重点
成语、单字、词语、歇后语四张表,合计 32.6 万条记录。文件字段直白,导入数据库即可使用。
03 daizhigev20:4.8GB 的民间数字古籍全库
项目地址:https://github.com/garychowcmu/daizhigev20
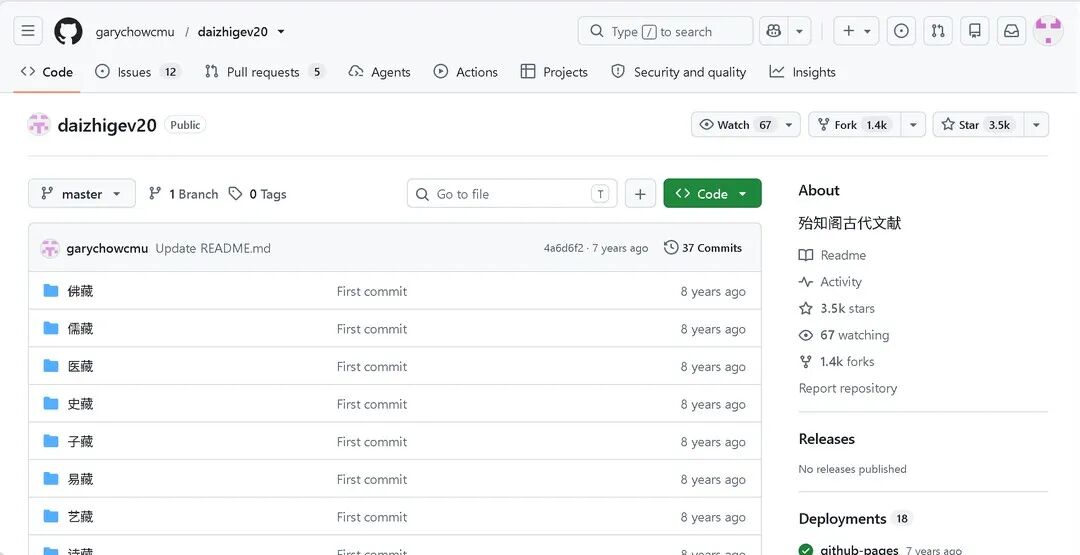
如果说前两个项目侧重于文人词章与基础文字,daizhigev20 则是名副其实的古典文献大海。
该项目的底本来自早期知名古籍整理项目「殆知阁」(取自「吾生也有涯,而知也无涯;以有涯随无涯,殆矣」)。在原独立站点历经变迁后,开源社区成员将其文本完整托管并持续维护。
整个项目全部采用原生 .txt 纯文本格式存储,解压后体积逼近 4.8GB,涵盖约 1.6 万种典籍、20 万卷、近 20 亿字。对于现代电子设备而言,一次性打开某些超大子卷甚至会短暂吃满内存,足见其厚重。
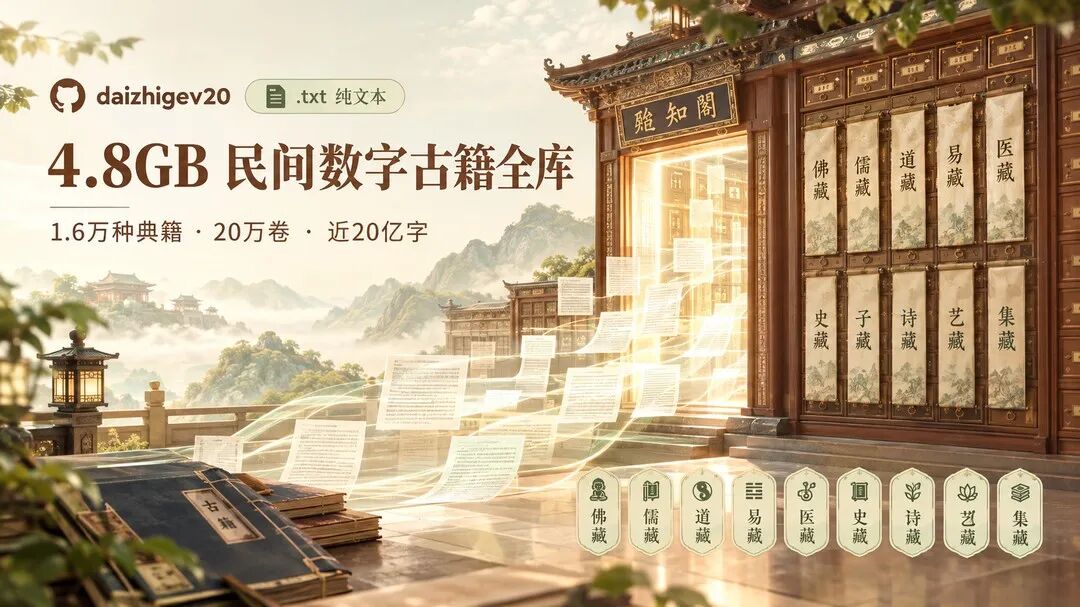
经史子集与十藏结构
不同于常规现代四部分类,项目参照传统丛书的十部类目进行了严谨归纳。
- 佛藏:大藏经诸品、历代高僧传、汉传与藏传佛学义理集
- 儒藏:十三经注疏、宋明理学语录、历代经解训诂著作
- 道藏:三洞四辅道教典籍、丹经科仪、内修养生诸书
- 易藏:历朝易象数理、卜筮占候与图说阐微专著
- 医藏:伤寒金匮、脉经本草、历朝名家医案与方剂全编
- 史藏:二十四史正史、野史杂史、起居注、职官制度与地理方志
- 子藏:先秦诸子百家、兵家谋略、农桑术数诸流派集评
- 诗藏:历朝诗话、总集汇编、选本及韵书专集
- 艺藏:书法画品、琴谱棋经、印学园冶等传统艺境珍本
- 集藏:汉魏六朝别集、唐宋明清文人全集与总集汇纂
划重点
1.6 万种典籍、20 万卷、近 20 亿字,纯文本存储。十部类目的归纳沿用了传统丛书的分类逻辑,检索时能顺着学术脉络定位。
04 如何获取这些宝藏数据
文史古籍具有超长周期的稳定性,数据一旦校准成型便无需频繁更新。大家可以通过以下两种方式将其落地至本地环境。以第一个项目为例。
方式一 终端克隆仓库
在终端中执行对应的克隆命令,将目标仓库同步至本地环境。
git clone https://github.com/chinese-poetry/chinese-poetry.git
若获取其他两个仓库,只需将其中的 URL 替换为相应的开源地址即可。
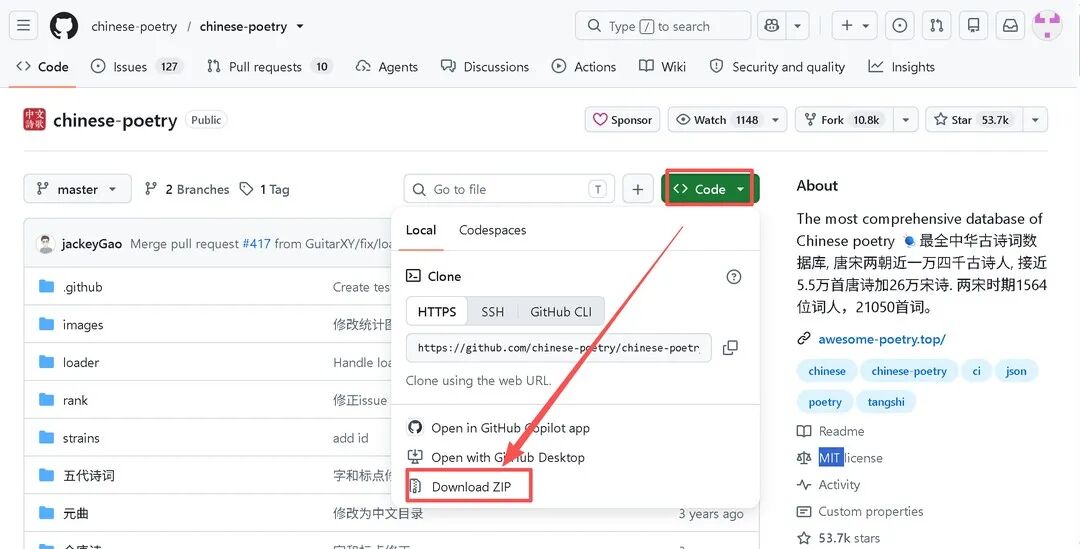
方式二 网页端打包下载源码
若本地未配置 Git 环境,访问对应的 GitHub 项目主页后,点击页面绿色的 Code 按钮,在下拉菜单中选择 Download ZIP,即可将全量数据压缩包直接下载到本地并解压。
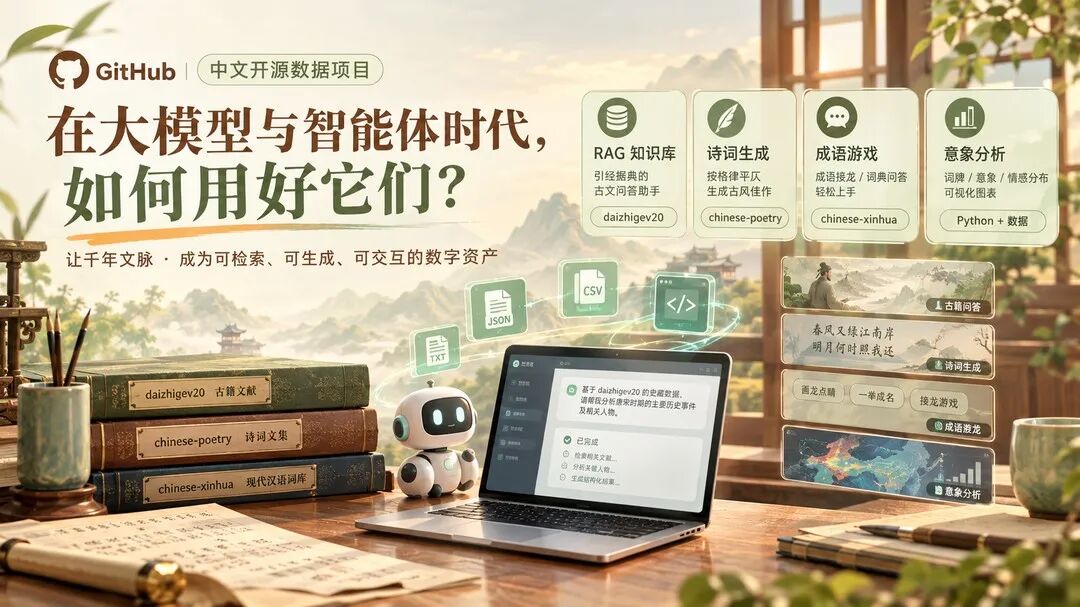
在大模型与智能体时代,如何用好它们
这些数据由结构化的 JSON、CSV 和纯文本构成,天然具备出色的解析友好度。随着大模型编程助手与 Agent 工具(如 Claude Code、Cursor、WorkBuddy)的普及,普通人也无需编写海量底层爬虫,只需向智能体明确输入提示词,即可快速实现如下高价值玩法。
- 搭建私人专属的「传统文化 RAG 知识库」。比如将 daizhigev20 中的医藏或史藏文本分块切片,结合向量检索,打造能引经据典、不胡说八道的古文问答助手。
- 构建高精度古典文学生成与文风评估器。利用 chinese-poetry 规整的格律、平仄与韵脚数据,让大模型在写古风诗词时摆脱「顺口溜」缺陷,严格按照平水韵或词牌格律生成作品。
- 开发轻量级语言交互应用。直接利用 chinese-xinhua 的成语缩写与释义字段,通过智能体快速搭出一套交互式成语接龙游戏或微信问答小程序。
- 数字人文的高频意象挖掘。借助 Python 脚本统计全宋词中各类词牌与高频意象(如「东风」「斜阳」「残月」)的情感分布,将千年前文人的幽微心境具象化为直观的可视化图表。
本文由人人都是产品经理作者【AI李子】,微信公众号:【AI李子】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!