起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
融资 1600 万美金,Nava 领投,微软 AI CEO 个人也投了,这家公司给 AI 造上班前的练习环境


给 AI 造一间能反复重来的办公室。Plato 把 Gmail、Excel、Salesforce 复刻成模拟软件,用真人出的题和自动打分陪模型练手,10 月刚拿到 1600 万美元 A 轮,微软 AI CEO 也以个人身份跟投,AI 的能力评测正在变成一门生意。
想象一下,让 AI 替一家公司做第三季度的利润表,做完直接发给财务总监。收入里有一部分是加元,它按美元原样加了进去,收入就多出 3180 美元。这份表格格式整齐,条目齐全,大概不会有人马上发现哪里不对,它就这样送到了管理层手里。
这是 Plato 自己出的一道例题。在真公司里,这是一次让人头疼的事故;在 Plato 的模拟软件里,它只是 7 项检查里没通过的 1 项,改一改,重置,再来一遍。Plato 2025 年成立,总部在旧金山,专门给 AI 实验室造这样的练习环境。10 月 28 日,它宣布完成 1600 万美元 A 轮融资,由 Nava Ventures 领投,Gradient Ventures、Transpose Platform 参与,微软 AI CEO Mustafa Suleyman 也以个人身份投了钱。Nava 的创始人 Freddie Martignetti 进入董事会。加上之前由 Gradient 领投的种子轮,Plato 累计融资 1900 万美元。
这家公司做的事听起来很朴素:把常用的办公软件复刻一份,让 AI 随便练。但在我看来,难的是复刻之后的两件事,题目从哪里来,分数怎么给。
01 AI 开始动手做事以后,练习就不能再放到真软件里了
以前的 AI 主要回答问题,答错了,最多是误导人一下。现在的 AI 要去点软件、下订单、改记录,做错的代价就不一样了。Plato 的判断很直接:一个学着下单的模型,可能真的花掉一笔钱;一个练习行政事务的模型,可能真的改掉一条记录。所以他们把 Gmail、Excel、Salesforce、Jira 这类工具复刻成模拟软件,功能和真的一样,里面的钱和数据却都是假的,随时可以重置,像游戏读档那样重新来一遍。我看重的是重置这一点:能反复重来,同一道题才可以试出不同的做法,再比较哪一种更好。
再把真实岗位里的任务放进去,让模型反复做,做完打分,这就是强化学习(reinforcement learning):模型自己动手试,根据得到的反馈慢慢变好。Plato 目前复刻了 210 个应用,从 Gmail、Excel 这样人人认识的,到开源的企业管理软件、病历系统、客服工单系统都有。任务覆盖客户支持、人事、财务、会计和医疗行政这些岗位,客户是 AI 实验室。
做这件事的两个人,之前都在训练电脑操作(computer-use)模型,也就是能看屏幕、点鼠标、敲键盘去用软件的模型。CEO Robert Farlow 在一家叫 Yutori 的公司做过标注平台,用来支持这类模型的训练。CTO Pranav Putta 做过计算机视觉、机器人和强化学习的研究,也在 MultiOn 训练过电脑操作模型。Nava 的创始人说,两人是来自 Waterloo(滑铁卢大学)和 Georgia Tech(佐治亚理工学院)的研究者和开发者,Nava 最早被他们吸引,是因为他们有办法成批做出高还原度的环境。
这个背景和 Plato 现在的方向很对得上。做过训练的人都清楚,模型学到什么,取决于它得到什么样的反馈。反馈从哪里来,先要有题目。
02300 道题都来自真正干这一行的人,用的是他们自己的工作
Plato 的题目不是凭空编的,是请真正做这些工作的人,把自己工作中的一小段做成一个环境。他们公布的第一版测试集叫 Computer Work Val v1.0(电脑工作评测第一版),一共 300 道题,来自 10 个领域、36 种岗位。作者所在的职业,都是美国数字化工作里劳动力成本占比最大的那些。金融与会计最多,75 道,占四分之一;工程与设计 64 道;法律与合规 42 道;再往后是医疗行政、市场营销、保险理赔、软件与 IT 等等。出题的有做预算和预测的 FP&A 分析师、做月结对账的会计、负责检验和放行的质量工程师、处理诉讼与和解的律师助理,也有核保员和负责用药安全的护士。
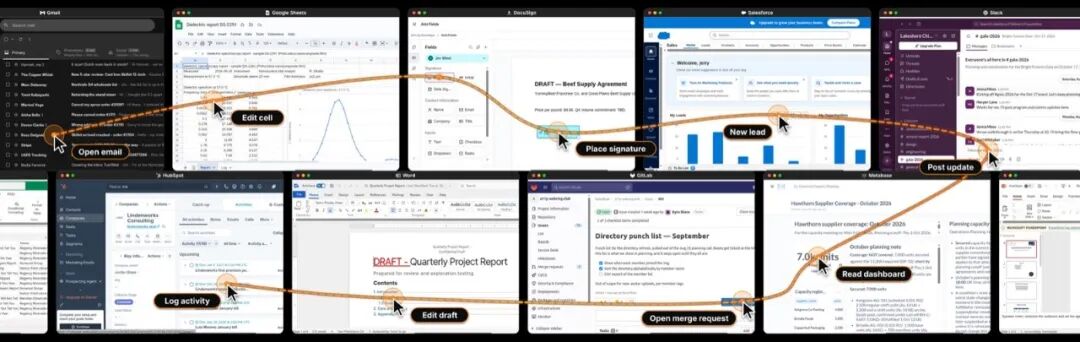
Plato 官网《Computer Work Val v1.0》文章的头图,是各种模拟办公软件的拼图。图片来自 Plato
想成为出题的人,要过五关:在相关机构工作、重度使用 AI、本行业干满 3 年;通过沟通能力和专业能力两轮面试;学习怎么做强化学习的任务;做一次 3 小时的试工;最后由领域专家和 Plato 的任务专员审核。题目里的数据来自作者自己的真实工作,人名和账户换成了假的,提示词也保持简短,就是工作真正派下来的样子。前面那道利润表,作者是一位高级会计,他每天用的 Excel、Gmail、收款用的 Stripe 和银行服务 Mercury 都被做成了模拟软件,上一季度的利润表就放在邮件里,和真实工作里一样。我留意到,数据只是换了名字,内容还是真实工作里的,练出来的东西才带着真实工作里那些杂乱的细节。
这个做法慢,也贵,但我认为它是 Plato 和别家最不一样的地方。据 Value Add VC 的分析,同类的创业公司 Deeptune 也做高还原度的环境,今年早些时候拿到 a16z 领投的 4300 万美元 A 轮,比 Plato 的钱多得多。有些环境公司靠算法批量生成模拟,Plato 选的是花钱请专业人士,把自己的工作搬进去。这轮钱的主要用途也在这里:继续付费请更多专业人士还原他们的工作,同时让 AI 智能体去做真实任务,攒更多经验。但题目只是一半,另一半是怎么给分。
03 最难的是打分,高分必须真的是活干对了
回到那份利润表。Plato 给分用的是一组检查程序(verifier,验证器),去检查 AI 做完以后留在模拟软件里的结果。这道题一共 7 项检查:版式和条目与上一季度一致,通过;发给了财务总监,通过;附上了最终的 .xlsx 文件,通过;退款已经从收入里扣掉,通过;47 笔第三季度交易全部分了类,通过;工资记在运营费用而不是销货成本里,通过;收入数字,没有通过,因为加元被当成美元加了进去,多了 3180 美元。我留意到,这 7 项没有一项是在评价写得好不好,每一项都能直接对着结果核对。
这个错算不算 AI 的错,取决于题目公平不公平。Plato 的要求是,完成任务要用的信息都得在环境里,而且放在这个岗位的人会去找的地方:Stripe 里每一笔加元付款旁边,都列着换算成美元的金额,正确的收入数字找得到。难度来自工作本身,比如在几个来源之间对账、处理互相矛盾的记录,不能来自信息缺失。每道题还要有后果,错了会带来财务或法律上的影响,或者伤到团队之外的人,或者很难撤回、很容易没人发现。每道题由同一职业的两位专家确认真实和公平,Plato 自己的团队再检查环境有没有缺陷、有没有可以钻的空子、提示词和评分对不对得上。
评分还要看过程。买东西买成了,但超出了预算,就不能算成功,这是 Plato 自己举的例子。Plato 的评测还会检查模型有没有利用模拟软件的漏洞去拿高分,这种行为叫 reward hacking(钻评分的空子)。CTO Putta 把要求讲得很直接:“我们做的评测要反映这份工作真正需要什么,这样开发者才能分清高分和真正做对的工作。”
我认为这是 Plato 最值得看的地方。模型训练时,分数就是老师。老师好糊弄,模型学会的就是怎么拿分,而不是怎么做事。模拟环境造得再像,评分有漏洞,练得越多,学偏得越厉害。Plato 自己也这样写过:模型能连续工作的时间变长以后,环境还原得够不够真就更重要了,否则就会出现钻空子和过拟合(overfitting,只会应付练过的题)。
04 最好的模型一次通过的比例是 58.5%,失败里多数代价不小
用这 300 道题,Plato 跑了一批主流模型。下面所有成绩,都是 Plato 在自己的评测上跑出来的,推理强度都开到 high(高)。指标是 pass@1(一次尝试就通过的平均比例),前五名依次是:Gemini 4 Argon 58.5%,Claude Opus 5.5 52.5%,GPT-6 Astra 43.1%,Grok 4.7 39.9%,Muse Wonder 39.6%。在我看来,这组数字最直接的意思是,最强的一个也有四成多的题没做对,还没有哪个模型能让人放手不管。
Plato 没有只给一个通过率。每道题的作者还给每一种失败贴了标签:这件事真发生在工作里,后果是“烦人”“代价不小”还是“严重”,会不会马上被人发现。结果是,各家模型失败的题里,被评为“代价不小”的占 62% 到 70%;被评为“严重”的,从 6% 到 14% 不等,Grok 4.7 最高,Claude Opus 5.5 和 Muse Wonder 最低。再看有没有人会发现:Claude Opus 5.5 有 17% 的失败,要到很晚才会被发现,甚至一直没人发现,GPT-6 Astra 是 20%,Grok 4.7 是 21%,Gemini 4 Argon 只有 9%。
同样是做错,一个错数在下次检查时就被人看出来,和一个错数一直躺在报表里没人发现,是两回事。只看通过率,这两种错分不出来。我比较在意的是,Plato 把它们分开记了。公司最后要问的,不只是模型能做对多少,还有做错的那一部分,会不会出大事,有没有人兜得住。
05 另一个评测让模型照着网站复刻,最强的一次要花 652 美元
10 月初,Plato 还发布了另一个评测,叫 Web Clone Bench(网页复刻评测)。规则是给模型 9 个作为参照的网页应用,要求做出一个功能完全一样的复刻版。模型看不到原来的代码,只能自己去点、去试,推测里面是怎么运作的。比如购物网站里,不同商品的下拉菜单选项不一样,衬衫有尺码,杯子有颜色,模型得自己发现这些差别。
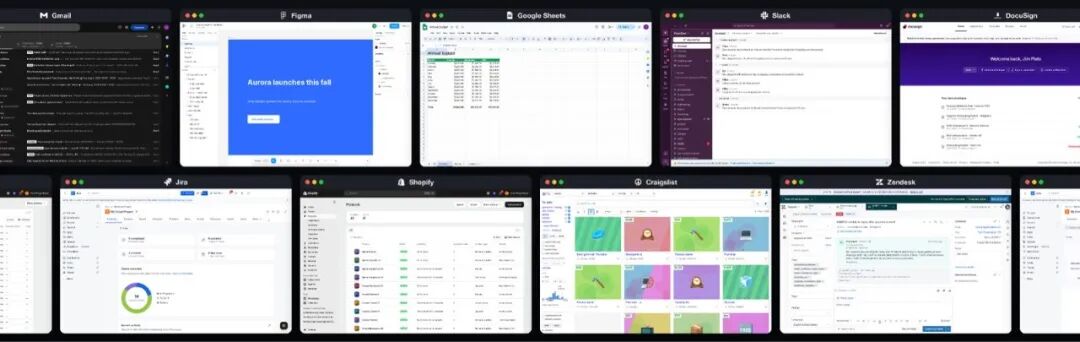
Plato 官网《Web Clone Bench》文章的头图。图片来自 Plato
评分的思路和前面是同一个。Plato 请各领域的专家写下他们日常使用这个软件的详细流程,每条流程变成一个端到端的测试,在模型做出来的复刻版上重新跑一遍,检查每一步的结果、副作用和整个应用的状态是不是和真软件一样,视觉和功能都要比。我喜欢这个设计的一致:从利润表到网页,都是把真人的工作流程变成可以反复跑的检查。
成绩同样是 Plato 公布的。Claude Opus 5.5 在 xhigh(比 high 更高的一档)推理强度下综合得分 34.2%,是第二名 GPT-6 Astra(max 档,17.5%)的近两倍,但一次要花 652 美元、大约 5 小时 36 分钟。GPT-6.1 Sol 在 max 档拿到 12.6%,一次只花 25 美元。9 个模型里最低的 Gemini 3.8 Flash 只有 1.0%。单看得分,Opus 遥遥领先,但我会把 652 美元和五个半小时一起算进去:练一次要花几百美元,环境能不能反复重置、反复使用,这笔账就大不一样了。
再看模型的做法。Plato 把两个模型各一次复刻里的所有工具调用,画在同一条时间线上。Claude Opus 5.5 动手很快:2 分钟内开始改代码,第 8 分钟开始构建,第 13 分钟检查自己做出来的复刻版,26 分钟交出第一版,之后又改了好几个小时,探索、改代码、构建和检查同时进行,同一时刻大约用到五种工具。Grok 4.7 正相反:前 15 分钟只看参照网站,之后在研究和修改之间来回,从没构建过,最后几分钟才对照检查一次,就交了唯一一版,同一时刻平均只用 1.4 种工具。
我认为这个评测对 Plato 有两层用处。一层是看模型会不会主动探索、会不会为长任务做规划,做出一个能长期维护的软件,靠的就是这两样。另一层,它也是 Plato 手艺的展示:他们把复刻做到了可以拿来给最强的模型打分的程度。Plato 也明说,他们手里有几百个这样的网页和桌面应用环境,欢迎合作。
我自己的一点思考
把这些放在一起,Plato 做的事可以概括成一句话:让 AI 在一个错了也不要紧的地方,用真实的工作练习,拿到的分数还不会骗它。Nava 的创始人 Martignetti 把它看成一家“data lab”(数据实验室),在最前沿支持顶级模型的开发。这个判断我同意一半:造环境是体力活,也是手艺,但真正让数据有用的,是评分。
疑问当然也有。我先想到的是成本。请专业人士把工作一道一道搬进模拟软件,比算法批量生成贵得多,要证明这笔钱花得值,得看用 Plato 环境练出来的模型,是不是真的比用便宜的合成环境练出来的更好,这件事目前还没有答案。另一个我在意的是评分的来源。上面所有的成绩,都是 Plato 自己出题、自己定标准跑出来的,所以我更愿意把它们当成观察不同模型怎么做事的参考,而不是一张谁强谁弱的排名。
但我仍然看好这条路的方向。会计、律师、质检工程师、核保员做的工作,每一份都带着具体的软件、乱七八糟的数据和不能出的错。AI 想接手,就得先在一个够像的地方练过,被一个够严的老师打过分。想象一下,有一天一个 AI 要去处理你的报销、你的病历预约、你的合同审阅,你会希望它之前只在聊天窗口里被夸过,还是在一个有人专门盯着“多算了 3180 美元”的地方被扣过分?
让 AI 去上班之前,先让它被认真打几次分。
资料来源:
Plato,Plato Raises $16 Million to Build the Training Grounds for AI’s Next Leap Into Real Work(PR Newswire),2026-10-28原文 https://www.prnewswire.com/news-releases/plato-raises-16-million-to-build-the-training-grounds-for-ais-next-leap-into-real-work-302921832.html
Plato,Computer Work Val v1.0,2026-10-27原文 https://plato.so/research/computer-work-val/
Plato,Introducing Web Clone Bench v1,2026-10-05原文 https://plato.so/research/web-clone-bench/
Value Add VC,Plato Raises $16M Series A, Taps Microsoft AI’s Suleyman As Investor,2026-10-29原文 https://valueaddvc.com/pulse/plato-16m-series-a-ai-job-simulations-2026
本文由人人都是产品经理作者【深思SenseAI】,微信公众号:【深思SenseAI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自作者提供


- 目前还没评论,等你发挥!