起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
缺少上下文层,Agent啥也不是


企业里的 Agent 产品越来越多,真正落地有用的却很少,作者把根源归到缺少上下文层,读懂业务的素材都藏在上下文层里。文章拆出数据要 AI Ready、上下文要 Agent Ready 两级,并列出统一口径、降低幻觉、权限内嵌等十项好处。
现在的企服市场,Agent产品越来越多,但真正落地有用的很少。根源就一点:它们不理解你的业务、生意逻辑,还有长期积累下来的工作习惯。
为什么会这样?原因也只有一个:缺少上下文的支撑。换句话说,支撑它读懂业务的全部素材,都藏在上下文层。
而我们把所有希望,都寄托在LLM上。总以为更好的模型,就能产生更好的Agent。
但其实,表现强大的Agent,跟LLM的关系并不大。
如果这样说还太抽象,那我们可以具体看看:一次行动,从Agent到LLM,期间究竟发生了什么。
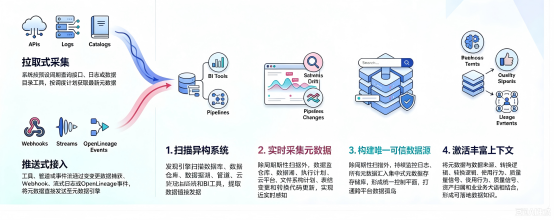
首先,是数据的AI Ready:
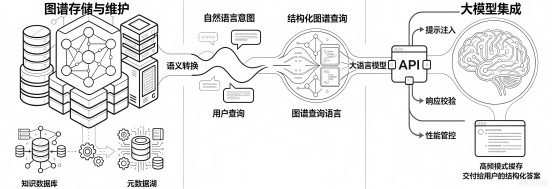
其次,是上下文的Agent Ready:
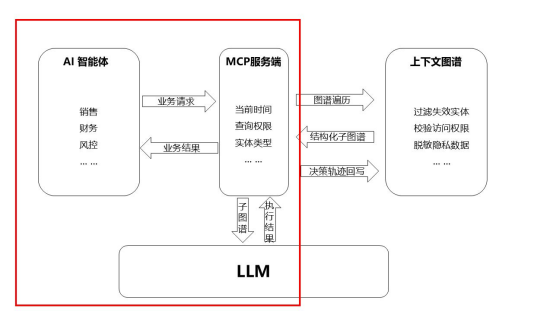
最后,才是你看到的那一小部分(红框部分):
之所以需要业务数据层和上下文层,有十大好处:
1.消除业务术语歧义,统一口径
不同部门对同一指标往往存在多种定义。
上下文层承载经过认证的业务本体、术语词典,AI和业务人员可以拿到统一权威释义,避免同一指标在不同场景下计算结果不一致。
2.降低AI幻觉,增强结论可追溯
上下文层提供数据来源、血缘、质量标记、负责人信息。
AI在推理时可以判断数据是否可信,输出结果附带溯源链路,一旦出现问题可以定位原始数据与业务假设,减少无依据的臆断。
3.运行时按需供给上下文,减少Token浪费
不再把全部文档一次性塞进提示词。
AI在执行任务的过程中动态检索所需业务信息,只拉取当前任务相关的元数据、规则与状态,降低推理成本,支撑更长、多步骤的业务工作流。
4.治理与权限内嵌,实现可控的AI执行
访问策略、数据分级、合规规则托管在上下文层。
AI发起查询前,上下文层自动校验权限,过滤不可访问数据,把治理能力嵌入AI执行链路,而不是事后审计。
5.隔离业务知识与模型,提升架构可维护性
业务定义、资产关系、业务规则统一放在上下文层,不硬编码到Prompt或模型内部。
当表结构、业务口径变更时,只更新上下文层,不需要重训模型、改写大量提示词,规模化维护成本更低。
6.沉淀组织记忆,把隐性知识转为机器可读资产
把专家经验、历史决策、人工修正、过往结论持续存入上下文层。
多次任务执行形成反馈闭环,后续同类任务可以复用历史经验,降低对少数资深人员的依赖。
7.打通异构系统,提供统一查询入口
企业分散在数据库、数据管道、报表平台的资产关系被整合为统一知识图谱。
AI不需要对接数十套独立系统,通过统一接口获取技术元数据、业务语义、资产关联关系。
8.支撑长会话、跨会话的任务连续性
上下文层持久保存任务状态、历史交互记录。长时间中断的业务流程可以恢复现场,智能体记得任务进度、前置约束,不用用户反复复述背景信息。
9.统一人类与AI的认知底座
业务人员、数据分析师、AI智能体共享同一套资产与业务语义。人和AI基于相同的事实体系沟通,减少人机理解错位。
10.开发第N个Agent,要比第一个更容易
上下文层作为共享语义底座,新增Agent可直接复用已有的术语、数据资产、权限与业务规则。
无需从零开始,新增Agent的开发周期大幅缩短,落地门槛持续下降。
现在,做一个Agent非常容易,但如果没有上下文层支持,直连LLM,那结果只能是个Agent Demo。
这就像是在半空中盖楼,根本立不住。放在业务场景下,啥也不是。
作者 | ToBeSaaS
本文由人人都是产品经理作者【ToBeSaaS】,微信公众号:【ToBeSaaS】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。

- 目前还没评论,等你发挥!