
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
我所了解的机器视觉检测产品应用(6):深度学习还是传统算法?先别比准确率,算三笔账


面对客户对深度学习样本和接手问题的担忧,本文从产品视角出发,通过数据、周期、接手三笔账,深入剖析传统机器视觉与深度学习的选型逻辑。八成项目混着用,但谁当主力、谁跑龙套,每个项目都不一样。PM的价值不是替客户选,而是把技术选择题翻译成客户答得上来的业务问题。
去年有家做精密结构件的客户来公司考察。技术总监看完整场演示,问的第一个问题是:“你们这套用了深度学习吧?”销售说是,他点头。可参观快结束的时候,他又折回来,压低了声音问:“有没有不依赖深度学习的版本?”
销售没接住,回来问我:这客户到底想要什么。
我听懂了。
他不是反对深度学习,他在担心两件事:一是样本——缺陷图要攒多少、谁来标;二是接手——设备上了产线,半年后模型不对劲了,谁管。两个担心都不在“准确率”上,在账上。
这个系列写到第六篇,选型阶段被问得最多的就是这道选择题。这篇把它摊开算。不比谁更先进,只算三笔账:数据的账、周期的账、客户接不接得住的账。结论先放这儿:三笔账算完,八成项目的答案是“都要”,但谁当主力、谁跑龙套,每个项目都不一样。
一、先把两种算法翻译成产品语言
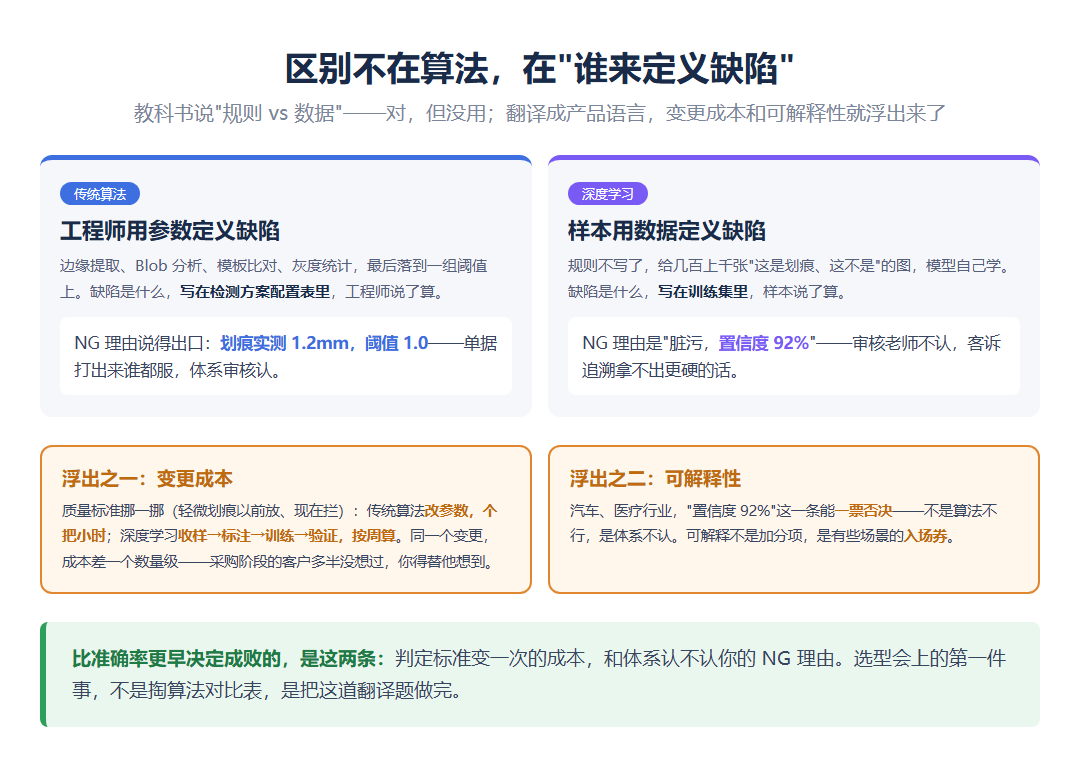
教科书说,传统机器视觉基于规则,深度学习基于数据。这话对,但没用。我自己的翻译就一句话:区别不在算法,在“谁来定义缺陷”。
传统算法,工程师用参数定义缺陷。边缘提取、Blob 分析、模板比对、灰度统计,最后落到一组阈值上:划痕超过多少毫米算 NG,脏污面积超过多少像素算 NG。缺陷是什么,写在检测方案的配置表里,工程师说了算。
深度学习,数据用样本定义缺陷。规则不写了,给几百上千张“这是划痕、这不是”的图,模型自己学。缺陷是什么,写在训练集里,样本说了算。
这么一翻译,两个很实际的东西就浮出来了。
第一个是变更成本。客户质量部把标准挪一挪——“轻微划痕以前放行,现在要拦”——传统算法是工程师改参数,个把小时的事;深度学习是重新收样本、重新标注、重新训练、重新验证,一轮下来按周算。同一个变更,成本差一个数量级。这一点,客户在采购阶段多半没想过,你得替他想到。
第二个是可解释性。传统算法拦下一件产品,理由说得出口:划痕实测 1.2 毫米,阈值 1.0,NG,单据打出来谁都服。深度学习拦下来,理由是“模型判定脏污,置信度 92%”。92% 是什么?质量体系审核的老师不认,客诉追溯的时候你也拿不出更硬的话。汽车、医疗这类行业,这一条能一票否决——不是算法不行,是体系不认。
二、第一笔账:数据从哪来,够不够
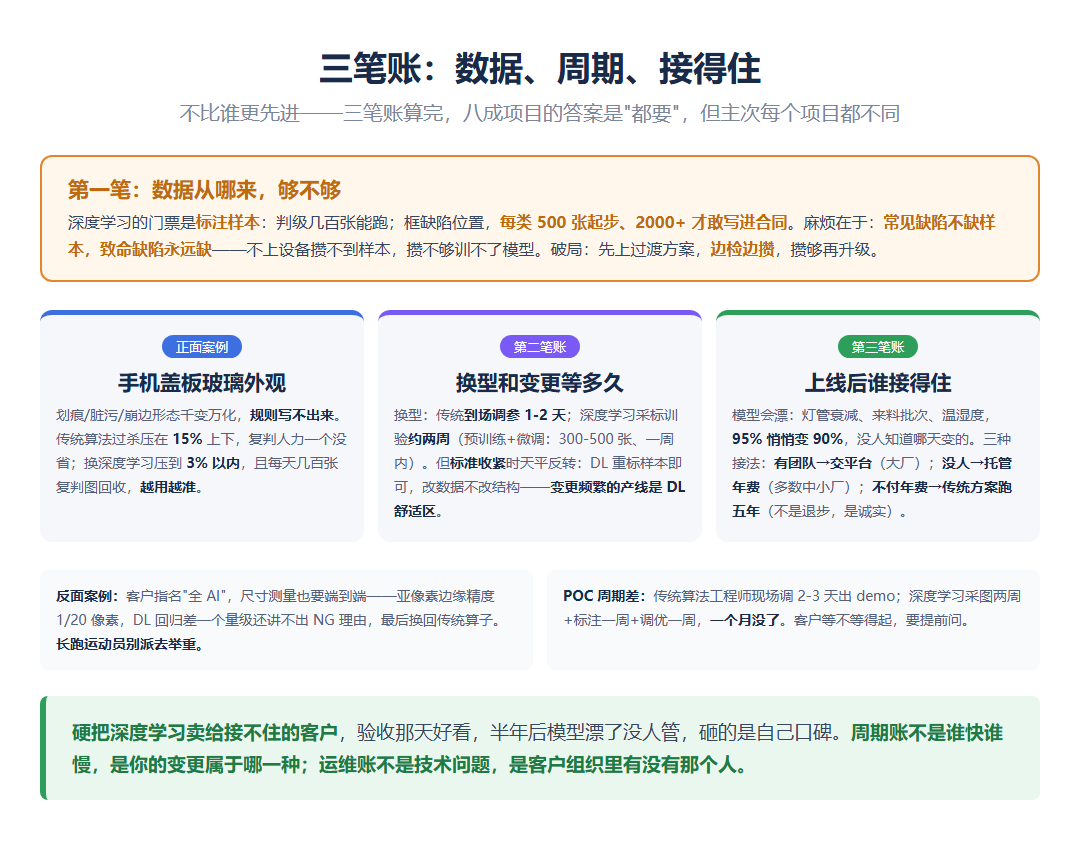
深度学习的门票是标注样本,这张票不便宜。我的经验值:只做 OK/NG 判级,几百张能跑起来;要框出缺陷位置和类型,每个类型 500 张起步,2000 张以上才敢往合同指标里写。
麻烦在于,常见缺陷不缺样本,致命缺陷永远缺样本。脏污、轻微划痕天天有,一个月攒几千张;可最容易流出去、赔得最狠的那种罕见缺陷,一个月就几张。攒一年,不够训一个稳的类别。而客户上设备的动机,常常就是冲着那个罕见缺陷来的。先有鸡还是先有蛋:不上设备,攒不到样本;攒不够样本,训不了模型。
破局的办法有,就是别把话说死:先上传统算法或者人机结合的过渡版本,边检边攒,攒够了再升级。这个节奏要写进方案里——销售不会自动替你讲。
传统算法不吃样本,吃工程师时间。POC 阶段的差距很直观:传统算法,工程师带着工具到现场,对着产线调两三天,demo 就出来了;深度学习,采图两周、标注一周、训练调优一周,一个月没了。客户等不等得起,要提前问。
说两个我都经手过的场景。
正面的是手机盖板玻璃的外观检测。划痕、脏污、崩边,形态千变万化,同一类缺陷在反光、纹理、位置干扰下长得都不一样——判定规则根本写不出来。传统算法怎么调,过杀率都压在 15% 上下,复判人力一个没省。换深度学习,过杀压到 3% 以内。而且这种场景样本源源不断:每天几百张复判图回收,模型越用越准——上一篇讲的训练集回收,就是给这种场景准备的。规则写不出来、样本管够的,深度学习完胜。
反面的是个想“一步到位”的客户,指名要全 AI 方案,连尺寸测量也要深度学习端到端做。结果呢?像素当量标定加亚像素边缘算法,测量精度能做到二十分之一像素;深度学习回归尺寸,精度差一个量级,还讲不出 NG 理由。最后乖乖换回传统算子。这不怪深度学习,是把长跑运动员派去举重。
三、第二笔账:换型和变更,等多久
产线不是静态的,这笔账要看变更的频率。
换型,传统算法是工程师到场重新调参,一到两天;深度学习是新样本重新采集、标注、训练、验证,顺利的话两周。客户一年换四次型,差距乘以四,就是产线干等的时数。
解法我总结成两个。技术上的:预训练模型加少量微调,换型时 300 到 500 张新样本做增量训练,一周内交付。机制上的:把“换型要重新标数据”这件事在交付那天就讲明白,并且给工具——标注界面、待标图片的智能排序,模型最没把握的图排在最前面,标三百张顶一千张。千万别让客户在第二次换型时才发现“原来还要标数据”,那是信任塌方的时刻。
不过有一类变更,天平倒向另一边:客户自己收紧质量标准。传统算法碰到规则级的修改,有时要推倒重来;深度学习把样本按新标准重标一遍、重新训练就行——改的是数据,不是结构。判定标准三天两头变的产线,反而是深度学习的舒适区。
所以周期的账不是谁快谁慢,是你的产线变更属于哪一种。
四、第三笔账:上线之后,谁接得住
这笔账最容易被跳过,因为爆雷在验收之后。
深度学习模型会漂。灯管衰减、来料批次变化、季节温湿度,都会让图像分布慢慢挪位。半年前验收 95% 的准确率,悄悄变成 90%,没人说得清是哪天变的。接住漂移要一套机制:样本库持续回收、定期离线评估、按季度迭代训练。机制要有人盯。那么问题来了:客户的设备科,有没有这样的人?
我经手的项目,落地就三种接法。
客户有自动化团队——设备加平台一起交付,客户自己的工程师管迭代。汽车零部件大厂常见,中小厂基本没这个配置。
客户没人——托管服务,按年收服务费,我们远程盯评估报告、按期出迭代版本。大部分中小制造厂的现实选择。注意,这意味着深度学习的商业模式里天然有一笔年费,签单前要讲清楚。
客户没人、也不想付年费——那就老老实实传统算法。把机械结构、光源、触发时序做扎实,一套传统方案跑五年不漂。这不是退步,是诚实。
硬把深度学习卖给接不住的客户,验收那天大家都好看。半年后模型漂了没人管,复判人力反弹,设备在客户内部被判“不好用”,传到行业圈子里,砸的是自己的口碑。
五、真实答案:八成项目是混着用
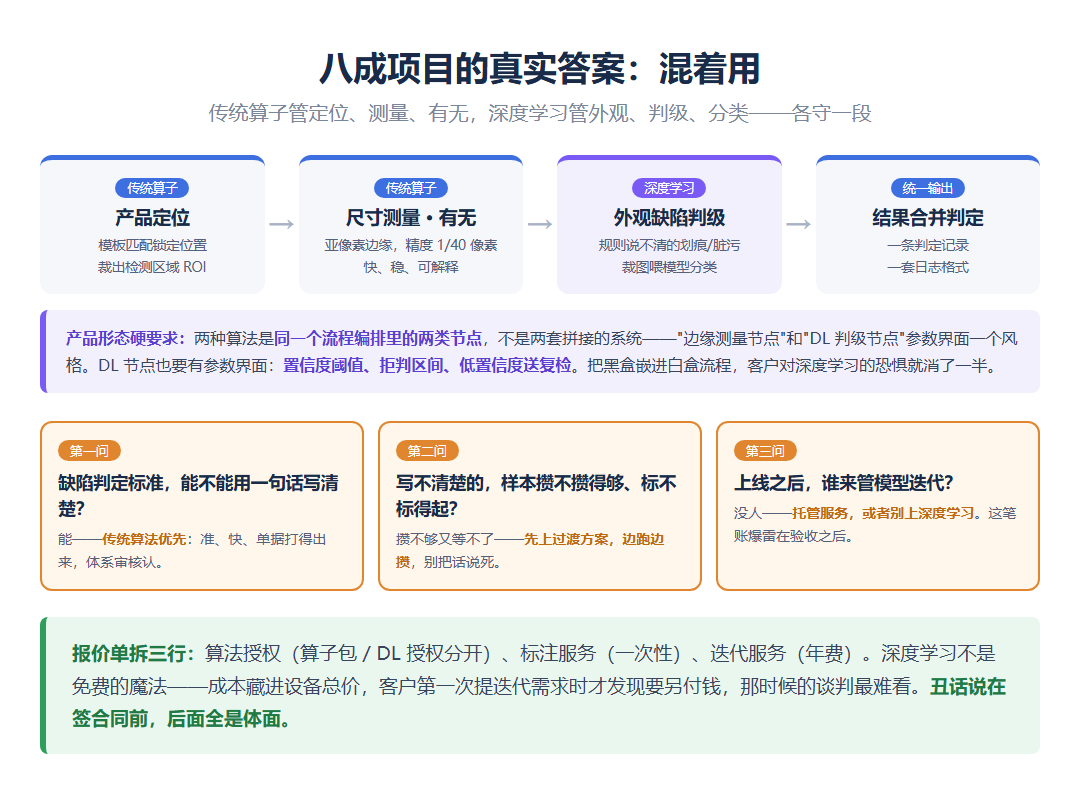
写到这儿别误会,实践中这道题很少是二选一。八成项目的主流架构是混合:传统算子管定位、测量、有无,深度学习管外观、判级、分类。
一条典型的检测流水线长这样:传统算法定位产品、裁出检测区域;传统算法完成尺寸测量和有无判断;外观那块裁图喂给深度学习模型分类判级;最后结果合并,统一输出判定。深度学习只出现在它该出现的那一段,前后都有传统算子把守。
道理不复杂:定位和测量要精度、速度和可解释,模板匹配和亚像素边缘稳;外观缺陷要的是“规则说不清、看得多了就认识”,这恰好是深度学习唯一不可替代的长处。
这对检测软件的产品形态是个硬要求:两种算法必须是同一个流程编排里的两类节点,不是两套拼接的系统。客户配方案时,拖出来的是“边缘测量节点”和“DL 判级节点”,参数界面一个风格,日志输出一个格式。深度学习节点也得有参数界面:置信度阈值、拒判区间、低置信度送复检的规则。说白了,把黑盒嵌进白盒流程里,配置体验和一个滤波器一致——做到这一步,客户对深度学习的恐惧就消了一半。
六、PM 的动作:把选择题翻译成三个问题,把报价单拆开
回到开头那位考察的客户。销售把问题带回来之后,我们做的第一件事不是回答“用不用深度学习”,是回给客户一张三个问题的清单:
第一问,你的缺陷判定标准,能不能用一句话写清楚?能,传统算法优先——准、快、可解释。
第二问,写不清楚的,样本攒不攒得够、标不标得起?攒不够又等不了,先上过渡方案,边跑边攒。
第三问,上线之后谁来管模型迭代?没人,要么托管服务,要么别上深度学习。
三个问题客户都答得上来,答案拼一起,选型自己就出来了。这套问法不是我发明的,是被客户教育出来的——早年我拿着算法对比表去讲,客户听完只记住了“深度学习更先进”,单子最后卡在“再研究研究”。后来换了打法,先问这三句,会议反而好开了。PM 在这道题里的价值,不是替客户选,是把技术选择题翻译成客户答得上来的业务问题。
还有件小事,影响很长远:报价单拆开列。算法授权,传统算子包和深度学习授权分开;标注服务,一次性;迭代服务,年费。三行分开写。深度学习不是免费的魔法,你要是把它的成本藏进设备总价,客户第一次提迭代需求时才发现“原来还要另付钱”,那时候的谈判最难看。丑话说在签合同前,后面全是体面。
下一篇,我想把第二笔账里埋的线头抽出来展开:标注数据管理的产品设计——样本库怎么建、版本怎么冻结、训练集怎么划、客户自己标注的门槛怎么降到质检员能上手。上篇有读者留言问训练集 7:2:1 的门道,正好接着说。如果你正在“上不上深度学习”的节点上,评论区说说你的场景,我帮你把三笔账粗算一遍。
(系列前篇:《我所了解的机器视觉检测产品应用(4):把算子做成产品,参数、公差、复检逻辑怎么设计》《(5):检测数据反哺制造端,从判级工具到数据资产》)
专栏作家
互联网产品经理Mik,公众号:逆袭产品汪,人人都是产品经理专栏作家。专注于ToB领域产品,包括机器视觉、工业大数据、MES、ERP和物联网等方面。
本文原创发布于人人都是产品经理,未经许可,禁止转载
题图来自 Unsplash,基于 CC0 协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。


- 目前还没评论,等你发挥!