起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
月之暗面发布Kimi K3.1 Pro。这把超Astra了?


Kimi K3.1 Pro 建在 7 月发布的 K3 之后,通过后训练提升代码、3D 创作、金融、幻觉控制和网络安全能力。本文中的分数主要来自模型方公布的 Benchmark,个人案例只代表特定提示词和工具链下的结果,选型还得用自己的仓库复验。

Kimi K3.1 Pro 建立在 7 月发布的 K3 之后,通过后训练提升代码、3D 创作、金融、幻觉控制和网络安全相关能力。最吸引开发者的并不是“又多了一个旗舰模型”,而是它把代码 Agent、专业文档分析和可交付的创作结果放进同一条能力链路:能在终端任务里执行、能读跨文档数据、也能通过脚本驱动 Blender 和 CAD 等工具。
本文中的分数主要来自模型方公布的 Benchmark,个人案例只代表特定提示词、特定样例和特定工具链下的结果。选模型时,应把官方成绩当作候选信号,再用自己的仓库、业务文档和交付标准做复验。
代码:Terminal Bench 分数之外,还要看单位任务成本
Kimi K3.1 Pro 在 Terminal Bench 4.0 上的分数为 65.7。这个基准关注模型在终端环境中完成真实软件工程任务的能力,例如理解仓库、修改文件、运行命令、调试问题和验证结果。按照公布的对比,它在该项任务上超过 GPT-6 Astra,但仍低于 Opus 5.5。
单个跑分很难覆盖所有编码场景。Terminal Bench 更接近具有工具调用的完整工程任务,而前端视觉还原、跨仓库重构、测试修复、基础设施排障和代码审查,分别会对上下文、工具选择、规划与验证能力提出不同要求。
这次更新还强调了单位任务成本。低价并不等于低账单,真正影响使用成本的是:完成一个任务需要多少输入输出 Token、调用多少轮工具、是否反复重试、子 Agent 是否过度展开,以及失败后是否需要人工返工。
建议团队对模型建立自己的任务账本:
| 指标 | 要记录的内容 |
|---|---|
| 首次成功率 | 一次提交后测试、构建或验收通过的比例 |
| 端到端耗时 | 从任务发起到产物可交付的总时间 |
| Token 与工具轮数 | 输入、输出、检索、命令和浏览器操作的消耗 |
| 人工返工 | 需要人工补充需求、修复或回滚的次数 |
| 单任务成本 | 真实费用,不只看每百万 Token 报价 |
只有把这些指标放在一起,才能判断模型是真的更高效,还是只是把计算成本从某个环节挪到了另一个环节。
3D 建模:从生成回答到编写专业工具脚本
Kimi K3.1 Pro 在 3D 创作和空间推理上强化明显。Bench CAD 的工具使用条件下得分为 92.7,低于 GPT-6 Astra 的 95.9 和 Opus 5.5 的 96.2,但已是开源模型中的高分表现。
重点不在于模型是否“会画 3D”,而是它可以编写 Blender、CAD 等专业工具的脚本,操控布局、材质和几何元素。这样的工作流比直接输出一段描述更接近真实生产:模型生成或修改脚本,工具执行脚本,用户在建模软件中检查结果,再把错误和改动要求反馈给模型。
3D Make 已在 Kimi 官网和 App 中上线,提供在线预览、编辑、模型下载、3D 打印和视频或 Live Photo 导出。对于真正要交付的资产,还应该额外检查:网格面数、材质贴图、单位与尺度、法线、打印可行性、导出格式和授权来源。一个视觉上可看的模型,不必然是可编辑、可打印或可进入游戏引擎的资产。
金融文档分析:能力强弱,取决于证据链是否完整
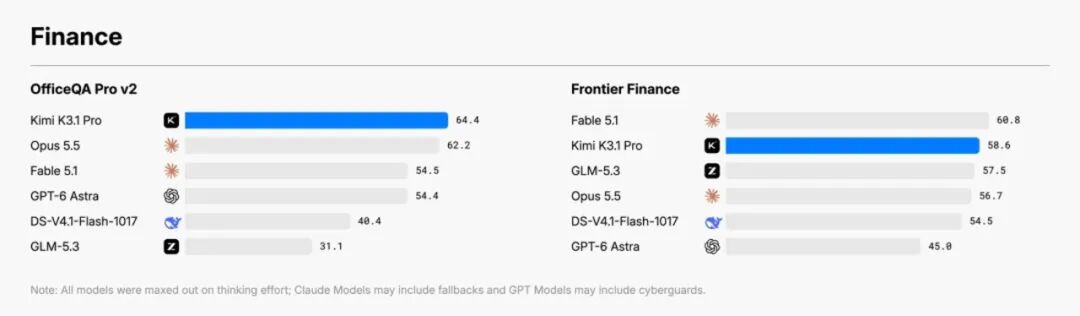
OfficeQA Pro v2 考察真实金融文档中的复杂数据分析,需要检索、跨文档核对和多步数值推理。Kimi K3.1 Pro 在该基准上为 64.4 分。Frontier Finance 覆盖从标的筛选到盈利分析等完整投资工作流,K3.1 Pro 得分 58.6,较前一版本提升明显。
对金融工作流来说,模型分数并不能替代可审计性。一个可靠的分析结果应该能回到原始文档:每个数字来自哪份材料、对应哪个期间、使用什么口径、经过什么计算、哪些地方是模型假设。若模型只给出一段流畅结论,却无法展示来源和公式,即使推理看起来合理,也不适合作为最终决策依据。
可以用以下结构要求模型输出:
事实:原文档中的字段、页码、时间与数值 计算:公式、单位、汇率、四舍五入规则 假设:情景参数与未确认条件 结论:在当前证据和假设下成立的判断 风险:缺失数据、口径冲突、需要人工复核项
幻觉率下降,仍不等于可以取消复核
在内部压力测试 Kimi Hallu Bench Hard 中,K3.1 Pro 的错误率从上一代的 23.4% 降至 8.3%。这是一个积极信号,但它属于模型方的内部基准,不能直接外推到所有行业、语言、提示词和工具调用场景。
模型更少编造,不代表它更擅长发现自己不知道什么。高风险场景仍要保留来源引用、检索范围、置信标记、反例检查和人工审批。工程团队应该用自己的文档和历史错误建立 Eval 集,而不是把某个整体幻觉率当作上线许可。
网络安全:能力评测必须和使用边界一起看
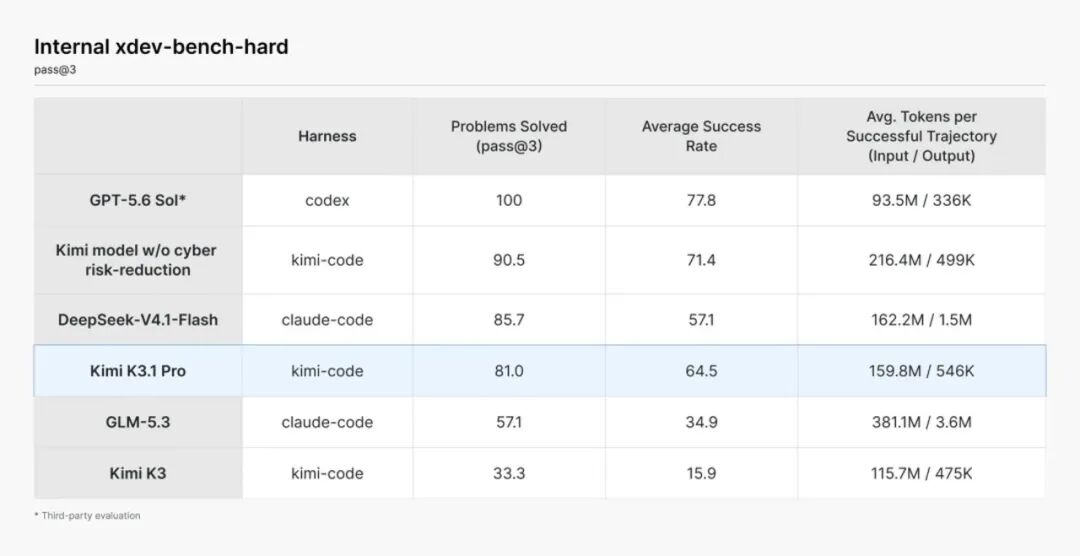
Kimi K3.1 Pro 的网络安全能力在自建 Benchmark 中得分 81。模型方同时说明,其网络攻防能力仍落后于已经公开至少三个月的前沿闭源模型。
对安全团队而言,模型可以用于漏洞说明归类、日志初筛、代码审查辅助和防御规则草案,但必须在隔离环境中运行,不能默认拥有生产密钥、外网扫描权限或自动执行能力。评测越高,越需要清晰的工具权限和日志审计,避免把能力提升直接转换成更大的操作风险。
价格与接入:要把模型单价换算成任务预算
Kimi K3.1 Pro 可在 Kimi 官网、Kimi Code 和 Kimi Work 使用。API 定价为每百万 Token 输入 13 元(未命中缓存)、1.3 元(命中缓存),输出 68 元。高速版本的输出速度约为标准版本的 2 至 3 倍,价格为标准版本的 2 倍。
定价本身只是预算模型的一个变量。输出 Token 往往比输入更贵,长链路 Agent 还会受到工具调用、重试和上下文重复注入的影响。实际接入时,可以给不同任务设置不同策略:
- 高并发检索或分类任务优先压缩输出与上下文;
- 代码修复任务限制最大工具轮数并要求测试通过;
- 财务和文档分析任务保留来源与中间计算;
- 3D 或前端生成任务将生成、运行、截图和修复分成独立步骤。
模型升级后,先跑一组稳定的基准任务,再决定是否扩大流量。不要把“输入更便宜”当作“复杂 Agent 更便宜”,也不要把“跑分更高”当作“业务事故更少”。
几个创作案例,应该怎样正确解读
个人体验中,Kimi K3.1 Pro 被用于生成老式新闻播报风格视频、按参考图用 SVG 复刻小米 SU7、用 p5.brush.js 画鱼,以及制作上海风景体素艺术。这些案例能观察模型对代码创作、视觉还原和迭代修改的能力,但每个案例都高度依赖提示词、参考图、运行环境和人工筛选。
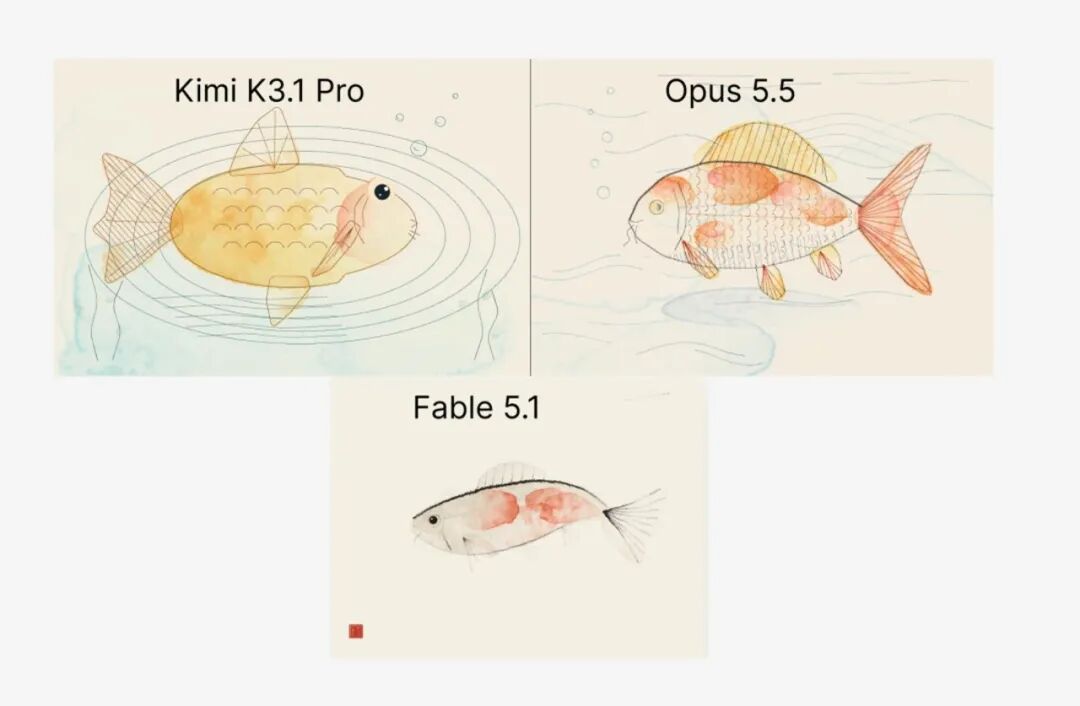
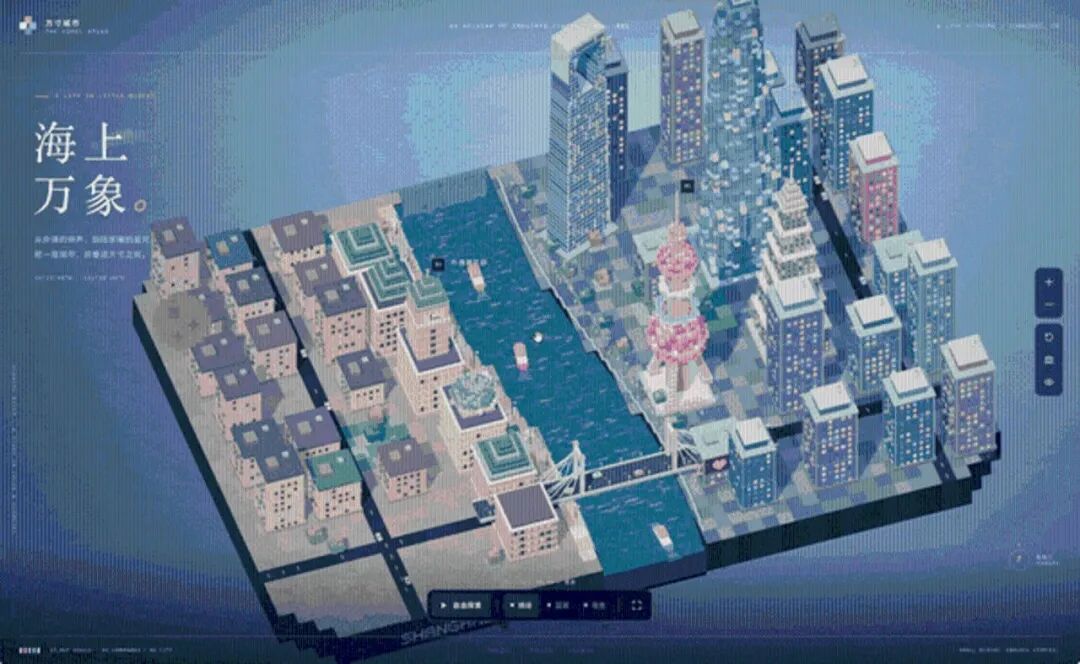
做同类评测时,建议固定参考素材、要求清单、时间预算和验收标准。对 SVG 看还原精度、结构语义与响应式行为;对绘图看画面结构、细节和审美;对视频看脚本、素材、音画同步与导出结果;对 3D 则要检查几何、材质、格式和可编辑性。只有统一约束,横向比较才有意义。
常见问题
Kimi K3.1 Pro 是否已经全面超过 GPT-6 Astra?
不能这样概括。它在 Terminal Bench 4.0 等具体基准上有优势,但不同模型在代码、视觉、金融、工具调用和安全任务中的表现不同,应结合任务类型和可复现实测判断。
Bench CAD 的高分代表可以直接用于生产建模吗?
不代表。高分说明在该评测条件下具备较强工具使用能力,生产场景仍需检查单位、网格、材质、导出格式、许可证和人工验收要求。
幻觉率从 23.4% 降到 8.3% 后,还需要人工复核吗?
需要。这是内部压力测试结果,且错误率不等于所有场景的真实风险。涉及财务、合规、安全和生产变更时,来源、计算和结论都要可复查。
API 怎么估算实际费用?
除了输入和输出 Token 价格,还要统计缓存命中、工具调用、重试、上下文长度和任务成功率。最可靠的方法是先对自己的典型任务小规模压测。
如何把 Kimi K3.1 Pro 接入 AI 编程工作流?
可以先在 Kimi Code 或 API 中针对固定仓库任务做验证,限制可执行命令和最大轮次,并要求生成 Diff、测试结果和回滚说明。模型能力越强,越需要把权限和验收边界设置得明确。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Kimi官网截图

- 目前还没评论,等你发挥!