起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
WorkBuddy + 腾讯乐享,原来知识库还能这么用


大家好,我是苍何。
我在上个月的时候,分享了我是如何用 WorkBuddy + Codex 搭建个人知识库的文章。
收获到了很多朋友的喜欢,不少朋友更是在评论区分享自己的搭建实践以及自己的困惑。
其中有人问到,说我的那种知识库搭建方式是否支持团队使用。
个人知识库可以围绕自己的习惯来搭。到了团队场景或者企业场景,还得考虑:资料散在不同地方怎么汇总,版本不一致该信哪份,哪些内容能让谁、让哪个 Agent 读取。
于是我去找了找适合团队使用的知识库,发现腾讯乐享也能接入我正在用的 WorkBuddy。手头正好有个项目要整理资料,就拿它试了试。
刚开始做项目时,我只想着先把功能做出来,文档就想着回头再写,结果一直拖着。
最近维护 WeSight,我就有这个感受。功能越做越多,改个页面、排查一个问题,都得先翻代码、找资料。让 AI 来做,它也得从头检索一遍。
WeSight 是我在做的开源桌面 AI Agent 项目,把 Claude Code、Codex 等编码 Agent 放进同一个可视化工作台。
我这个项目,已经同时包含产品定义、技术架构、设计素材和用户反馈。放到企业里,这些资料会分散在产品、研发、客服、销售等多个部门。
如果没有统一知识来源,不同 Agent 很容易各自拿到一部分信息,甚至继续引用已经过期的版本。
这段时间,我试着用腾讯乐享整理它的项目资料。乐享是一套给 Agent 用的企业 AI 知识库,我把技术文档、设计素材和用户反馈放进去,再让 Agent 带着这些资料继续做事。
这次,我想验证乐享能否把一套项目知识接进来,加工成 Agent 能理解的结构,持续管理其来源和状态,再按权限应用到 WorkBuddy 的真实任务中。
我先从 WorkBuddy 里接上乐享知识库,让它梳理本地项目。
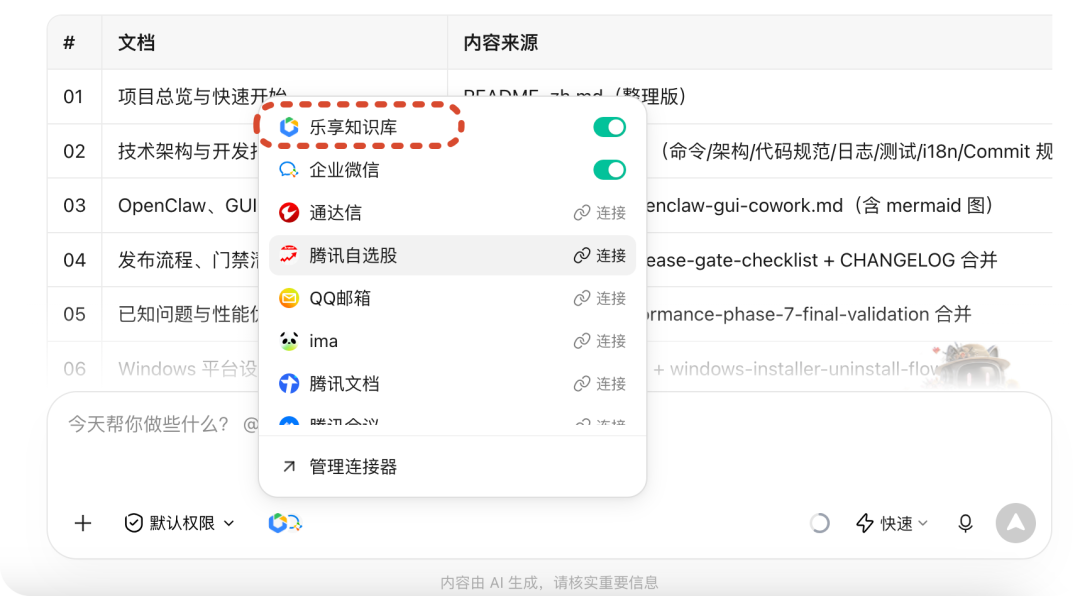
要求很直接,乐享的 Agent 会自主建库和进行分类整理。
●●●
给我的项目 WeSight 梳理一份项目文档,同步到乐享知识库,要求分门别类地整理这个项目。
整理完,一共分了五个库:产品与业务、技术与工程、设计与规范、运营与增长,以及团队规范与新人手册。
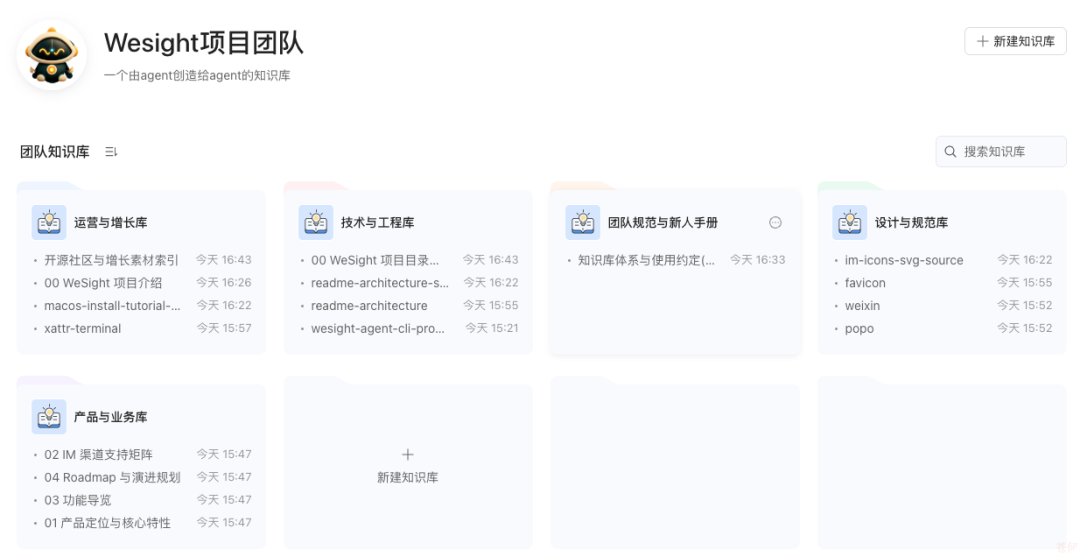
按业务用途分类后,各类项目资料有了明确的归属。即使主要由我一个人维护,也能按统一的结构查找、补充和更新文档。
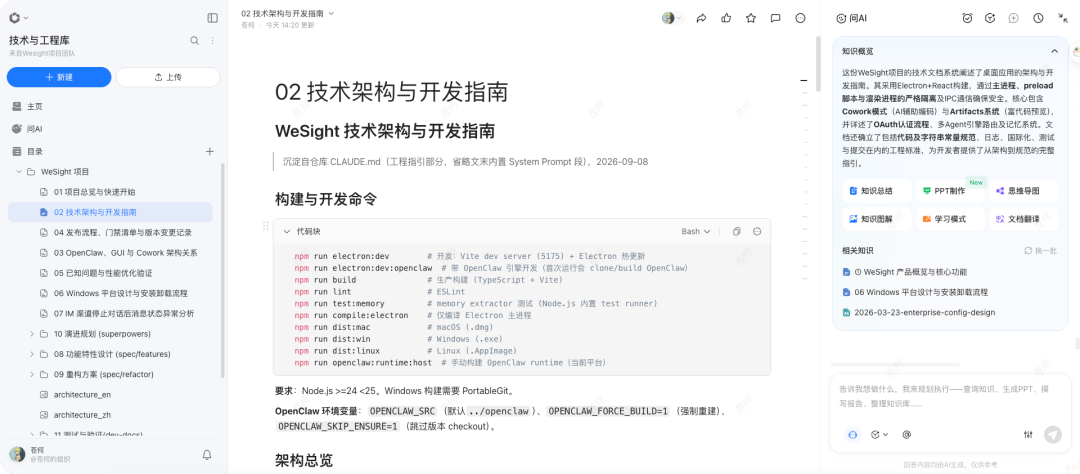
比如技术库里的这篇开发指南,把架构说明和常用命令整理到了一起,还注明内容来自仓库中的哪份文件。要核对时,可以回去看原文。
我更喜欢的是,之前反复调整的那些界面截图,也一起收进来了。右侧还有对图片内容的描述。
下次讨论页面怎么改,就可以直接引用这些资料。否则,光是找到“之前看过的那一版”,有时候就得翻一会儿。
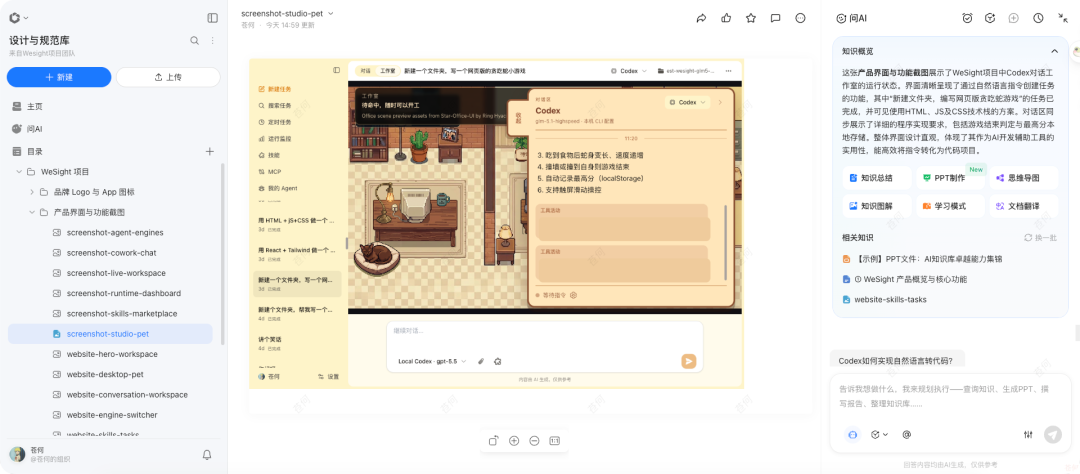
到这里,项目里的文字和图片有了共同的入口,也补上了分类、来源和说明。Agent 再来查,至少有地方下手了。
项目资料整理完,还有一类内容每天都在增加:用户反馈。
大家在群里聊问题,有人报 Bug,有人提建议。同一件事可能隔几天又被提起。等到要安排开发时,再翻聊天记录就挺费劲。
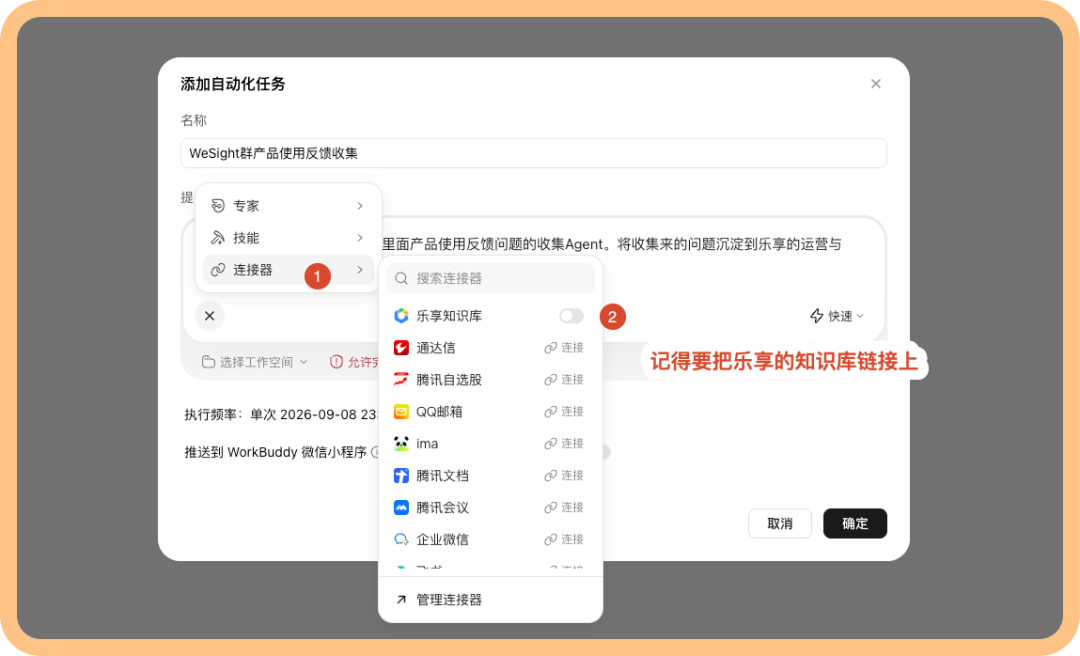
所以我在 WorkBuddy 里配了一个自动化任务:每天收集产品群的反馈,写进乐享的运营与增长库,晚上 8 点向我汇报。加
在这套流程里,WorkBuddy负责定时执行、跨工具取数和生成结果;乐享负责保存团队知识、维持资料之间的关系与权限,并为下一次任务提供可信上下文。
●●●
你是一个专门收集企业微信群里产品使用反馈的 Agent。将收集到的问题沉淀到乐享的运营与增长库,做好知识整理,并在每天晚上 8 点向我汇报。
这里是 WorkBuddy 负责定时执行,乐享存放整理后的资料。任务里要把知识库接上,企业微信的访问也要提前配好,能读取哪些记录取决于账号权限。
下面这些,就是已经按日期留下来的记录。
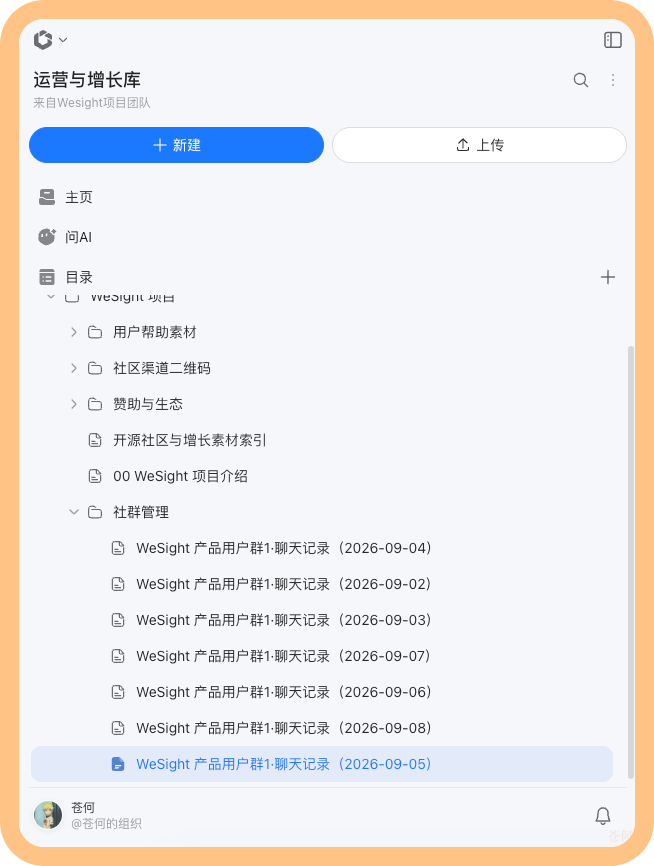
团队和企业一起使用时,还要注意资料的访问边界。Agent调用乐享知识时,会受到当前用户知识权限的约束;不同成员发起同一个任务,能够调用的资料范围也可能不同。这个就解决了我一直以来的痛点和担忧。
反馈收进来以后,我又往前试了一步。
用户说“用不了”,到底是已知问题,还是一个没遇到过的新问题?如果开发文档里已经分析过,再从头查一遍就很可惜。
于是我让 Agent 同时查两个地方:运营库里的用户反馈,以及技术库里的架构说明和已知问题。
提示词里,我特别强调要留下用户原话,找到对应的技术文档并写出文档名;没找到记录的,就标成待核实。
完整提示词放在文末。先看这份结果。
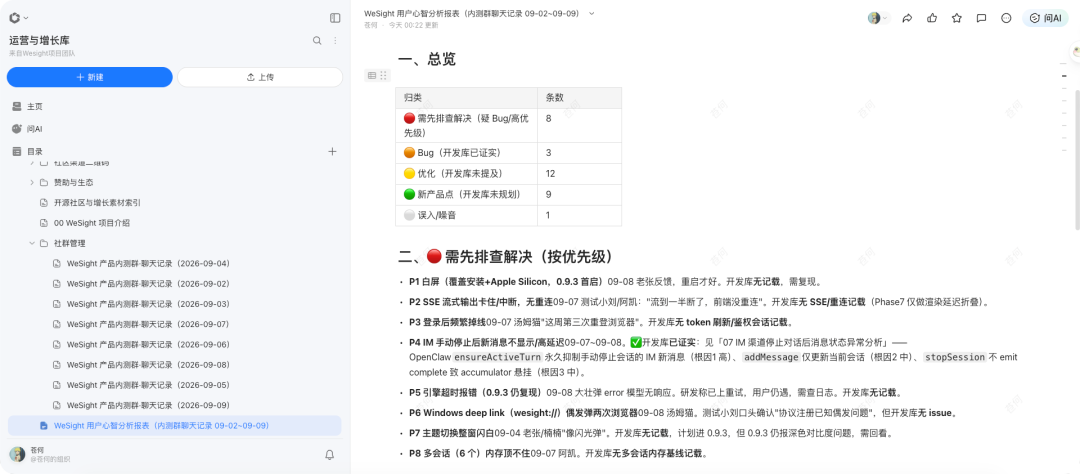
比如这两条反馈,一条有记录可查,另一条还得复现。
一条是“IM 手动停止后,新消息不显示或延迟较高”。报表找到了《07 IM 渠道停止对话后消息状态异常分析》,标注为开发库已有记录支持的问题。接下来就能沿着这份文档,看之前分析到了哪一步。
另一条是 Apple Silicon 设备上,0.9.3 版本首次启动出现白屏。这条被标成了“开发库无记载,需复现”。
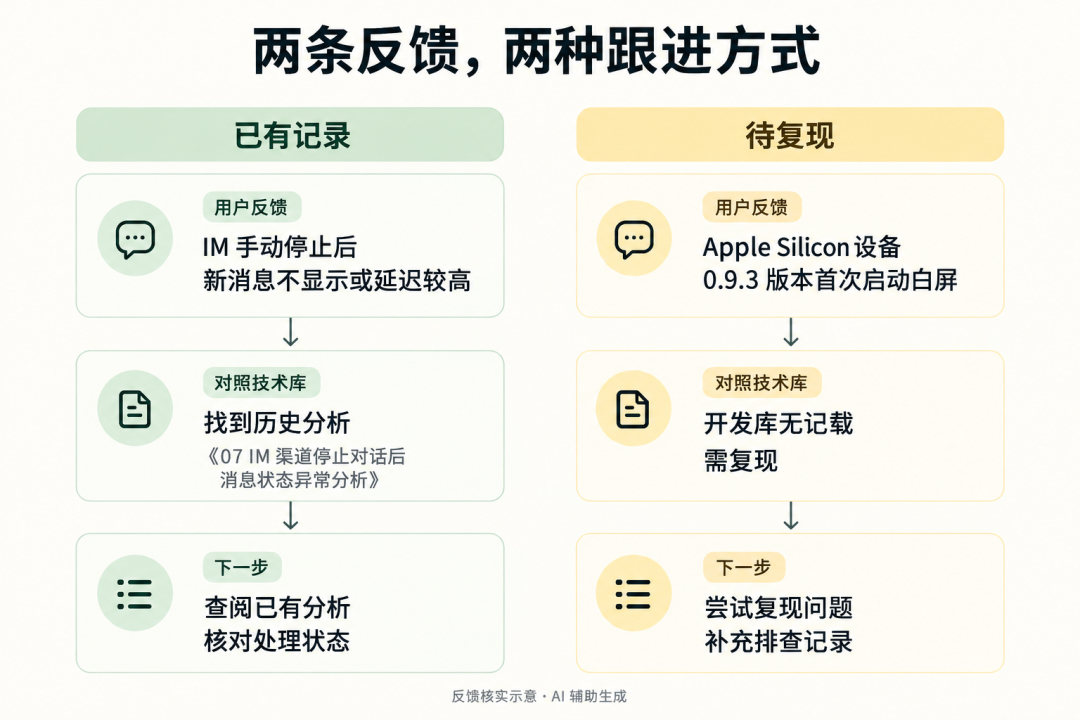
看到这里,至少知道接下来该分别做什么:一条先查已有分析,另一条先想办法复现。它还单独分出了噪音信息,方便我继续筛选。
这比只列出一长串问题更方便我往下处理。真正的原因是否找对、修复能不能生效,后面还得验证。
我理解的知识治理,大概就落实在这些细节上:哪句话有出处,哪条结论还没确认,哪些资料需要继续补。把这些分清楚,后续的 Agent 才有比较明确的依据。
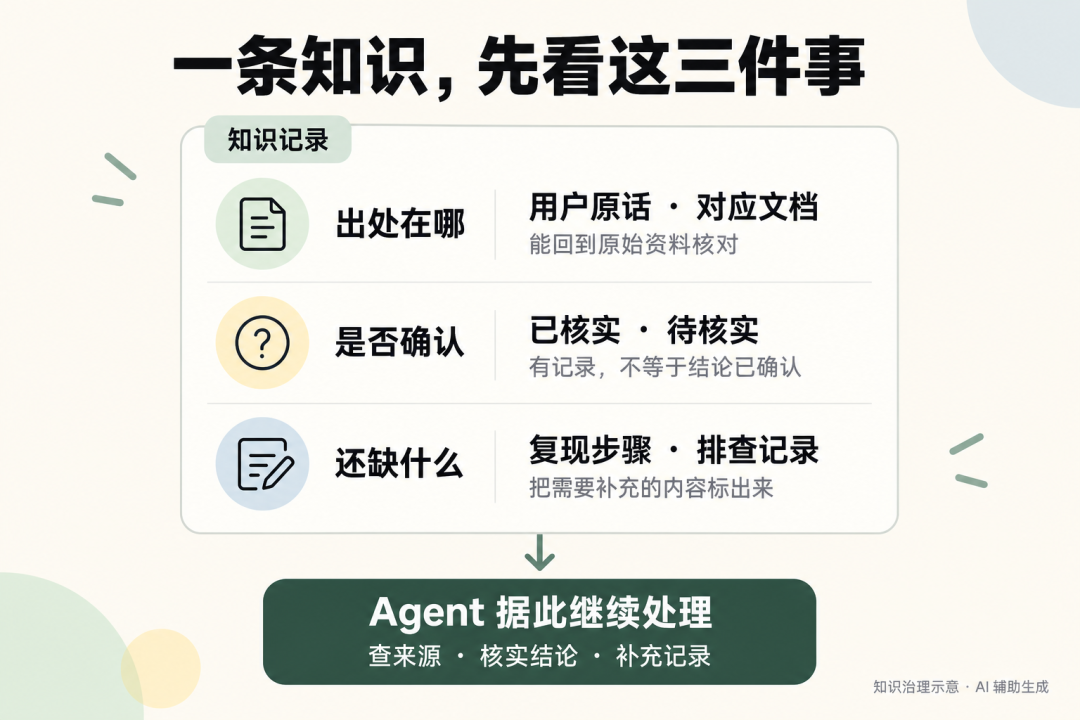
前面那条 IM 消息异常,就连着用户反馈和一份历史分析。要是这种联系能留下来,下次遇到类似问题,就能顺着找到相关资料。
乐享的知识图谱也是这个思路:先由机器梳理资料之间的关联,再让熟悉业务的人确认。
项目一直在改,文档也得跟着更新。比如 Bug 已经修了,库里还写着“待解决”,下次查到就容易误判。
我发现乐享正在探索通过 LLM Wiki,把分散的原始资料重新组织成更适合 AI 理解和调用的 Wiki;当项目内容发生变化时,还可以进一步识别新旧知识之间的差异,提出更新建议,让知识持续跟上项目进展。
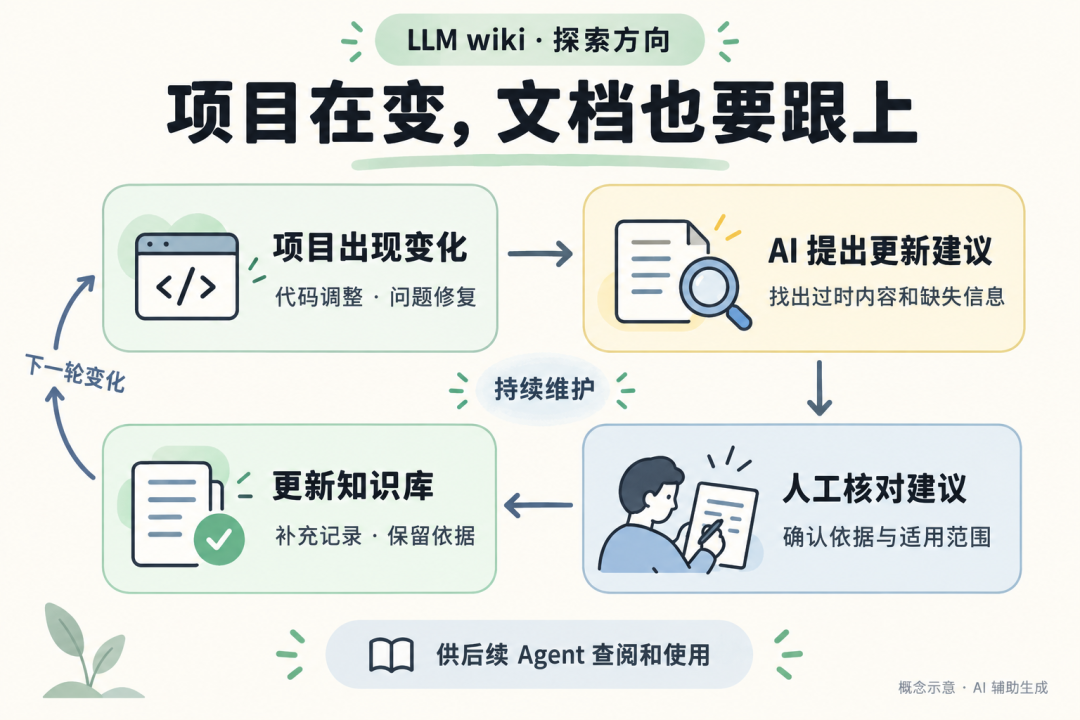
我选中 WeSight 项目的相关资料,交给乐享的 LLM Wiki 去构建。它会从已有文档中抽取主题和关系,再重新整理成一组互相关联的 Wiki 页面。过了一段时间,我看到的结果是这样的
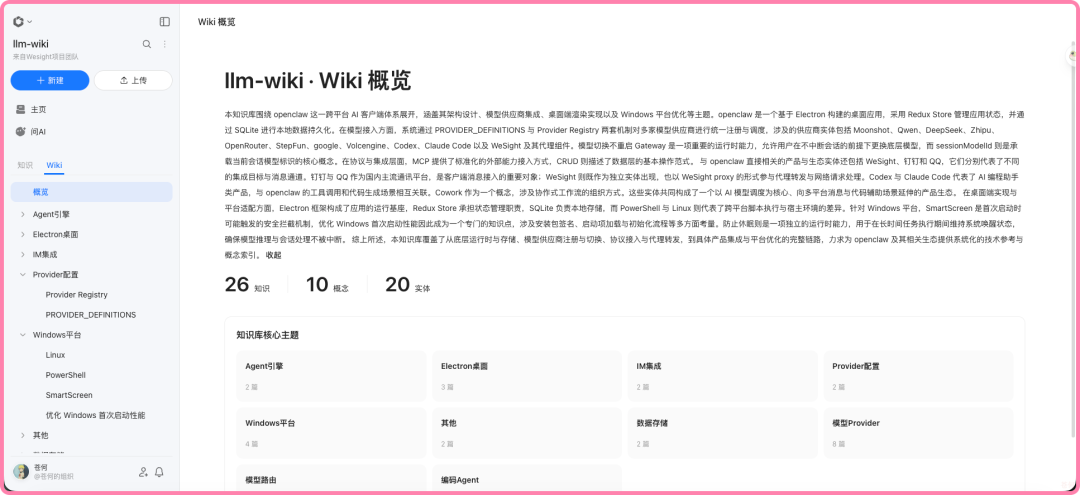
我体验过很多LLM wiki。乐享和workbuddy结合,能解决“文档半衰期”问题,拥有闭环的知识反哺与维护机制,项目永远在迭代,知识库最大的痛点永远是“写出来即过时”。好用的系统必须有像我们前面提到的巡检机制——能够感知代码与业务变化,提示人工核对,或者由 Agent 验证后再把最新结果反写回库中。能自我更新的知识库,才有长期的生命力。刚好乐享在这方面很有巧思。
前面的报表可以用来辅助安排开发。再往后,可以让接入知识库的编码 Agent 查资料、尝试复现问题,把验证过的结果写回来。这个流程还有继续往下做的空间。
这里我们以一个真实的开发来举例。
团队收到社群反馈:“Windows 客户端在特定系统环境下偶发白屏/闪退”。以往开发需要到处翻历史 PR、微信群聊记录或架构文档定位原因,极其费时。
●●●
我们在 Windows 平台上遇到了偶发闪退问题。请结合当前乐享知识库中沉淀的 Electron 架构、Windows 平台适配文档以及历史 Issue 记录,排查可能导致闪退的原因,并给出最小复现步骤。
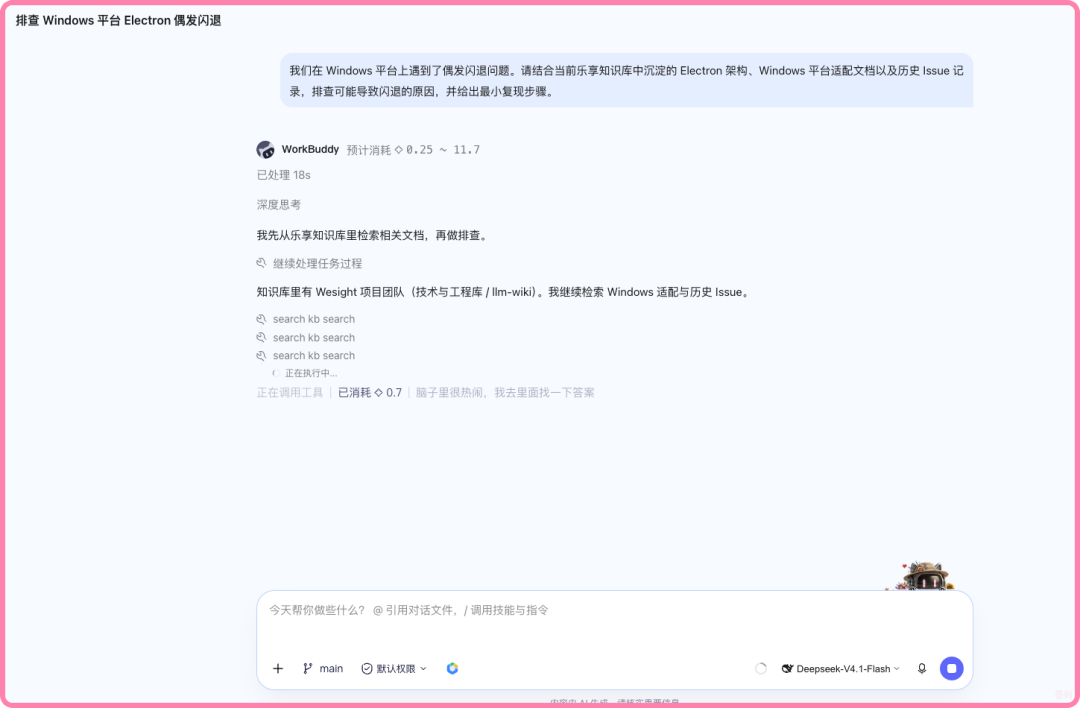
Agent 输出排查思路与复现代码
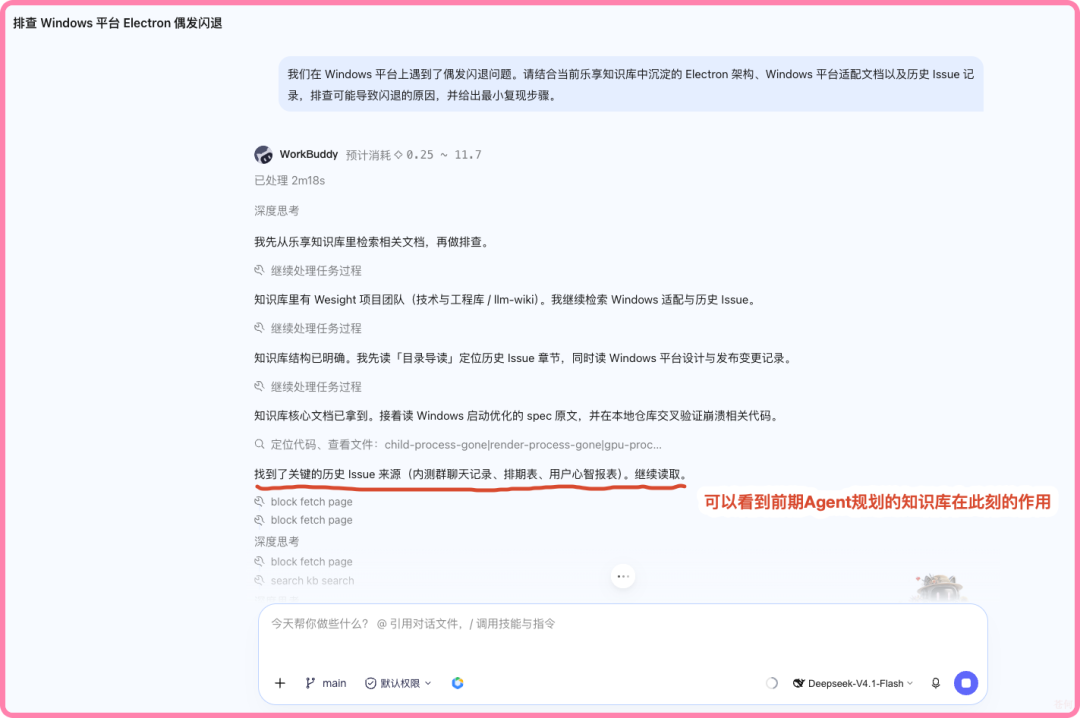
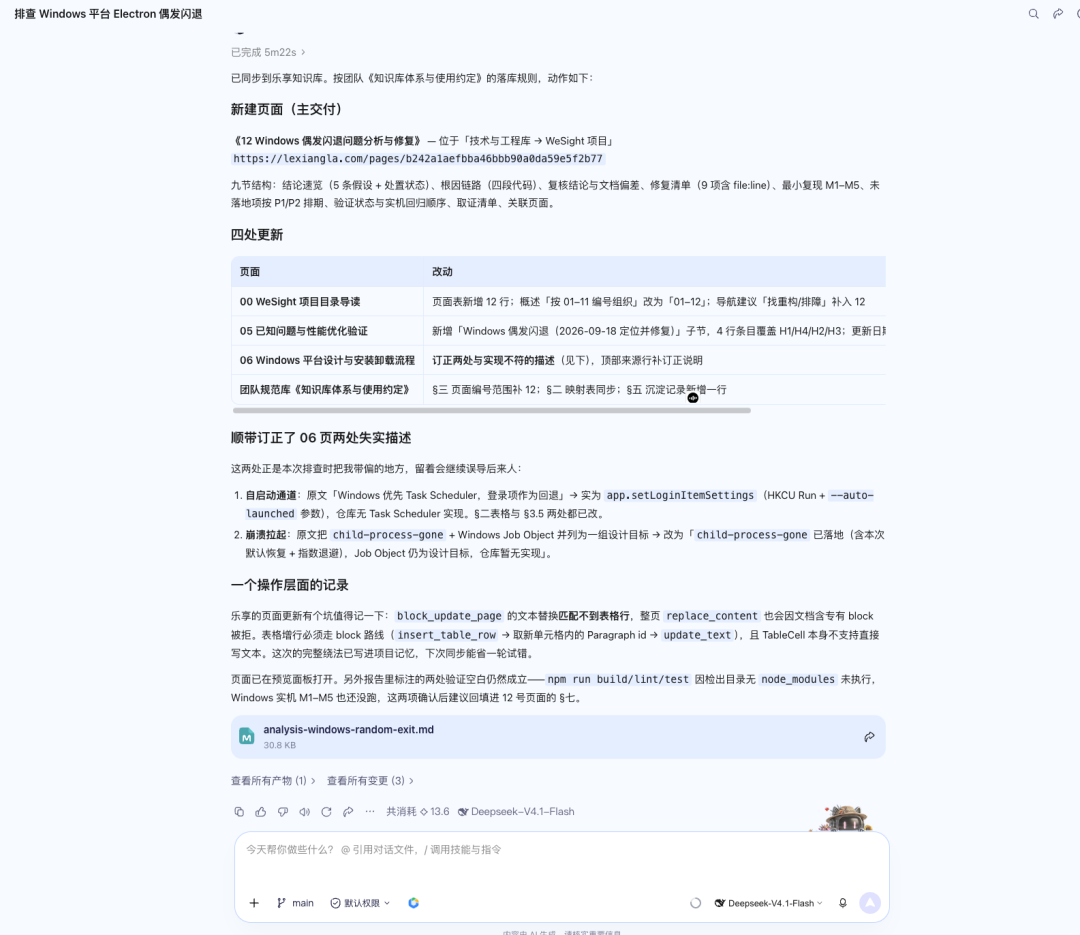
完整的排查报告(讲的大概意思是解释为什么会闪退,以及闪退的原因是什么。)
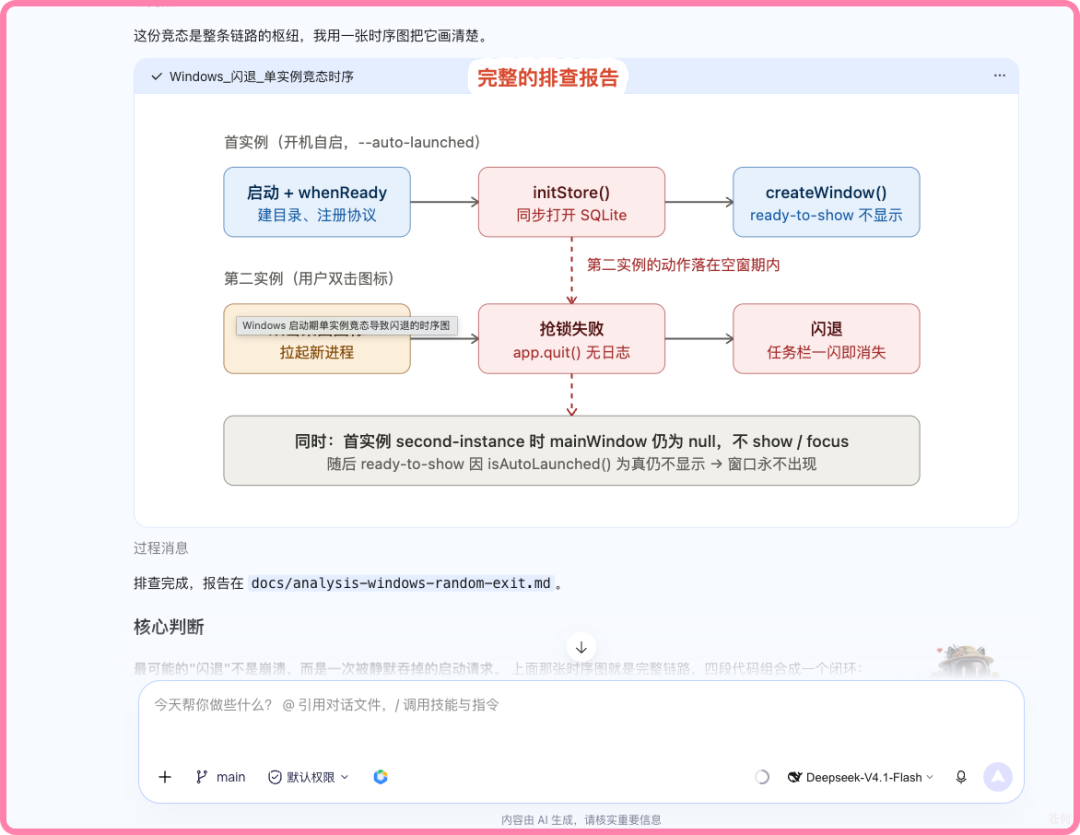
问题复现和修复结果验证后,Agent 可以把结论整理成知识更新建议;经确认后再回写乐享,为下一次排查提供依据。
接着,我又试着用库里的资料做一份路演 PPT。
产品介绍、技术资料和界面截图都在库里,就想着让它用这些内容做一份初稿:
●●●
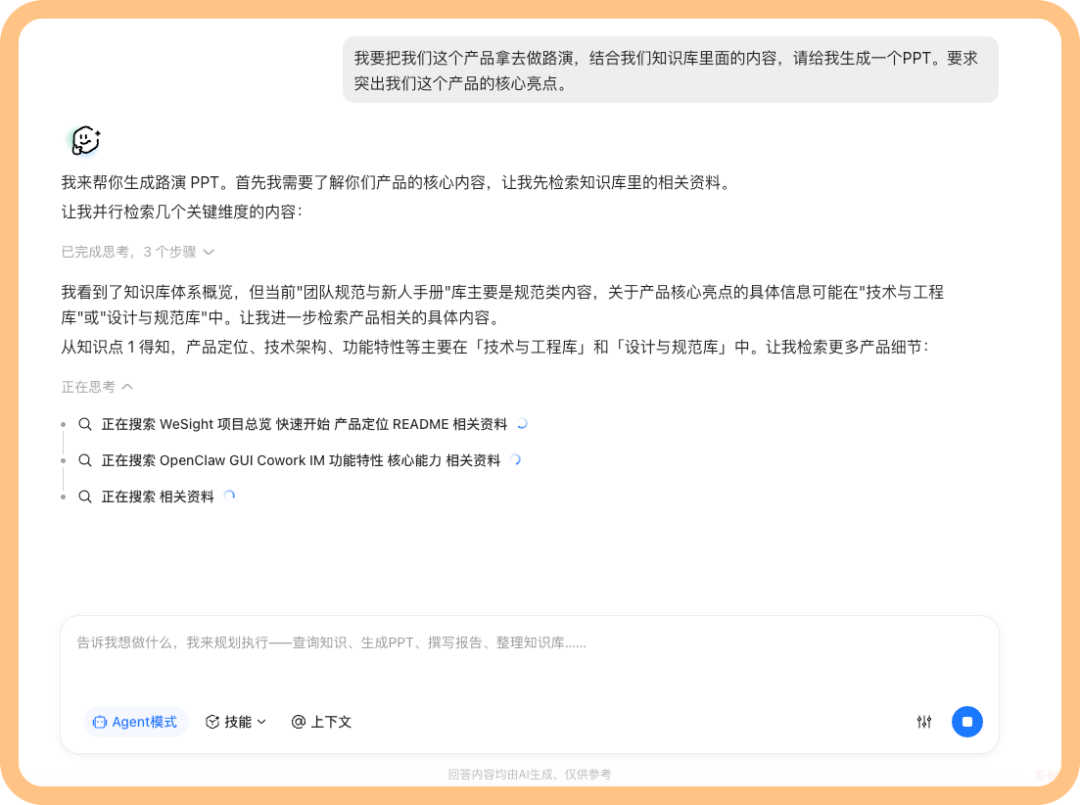
我要把我们这个产品拿去做路演,结合知识库里的内容,请给我生成一个 PPT,突出产品的核心亮点。
从执行过程能看到,它先找了产品定位、技术架构和功能特性等资料。
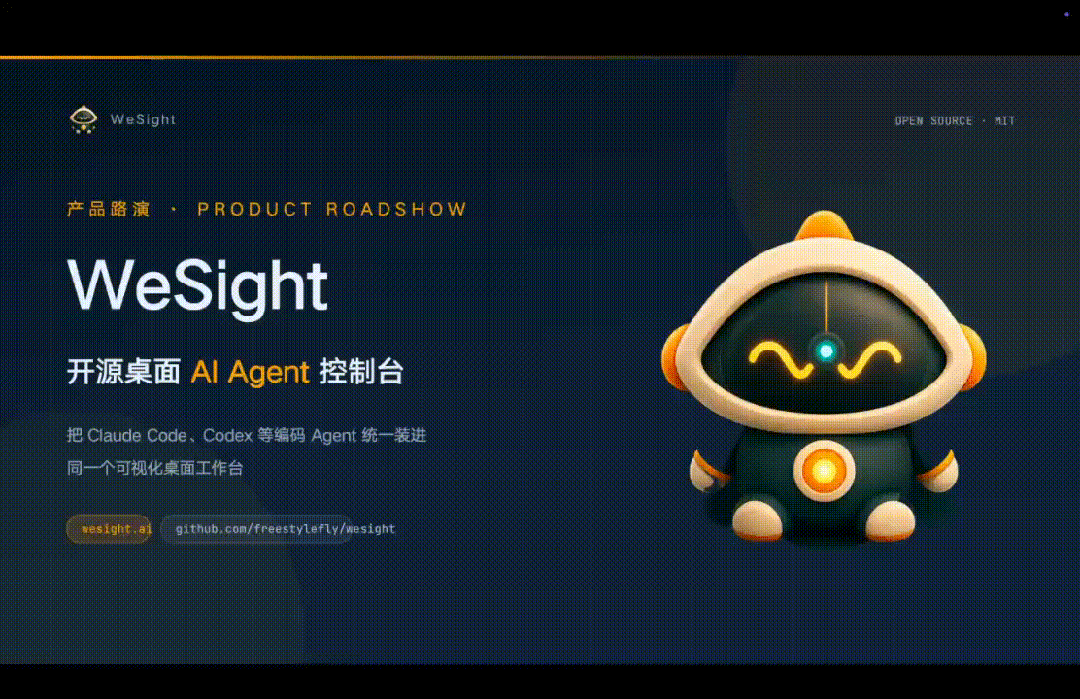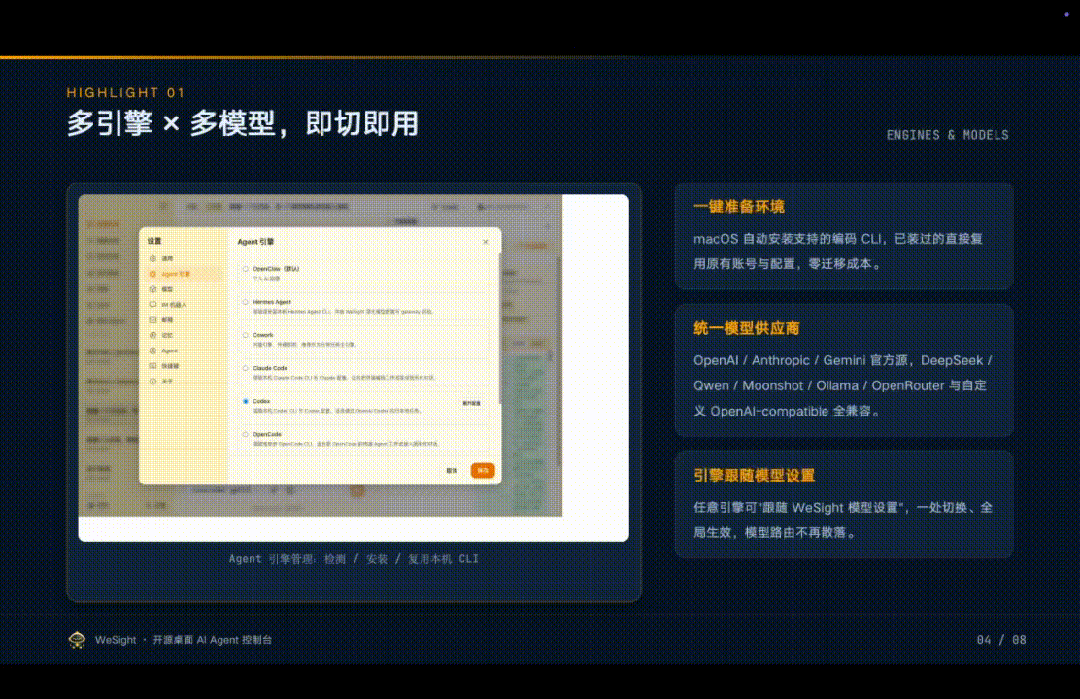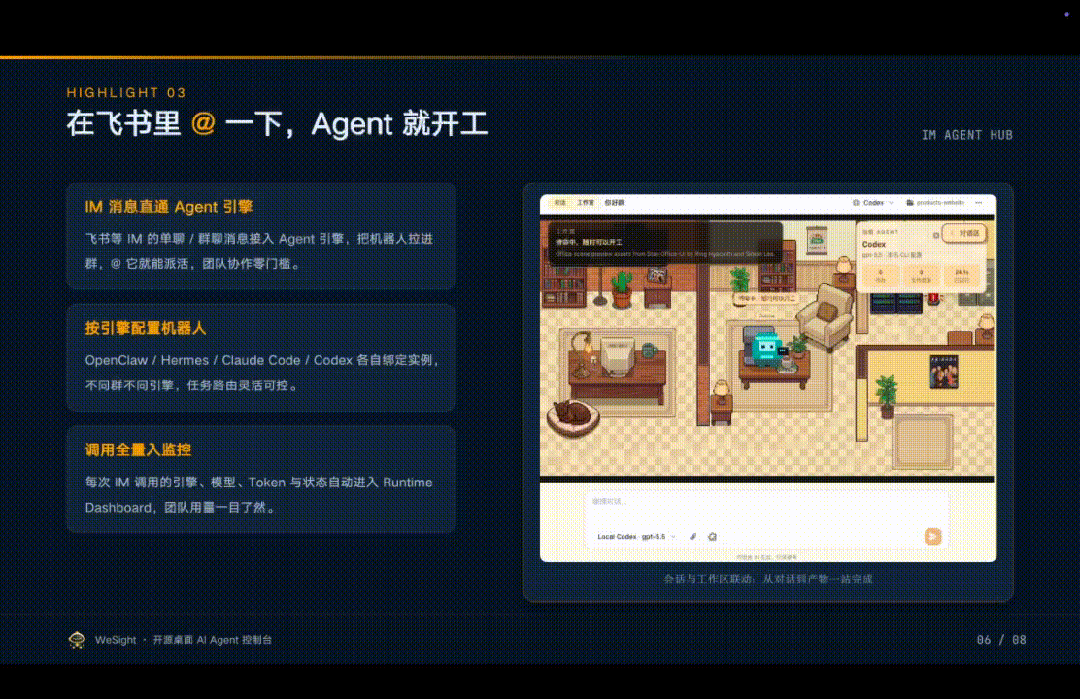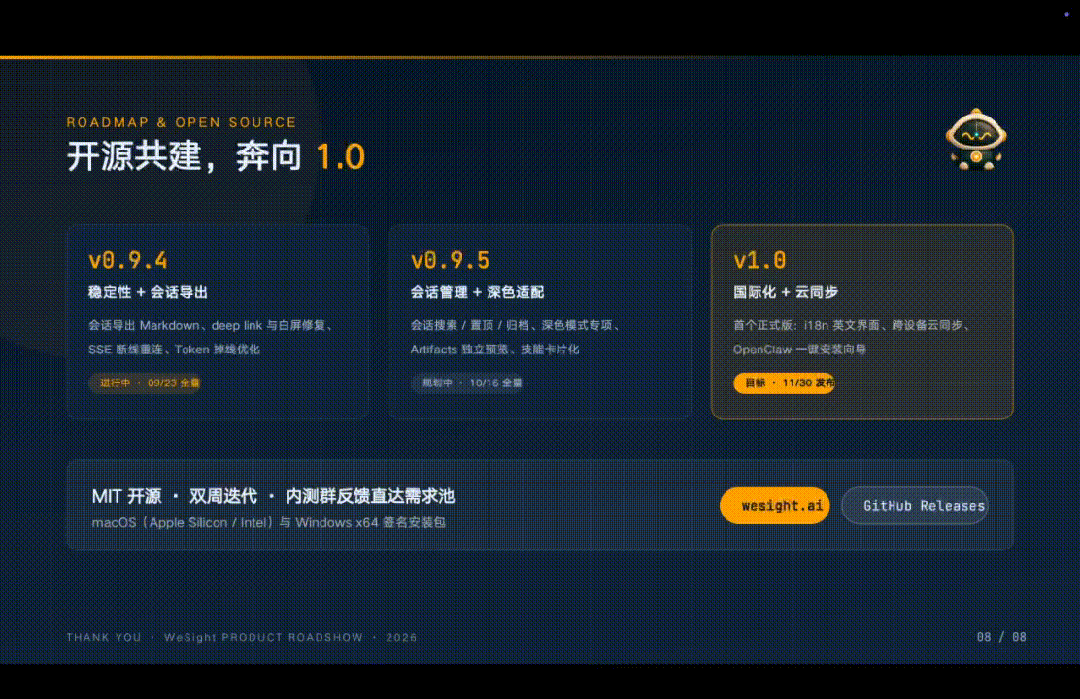
下面是其中两页。封面用了 WeSight 的产品定位,功能页把对话界面和实时工作区放在了一起。
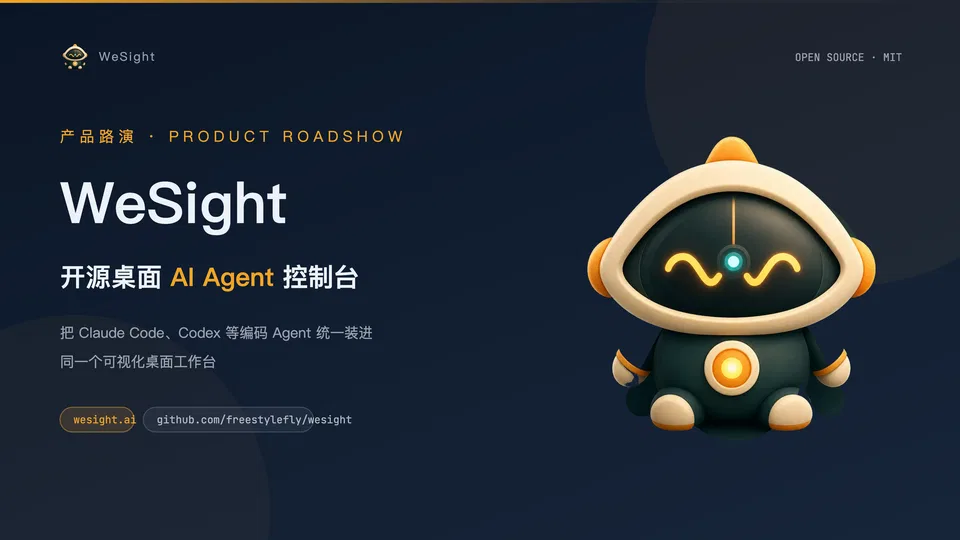
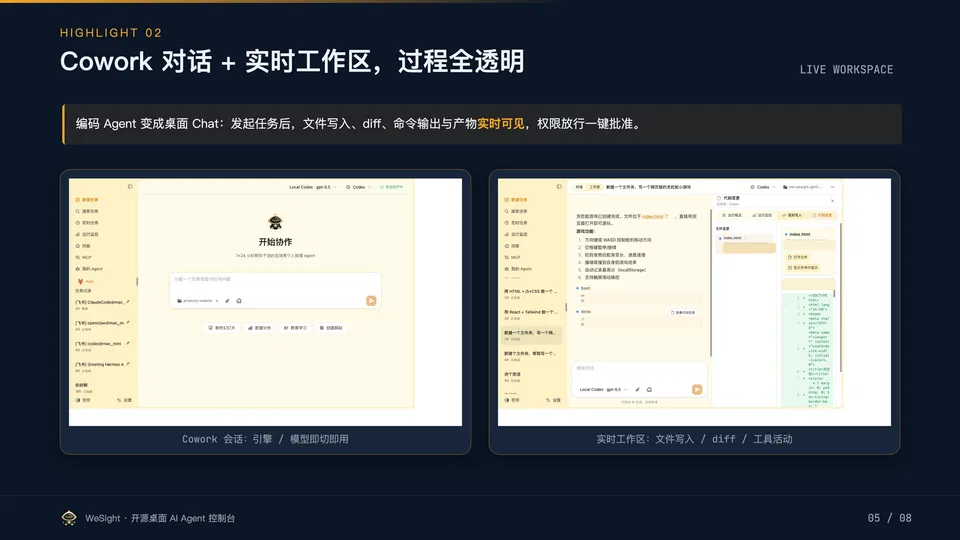
说实话,通过乐享 LLM Wiki 这种方式做的路演 PPT,发现 Agent 查的更准了,效果比我之前做的好多了。
这次折腾下来,最有用的还是反馈核实那一步。已有分析的,可以顺着文档继续查;还没记过的,先留着排查。
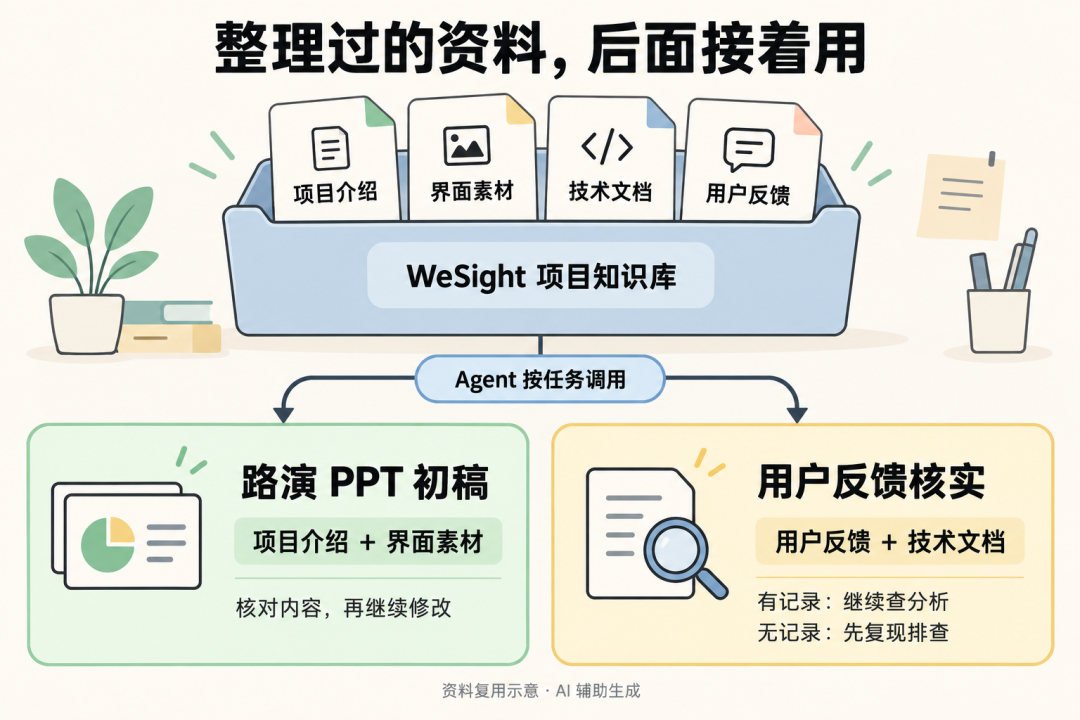
资料整理也有前期成本,生成的结果还得自己看。但对我这种会反复修改项目、处理用户反馈的人来说,先把这些记录留下来,后面确实方便些。
如果你和团队也经常在聊天记录、技术文档之间来回找东西,可以参考这个流程。先拿一小段时间的反馈和对应文档试一次,看看它找的依据对不对,再决定要不要用到更多工作里。
完整提示词留在下面,按自己的项目改就行。
下面是这次用的完整反馈分析提示词。复用时,把项目名、知识库名和文档名换成自己的实际内容,并检查 Agent 是否具备相应的访问权限。
# Role你是一名资深产品专家(CPO)兼敏捷研发负责人,擅长从真实用户反馈中洞察用户心智,并能结合技术开发文档进行交叉验证与根因核实。# Task请完整调取并分析【运营与增长库】中的 WeSight 项目用户聊天记录,同时跨库检索【技术与工程库】(重点核对“05 已知问题与性能验证”及相关技术架构/接口文档)。按照严密的用户心智分析框架提炼诉求,与开发库知识交叉印证,最终生成一份具备落地指导意义的分析报表。# AnalysisCriteria(分类与判定标准)在归类问题时,严格按照以下逻辑区分:1. 【紧急排查】(P0/Blocking):阻碍用户核心链路使用、高频投诉、造成数据异常或安全隐患,无论是否确认是 Bug,都需要技术立即介入排查定位。2. 【缺陷 Bug】:现有功能表现与设计预期不一致、控制台报错、接口异常、前端展示错乱或开发库中已明确记录为“已知缺陷/待修复”的问题。3. 【体验优化】:功能本身可用,但交互路径繁琐、加载延迟偏高、文案歧义、不符合用户认知习惯的改进项。4. 【新增需求】:用户期望获得但目前产品完全未覆盖的能力、业务场景拓展或新的集成形态。# StrictGroundingRules(严谨性与溯源约束)-**事实依据原则**:必须逐条提取用户的原话片段作为“原始反馈佐证”,不得概括虚构。-**交叉验证要求**:每一项问题必须明确在【技术与工程库】中是否找到对应记录:- 若开发库已确认:注明对应文档名、已知原因或当前状态。- 若开发库未记录:标记为“开发库未收录/待技术核实”,给出可能的排查方向,并明确标记为“假设”,不得当成已确认原因。-**用户心智提炼**:不仅记录“用户说了什么”,更要提炼“用户的底层预期与挫败感来源是什么”(如:对实时性的不安全感、对配置门槛的抗拒等)。# OutputFormat请严格按照以下三部分输出报表:## 一、用户心智与痛点全景洞察1.**核心心智特征**:总结当前用户对产品的整体预期与认知偏差(2-3 点)。2.**高频挫败感集中地**:用户在哪个阶段流失或抱怨最多。## 二、问题核实与分类处理矩阵表| 优先级 | 分类 | 问题描述 | 用户底层心智/挫败根因 | 运营库原话佐证 | 开发库核实结论 (文档/状态)| 建议处理方案/排查方向 ||:---|:---|:---|:---|:---|:---|:---||P0/P1/P2| 紧急排查/Bug/优化/新增需求 |...|...|"...用户原话..."| 【已证实】文档名+原因 / 【未记录】需排查 |...|## 三、近期冲刺(Sprint)行动建议- 立刻排查(Top3):- 快速上线优化项(QuickWins):- 产品规划池(Backlog 候选):
本文作者@苍何,授权发布于平台,未经许可禁止转载。


- 目前还没评论,等你发挥!