起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
3D国漫女性角色提示词工程:角色资产完整性模型+分镜一致性锚定全解


做3D国漫角色时,第一张立绘惊艳全场,第二个分镜却让团队沉默——角色漂移、产能崩盘。问题不在提示词长度,而在方向:三视图只能展示,无法锚定。本文提出DNA锚定系统与DZS角色资产生成框架,从底层原理到工程落地,帮你彻底解决跨镜头一致性难题。
做3D国漫角色,第一张立绘出来的时候,所有人都觉得成了。脸好看,服装精致,光影高级。然后进入分镜制作,第二个镜头一出来,整个团队沉默了——这是同一个人吗?
眼睛颜色偏了,脸型宽了,发型层次塌了,服装细节对不上。于是开始反复抽卡、反复局部重绘、反复跟AI描述“就是之前那个角色”,一张图折腾半天,产能直接崩盘。
这个问题不是提示词写得不够长。是根本方向错了。
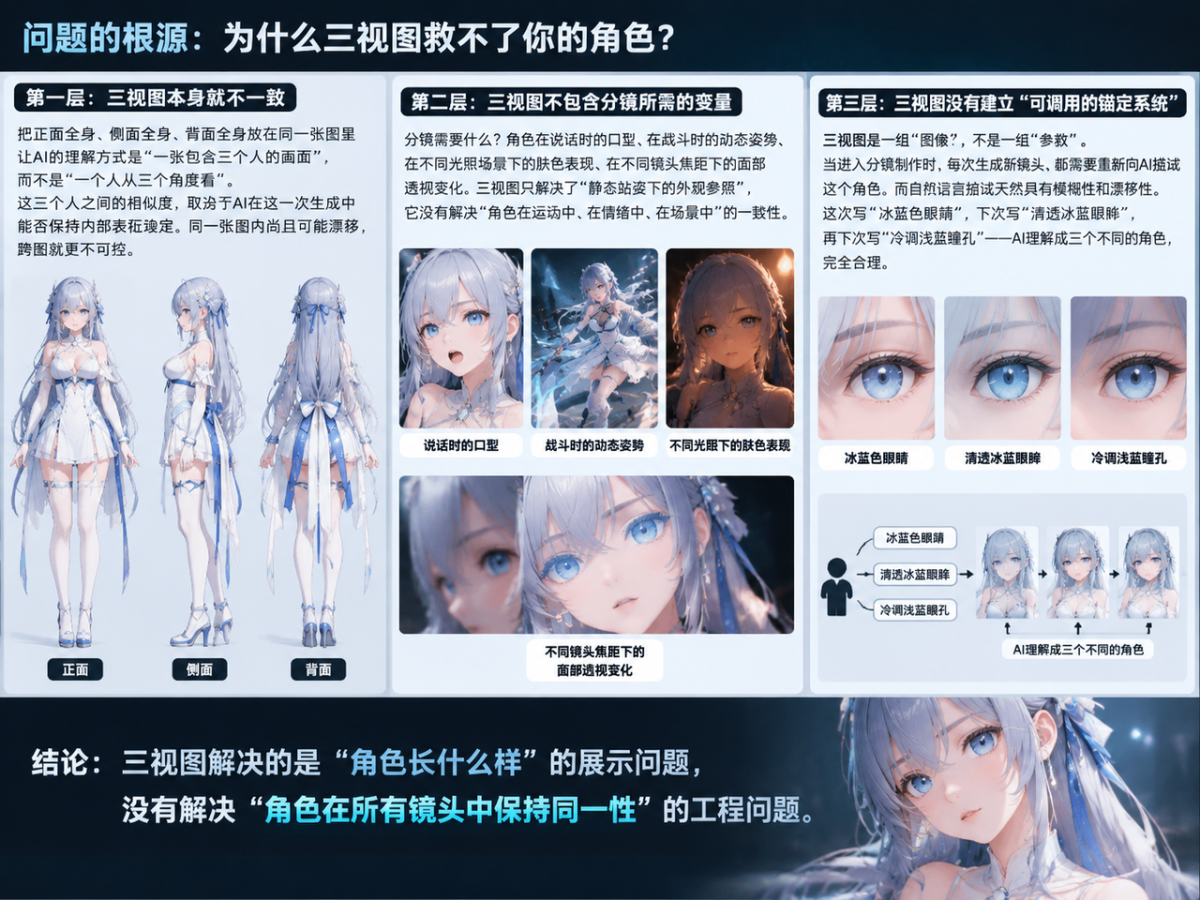
问题的根源:为什么三视图救不了你的角色?
绝大多数教程给出的方案是:生成一张正面立绘,再生成三视图,角色就完整了。
这个方案在“角色展示”场景下成立。但在“分镜制作”场景下,它必然崩溃。原因有三层。
第一层:三视图本身就不一致。
把正面全身、侧面全身、背面全身放在同一张图里让AI生成,AI的理解方式是“一张包含三个人的画面”,而不是“一个人从三个角度看”。这三个人之间的相似度,取决于AI在这一次生成中能否保持内部表征稳定。同一张图内尚且可能漂移,跨图就更不可控。
第二层:三视图不包含分镜所需的变量。
分镜需要什么?角色在说话时的口型、在战斗时的动态姿势、在不同光照场景下的肤色表现、在不同镜头焦距下的面部透视变化。三视图只解决了“静态站姿下的外观参照”,它没有解决“角色在运动中、在情绪中、在场景中”的一致性。
第三层:三视图没有建立“可调用的锚定系统”。
这是最关键的。三视图是一组“图像”,不是一组“参数”。当进入分镜制作时,每次生成新镜头,都需要重新向AI描述这个角色。而自然语言描述天然具有模糊性和漂移性。这次写“冰蓝色眼睛”,下次写“清透冰蓝眼眸”,再下次写“冷调浅蓝瞳孔”——AI理解成三个不同的角色,完全合理。
结论:三视图解决的是“角色长什么样”的展示问题,没有解决“角色在所有镜头中保持同一性”的工程问题。
角色一致性的底层原理:DNA锚定系统
要解决跨镜头一致性,必须先理解AI生成角色的工作机制。
当AI接收一段角色描述时,它会将文字映射到一个高维语义空间中的“角色表征”。这个表征由所有描述词共同决定,每个词都在拉扯这个表征的位置。描述词越多、越具体,表征越稳定。但问题是——每次生成,描述词都在变。
分镜提示词为了适配不同镜头,必然要加入镜头角度、景别、动作、表情、光照等变量。这些变量会扰动角色表征。如果角色本身的核心描述不够“锚定”,扰动就会导致漂移。
角色DNA锚定系统的核心逻辑:
将角色描述拆分为两个层级——锚定层和变量层。
锚定层是不可变的角色核心特征。它必须足够具体、足够独特、足够精简,能够在一句话内完成角色锁定。锚定层的作用是:无论后面加什么变量,AI都能识别出“这是同一个角色”。
变量层是每次生成时根据镜头需求变化的描述。包括:角度、景别、表情、动作、光照、背景等。
锚定关键词组的构建原则:
唯一性:锚定词组合必须能唯一指向一个角色。如果两个角色都是“银白色头发+冰蓝色眼睛+冷白皮”,锚定就失效了。
精简性: 锚定层不能太长。太长会被变量层稀释,AI的注意力分配会失衡。
结构性:锚定词不是随便堆砌,而是有固定顺序的结构化组合。建议顺序:发型特征 → 瞳色特征 → 肤色特征 → 标志性配饰。
可复用性:锚定词组必须能够直接嵌入任何分镜提示词的开头或结尾,不产生语法冲突。
示例锚定词组:
银白短层次发+空刘海+冰蓝瞳+冷白皮+白花侧饰
这组词在任何分镜提示词中出现,都能将角色锁定。变量层可以随意变化,锚定层始终不变。
核心增量(一):角色资产完整性模型
有了DNA锚定系统,还需要一套完整的资产体系来支撑分镜制作。以下是角色资产完整性模型的五个层级。
第一层:基础设定层
这是角色的“出厂设置”。包含:
角色DNA锚定词组(必须最先确定)
标准三视图(正面、侧面、背面)
面部特写(用于后续面部一致性参照)
服装细节拆解图(材质、剪裁、配饰单独展示)
基础设定层的输出目标:让任何人看到这组图,都能准确描述这个角色的核心特征。
第二层:表情差分模块
分镜中角色不可能只有一个表情。需要至少生成以下表情差分:
- 中性表情(基准)
- 微笑
- 冷笑/讥讽
- 惊讶
- 愤怒
- 悲伤
- 害羞/脸红
- 战斗中的专注/咬牙
每个表情都必须基于同一组锚定词生成,确保表情变化不带动角色特征漂移。
第三层:动态姿势模块
静态站姿不够用。需要生成:
- 行走姿态(正面、侧面)
- 奔跑姿态
- 战斗姿态(出拳、持剑、防御)
- 坐姿
- 回头姿态
- 伸手姿态
动态姿势的生成必须使用锚定词组+姿势变量,且姿势变量不能干扰锚定层。
第四层:光影适配模块
同一角色在不同场景中的光照反应必须一致。需要测试:
- 暖光环境
- 冷光环境
- 逆光
- 侧光
- 顶光
- 夜景弱光
- 高对比戏剧光
这一层的作用是建立“角色在不同光照下的肤色、发色、服装材质反应参照”。
第五层:分镜一致性锚定模块
这是最终输出层。将以上所有模块整合,形成一套可直接用于分镜制作的提示词组装系统。
核心增量(二):工程级“DZS-角色资产生成框架”提示词构建
以下框架的设计哲学是:将角色资产生成从“一次性描述”升级为“可复用系统”。 用户只需将框架发送给AI,即可开启一个持续协作的角色资产工作模式。
框架设计核心原则:
- 无任何人设语句
- 变量定义清晰
- 模块化调用
- 支持单步输出和多步工作流
- 锚定层与变量层强制分离
完整框架代码如下:
# DZS-角色资产生成框架
## 框架标识
DZS-CharacterAsset-v1.0
## 输入变量定义
{{CHARACTER_CORE}}:角色核心锚定词组,格式为“发型+瞳色+肤色+标志配饰”,不可变。
{{CHARACTER_DETAIL}}:角色详细描述,包含脸型、五官细节、妆容、服装、鞋履、整体气质。
{{ASSET_TYPE}}:资产类型,可选值:三视图/表情差分/动态姿势/光影适配/分镜提示词组装。
{{VARIABLE_LAYER}}:变量层描述,根据ASSET_TYPE不同而变化。
{{OUTPUT_FORMAT}}:输出格式要求,如“16:9横版”“纯白背景”“8K”等。
## 工作流逻辑
### 步骤一:锚定层校验
检查{{CHARACTER_CORE}}是否满足以下条件:
– 唯一性:能否唯一指向一个角色
– 精简性:是否在15字以内
– 结构性:是否按“发型→瞳色→肤色→配饰”顺序排列
若不满足,输出优化建议,等待用户确认。
### 步骤二:按ASSET_TYPE分支执行
**分支A:三视图**
组装提示词:
{{CHARACTER_CORE}},{{CHARACTER_DETAIL}},{{VARIABLE_LAYER}},标准角色三视图,左侧胸像特写占40%,右侧依次正面全身/侧面全身/背面全身,比例服装完全一致,{{OUTPUT_FORMAT}}
**分支B:表情差分**
组装提示词:
{{CHARACTER_CORE}},{{CHARACTER_DETAIL}},{{VARIABLE_LAYER}},角色面部特写,[指定表情],保持角色核心特征完全一致,{{OUTPUT_FORMAT}}
**分支C:动态姿势**
组装提示词:
{{CHARACTER_CORE}},{{CHARACTER_DETAIL}},{{VARIABLE_LAYER}},角色全身,[指定姿势],保持角色核心特征与服装细节完全一致,{{OUTPUT_FORMAT}}
**分支D:光影适配**
组装提示词:
{{CHARACTER_CORE}},{{CHARACTER_DETAIL}},{{VARIABLE_LAYER}},角色半身,[指定光照条件],保持角色核心特征与材质反应一致,{{OUTPUT_FORMAT}}
**分支E:分镜提示词组装**
组装提示词:
{{CHARACTER_CORE}},{{CHARACTER_DETAIL}},[镜头角度],[景别],[表情],[动作],[光照],[场景],保持角色核心特征完全一致,{{OUTPUT_FORMAT}}
### 步骤三:一致性自检
每次输出前,检查组装后的提示词是否满足:
– 锚定词组是否完整出现
– 变量层是否可能干扰锚定层
– 是否存在与锚定层冲突的描述
若存在冲突,自动修正并说明修正原因。
### 步骤四:输出与迭代
输出组装后的提示词。
等待用户反馈生成结果。
若用户反馈漂移,执行诊断:
– 判断漂移类型(面部/发型/服装/气质)
– 定位漂移原因(锚定层不足/变量层干扰/描述冲突)
– 输出修正方案
## 交互协议
-首次对话:等待用户输入{{CHARACTER_CORE}}和{{CHARACTER_DETAIL}}
– 后续对话:用户可直接指定{{ASSET_TYPE}}和{{VARIABLE_LAYER}},框架自动组装
– 若用户未提供{{CHARACTER_CORE}},框架主动询问并要求先完成锚定层定义
– 若用户要求跨角色批量生成,框架要求为每个角色单独建立锚定词组
## 禁止事项
– 禁止在锚定层未确认的情况下生成任何资产
– 禁止在提示词中引入与锚定层矛盾的描述
– 禁止省略锚定词组
框架使用说明:
将上述框架完整发送给AI,AI即进入角色资产工作模式。首次使用时,用户需提供角色的核心锚定词组和详细描述。框架会自动校验锚定层质量,然后等待用户指定资产类型。
后续每次生成,用户只需说“生成表情差分-微笑”或“生成动态姿势-战斗姿态”,框架会自动组装提示词,无需重复描述角色核心特征。
当出现漂移时,用户反馈“面部漂移”,框架会诊断锚定层是否被变量层干扰,并输出修正方案。
核心增量(三):分镜一致性控制工作流
有了资产包和框架,还需要一套工作流来确保分镜制作中的一致性。以下是完整流程。
步骤一:建立角色资产包
使用DZS框架,依次生成:
基础设定层(三视图+面部特写+服装拆解)
表情差分模块(至少8个表情)
动态姿势模块(至少6个姿势)
光影适配模块(至少5种光照条件)
将以上所有生成结果归档为“角色资产包”,并记录每次使用的完整提示词。
步骤二:提取锚定词组
从基础设定层中提取最终确认的锚定词组。这个词组是后续所有分镜提示词的固定开头。
步骤三:分镜提示词组装
每个分镜的提示词按以下结构组装:
[锚定词组] + [角色详细描述] + [镜头角度] + [景别] + [表情] + [动作] + [光照] + [场景] + [输出格式]
关键原则:锚定词组必须出现在提示词的最前面。变量层描述不能与锚定层冲突。
步骤四:漂移诊断与修复
若生成结果出现漂移,按以下流程诊断:
- 面部漂移:检查锚定词组中的瞳色、脸型描述是否被变量层覆盖。修复方案:强化锚定词组,将其重复出现在提示词末尾。
- 发型漂移:检查发型描述是否过于笼统。修复方案:在锚定词组中加入更具体的发型特征词。
- 服装漂移:检查服装描述是否被场景描述干扰。修复方案:将服装描述移至锚定词组之后、变量层之前。
- 气质漂移:检查整体气质描述是否与镜头情绪冲突。修复方案:在变量层中明确“保持角色核心气质不变”。
步骤五:批量分镜生成
当同一角色需要在多个分镜中出现时,使用以下策略:
- 所有分镜共享同一锚定词组
- 变量层按镜头需求变化
- 每生成3-5个分镜后,用基础设定层的三视图做一次一致性比对
- 若发现漂移趋势,立即回溯修正锚定词组
角色一致性问题,表面上是提示词技巧问题,本质上是工程管理问题。
单张立绘思维将角色视为“一张图”,所以每次生成都是重新开始。角色资产工程思维将角色视为“一套参数系统”,所以每次生成都是调用同一组核心参数。
DZS-角色资产生成框架的价值不在于它写得多复杂,而在于它将角色定义、资产扩展、分镜组装、漂移诊断整合为一个可复用、可迭代、可协作的工作流。锚定层与变量层的强制分离,让角色核心特征在任何镜头中都不会被稀释。
当角色资产包建立完成,分镜制作就不再是“抽卡碰运气”,而是“调用参数出结果”。产能瓶颈从“AI不稳定”转移到“创意和节奏设计”——这才是创作者应该投入精力的地方。
下一步的进化方向,是将角色资产包与场景资产包、道具资产包进行交叉锚定,建立完整的“世界观资产管理系统”。届时,AI辅助国漫制作将真正进入工业化阶段。
本文由 @抖知书 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务


- 目前还没评论,等你发挥!