起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Agent记忆系统的设计实践:一张表、一个索引、三套淘汰策略


当模型本身的推理能力逐渐抹平差距,Agent产品之间的分水岭悄悄转移到了记忆系统。从会话上下文的简单拼接,到跨会话的长期记忆,再到可被检索的语义知识,一个Agent能记住什么、记住多久、在该忘的时候敢不敢忘,决定了它是玩具还是工具。本文拆解Agent记忆分层落地的工程细节,分析一张表的设计、一个索引的使用和三套淘汰策略。
记忆分层解决三个具体问题
上周帮一个朋友体验他们的Agent产品,发现了一个很实际的问题:模型用的是deepseek v4.1,输出质量也很高,但token消耗非常高,简单的问题也需要几十万token。进一步进行分析,发现每次对话都是第一次见面。用户说过的偏好、问过的问题、踩过的坑,一但跨了会话,Agent 一概不记得。
当模型本身的推理能力逐渐抹平差距,Agent产品之间的分水岭悄悄转移到了记忆系统。记忆系统没做好,模型再强也是金鱼脑。
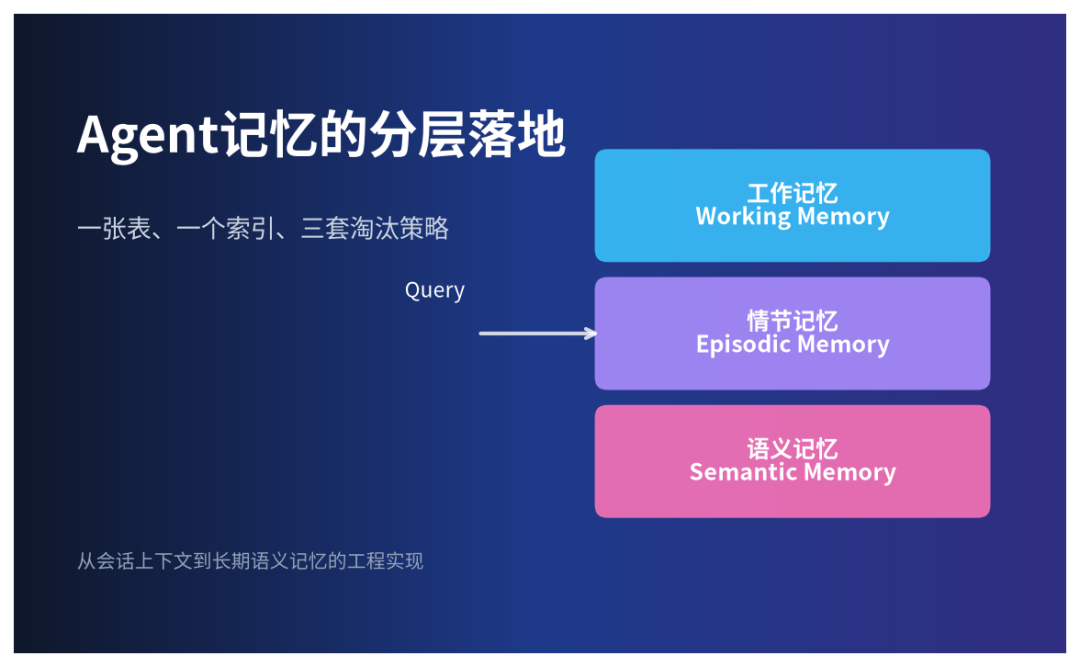
从认知科学角度,可以将Agent的记忆主要分为以下三类:
- 工作记忆(WorkingMemory):负责存储当前交互中即时相关的信息,如对话历史、任务状态,解决“上一句说了什么”的问题。
- 情节记忆(EpisodicMemory):记录过去发生过的具体事件与经历,例如“上周三用户问过退款流程”或“过去失败的操作轨迹”。解决“用户之前做过什么”的问题。
- 语义记忆(SemanticMemory):存储事实性知识、概念与用户偏好,例如“用户喜欢靠窗座位”或领域知识库,解决“用户是谁、要什么”的问题。
三种记忆如何存储和查询呢?我们首先不要把三种记忆在一张表里用同一个向量检索。因为不同的记忆有不同的特征:工作记忆记录最近N轮的对话,可以走时间序;语义记忆记录长期的偏好,可以走向量检索;情节记忆介于两者之间——既需要时间线,也需要语义召回。
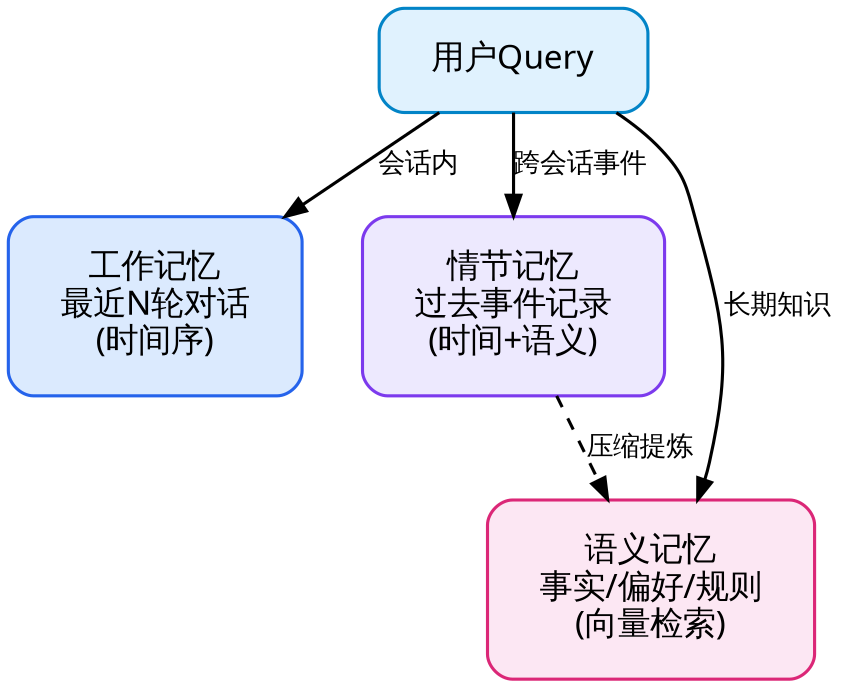
图1:三层记忆模型
一张表存三层:字段设计
我们可以用向量数据库来设计数据表的字段,当然也可以用PGSQL的vector插件来实现。在PGSQL中可以在一张表承载三种记忆类型,靠memory_type字段区分,靠不同的索引区分访问路径。

- role:user/assistant/system,区分对话角色。
- embedding:向量列,维度必须与所用embedding模型输出一致,换模型要同步改。
- importance:0到1的重要度,决定排序权重和TTL时长。
- hash:内容哈希,配合UNIQUE约束做幂等写入,重复内容不入库。
- memory_type:working/episodic/semantic,检索时按类型走不同索引。
三层记忆共用同一套embedding空间:工作记忆按时间序取;情节记忆和语义记忆走向量召回,共用同一条HNSW索引。
写入:去重、打分、TTL
记忆写入的时候不能直接INSERT。一条记忆要经过三个步骤:
1. 去重
对content做sha256,取前32字符存hash列,用INSERT…ONCONFLICTDONOTHING。聊天场景下重复率不低,去重能省下大量写入和向量索引空间。
2. 重要度打分
有两种做法:
- 规则打分:含关键词(偏好、记住、不要、总是、以后)每条加0.3,长度在20到200字加0.2,上限1.0。
- 模型打分:用小模型判断“这条信息对未来对话有多重要”,输出0到1。效果好但每次写入多一次模型调用。
3. TTL设置
expires_at默认now()+7天,重要度高于0.7的延长到30天,语义记忆延长到90天。过期数据由定时任务批量DELETE,不要让前端每次查询带过期过滤。

图2:写入流水线
召回:双通道加token预算截断
召回是整个记忆系统最容易翻车的地方。单走时间序会丢长期信息,单走向量检索会丢当前上下文。
可以用双通道:
- 通道A(工作记忆):按session_id取最近8轮,ORDERBYcreated_atDESCLIMIT8。保证上下文连贯,这部分是骨架,不能丢。
- 通道B(情节加语义记忆):对当前query做embedding,用<=>算子取余弦相似Top10,按importance加权排序。这部分是血肉,提供长期信息。
合并后按token预算截断。关键算法:给每条记忆估算token数,从通道A开始累加,超过预算就停;通道B的记忆先压缩成摘要再塞,保证长期信息不被挤掉。
以下是一个具体示例:
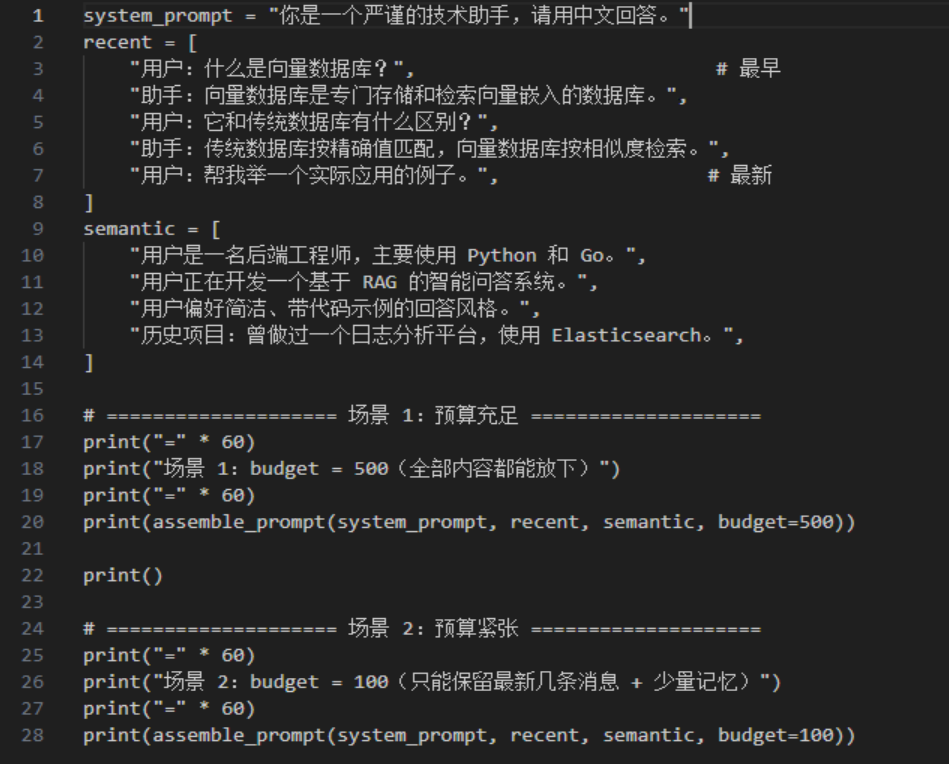
这里有个容易被忽略的点:系统提示必须在预算计算前就占用,且不可被压缩。否则长期记忆一多,系统角色设定会被挤掉,Agent会失忆。
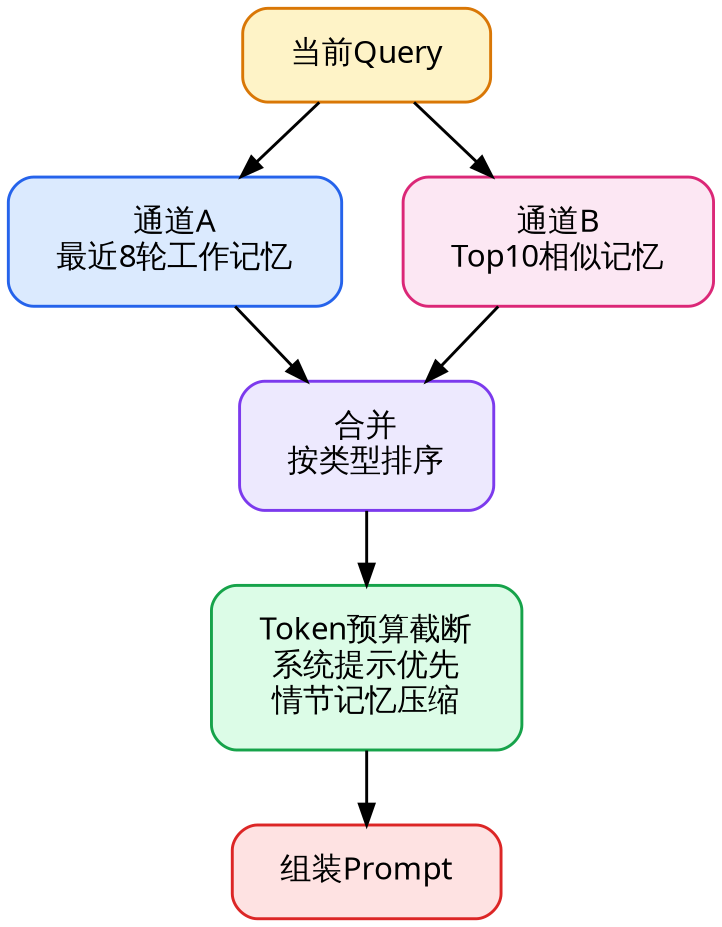
图3:召回双通道
压缩与遗忘
记忆会无限增长,所以需要有淘汰策略。以下三套策略回答三个不同的问题:什么时候直接删、删之前先把什么留下、什么情况下不新增。
第一套,TTL 过期清理。上文提到的一张表中的expires_at字段在这里兑现。定时任务每10分钟扫一次,分批删除,单批控制在5000行以内,别一次删几十万行会把IO打满:
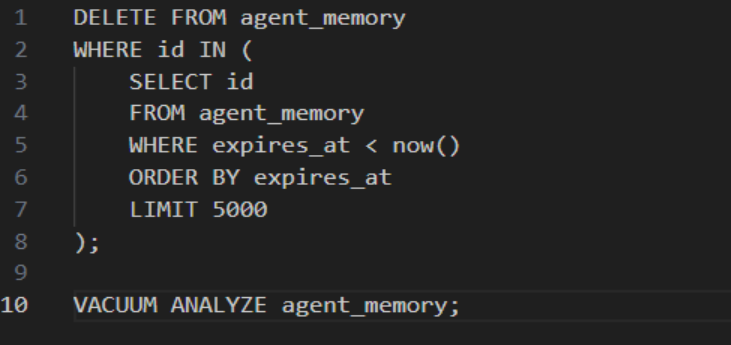
注意 VACUUM。只 DELETE 不做这一步,HNSW 索引里会留下死节点,查询延迟随删除量线性上升——这是最常见也最难定位的性能衰退。
第二套,情节记忆降级。超过 30 天的情节记忆不直接丢弃,先用小模型生成一句摘要,写成一条新的semantic记录,再删原记录。TTL 是丢弃,降级是压缩。把“上周三他问了一遍报销流程”变成“该用户关注报销流程”,表变小,信息密度变高。
第三套,语义记忆相似度合并。新写入的语义记忆与已有记录相似度大于 0.92 时,合并内容而不是新增。这条严格说是减冗余,防止同一个偏好被存十份,召回时Top10全是同一件事的不同说法,把真正有用的信息挤出预算。
正常人类的记忆也有遗忘机制,遗忘非常重要,工作记忆如果不遗忘,prompt会被无关的寒暄塞满,反而淹没真正重要的信息。
最小可跑实现
给一段Python代码,用psycopg2加pgvector实现写入、召回、打分。embedding函数用占位,接你自己的模型。
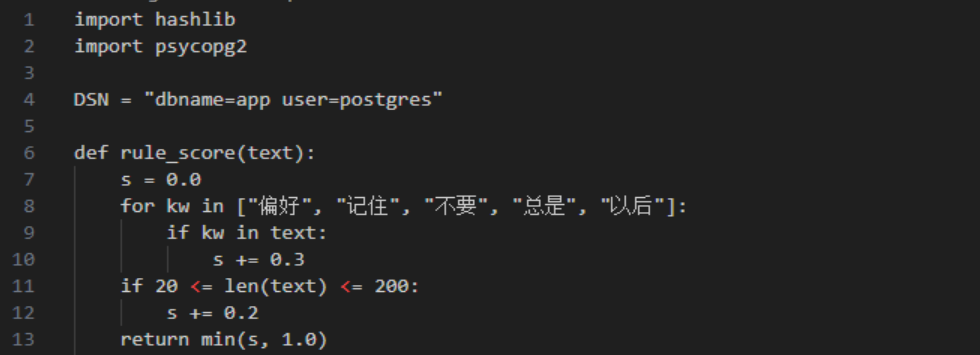
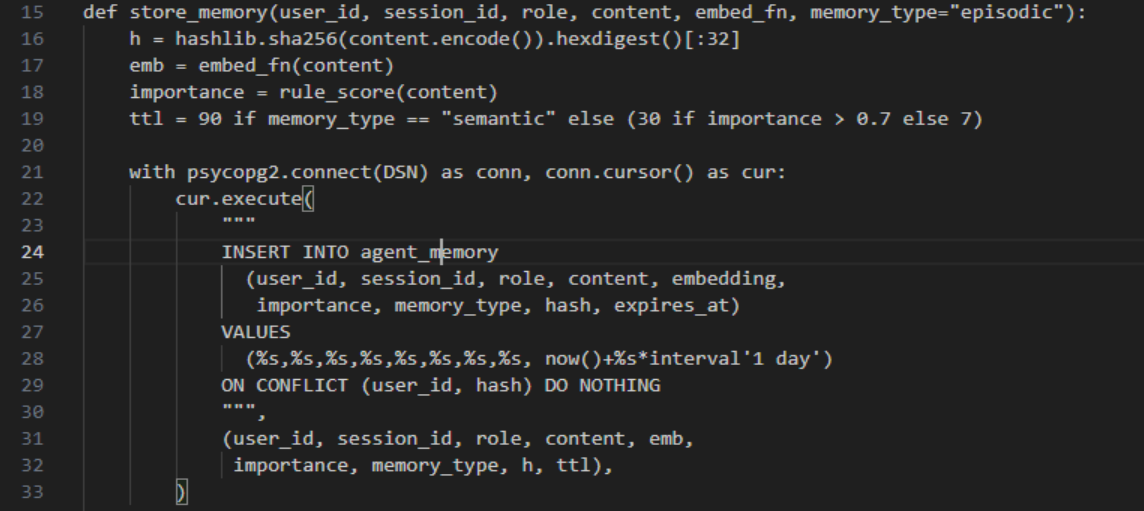
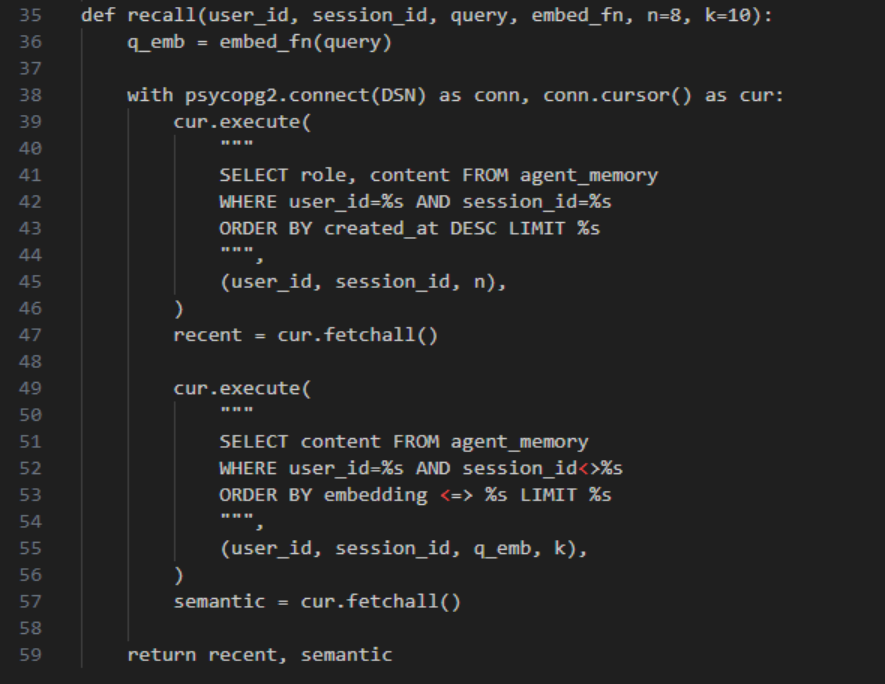
这段代码把embed_fn换成你用的embedding接口,就能看到完整的写入召回闭环。
踩坑清单
- embedding模型切换可能导致向量维度变化:建表时向量维度写死了,换模型要加新列双写,不能直接ALTER改维度。
- 重要度打分全靠规则可能导致“记住”被滥用:用户发现说“记住”就能被记住,反而降低真实记忆质量。可以用模型打分兜底,但模型打分也是一种消耗。
- TTL删数据没有先处理向量索引:直接DELETE会让HNSW索引残留死节点,查询变慢。批量删除后要VACUUM或定期重建索引。
- 多用户场景下session_id没隔离:不同用户的记忆串了,必须在所有查询里带user_id过滤,且索引要以user_id为最左列。
- 语义记忆不做去重合并:同一个偏好被反复入库,召回时Top10全是同一件事的不同表述,挤占了其他信息的位置。
本文由 @会说话的小文 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自作者提供

- 目前还没评论,等你发挥!