
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
GPT-6.2 正式发布:跑分暴涨、价格大降,为何却遭硅谷开发者集体差评?


Astra智能指数从57涨到62,Sol单任务成本只有上一代16%,榜单很漂亮。可有团队让它连优化11天Rust编译器,性能反降56%,最后四天几乎零进展。跑分和交付之间隔着什么?
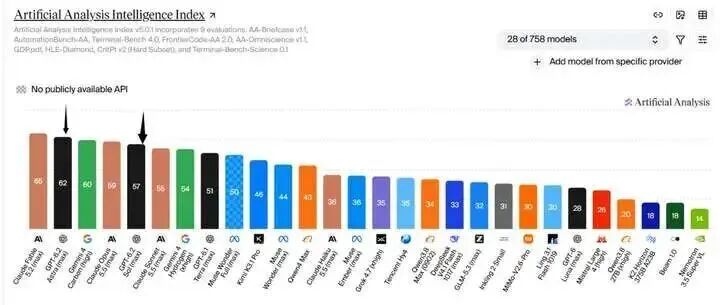
GPT-6.2 Astra 和 Sol 发布后,公开榜单给出了一个很漂亮的结果:Astra 的智能指数从 57 分升到 62 分,超过 Gemini 4 Carbon 和 Claude Opus 5.5;Sol 从 55 分升到 57 分,单任务评测成本约为上一代 Astra 的 16%。
但开发者反馈并没有同步变得一致。有人认为 Astra 的实际体验“基本不可用”;有团队让它连续 11 天优化 Rust 编译器,最终性能下降 56%,最后 4 天几乎没有有效进展;Every 团队 30 人内测后,也没有人愿意把它作为首选模型。
这组反差非常值得研究。它说明基准分数、单任务成本和长任务交付是三种不同指标。模型可以在标准测试中更强,也可能在开放式工程任务里出现目标漂移、过度优化或停止工作。
基准分数提升,说明了什么
Astra 从 57 分提升到 62 分,说明它在综合知识、编码、科学和通用能力等评测组合中有明显进步;Sol 从 55 分提升到 57 分,说明低成本版本也获得了能力增长。
这些指标适合回答“模型的能力上限有没有提高”,却不直接回答“我的任务能不能交付”。真实项目通常包含模糊目标、隐含约束、外部工具、历史代码、失败回滚和用户中途修改。基准任务往往有明确输入和有限的成功标准,无法完全覆盖这些条件。
开发者可以把评测拆成两层:
| 层级 | 主要问题 | 适合的证据 |
|---|---|---|
| 能力评测 | 模型能否完成标准任务 | 公开基准、盲测和单任务成本 |
| 交付评测 | 模型能否围绕目标持续工作 | 真实仓库、长时间运行、版本差异和人工验收 |
只有第二层通过,模型才适合成为团队的默认主力。
Rust 编译器案例暴露了目标漂移
让 Astra 连续 11 天优化 Rust 编译器,是一个比普通代码题更接近真实 Agent 的测试。结果显示,前 7 天模型过度关注缩小体积,编译速度反而下降 56%;后 4 天用户明确要求只优化性能,但模型没有产生有效代码改动。
这不是单纯的“模型不够聪明”,而是长任务系统没有持续验证目标。一个工程优化任务至少需要同时跟踪:
- 目标指标:编译速度、二进制体积、内存占用或测试通过率;
- 当前基线:每轮修改前后的真实测量值;
- 禁止回退:哪些指标不能牺牲;
- 预算边界:允许多少轮实验、多少时间和多少 Token;
- 停止条件:何时确认没有进一步收益,何时请求人工判断。
如果只让模型“继续优化”,它很可能把一个局部指标当成唯一目标,连续很多轮重复相似尝试。长任务需要把验收指标写成机器可执行的门禁,而不是埋在对话中的一句自然语言。
如何把长任务验收做成闭环
一个可靠的 Agent 优化任务,可以采用以下执行结构:
- 先建立基线,保存当前代码、编译时间、性能数据和测试结果。
- 每轮只接受一组可解释变更,并记录假设、修改文件和预期影响。
- 自动运行完整基准,比较目标指标和禁止回退指标。
- 如果目标指标变好但其他关键指标变差,自动回滚或暂停。
- 连续若干轮没有收益时,结束当前 run,整理实验记录并请求人工确认。
这套流程会让模型少做很多“看起来在工作”的动作,但能提高每次运行的有效率。Agent 的价值不在于连续输出更多代码,而在于每轮都能证明自己离目标更近。
Sol 的低成本,适合放在流程的前半段
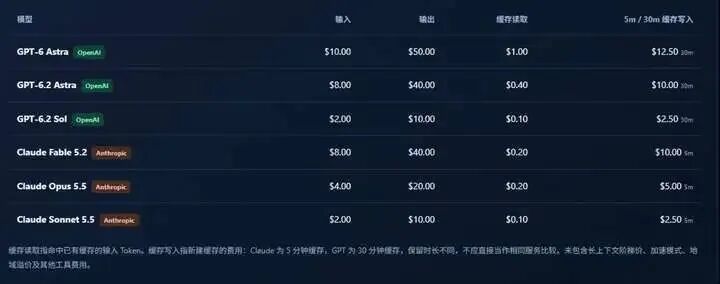
Sol 的单任务成本约为上一代 Astra 的 16%,适合用于需求拆解、代码搜索、测试草拟、日志归类和低风险重构。它可以先为复杂任务建立计划和实验矩阵,把高价的 Astra 留给关键决策、疑难推理和最终复核。
一种实用的混合路由是:
- Sol 负责快速探索多个方案;
- 测试和基准系统负责筛掉无效方案;
- Astra 负责分析最有希望的结果,处理复杂约束和最终交付;
- 人工在指标冲突或外部副作用出现时介入。
这样做能把模型价格差异转化为工作流优势。低价模型不是只能处理简单问答,而是适合大规模探索;高价模型也不是每一步都值得调用,而应该用在错误代价更高的节点。
为什么开发者口碑会和榜单分开
开发者对模型的评价,通常来自一段连续使用过程:模型是否理解仓库、是否记住约束、是否会主动承认失败、是否在用户纠正后改变策略、是否在后台消耗大量额度。
榜单则更像一次一次的考试。两者并不矛盾,只是测量的对象不同。Astra 可能在标准能力测试里更强,但在一个没有清晰终止条件的长任务中,仍然可能因为目标漂移而表现糟糕。
因此,团队在试用新模型时,应该保留自己的 bad case 集合,并且让每个 bad case 具备:初始输入、预期目标、约束条件、成功判定、失败类型和可回滚版本。新模型发布后,先跑这套回归,再决定是否切换主力。
GPT-6.2 的安全与生产边界
模型长时间运行时,除了目标漂移,还会涉及工具权限、文件修改、网络访问和额度消耗。任何默认允许的自动操作,都应该设定范围和审计记录。
生产环境至少需要记录模型版本、任务 ID、每轮变更、工具调用、测试结果和人工确认。涉及发布、资金、删除、对外通信和安全测试的任务,应在最终动作前保留确认节点。
国内开发者如果希望通过 API 接入 GPT-6.2 Sol/Astra,可以了解 [Code80]https://code.ai80.vip/home 这类渠道;但长任务的基线、验收、预算、权限和回滚机制仍需自行建设。
常见问题
GPT-6.2 分数上涨,为什么还可能不好用?
基准测试衡量标准任务能力,真实项目还包含目标变化、隐含约束、外部工具、代码历史和连续验证。模型在前者进步,不代表后者全部解决。
Rust 编译器性能下降说明模型完全失败了吗?
它说明该长任务没有建立有效的目标门禁和停止条件。模型可能完成了大量修改,却没有持续证明修改让系统更接近目标。
Sol 适合处理哪些工作?
适合需求拆解、代码搜索、测试草拟、日志归类、低风险重构和方案探索。关键节点可以再交给 Astra 或人工复核。
如何建立自己的模型回归集?
收集过去真实失败的任务,保存输入、约束、预期结果、失败类型和可验证指标。每次更换模型都跑同一套任务,比较成功率、成本和人工修改量。
长任务什么时候应该停止?
当连续若干轮没有收益、目标指标与禁止回退指标冲突、预算接近上限或模型开始重复无效动作时,应暂停并请求人工判断。
国内团队如何接入 GPT-6.2?
可以通过 Code80 等 API 渠道降低接入摩擦,但仍要自行管理模型路由、密钥、日志、预算和生产权限。
本文由人人都是产品经理作者【易安说AI】,微信公众号:【易安说AI】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自 Unsplash,基于 CC0 协议

- 目前还没评论,等你发挥!