起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
重磅!微信把自家的AI知识库开源了


最近在做知识库相关项目,我发现微信这边有个挺容易被忽略的开源项目:WeKnora。
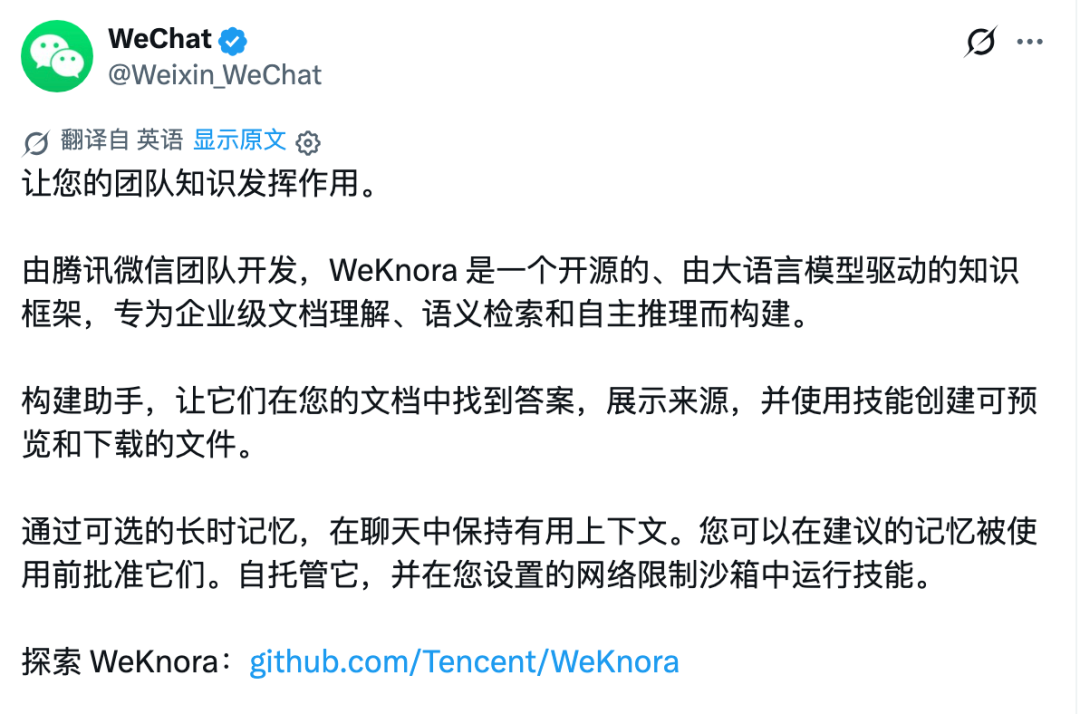
如果只看一句介绍,你可能会把它理解成又一个 AI 知识库:上传 PDF、Word,然后对着文档问问题。
但我认真看了一遍现在的 WeKnora,发现这个理解已经有点过时了。
它现在做的事情,已经从最早的“RAG 知识库”,一路扩展到了 Agent、自动 Wiki、知识图谱、长期记忆、MCP、Skill、企业权限、数据源同步,甚至直接接入微信生态。
简单来说,微信正在把一套“企业 AI 知识底座”开源出来。
先说 WeKnora 到底是什么
WeKnora 是腾讯开源的一套基于大模型的知识管理框架。
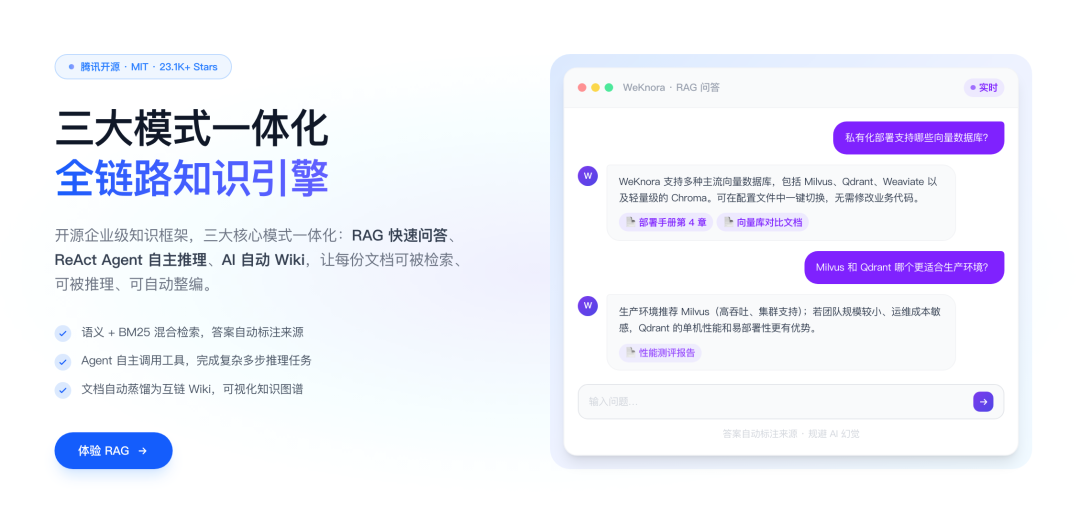
最基础的逻辑还是我们熟悉的 RAG。
比如一家公司有几千份产品文档、内部制度、客户资料、会议纪要,过去想找一个答案,需要员工自己搜索文件、翻文档。
用了 WeKnora 之后,可以把这些资料统一扔进知识库,再直接用自然语言提问。
它会先从知识库里检索相关内容,再让大模型根据这些材料生成答案,而不是完全依赖模型自己的“记忆”。
官方现在把 WeKnora 的核心能力分成了三个部分:RAG 快速问答、ReAct Agent,以及 Wiki Mode。
真正让我觉得有意思的,其实是后面两个。
它已经开始从“知识库”变成“知识工作台”
传统 RAG 产品解决的问题,其实非常明确:
我有很多资料,你帮我找到答案。
但 WeKnora 现在明显已经不满足于这个定位。
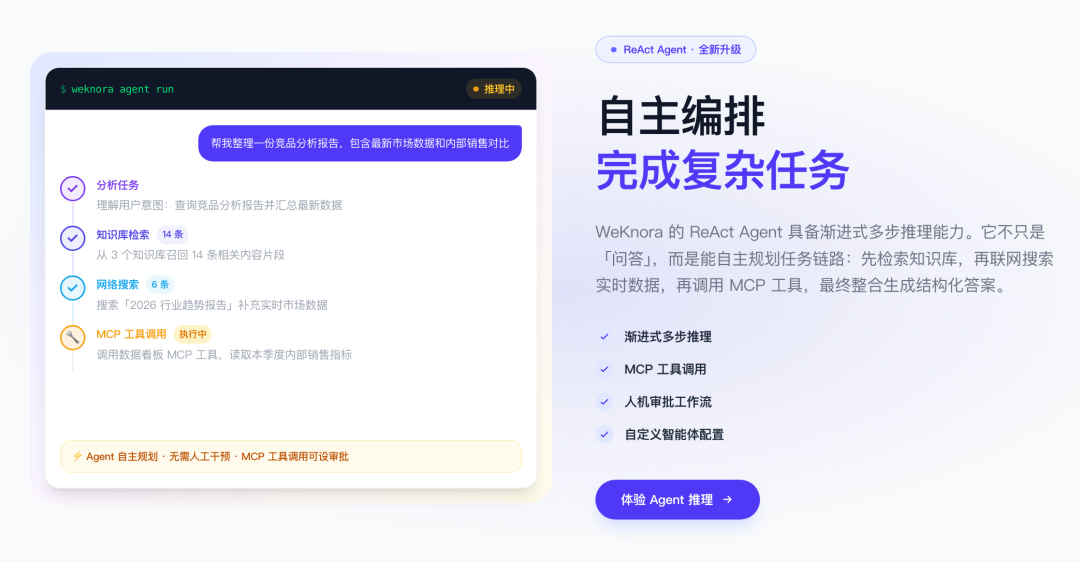
它加入了 ReAct Agent。
Agent 可以自己决定什么时候搜索知识库、什么时候调用 MCP 工具、什么时候搜索互联网,再把这些步骤串联起来完成一个更复杂的任务。
这意味着,以前是:
“帮我查一下公司去年的差旅报销标准。”
现在可以进一步变成:
“根据公司过去三年的差旅制度,找出今年变化最大的五条规则,并生成一份给员工看的更新说明。”
前者是搜索。
后者已经开始变成工作。
这也是最近一两年整个企业知识库产品最大的变化:RAG 正在从一个问答组件,变成 Agent 的知识基础设施。
WeKnora 甚至已经加入了 Skill 沙箱环境,支持 Docker、E2B、Cube 等运行后端,同时拥有跨会话长期记忆。换句话说,它开始不仅记得“公司的知识”,还可以记住用户长期关注的内容和任务。
这个产品形态,已经和两年前的“ChatPDF”完全不是一回事了。
我更喜欢它的自动 Wiki
WeKnora 另一个挺有意思的功能,是 Wiki Mode。
很多企业做知识库最大的问题,其实不是“没有资料”,而是资料太多。
飞书里一份,Notion 里一份,语雀里一份,电脑里还有几十个 Word、PDF,最后所谓的“企业知识库”,本质上就是一个巨大的文件夹。
AI 搜索虽然解决了一部分问题,但知识本身依然是乱的。
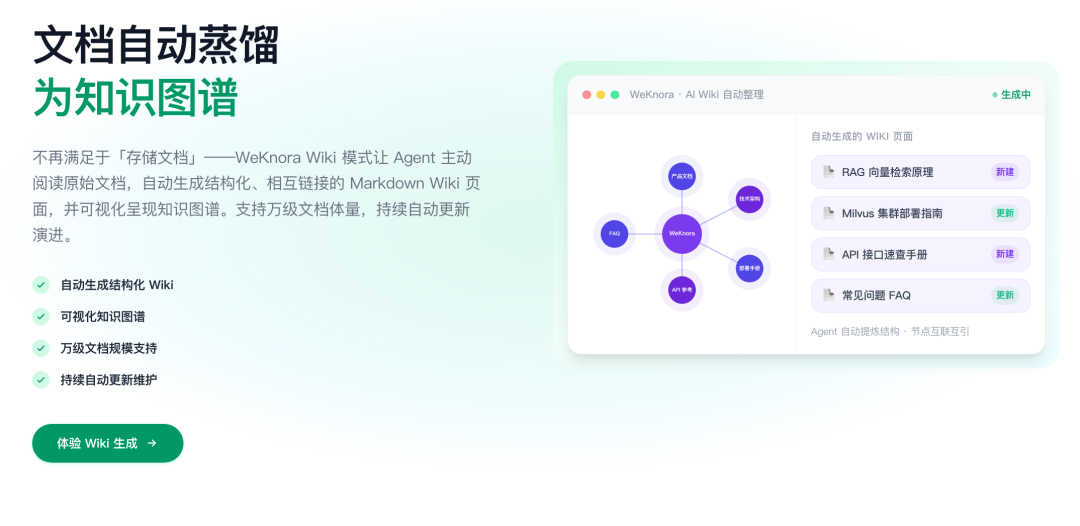
WeKnora 的思路是,让 Agent 主动阅读这些原始资料,然后整理成相互关联的 Markdown Wiki,并生成知识之间的关联关系和知识图谱。
而且这个 Wiki 不是生成一次就结束了,它支持人工编辑、版本历史和回滚。
我觉得这个方向其实比“再做一个 AI 搜索框”更值得关注。
因为未来真正有价值的企业知识产品,可能不是帮你搜索那 1 万份文档,而是能够把这 1 万份文档重新组织成一套可以不断生长的知识体系。
从“找知识”,变成“整理知识”。
这是完全不同的一层价值。
数据源也越来越像企业级产品
现在 WeKnora 已经支持从飞书 Wiki、飞书云盘、GitLab、腾讯 IMA、Notion、语雀、RSS 等来源同步知识,同时支持 PDF、Word、图片、Excel、XMind 等多种文件格式。
检索也不是简单把所有文档切块之后做向量搜索。
官方文档里已经明确支持向量检索与 BM25 关键词检索结合,再通过 RRF、Rerank 等方式重新排序,并且可以结合知识图谱进一步扩大检索范围。
另外一个企业真正会关心的问题是:模型能不能自己选?
可以。
OpenAI、DeepSeek、千问、智谱、混元、Gemini、MiniMax、Ollama 等都可以接,甚至可以直接使用本地模型。底层的 LLM、Embedding、Rerank、向量数据库和存储,也都尽量做了解耦。
这点非常重要。
企业做内部 AI 时,真正麻烦的往往不是“有没有一个模型”,而是今年用 DeepSeek,明年可能换千问;部分业务走云端,敏感数据又要求跑本地。
一个知识底座如果把模型绑死,后面迁移会非常痛苦。
但它最特殊的地方,还是微信
如果 WeKnora 只是腾讯开源的一个 RAG 框架,我可能觉得它不错,但不会觉得特别值得单独写一篇。
真正让我觉得它有想象空间的,是另一句话:
WeKnora 是微信对话开放平台的核心技术框架。
通过微信对话开放平台,企业可以把知识上传进去,再把基于这些知识构建的 AI 问答能力接进公众号、小程序等微信场景。
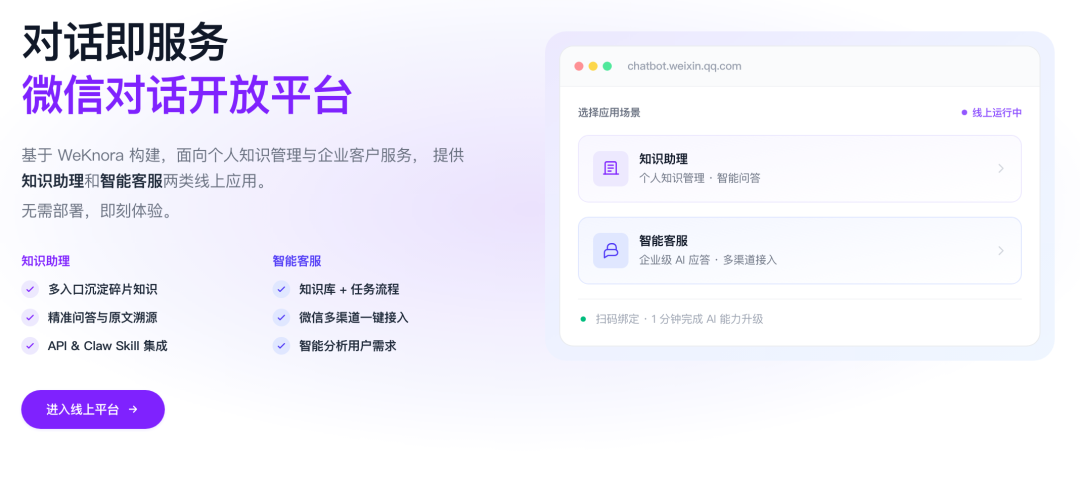
这件事的意义其实很大。
现在很多企业都在做自己的 AI 客服、产品顾问、内部助手。
技术本身已经不稀缺了。
Dify、RAGFlow、FastGPT,包括各种 Agent 平台,都能搭出类似东西。
真正困难的反而变成了:
用户在哪里使用它?
如果做完一个 AI 助手,还需要让用户再下载一个 App、注册一个账号、记住一个网址,使用门槛依然很高。
但如果 AI 最终直接出现在公众号、小程序乃至更多微信场景里面,事情就完全不一样了。
微信天然拥有中国互联网最成熟的一套用户身份、内容、服务和企业触达体系。
所以从这个角度看,WeKnora 真正值得关注的并不只是它的 RAG 做得怎么样。
而是微信正在慢慢把 知识库 + Agent + 微信入口这几件事情串在一起。
腾讯甚至没有把模型绑死
还有一个细节我觉得挺有意思。
WeKnora 是 MIT License。
也就是说,它并不是一个只能围绕腾讯云、混元才能运行的封闭方案。官方明确支持多家模型,也支持 Docker、Kubernetes,以及本地和私有化部署。
对于开发者来说,你完全可以把它拉下来,接 DeepSeek、千问或者 Ollama,再搭自己的知识库。
甚至不一定要跟微信发生任何关系。
这其实很像腾讯这几年做开源的一种思路:先把底层基础设施做成一个开放项目,再让自己的生态成为其中一个重要出口。
所以我现在看 WeKnora,更愿意把它理解成:
腾讯正在开源一套“把企业资料变成 AI 能调用的知识”的基础设施。
今天它可以是一个知识库。
再往后,它可能成为企业 Agent 的长期记忆、数据入口和知识中枢。
过去我们搭一个 AI Agent,最先考虑的是“用哪个大模型”。
但当模型越来越便宜、能力越来越接近之后,真正拉开差距的东西可能会慢慢变成另外一个问题:
你的 Agent,到底知道多少属于你自己的东西?
公司的文档、项目经验、用户反馈、业务数据、历史决策,这些模型训练时根本不知道的东西,才是企业真正独有的数据资产。
从这个角度看,WeKnora 这种项目反而值得多看一眼。
因为 AI 下一阶段真正的竞争,可能不只是模型谁更聪明。
而是谁能把散落在企业各个角落的知识,真正喂给 Agent。
本文由作者@AI星球大本营,授权发布于平台,未经许可禁止转载。

- 目前还没评论,等你发挥!