起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Jev 不是下一个 GPT,但它可能比 GPT 更该装进你的工作流


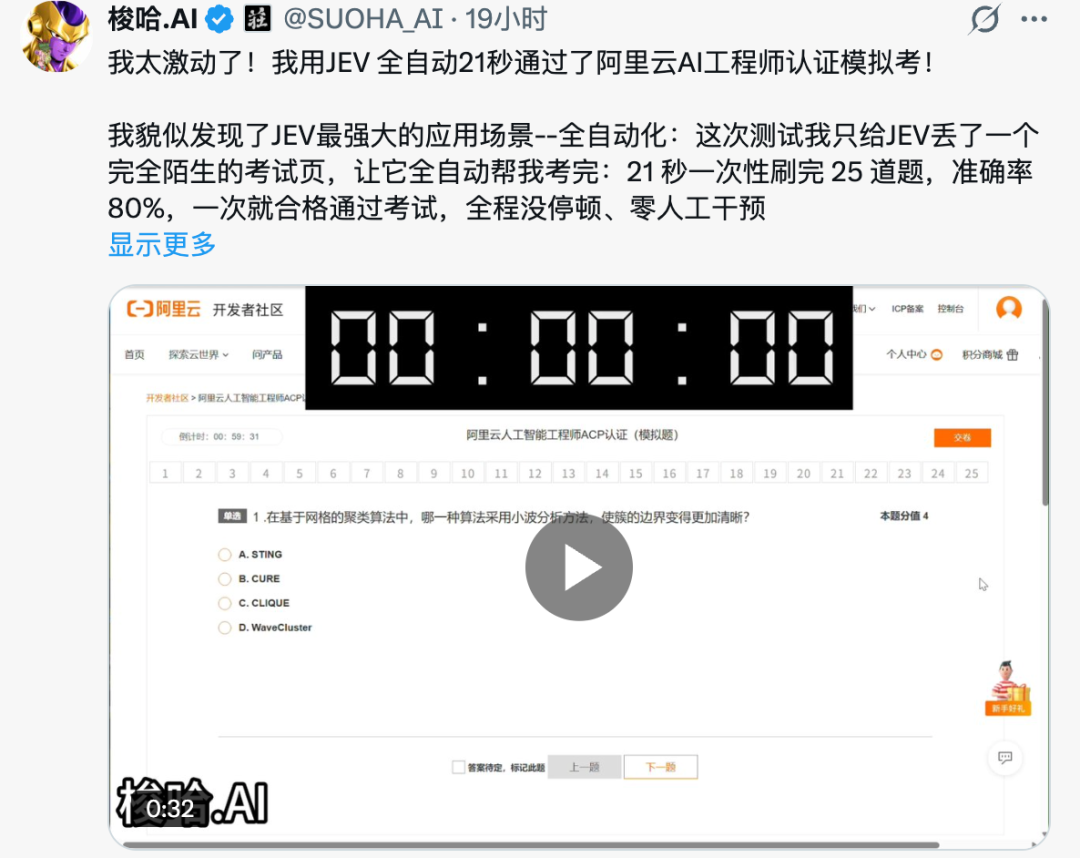
Jev 这两天在朋友圈屠版,有人拿它全自动刷完了阿里云 AI 工程师认证的模拟考试:25 道选择题、21 秒、准确率 80%,全程零人工干预。作者也用它给三版封面打分,95 秒花了一毛钱,把模糊的直觉变成了四个维度的数字,它天生就是为选择题而生的。
这两天刷朋友圈,Jev 直接屠版了。
有人拿它玩 Doom,有人拿它跑 Mario,有人拿它接浏览器自动化——7 秒找到最便宜机票的那个视频,刷了快两百万播放。Hacker News 上第一天就拿了 1679 分,Vercel 第二天就把自家 AI Gateway 接上了 Jev。
但说实话,我刷了一圈下来发现,大部分人都在炫技,真正实用的玩法没几个。
直到昨天看到一条推文,有人用 Jev 全自动刷完了阿里云 AI 工程师认证的模拟考试。25 道选择题,21 秒,准确率 80%,一次合格通过,全程零人工干预。
我当时就愣住了。
不是因为它快,快是预期之内的。而是因为我突然意识到一件事:
Jev 天生就是为选择题而生的。
选择题、问卷、表单、认证考试、满意度调查……这些东西的共同特点是什么?答案空间封闭,每道题就那么几个选项。这不就是 Jev 的主场吗?
我自己也试了一下。每次写完文章要选封面图,我会生成好几版不同风格的封面,然后来回犹豫。这次我把三版 Codex 封面丢给 Jev,让它帮我打分:
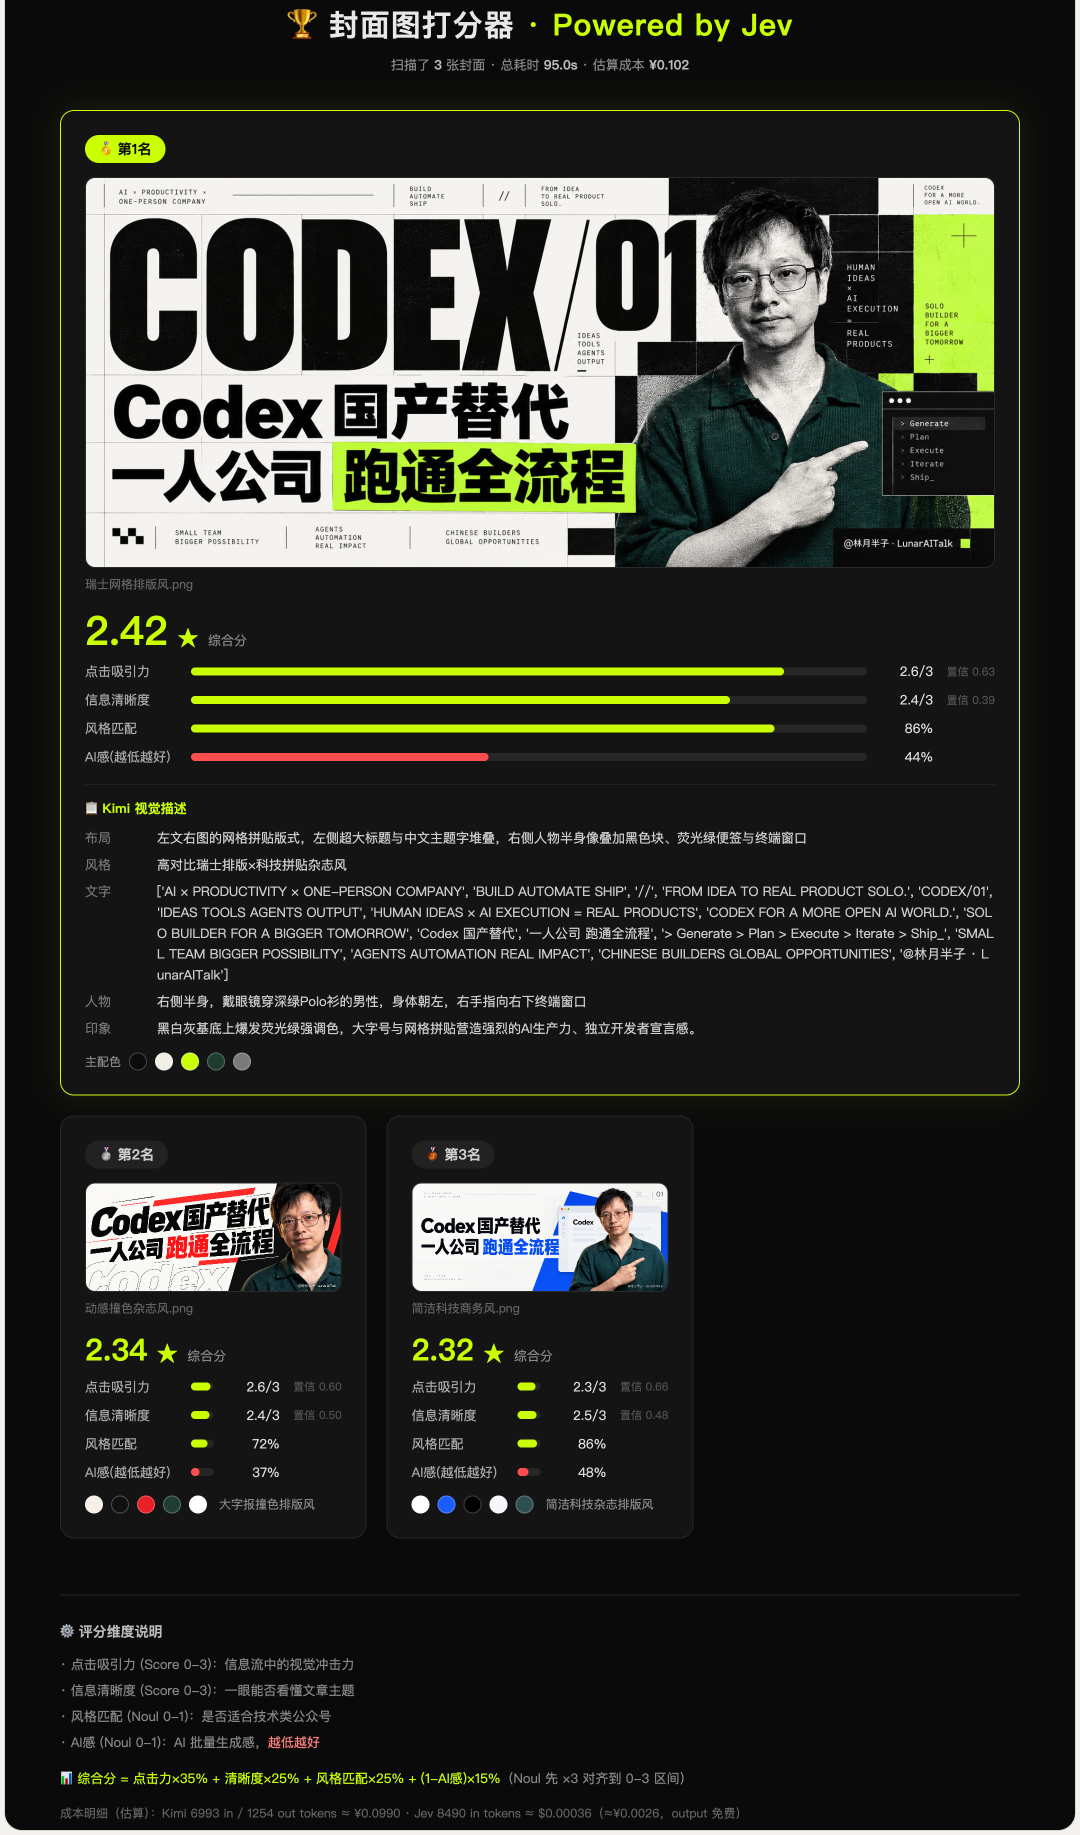
95 秒跑完,成本一毛钱。三张图的综合分分别是 2.42、2.34、2.32——差距不大,但第 3 名被精准抓到了问题:AI 感高达 48%,在三张里最重。
这个直觉,人脑能隐约察觉,但说不出具体哪里不对。Jev 帮你把这个模糊的感觉变成了四个维度的数字。
怎么做到的?后面会讲。先搞明白 Jev 到底是什么。
Jev 到底是个啥
先说背景。发布 Jev 的公司叫 TypeSafe AI,创始人 Diogo 之前在 OpenAI,是 RLHF 的共同发明人之一——就是让语言模型学会听指令、会聊天的那套方法的作者之一。
有意思的是,他据说在做完 ChatGPT 之后,花了整整两年研究一套全新的训练方法,最后做出来的东西正好相反:一个不会聊天的模型。
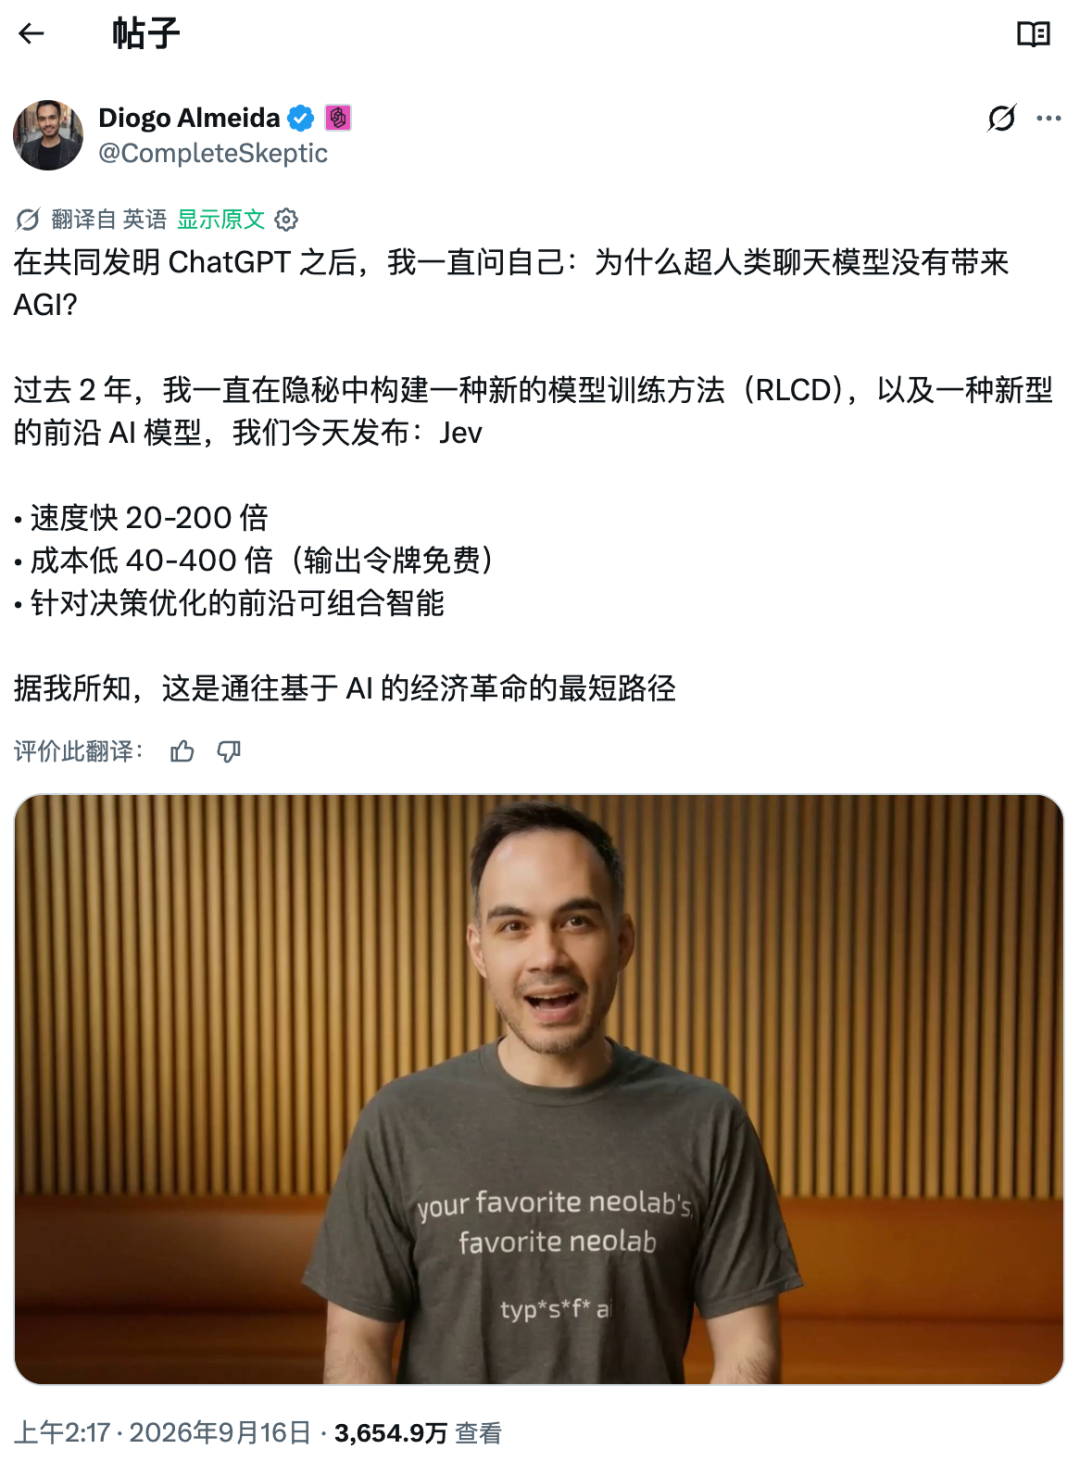
你平时用 Claude、用 GPT,给它一个问题,它一个 token 一个 token 地往外写一段话。Jev 不干这个。你给它一段信息和一组问题,它只返回:选哪个、打几分、是不是,每个答案带一个概率。
完事了。不解释,不废话,不输出一个多余的字。
如果还觉得抽象,换一个比喻:一般的大模型像是在写申论题,Jev 则像是在做选择题。 申论题得一句一句慢慢写,不但慢,还可能跑题;选择题只需要圈一个答案,速度极快,而且答案绝对不会跑到选项之外。
它的名字也藏着野心。Jev 取自经济学中的“杰文斯悖论”:当一样东西变得越便宜、效率越高,人们反而会用得越多。TypeSafe 的判断是,把“判断”的成本压到接近于零,人们就会在原本舍不得判断的地方,都插上一个判断。
三种题型
Jev 能做三种题:
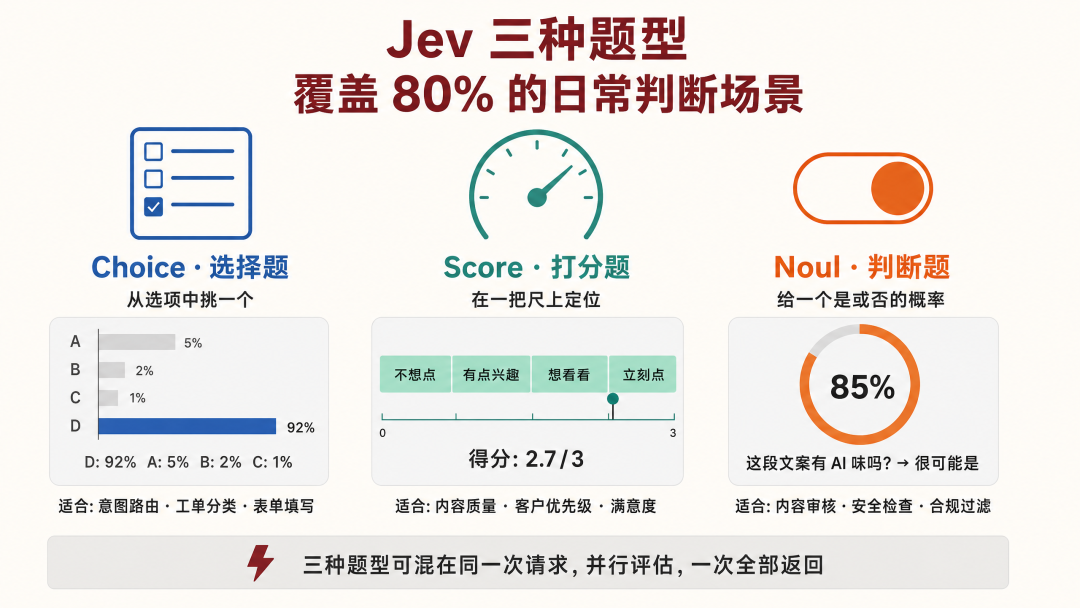
Choice — 选择题。 给它几个选项,它告诉你选哪个,每个选项概率分别多少。选项完全由你定义,最多 255 个,每个还能搭配一句说明。做表单、做问卷、做路由分发,最常用的就是这个。
Choice(
instructions=”在基于网格的聚类算法中,哪一种算法采用小波分析方法?”,
criteria={“A”: “STING”, “B”: “CURE”, “C”: “CLIQUE”, “D”: “WaveCluster”},
)
Noul — 判断题。 问一个是非问题,它返回“是”的概率。越接近 1 越确定是“是”,越接近 0 越确定是“否”,0.5 附近表示它也拿不准。比如:这封邮件是不是诈骗?这段文案 AI 味重不重?
Noul(instructions=”这个标题读起来有明显的 AI 生成味道吗?”)
Score — 打分题。 你先画一把尺,从低到高写出每个档位代表什么,最多 11 级。它告诉你当前情况落在哪个位置。比如给潜在客户打分:0 分是没预算的学生,3 分是预算充足的大企业。
Score(
instructions=”这个标题对目标读者的点击欲望有多强?”,
criteria=[“几乎不想点”, “有点兴趣”, “想点开看看”, “非常想立刻点开”],
)
有个很关键的设计:这三种问题可以混在同一次请求里,并行评估,一次全部返回。 不用先问第一题等答案回来再问第二题。25 道题一次性全丢进去,毫秒级出结果。
实操:批量刷选择题
来,跟着我跑一遍。
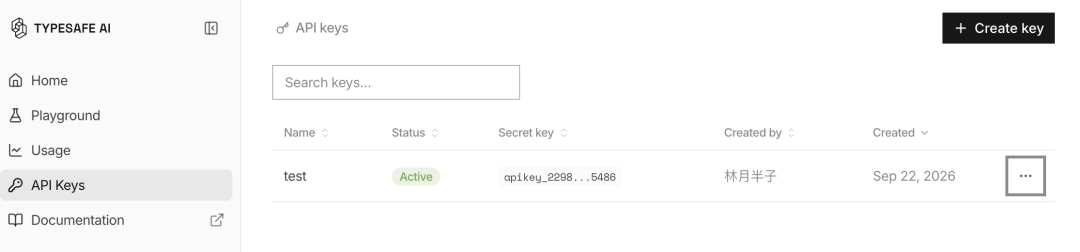
第一步:注册拿 Key
去 TypeSafe AI 官网,邮箱验证通过就能拿到 API Key,两分钟搞定。
第二步:装 SDK
pip install typesafe-sdk
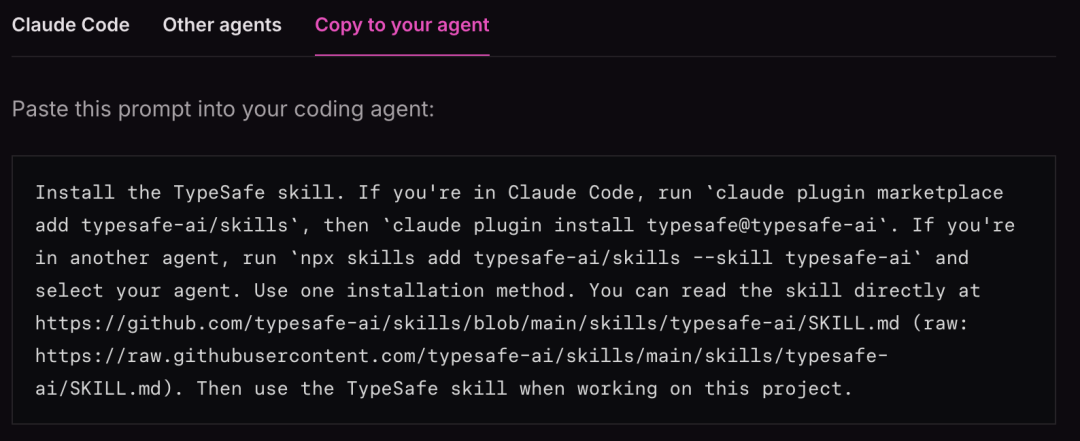
如果你用 Claude Code 或 Codex 这类编程 Agent,可以直接装官方 Skill,装完之后 Agent 在涉及判断、分类、路由的任务时会自动调用 Jev:
别忘了设置环境变量:
export TYPESAFE_API_KEY=”你的 API Key”
第三步:写脚本
假设你有一份 5 道选择题的模拟卷。核心代码不到 20 行:
from typesafe_sdk import Choice, TypeSafeClient
questions = {
“q1″: Choice(
instructions=”在基于网格的聚类算法中,哪一种算法采用小波分析方法,使簇的边界变得更加清晰?”,
criteria={“A”: “STING”, “B”: “CURE”, “C”: “CLIQUE”, “D”: “WaveCluster”},
),
“q2″: Choice(
instructions=”以下哪项技术最适合处理高维稀疏数据的分类任务?”,
criteria={“A”: “决策树”, “B”: “支持向量机”, “C”: “朴素贝叶斯”, “D”: “K近邻”},
),
# … 继续添加
}
with TypeSafeClient() as client:
resp = client.system_one(
state={“exam”: “阿里云AI工程师认证模拟题”},
questions=questions,
)
for qid, answer in resp.choices.items():
print(f”{qid}: 选 {answer.choice}, 置信度 {answer.confidence:.0%}”)
跑一下,几秒钟全部出结果。
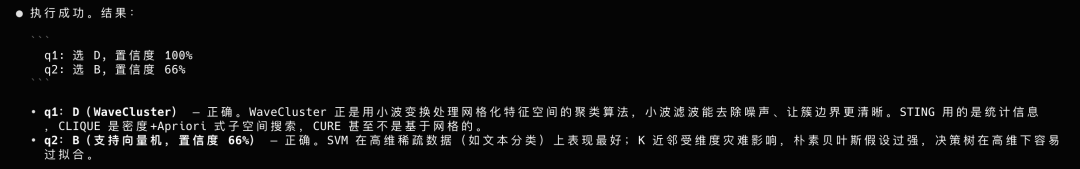
state 不一定只写题目名称。你可以把考试大纲、知识点整理、甚至参考资料直接塞进 state 里当“小抄”。Jev 的 state 支持直接传 JSON 对象,不用拼成自然语言,准确率会高不少。
我自己的场景:让 Jev 帮我选封面图
做选择题只是热身。我真正想拿 Jev 干的,是帮我选公众号封面图。
写过公众号的人都知道,每次发文之前最纠结的环节之一就是选封面。我一般会让 AI 生成好几版风格不同的封面图,然后在几张之间来回对比、犹豫、挑选。比如上次写 Codex 那篇,我生成了三版——动感撞色杂志风、瑞士国际主义网格风、简洁科技商务风——三张都还行,但选哪个?每次都靠感觉。
现在有了 Jev,我做了一个小工具:把“选封面”这件事也变成一道选择题。
Jev 有一个限制:它不能直接看图。所以我的思路是搞一条流水线。
Kimi 看图 → 输出结构化描述 → Jev 按四个维度打分 → 自动排名
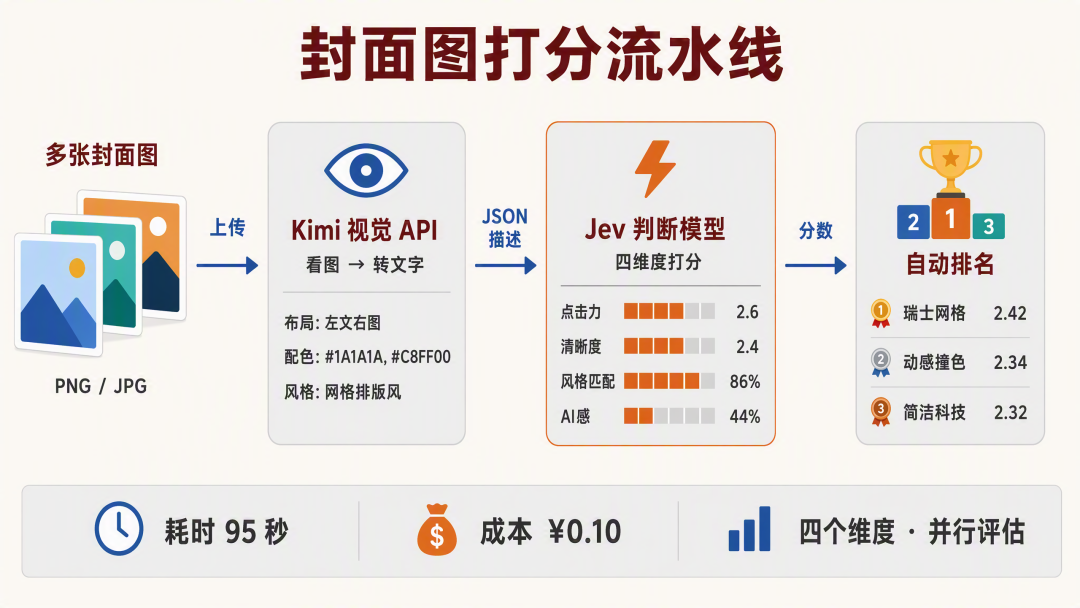
具体来说,先用 Kimi 的视觉 API 把每张封面图转成一段结构化的 JSON 描述:配色方案、文字内容、版式布局、人物位置、整体风格。然后把这段描述丢给 Jev,同时问四个问题:
- 点击吸引力(Score):在信息流里,这张图能不能让人停下来?
- 信息清晰度(Score):扫一眼就能看懂文章主题吗?
- 风格匹配(Noul):适不适合技术类公众号?
- AI 感(Noul):看起来像模板套出来的吗?越低越好。
我把三版 Codex 封面扔进去跑了一遍,结果出来了:
第 1 名是瑞士网格排版风,综合分 2.42。Kimi 给的描述是“黑白灰基底上爆发荧光绿强调色,大字号与网格拼贴营造强烈的 AI 生产力、独立开发者宣言感”。点击吸引力 2.6/3,风格匹配度 86%,整体最均衡。
第 2 名是动感撞色杂志风,综合分 2.34。点击力同样是 2.6/3,但风格匹配只有 72%——Jev 觉得它“杂志感太重”,偏离了技术类公众号的调性。
第 3 名是简洁科技商务风,综合分 2.32。信息清晰度其实最高(2.5/3),但点击吸引力只有 2.3/3——太“正经”了,在信息流里不够抢眼。而且 AI 感高达 48%,三张里最重。总耗时 95 秒,成本一毛钱。
有意思的是,三张图的分数差距其实很小(0.10 分)。这说明三版封面质量都还行,没有明显的“废稿”。但 Jev 帮你做的事情是:把“都还行但说不出谁更好”的感觉,拆成了四个可以对比的维度。第三版的 AI 感 48% vs 第一名的 44%,差距不大,但一旦量化出来就不再模糊了。
这里的关键是 Kimi 视觉描述的质量。Jev 看的是文字,不是图片本身,所以描述越精确,打分越准。我让 Kimi 输出结构化 JSON 而不是散文:配色用 hex 色值,布局用“左文右图”,文字原样抄出来。效果比一段笼统的描述好很多。
什么时候用,什么时候别用
用了两天,我的判断:
适合用: 答案空间能提前定义好的——分类、路由、打分、验证、选择题。以及需要高频批量判断的——一天跑几百上千次的场景。在这些地方调大模型做判断,就像开挖掘机去种花,大材小用。
不适合: 需要解释的——它只给概率不给理由。需要生成内容的——它不会写字。选项设计不好的——正确答案不在你给的选项里,它还是得硬选一个,概率再分散也没用。 这一点很重要。官方也承认,Jev 的难点从“写提示词”变成了“设计选项”。你得保证正确答案在选项里面。
还有一个代价要提:复杂度不会消失,只会转移。 Jev 帮你省掉了大模型的生成成本,但你得按它的格式组织输入,输出也得自己写代码处理和拼接。它不像 ChatGPT 那样“随便说两句就能用”,更像是一个有 AI 加持的高级 if else——确实比硬编规则聪明,但离“开箱即用”还有距离。对开发者来说这不是问题,但如果你期待的是“问一句就给完整答案”,那它不是你要找的东西。
还有一点,它是闭源托管的 API,没有公开权重。隐私敏感的场景需要自己掂量。
写在最后
我估计后面大模型厂商都会跟进这个方向。
不要问哪个模型最强,要问哪个模型最适合你当下的工作流。就像以前大家就知道,用聪明的模型来做规划,用便宜的模型去跑苦力。
现在武器库里又多了一个专职的决策模型——它不负责思考,只负责做判断。
该写文章的交给大模型,该做选择题的交给 Jev,该用代码的还是用代码。
把“判断”的成本压到接近于零之后,你会发现到处都值得插一个判断。
这大概就是杰文斯悖论在 AI 时代的样子。
作者:林月半子的AI笔记 公众号:林月半子的AI笔记
本文由 @林月半子的AI笔记 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议


- 目前还没评论,等你发挥!