起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
谷歌这个开源模型被低估了


谷歌开源 EmbeddingGemma 2 时几乎没激起水花,注意力全在聊天模型上。这个能把四种模态压进同一空间的小模型,配合本地语义搜索工具 DigUp 与二进制逆向项目 REA,构成了这次发布真正被低估的那部分。

谷哥最近给我的惊喜不断啊,一是它的 Gemini 3.8 Flash 在 Antigravity CLI 里相当可靠:我的 Gemini 终于要回本了,开发了一个 macOS
二是附送的Colab Pro可以使用英伟达A100,我在这里面部署了Qwen3.8-27B:Gemini Pro 大礼包,英伟达A100我用上了,成功部署 Qwen3.8-27B,还测试了 Strata部署Qwen3.8-Flash-Next:大模型推理引擎新晋王者,消费级显卡跑千亿大模型,Qwen3.8-Flash-Next本地部署,实测超快!
最近它又开源了 EmbeddingGemma 2,我刷了一圈,几乎没什么水花
大家的注意力都在聊天模型和编程 Agent 上,一个 740M 参数的 Embedding 模型,听起来实在不够性感
今天刚发现有人拿它做出了一个完整的 Mac 应用,越看越觉得:这东西被严重低估了
它瞄准的是每个人都有的痛点:电脑里的东西越来越多,越来越找不到
我的 Downloads 文件夹里躺着几千个文件,截图、PDF、会议录音、录屏视频混在一起,想找“上次那张报错截图”或者“会上谁提到了预算”,只能凭记忆翻文件名,基本靠运气
EmbeddingGemma 2 给的答案是:用一句大白话描述你要找的东西,图片、文档、音频、视频统统能搜出来,全程本地跑,普通笔记本就够
EmbeddingGemma 2:一个空间装下四种模态
熟悉 RAG 的同学应该十分清楚 Embedding 模型是干嘛的:
把内容变成一串数字(向量),意思相近的内容,向量也挨得近
搜索、RAG、推荐、去重、分类,底层都靠它,大模型负责“说”,Embedding 负责“找”
上一代 EmbeddingGemma 只认文字,是端侧 RAG 的热门选择
EmbeddingGemma 2 这次一口气把文字(含代码)、图片、视频、音频全塞进了同一个 768 维的向量空间
于是你可以用文字搜视频片段,用语音搜照片,用截图搜文档,跨模态随便组合
关键参数:
| 项目 | 数值 |
|---|---|
| 总参数 | 740M |
| 文本部分 | 270M(130M Transformer + 140M Embedder) |
| 视觉编码器 | 170M,可选加载 |
| 音频编码器 | 300M,可选加载 |
| 上下文 | 8192 tokens,上一代的 4 倍 |
| 输出维度 | 768,可截断到 512 / 256 / 128 |
| 语言 | 100+ 种 |
| 协议 | Apache 2.0,可商用 |
8K 上下文换算成多模态是什么概念:约 5.5 分钟音频(每秒 25 token),或 29 张图(每张默认 280 token),或 58 帧视频(默认每秒抽 1 帧)
成绩方面,多语言文本能力和上一代基本持平(MTEB 多语言 61.36 vs 61.15),代码检索从 68.76 涨到 78.68,涨了快 10 分,图片、视频、音频是全新能力,官方的说法是 1B 以下多模态 Embedding 模型里同尺寸最强
“同尺寸最强”这种话每家都会说,我更看重另外两个设计:
一是模块化,视觉和音频编码器是独立组件,只做文本检索就只加载 270M,用不上的部分压根不进内存
二是 MRL 套娃表示,768 维向量直接截掉后半段就能用,存储最多省 6 倍,官方数据显示截到 256 维,各项指标只掉 1~3 分,本地向量库动辄几十万条的时候,这个设计很香
本地部署硬件需求大不大
直接说结论:很小,不需要独立显卡,8GB 内存的普通笔记本就能跑,手机都行
官方实测:在 Pixel 11 Pro 手机上量化运行,纯文本只占约 191MB 内存,四模态全开约 567MB
再按参数量粗算一下权重体积(只算权重,不含推理时的激活开销,仅供参考):
| 加载组合 | 参数量 | bf16 权重约 | 8-bit 量化约 |
|---|---|---|---|
| 纯文本 | 270M | 0.54 GB | 0.27 GB |
| 文本 + 图片 | 440M | 0.88 GB | 0.44 GB |
| 文本 + 音频 | 570M | 1.14 GB | 0.57 GB |
| 四模态全开 | 740M | 1.48 GB | 0.74 GB |
DigUp 的真实数据也对得上:它用的是 ggml-org 出的 8-bit 版本,模型一共 865MB(文本部分 310MB,图像和音频编码器 555MB),搜索时只加载文本部分,约 250MB,App 本体才 20MB
对比动辄几十 GB 的大模型,这就是个零头
真正花时间的地方在首次建索引,你选中的文件夹里每张图、每页 PDF、每段音视频都要过一遍模型,DigUp 给的参考是几百个文件几分钟,大一点的 Downloads 文件夹可能要一个小时,之后新文件落地一两秒就能搜到
部署时有几个坑,我替大家划个重点:
- 别用 float16,这个模型的激活值范围超出了 fp16 的动态范围,用 fp16 跑会返回 NaN 或者悄悄变差的向量,还不报错,最难排查,硬件支持 bf16 就用 bf16,CPU 上老老实实用 float32
- 截断后要重新归一化,否则排序质量会悄悄下降,最省事的办法是 encode 时直接传 truncate_dim 和 normalize_embeddings=True
- 128 维慎用于多模态,MMEB 多模态总分从 59.01 掉到 45.65,掉得很明显,128 维更适合纯文本场景
- 文本记得加任务前缀,比如查询用 task: search result | query: xxx,文档用 title: xxx | text: xxx,不加也能用,精度会打折扣
上手很简单,官方给的 sentence-transformers 写法:
pip install -U sentence-transformers transformers
from sentence_transformers import SentenceTransformer
model = SentenceTransformer(“google/embeddinggemma-2”)
query = “What causes the northern lights?”
document = “The northern lights are caused by charged particles from the sun.”
query_emb = model.encode(query, prompt_name=”SearchQuery”)
doc_emb = model.encode(document, prompt_name=”Document”)
print(model.similarity(query_emb, doc_emb))
只做文本检索又想省内存,把两个编码器关掉,有效参数直接降到 270M:
model = SentenceTransformer(
“google/embeddinggemma-2”,
config_kwargs={“vision_config”: None, “audio_config”: None},
)
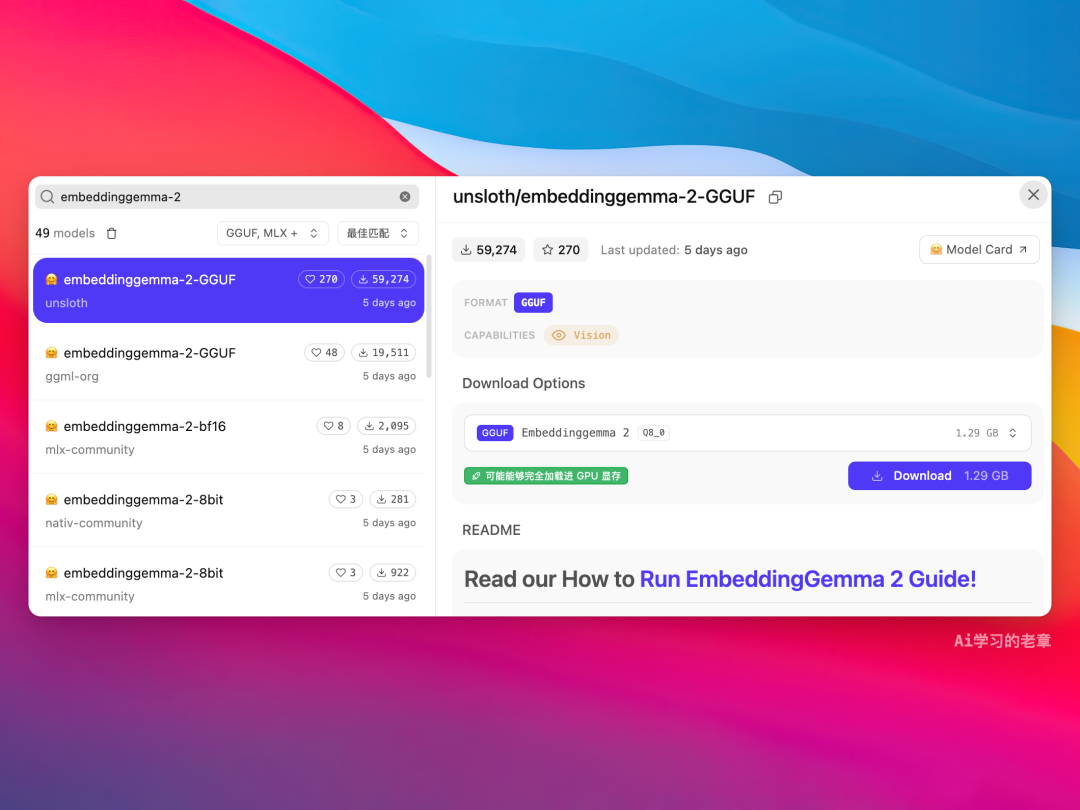
这种方式有点麻烦,这个模型的生态很齐:Ollama、LM Studio、llama.cpp(GGUF)、MLX、vLLM、SGLang 都支持,浏览器里能用 transformers.js + WebGPU 跑,向量库有 Qdrant,微调有 Unsloth
个人建议用 LM Studio,Windows 和 Mac 端都支持
潜力:为什么说它被低估了
大模型越来越聪明,可它不知道你电脑里有什么
Embedding 就是把“你的数据”和“模型”接起来的那根线,过去这根线只能连文字,现在照片、录音、视频都能接上了
比如端侧多模态搜索,AI Edge Gallery 里的 Instant Media Search 用文字或图片搜相册,Video Moments Finder 用文字或语音定位视频里的具体时刻
比如实时分类和路由,MediaPipe Decision Task API 用它做多模态的分类、路由和决策
我感觉它就是本地 AI 的地基型模型
单独看不出彩,所以没人吹,但凡是“本地 + 隐私 + 多模态 + 搜索”的产品,几乎都绕不开这类模型
Apache 2.0 可商用、笔记本能跑、生态首发齐全,三点凑齐,我估计接下来半年会冒出一大批基于它的应用
DigUp:给 Mac 装一个听得懂人话的 Spotlight
我发现已经有相关应用问世了——DigUp:
Describe it. Dig it up. 描述它,挖出来
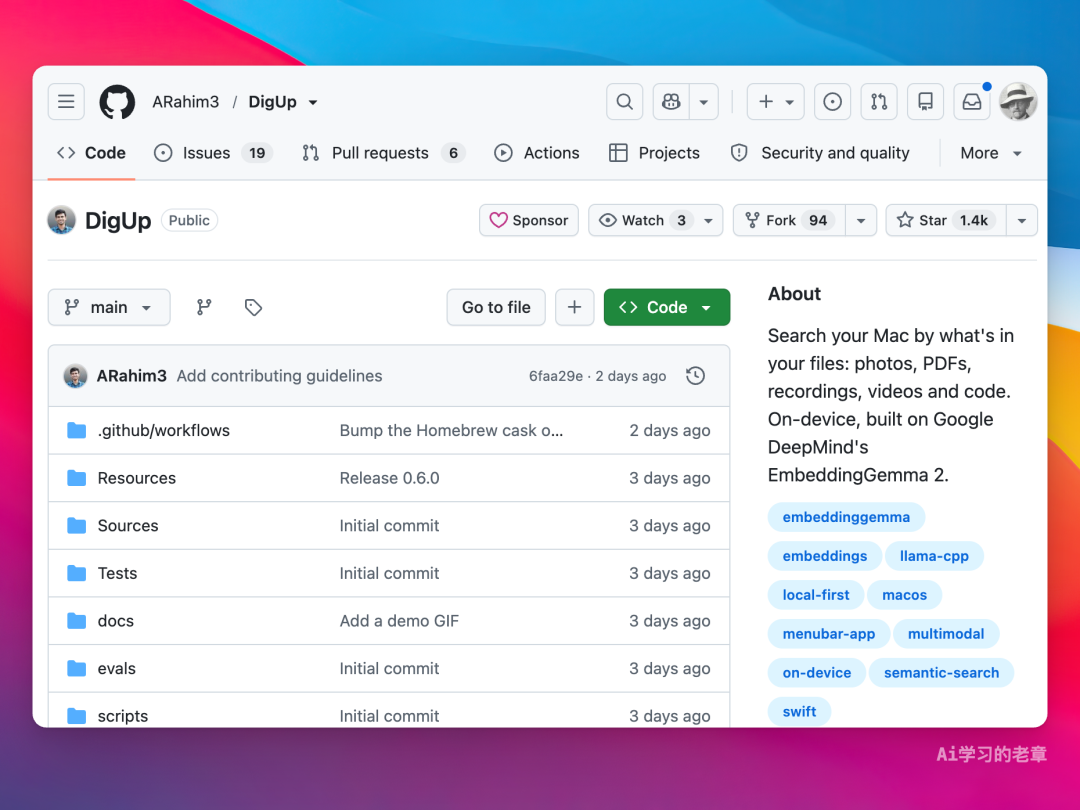
3 天收获 1400+Star
它的搜索面板,可以在视频里找斑马、在播客里找片段、在合同里找条款、用三种语言搜沙滩上的狗,最后还能搜代码并在 Zed 里打开:
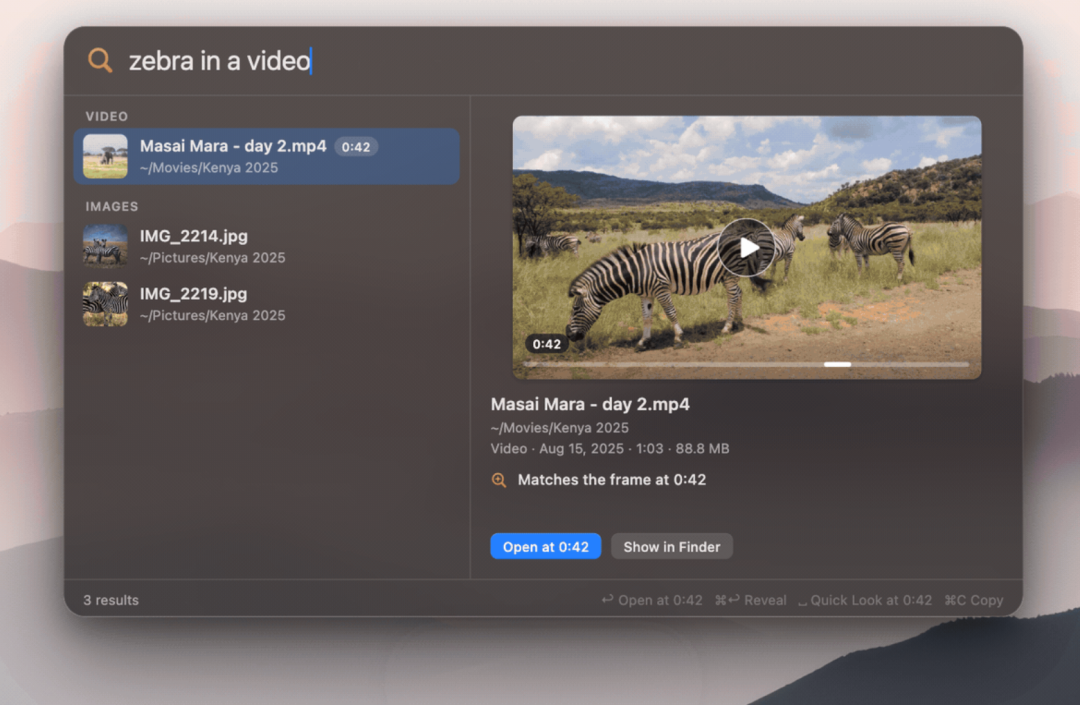
用法也就三步:选几个文件夹,等它读完,按 ⇧⌘Space 用自己的话描述要找的东西:
- 搜“zebra in a video”,直接打开视频,跳到斑马出现的那一秒
- 搜“where they talk about sleep”,跳到播客里聊睡眠的那一分钟
- 搜“the clause about pets in the lease”,打开租房合同 PDF 的对应页,关键词已经标好
- 搜“payment declined error”,翻出那张支付失败的截图
- 用英文搜,能找到孟加拉语、阿拉伯语写的笔记,反过来也行
- 开启代码搜索后,“code: retry a failed call with backoff”能找到那个函数,不管它叫什么名字,还能在 VS Code、Cursor、Zed 里直接跳到那一行
我最欣赏的一个细节是混合检索,作者在 README 里说:没有哪个 Embedding 能精确记住一张发票号
所以 DigUp 在向量之外又建了一套关键词索引,发票号、错误码、人名按原样匹配,文件名、文档正文、截图里的文字都算,语义和精确字符串两头都照顾到
再看它是怎么搭起来的:
- 读取层:ImageIO 读图,PDFKit 读 PDF,AVFoundation 读音视频,Vision 识别截图里的文字
- 模型层:EmbeddingGemma 2 跑在 llama.cpp(Metal)上,放在独立的辅助进程里,干完活就退出
- 存储层:一个 SQLite 文件,存每张图、每页 PDF、每段文字、每个视频帧、每 30 秒音频的向量,外加关键词索引
- 查询层:只加载模型的文本部分,毫秒级算出查询向量,再找最近的向量,叠加精确词命中
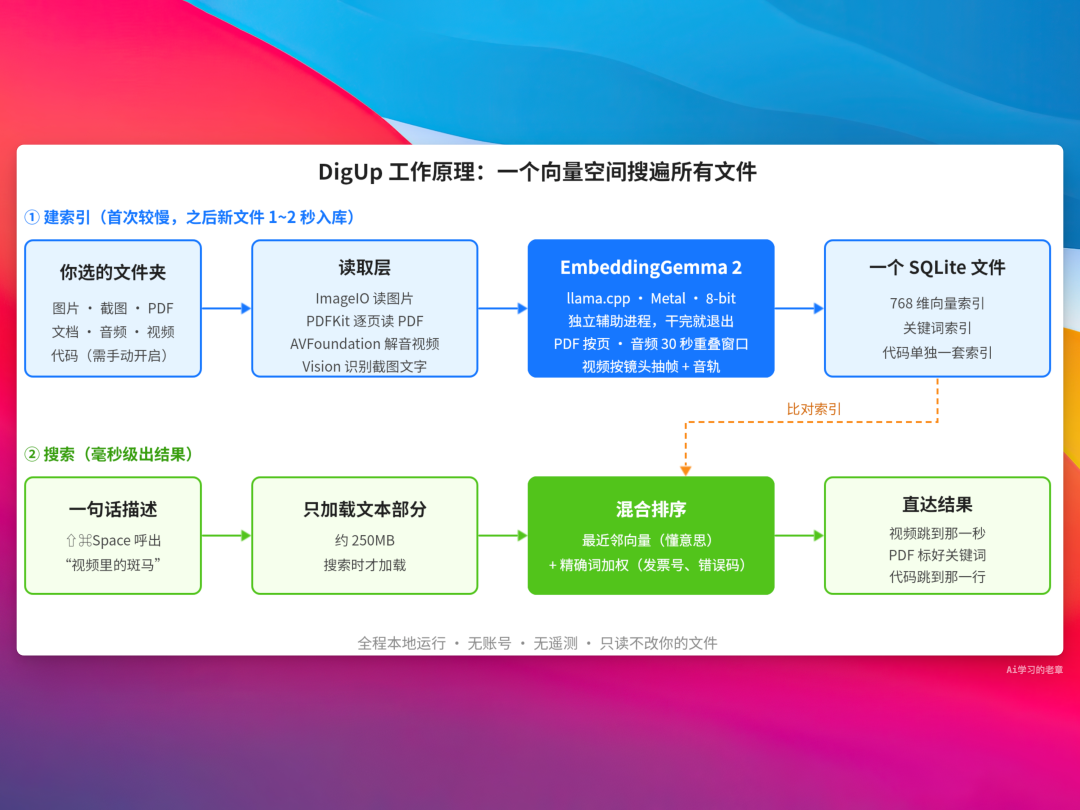
DigUp 工作原理:一个向量空间搜遍所有文件
切片策略也很讲究:模型一次只听 30 秒音频,DigUp 就用重叠的 30 秒窗口切任意长度的音频;视频每隔几秒抽一帧、每个镜头至少一帧,再把音轨按音频的方式处理;长 PDF 先读前 30 页,其余的后台慢慢读,单文件最多 5000 页
隐私方面,它只在第一次下载模型和每天检查更新时联网,更新检查不带任何文件信息,可以关掉,无账号、无遥测
还有个很工程师的细节:索引会记住是哪个模型版本生成的向量,每次升级 llama.cpp 前,都会拿存好的参考向量做回归测试,向量没变就保留旧索引,省得用户重建
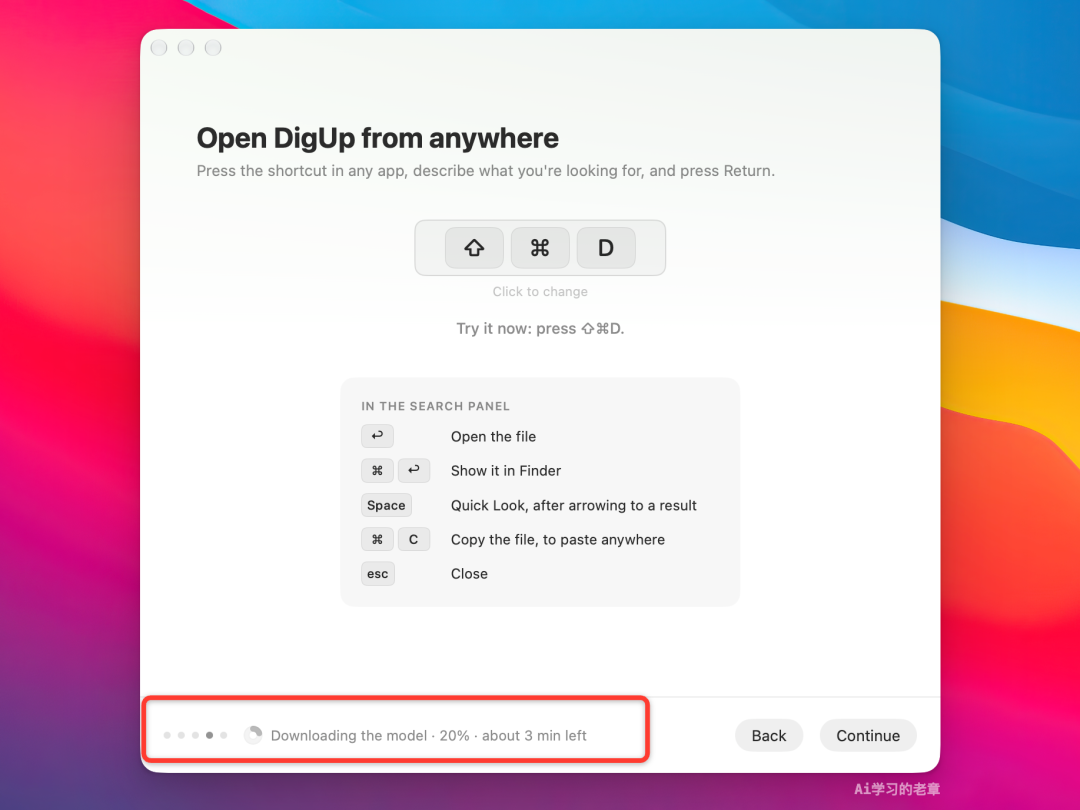
安装可以下 Releases 里的 DMG,也可以用 Homebrew:
brew install –cask arahim3/tap/digup
首次打开会下载 865MB 模型,下载的同时选文件夹,它会预估每个文件夹首遍要读多久
常用快捷键:
| 按键 | 作用 |
|---|---|
| ⇧⌘Space | 任意应用里呼出搜索面板 |
| ↩ | 打开结果,视频和录音跳到对应时刻,PDF 带着关键词打开,代码跳到对应行 |
| Space | Quick Look 预览,直接定位到那一页或那一刻 |
| ⌘↩ | 在 Finder 中显示 |
| ⌘O | 大窗口搜索,带图片网格和筛选 |
REA:逆向一切,登顶 GitHub Trending
最后再介绍一个最近很火的项目,REA,全称 Reverse Engineer Anything,刚登上 GitHub Trending 日榜第一,Star 已经突破 11 万
看到喜欢的功能,弄清它的工作原理,深入到二进制层面
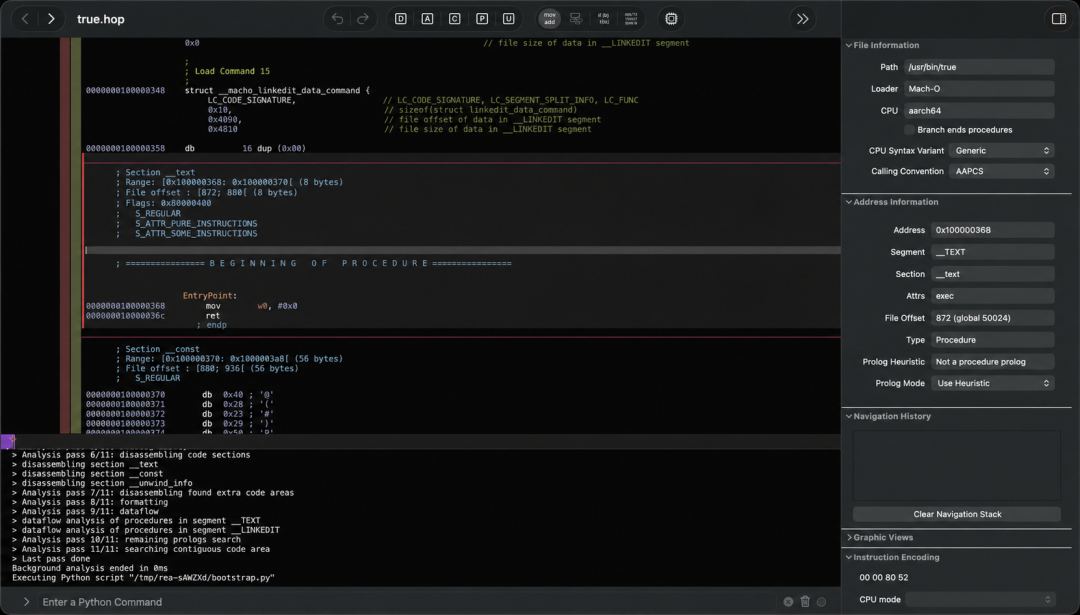
REA 在 Hopper 中启动分析桥,检查原生二进制文件
本质上它是一个 MCP 服务,把 Claude Code、Codex、Cursor、Gemini CLI 这些 Agent 接到 Hopper、Ghidra、IDA 等逆向工具上
没有源码也没关系,Agent 可以借它检查应用、解释某个功能怎么实现、给出证据,再帮你在自己的项目里实现类似功能
装好 Node.js 后一行命令完成配置(要求 Node.js 22.19+、24.11+ 或 26+):
npx rea-agents setup
选择 Agent、确认变更,它会注册 MCP 服务并装好配套的工作流 Skill,重启 Agent 就能用
工作流程是这样的:Agent 提问,REA 调用分析工具检查和追踪目标,把代码、引用和未知项返回给 Agent,Agent 再据此解释、实现和测试
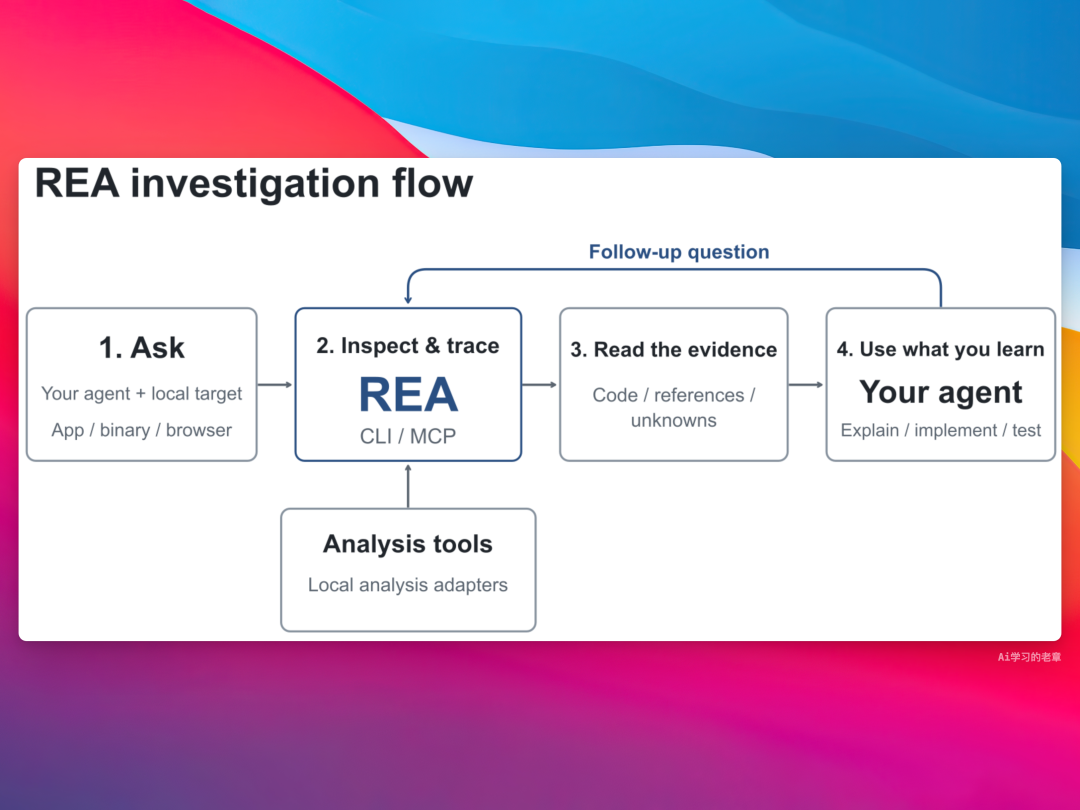
REA 调查流程:智能体提问,REA 检查追踪目标,智能体据此解释、实现与测试
它能分析的东西很杂:
- 原生二进制:伪代码、汇编、字符串、符号、调用关系,需要 Hopper、Ghidra 或 IDA
- JavaScript / Electron 应用:模块、导入、source map、IPC,不需要逆向引擎
- 网站:页面结构、脚本、网络请求
- .NET 程序集、Android APK、固件、Apple 的 .app / DMG 包结构
静态的 JavaScript 和 .NET 分析只读文件,不会运行目标程序
以前逆向是少数人的手艺,REA 把它变成了一句话需求:
弄清 Notes 应用的搜索功能如何工作,展示证据,并为我的项目实现类似功能
注意⚠️:这个项目只用于合法的逆向研究,授权和合规要自己负责
动手:把 DigUp 复刻成 Windows 版
DigUp 只能在 Mac 上用,Windows 用户怎么办?自己做一个
我感觉可行性很高,DigUp 的核心三件套 EmbeddingGemma 2、llama.cpp、SQLite 全都跨平台,llama.cpp 在 Windows 上支持 CUDA、Vulkan 和纯 CPU
需要换掉的,只是 macOS 专属的那一层:
| 环节 | DigUp(macOS) | Windows 可选替代 |
|---|---|---|
| 图片读取 | ImageIO | WIC / Pillow / libvips |
| PDF 解析 | PDFKit | PDFium / MuPDF |
| 音视频解码 | AVFoundation | FFmpeg / Media Foundation |
| 截图 OCR | Apple Vision | Windows OCR API / PaddleOCR(中文更强) |
| 向量推理 | llama.cpp + Metal | llama.cpp + CUDA / Vulkan / CPU |
| 索引存储 | SQLite | SQLite + FTS5(trigram 或 jieba 分词补上中文) |
| 文件监听 | macOS 文件事件 | ReadDirectoryChangesW / NTFS USN 日志 |
| 全局热键 | ⇧⌘Space | 自定义组合键,注意避开 PowerToys |
| 跳到视频时刻 | 控制 QuickTime | mpv / VLC 带起始时间参数 |
| 定位文件 | Finder | explorer /select |
| 自动更新 | Sparkle | WinSparkle / Velopack |
| 界面 | SwiftUI | WinUI 3 / Tauri / Avalonia |
具体怎么做,我想到两条路线
路线 A:让 Coding Agent 读源码重写(推荐)
DigUp 是 MIT 协议,源码就摆在那,这是最快的路
把仓库 clone 下来,丢给 Claude Code 或 Codex:
阅读 DigUp 的源码,梳理它的索引流水线:
文件读取、切片策略(PDF 分页、音频 30 秒重叠窗口、视频抽帧)、
向量与关键词的混合排序、SQLite 表结构
然后用 Tauri + Rust(或 C# + WinUI 3)在 Windows 上实现同样的功能,
推理用 llama.cpp 加载 embeddinggemma-2 的 GGUF,保留原项目的 MIT 许可声明
重点抄两样东西:切片策略和混合排序,这才是 DigUp 真正的价值所在,界面谁都能画
还有一个容易被忽略的宝藏:DigUp 仓库里有 evals/ 目录,放着衡量排序效果用的查询集,scripts/make-testbed.sh 能生成一批测试文件,Windows 版拿同一套评测跑一遍,就知道自己复刻得像不像
路线 B:用 REA 让 Agent 逆向
DigUp 开源,严格说用不着逆向,读源码效率高得多
这条路线的意义在于方法可迁移:今天复刻 DigUp 是练手,明天你看上哪个闭源 Mac 小工具的某个功能,同一套流程照样能用
做法是在 Mac 上对 DigUp.app 跑 REA,它是 Swift 写的原生应用,用 Hopper 或 Ghidra 做原生分析,REA 也能在不运行程序的前提下盘点 .app 和 DMG 的包结构,提示词照着 README 的格式改:
用 REA 弄清 DigUp 怎么把视频切成帧和音频窗口,
怎么把向量结果和精确词匹配合并排序,展示证据,
然后在我的 Windows 项目里实现类似功能
如果想在 Windows 上直接跑 REA,要注意它的 Windows 支持还是实验性的:Windows 10+ x64,需要自己装 Ghidra 12.1.x 和 JDK 21+,分析目标限于原生 x86 / x64 的 PE 程序,提供 25 个只读分析操作,配置参考官方文档:
npm install –global rea-agents
$env:GHIDRA_INSTALL_DIR = “C:\tools\ghidra_12.1.4_PUBLIC”
$env:JAVA_HOME = “C:\tools\jdk-21”
$env:REA_ANALYSIS_PROVIDER = “ghidra”
rea doctor –json
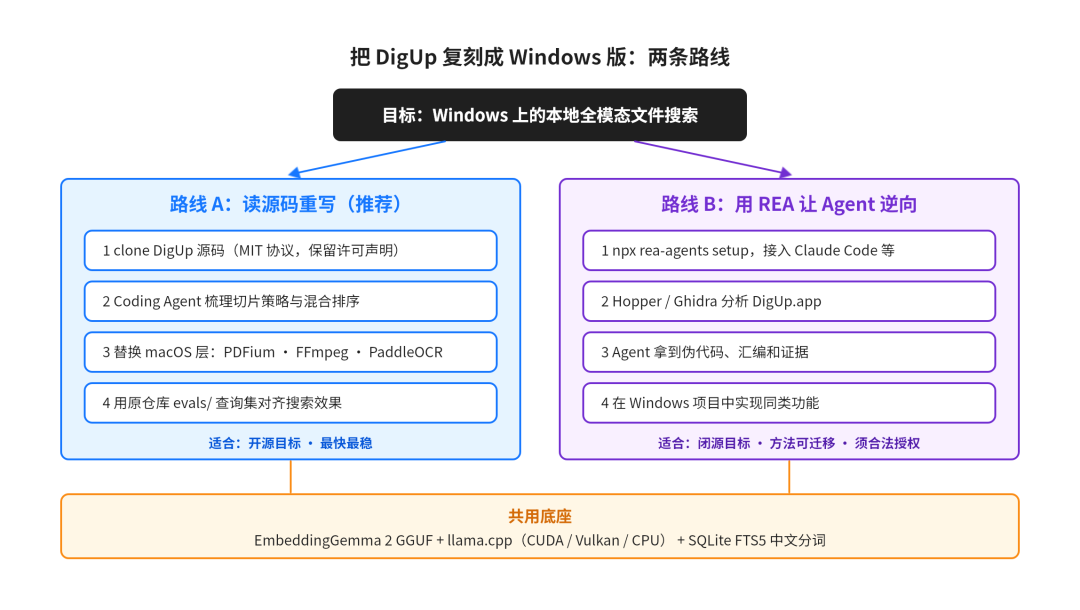
把 DigUp 复刻成 Windows 版的两条路线
不管走哪条路,我建议 Windows 版顺手补三件事,这样会比原版更适合中文用户:
- 中文分词,关键词索引接 FTS5 trigram 或 jieba,解决原版中文精确匹配吃亏的问题
- 中文 OCR,截图文字识别换 PaddleOCR,中文效果比系统自带的强不少
- 显卡加速,N 卡用户让 llama.cpp 走 CUDA,首次建索引能快很多
总结
我感觉EmbeddingGemma 2 是今年最值得 AI 开发者花时间研究的开源模型之一
我真的想尝试一下做个 Windows 版本,目前我在用的 Everything 搜索速度没得说,但是做不到 DigUp 这种深度
比较担心它中文水平不行,或许要换成Qwen3系列的多模态Embedding模型试试了
兄弟们有没有其他想法?
作者:Ai学习的老章 公众号:Ai学习的老章
本文由 @Ai学习的老章 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 Unsplash,基于CC0协议


- 目前还没评论,等你发挥!