
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
Warp 创始人:如何打造一个自我迭代的软件工厂


Warp 创始人 Zach Lloyd 讲的软件工厂,问的不是 AI 能不能独立写出应用,而是团队用了几个月 AI 之后究竟比开始时多了什么。他演示的一次改进建议里,同一类失败已经出现 37 次,办法是把任务记录留下来、找出反复出现的问题再改流程。

你有没有想过,今天让 AI 改代码时纠正过的问题,下次还要不要再纠正一遍?比如它没看项目里的说明就动手,或者写了一堆用处不大的测试,你解释一番,它终于改好了。可到了另一个任务,甚至只是换了一个同事来用,同样的事情又发生了。一个团队每天花不少时间教 AI 怎么干活,这些时间到底有没有让后面的工作变得容易一些?
Warp 创始人 Zach Lloyd 最近讲的软件工厂,讨论的就是这个问题。他以前负责过 Google Docs 的工程工作,现在做的是让团队把一部分软件开发交给 AI。按照他的设想,AI 做过的任务应该能留下记录,从中找出反复出现的问题,再去修改整个团队使用 AI 的方式。他演示了一次这样的修改建议,其中同一类失败已经出现了 37 次。我觉得这个例子比“AI 能不能独立写出一个应用”更值得聊,因为它关系到一个团队用了几个月 AI 以后,究竟比刚开始时多了些什么。
每个人都在用 AI,团队仍然可能每天重复纠错
Zach 接触的很多公司,已经给工程师配上了 AI 编程工具。大家在自己的电脑上开几个任务,让 AI 写功能、修问题,遇到不对的地方再补一句说明。这种工作方式很容易开始,也能帮上忙,但任务做得怎么样,仍然很依赖旁边那个人能不能及时发现问题、给出下一步指示。
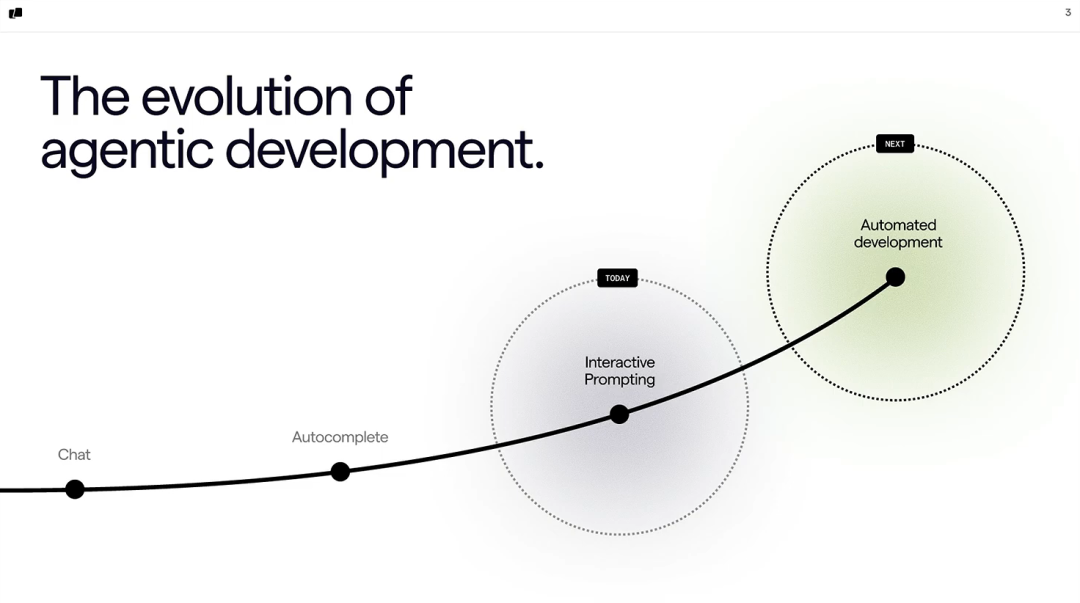
他提到一个很实际的麻烦,每个人都在配置自己的工具和工作说明。有人花时间调出了一套好用的方法,另一个人可能完全不知道,还在自己试。等到团队想弄清楚某个任务为什么成功、另一个为什么失败,很难把两次的条件放在一起看。连 AI 当时读到了什么说明,都未必能说清楚。个人可以靠熟练解决这些问题,团队要把这种熟练传给其他人,就需要留下更多东西。
他还担心权限的问题。如果本地 AI 可以使用工程师电脑上已有的权限,一旦出了问题,受到影响的可能就不只是眼前这个任务。把工作放进隔离环境,团队可以更明确地安排它能接触什么。比如只想让它修改某个项目,就应该围绕这项工作提供所需的东西,而不用默认把工程师日常使用的整个环境都交给它。
所以,他主张把这些任务搬进云端隔离的运行环境,让团队能统一管理,也能保留过程。工程师仍然可以在平时用的聊天工具里提出需求,不一定要先学一个新界面,后面的任务则进入同一套系统。这样,一个人刚纠正过的问题,才有机会被其他人看见。对管理这套系统的人来说,也能把不同任务的过程放在一起,了解大家反复花时间处理的究竟是什么。
想让 AI 改进做事的方法,得先把方法写清楚
他所说的软件工厂,包含人和 AI 一起工作的整个过程。人把需求放进去,AI 可以先判断是什么问题,和人一起把需求说清楚,再去实现、检查。每个团队可以决定哪些步骤交给 AI,哪些地方需要人参与。听起来跟现在使用编程助手差不多,区别在于,这些安排需要明确写下来,成为能够检查和修改的一套规则。
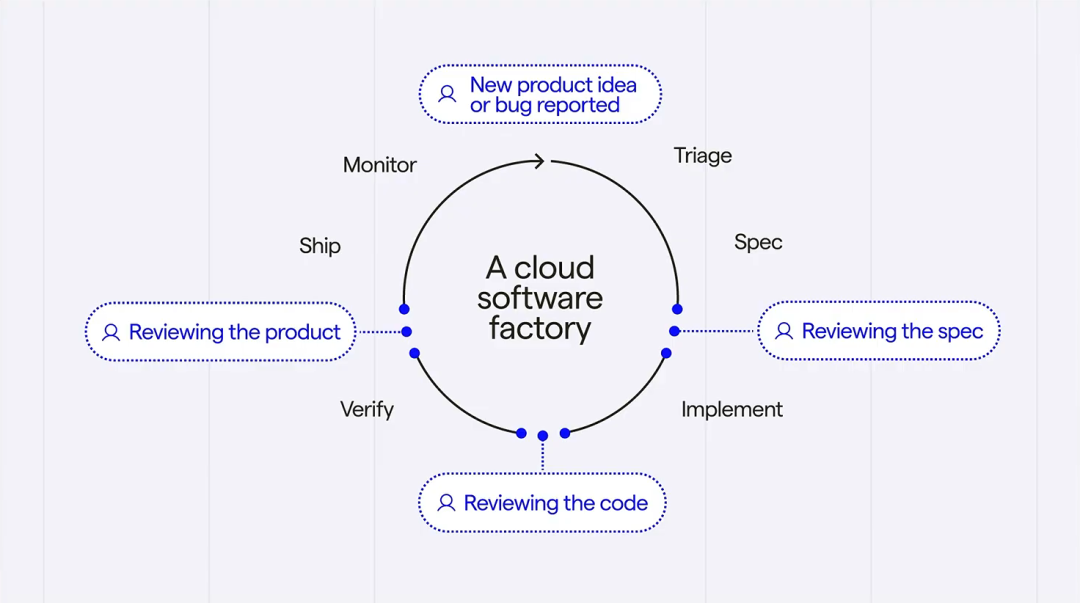
Zach 用的是代码仓库来保存它。这里面不只有业务代码,也有 AI 的工作说明,以及每个步骤选用什么模型、允许使用哪些工具。以前这些东西可能分散在个人设置和聊天记录里,现在团队可以看到一个具体版本,也能知道谁在什么时候改了哪一处。比如,原来一个任务来了就开始写代码,后来改成先检查现有实现,这就是一次可以被看见的流程修改。
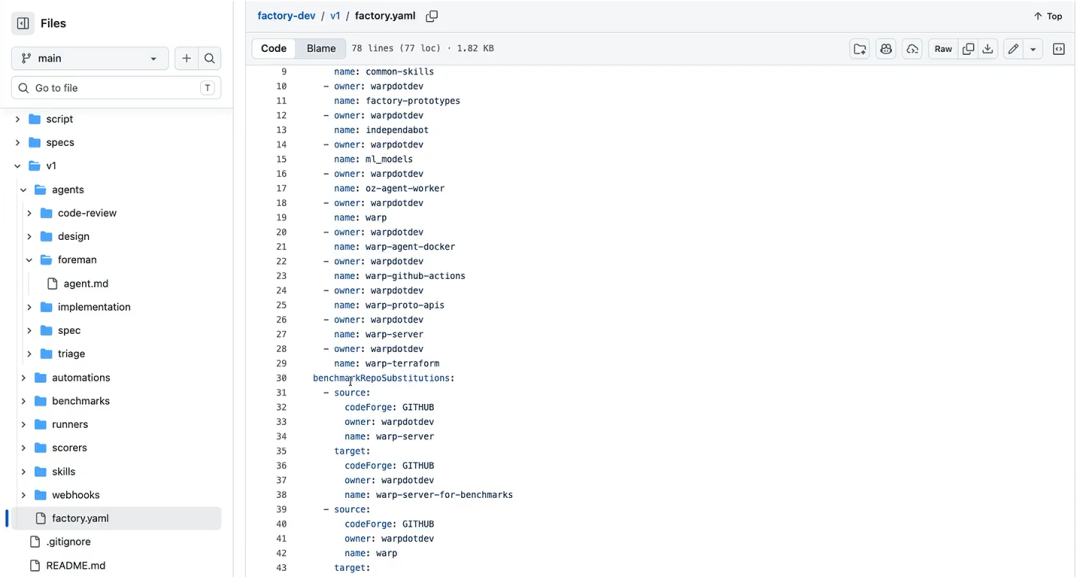
我觉得把规则写下来这件事,看上去有点笨,却省去了很多说不清楚的争论。假设大家觉得这一周 AI 比上一周好用了,如果期间换过模型,也改过工作说明,光凭感觉很难知道是哪一项起了作用。有了不同版本,至少可以把变化分开看。某条新规则让任务变慢了,也能回到原来的版本,重新考虑它是不是应该用在所有任务上。
这也解释了为什么 AI 有机会参与改进自己工作的系统。编程助手已经能读代码、提交修改,当流程本身也保存在仓库里,它就有了可以修改的对象。这里的“自我改进”,指的是调整工作流程和使用规则,不需要先把模型重新训练一遍。当然,能够提出修改和修改真的有效,还是两回事,后面得有办法判断。
他还强调,这套安排应该容得下不同的模型和工具,用他的话说,“最好的模型和工具一直在变”。今天适合的选择,过一阵未必还合适,如果换一个模型就得重新搭整套流程,试验的代价也太大了。他说的开放主要是这种选择上的自由,并不是说 Warp Factories 本身已经开源,这一点他在回答现场提问时也讲得很清楚。
同一类问题出现了 37 次,应该改哪一处
在 Warp 内部,每次 AI 任务的过程都会被保存下来,包括对话和产出的东西。Zach 可以从一个汇总界面点进去,看某项工作是怎么完成的。对工程师来说,这些记录可以用来排查问题;对他正在做的系统来说,它们也是判断现有流程哪里不合适的依据。
他举了一个特别具体的评分项目,检查 AI 有没有写多余的测试。写测试通常被当成好习惯,但如果只是重复已有的检查,或者为了一个很小的改动加了一堆没有必要的内容,也会增加阅读和维护的工作。只看代码有没有生成、测试有没有通过,看不出这种差别。团队得先把自己在意的问题说清楚,才谈得上让 AI 帮忙找。
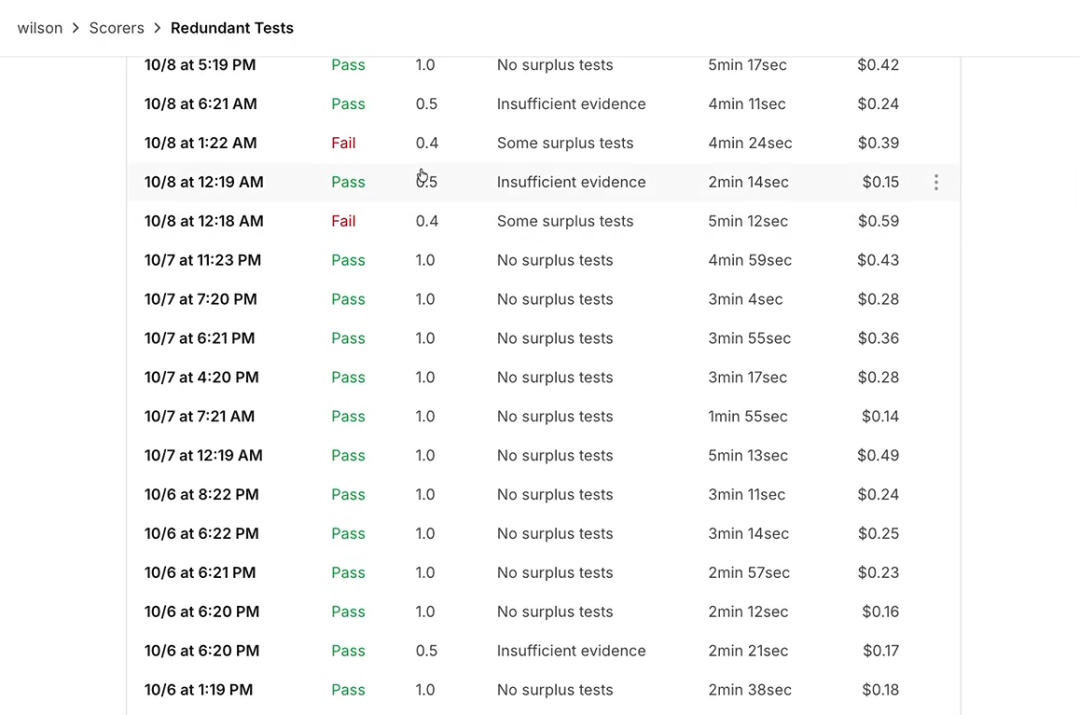
他们安排另一组 AI 去检查任务记录,判断有没有出现这些问题,再把失败的情况放在一起,找出重复的做法。Zach 点开的一个改进建议显示,同一类失败出现了 37 次。系统根据这些记录,提出了修改工厂配置的 PR,也就是一份可以被审查的代码修改请求。它找到了问题,还把建议落实到了具体的文件上,团队接下来就能讨论这处改动该不该采用。
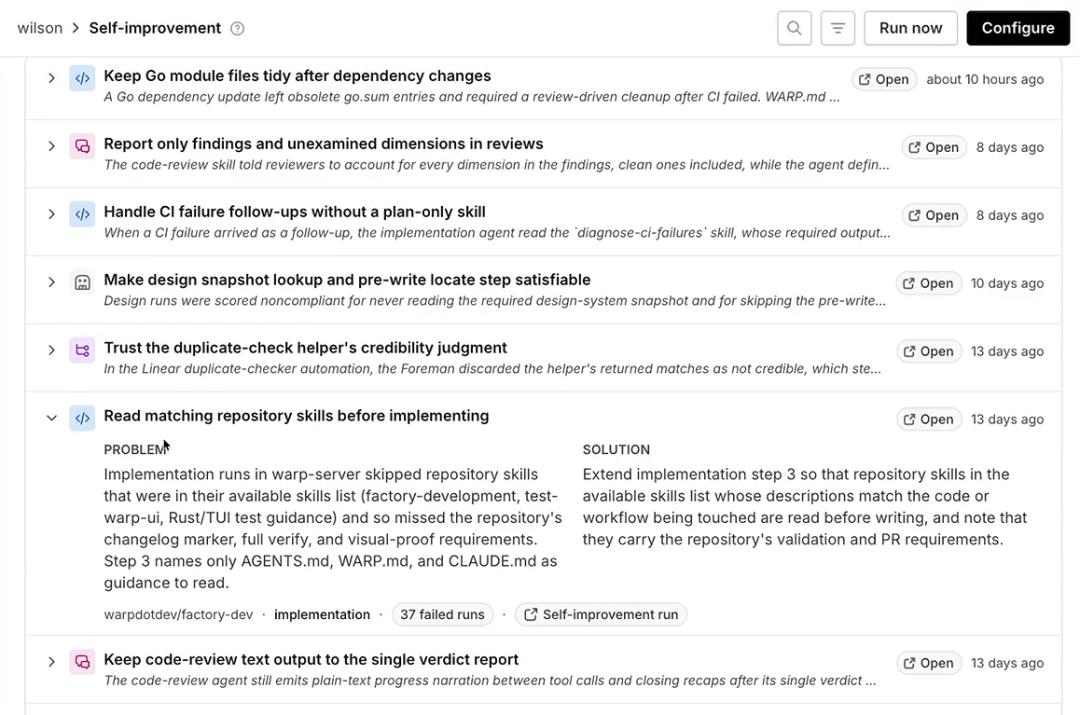
我觉得这里最有用的,是把散落在很多次对话里的麻烦放到了一起。只看某一次,你可能觉得提醒一下就好了;如果不同任务里反复出现,继续让每个人临时提醒就很费劲了。想象一下,团队已经写好一份开发说明,AI 却经常没读就开始改代码。每次把说明重新贴给它当然能解决眼前的问题,但也可以检查任务开始时的流程,让它更容易找到并读到那份说明。
不过,37 次也不能直接告诉我们应该加什么规则。有些失败可能看着相似,原因却不一样,仓促加上一条通用指令,还可能妨碍原来做得很好的任务。Zach 展示的是系统提出修改建议的过程,并没有把一次建议等同于问题已经消失。我更关心的是这份修改被采用以后,类似的任务还会不会继续出错,以及其他任务有没有受到影响。
模型适不适合你,可以拿自己做过的工作来试
Zach 对选择模型的看法很直接。今天有人说这个模型最好,明天有人推荐另一个,公共测试也会给出排名,但这些信息不能直接回答它在你们团队里会做得怎么样。一个经常改网页的团队,和一个主要维护后端服务的团队,平时遇到的问题就不一样,适合它们的模型也未必相同。
他的办法是从真实做过的任务里挑出一批,交给不同配置重新做,再比较结果。比如团队想知道哪个模型更适合处理前端工作,就可以把过去具有代表性的前端任务收集起来。选任务也需要花心思,他建议开始时由人挑,放进不同难度的工作。否则,如果只留下特别简单的任务,测出来的结果很漂亮,真正工作时还是会失望。
他展示了一张成本和质量的对比图,其中一种配置的评分对应 93%,另一种是 95%,后者花费大约是前者的三倍。这个例子里,分数来自 AI 对任务结果的评价。它能帮助团队比较配置,但不能直接当成产品上线后的成功率。即便只看这组比较,也没有一个适合所有人的选择:如果团队觉得那一点差别很重要,多花钱可能值得;如果只是一些容易检查的小改动,也可以考虑费用更低的配置。
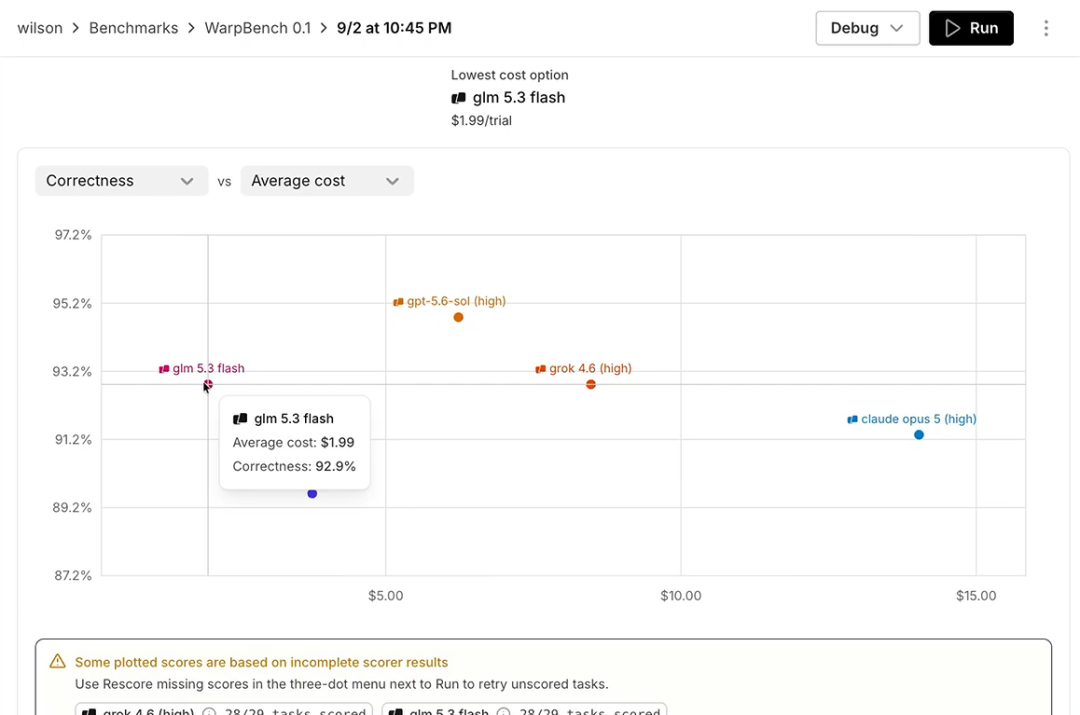
对我来说,这种比较还有一个好处,就是换模型不用每次都从头凭印象判断。团队把代表性的任务留下来,新模型出来以后,就能拿同一批工作试一遍,看看它具体在哪些地方更好。工作方式改了,也可以用这些任务再检查一次。这样积累几个月以后,手里有的会是一组跟自己业务有关的结果,选模型时也就有了更具体的理由。
AI 给了高分,还得确认用户真的能用
现场有人追问,图上的正确率究竟是怎么判断的。Zach 回答,现在是让大模型来评分,人工评分也很合理,只是他们当时还没有加进去。这个回答会影响我们怎么理解前面那套自我改进的方法,因为后面的修改建议,很大程度上取决于前面把什么判成了好、什么判成了坏。
如果评分规则没能抓住真正的问题,系统就可能花很多时间改善一个不太重要的指标。比如它学会少写测试了,却漏掉了本来应该检查的情况,分数变好并不意味着团队更省心。这是我对这种做法最想继续追问的地方。检查 AI 的工具也得有人检查,尤其是当它的判断开始影响整个团队的工作方式时,最好能回到具体任务,看看那次评分到底有没有道理。
另一个问题更接近日常工作。AI 写得越来越快,待审查的代码修改会不会越积越多?Zach 承认会出现这种情况。他建议在开发前把要求讲清楚,让后面的验证能对照这些要求进行;同时让 AI 实际操作软件,从用户的角度检查功能,并留下能够说明结果的证据。这样,人看修改时就不必从零开始猜它到底能不能用。
想象一下,让 AI 做一个报名表单,它改完代码、通过测试以后,再打开页面填一遍,看看提交后是否真的出现了预期结果。这样的检查仍然需要设计,但比只说一句“已经完成”,给审查者的信息多得多。团队也可以据此决定哪些改动还要仔细看,哪些问题需要退回重做。
这些检查当然也要花钱。有人问预算怎么安排,Zach 的做法是先看每份代码修改的成本,再看其中有多少花在评分和测试上。这让我觉得,讨论 AI 开发便不便宜,得把它完成之后还要做的工作一起算进去。如果生成只花了很少的钱,最后却需要工程师花很长时间确认和修补,就还不能说这次任务已经做得很划算。
团队里会有人专门改进 AI 的工作方式
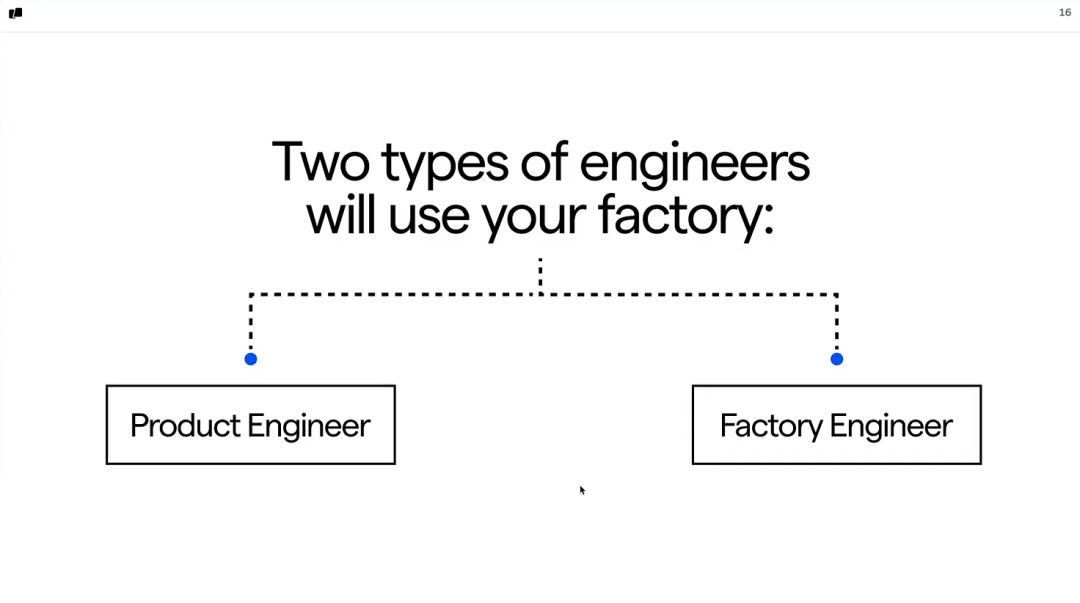
Zach 把未来的工程工作分成了两类。一类工程师继续负责产品,决定给用户做什么功能、解决什么问题,再通过这套系统完成开发。另一类工作是改进系统本身,让 AI 拿到合适的上下文,调整工作说明,试验不同的模型配置。他把后者叫作工厂工程,可以由平台团队承担,也可以由现有工程师来做。
我觉得这项工作很容易被低估,因为它不像一个新功能那么容易展示。一个人花了半天找出 AI 为什么反复漏看项目说明,最后可能只改了几行配置,表面上没有多少产出。但如果接下来很多任务都少了一轮返工,这几行修改的价值就会慢慢体现出来。前提是团队真的去看修改后的表现,而不是写完一份更长的说明就算完成。
这也不意味着每个人都应该马上搭一套软件工厂。Zach 自己说,一个人做项目,用这样的系统可能太复杂,继续用手边的编程助手就很好。他认为,当团队有大约十名或更多工程师时,统一管理这些工作会更有价值。这个规模更像他的经验判断,我觉得还得看团队有没有经常碰到同类问题,以及有没有人愿意花时间处理它们。
我自己的一点思考
我觉得 Zach 讲的这件事,最值得尝试的地方,是把我们平时随手给 AI 的纠正认真对待起来。很多纠正里其实已经包含了团队的经验,比如为什么这里不能照着现有代码抄,为什么这类修改一定要检查另一个页面。如果任务做完这些解释就散了,下一个人遇到相同情况,仍然要重新讲一遍。
当然,也没必要把每次纠正都变成一条永久规则。有时候只是需求临时变了,有时候是某个任务特别,写进所有人的流程里反而麻烦。可以先留下几次真正让人返工的任务,看看有没有共同原因,挑一个最明确的地方改,再用后来的工作检验。这个过程做得好不好,靠增加多少条说明是看不出来的。
我会先看那些重复发生、已经让人有点厌烦的问题。比如每次开始前都要提醒 AI 去读同一份说明,这件事就很适合试着改进。改完以后,下一次做相似的工作,能不能真的少提醒一句?先把这一件事做好。
本文由人人都是产品经理作者【深思圈】,微信公众号:【深思圈】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议
- 目前还没评论,等你发挥!