
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
WorkBuddy20来个大模型,从夯到拉排行榜!


WorkBuddy里那一长串模型到底点哪个?作者翻出三个月账本:22680.8积分里,有9077.9分烧在一个341轮对话上,用的还是最便宜的主力模型。这篇不按跑分排,而是按你要干什么活,把二十来个模型分五档,写清什么时候点、代价多少。
上周有朋友跑来问我:WorkBuddy 里那一长串模型,到底该点哪个?我说你先别问点哪个,你告诉我这活儿要干多久。
他愣了一下:「这还有关系?」
关系大了。我把三个月的账本翻出来一笔一笔算:22680.8 积分,其中有 9077.9 分,全烧在一个 341 轮的对话里。而那个对话用的,恰恰是我最便宜的主力模型。
所以这篇不按跑分排,按「你到底要干什么活」排。从夯到拉五个档,二十来个模型一个个过,每个都写清楚:什么时候点、为什么、代价多少。
急用的直接抄 01 和 03 两张表;想看我凭什么这么排的,往下翻。
01 从夯到拉:五个档,二十来个模型
先说清标准。
我没按「谁最强」排。按谁最强排,第一名永远是 K3——可它也是最贵的,你天天点,一个月工资不够烧。
我按三件事排:能力够不够用、代价划不划算、这活儿缺不缺它。三条凑一块,才有下面这张榜。
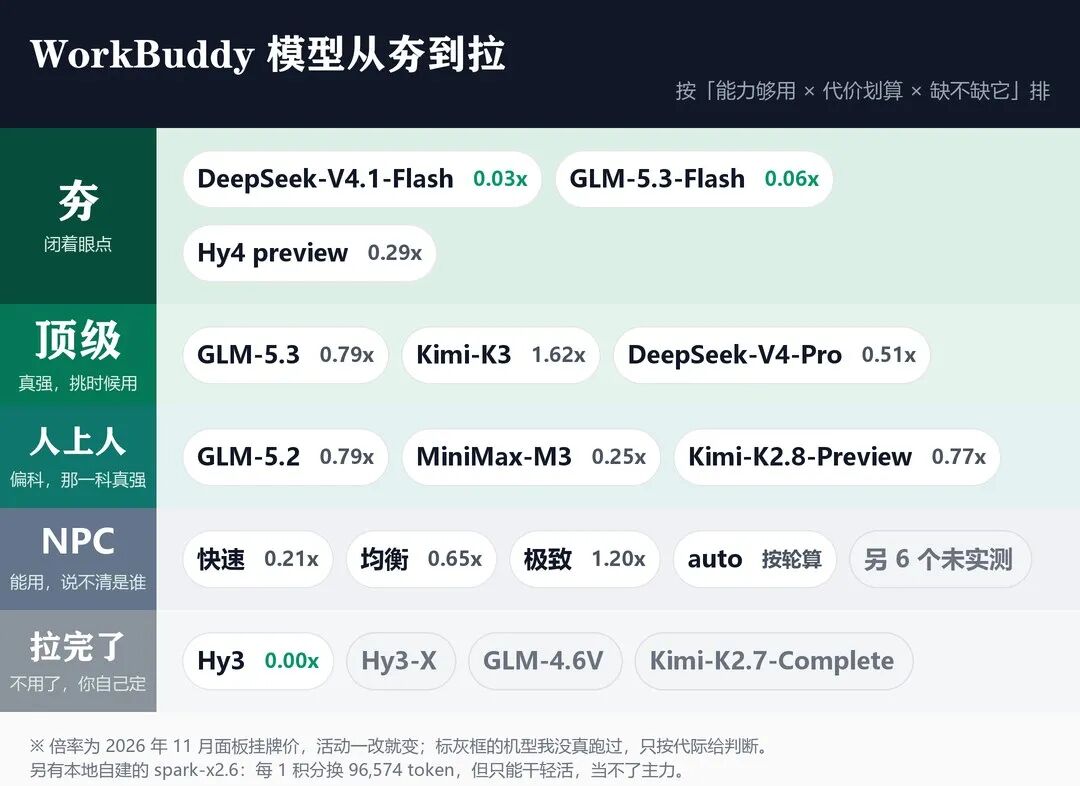
▲ 从夯到拉五个档,模型后面标的是当天倍率
榜里模型后面那个 x 就是倍率——同样一句话,1.62x 比 0.03x 贵五十多倍。
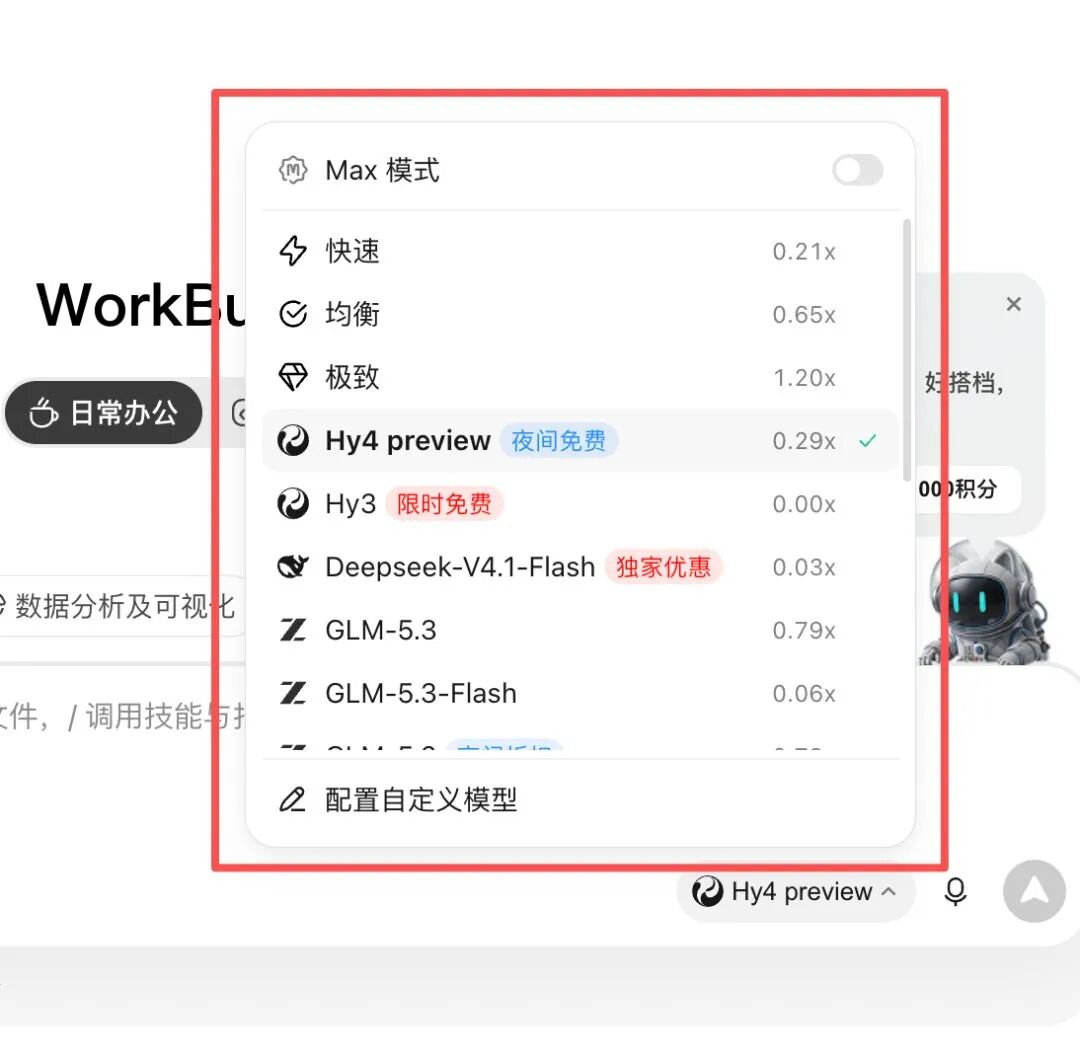
▲ 点开模型面板,第一屏就是这些:快速 0.21x、均衡 0.65x、极致 1.20x,Hy4 preview 挂夜间免费,DeepSeek-V4.1-Flash 挂独家优惠
这是我今天点开面板截的,跟你现在看到的不会完全一样。这数每天都在变,等下细说。
夯:闭着眼点,除非你心疼积分
DeepSeek-V4.1-Flash 0.03x。我现在干硬活的第一选择。Agent 长任务榜 90.6 分第一,代码榜 74.2 第一,倍率还压在最低那一档。唯一的毛病是它太能干——你会不知不觉把一个对话聊到三百轮,我后面细说。
GLM-5.3-Flash 0.06x。便宜到不像话,还专治看图:多模态榜 89.4 分第一,把 K3 都压在后面。截图识字、读图表我先点它。
Hy4 preview 0.29x,还常挂着夜间免费。我的日常主力:309 个任务,扛了我 62.6% 的 token,只花了 13.4% 的积分。这是我账本里唯一一个「干得多、花得少」的。
顶级:真强,但要挑时候用
GLM-5.3 0.79x。综合 85 分排第二,写作榜第一,长任务也稳。差一点点就能进夯档,卡在价格上——比 Flash 贵二十几倍。
Kimi-K3 1.62x。全场最强,综合 86 分第一。也是全场最贵。我的用法很简单:真搞不定才点它,点完立刻换回来!
DeepSeek-V4-Pro 0.51x。代码榜 62.7 第三,Agent 榜 87.9 第四。V4.1-Flash 偶尔抽风的时候,换它接一手。
人上人:偏科,但那一科是真强
GLM-5.2 0.79x,夜间还打折。这货很怪:复杂推理榜 99.2 分,全场第一,比 K3 都高;可综合分只有 76,排第七……为啥?代码和 Agent 两栏拖后腿。所以它这辈子只干一件事——算题、硬推理。
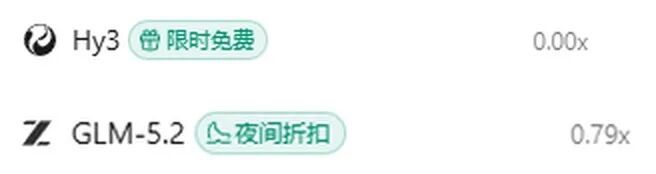
▲ 面板上这两个都挂着标签:Hy3 限时免费 0.00x、GLM-5.2 夜间折扣 0.79x
MiniMax-M3 0.25x。什么都行一点,什么都不顶尖。不想动脑子选模型的时候点它,最不容易翻车!
Kimi-K2.8-Preview 0.77x。百万上下文。整本书、整份财报一次丢进去那种活,只能靠它。
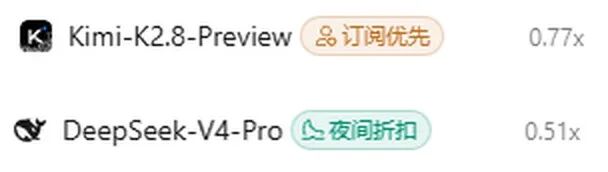
▲ 另外两个也各有标签:Kimi-K2.8-Preview 订阅优先 0.77x、DeepSeek-V4-Pro 夜间折扣 0.51x
NPC:能用,但你说不清背后是谁
快速、均衡、极致我放 NPC,不是它们差。是你点了也不知道背后是谁——0.21x、0.65x、1.20x 只是三个价格档,模型由系统临时分配。同一个「极致」,今天和明天可能不是一个人出的。
auto 也一样。我账本里它只跑了 6 个任务,却花掉 1585.4 分,摊到每轮 31.7 分——比我自己手挑任何一个模型都贵!它替你省的是脑子,不是积分。
剩下几个我只在面板上见过,没真跑过:Step-5-Preview、Xiaomi MiMo-V2.6-Pro、MiniMax-M3.1-Flash、Space-Buni、GLM-5.1、GLM-5v-Turbo。榜上没它们的位置,我给不出建议,就老实放这儿。
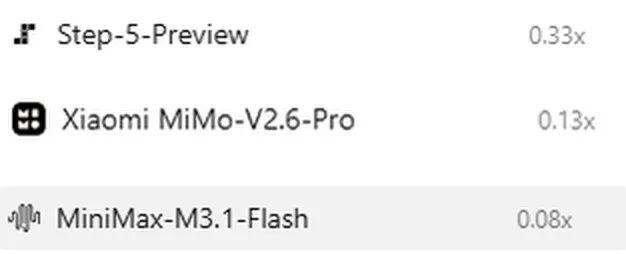
▲ 这三个我确实没跑过:Step-5-Preview 0.33x、Xiaomi MiMo-V2.6-Pro 0.13x、MiniMax-M3.1-Flash 0.08x
这三个倍率都压得很低,最高才 0.33x,看着挺香,可我一次没点过——没体感的东西我不敢推……
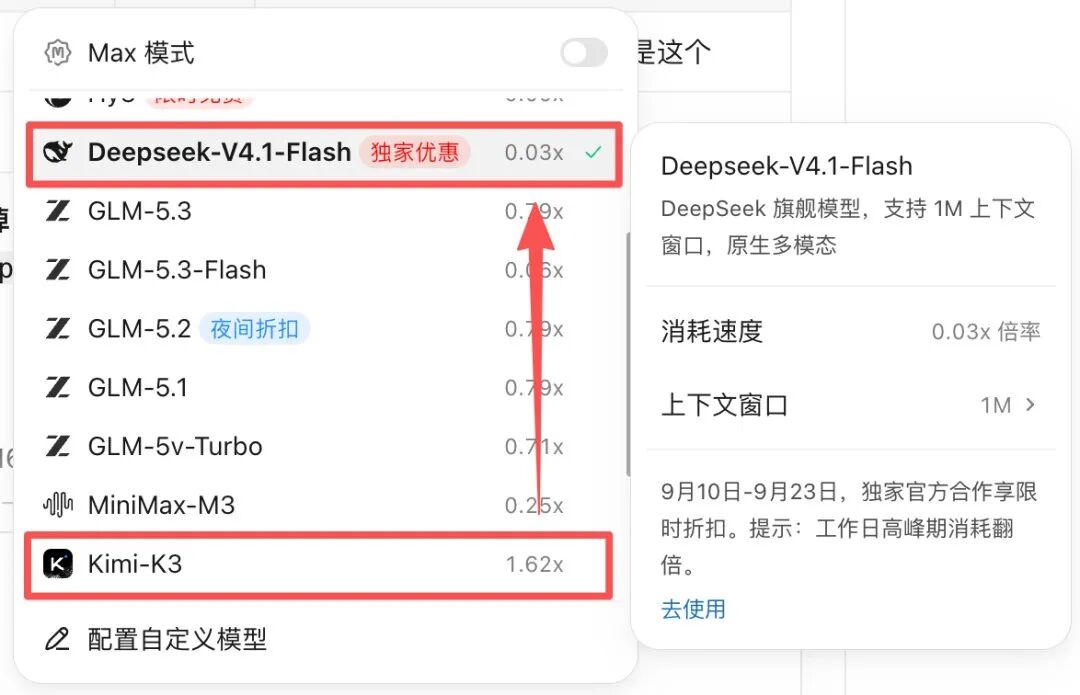
▲ 往下滑还有:GLM-5.2 夜间折扣 0.79x、GLM-5.1 0.79x、GLM-5v-Turbo 0.71x、MiniMax-M3 0.25x、Kimi-K3 1.62x
图里右边那行小字,比整个面板都重要:「9 月 10 日-9 月 23 日,独家官方合作享限时折扣。提示:工作日高峰期消耗翻倍。」倍率是个会动的东西——限时活动会改,夜里会打折,工作日高峰还能翻倍。所以别把任何一张倍率表当圣旨,你面板上看到的才是真的!
拉完了:我不用了,你自己决定
Hy3:我开了 27 次,一共只聊了 13 轮就关了!不是它崩,是我每次聊两句就觉得不对劲,没那个耐心。它现在还挂着限时免费,0.00x,可我还是没回去用过……免费不等于有用,这道理我花了 27 次才认。
Hy3-X、GLM-4.6V、Kimi-K2.7-Complete 这一批,都是上一代或者轻量版……有 GLM-5.3-Flash 在,看图没理由点 4.6V;有 K3 和 K2.8 在,K2.7 也没位置。
还有个特殊的:本地跑的 spark-x2.6。便宜到离谱——每 1 积分换 96,574 个 token,是 V4.1-Flash 的 635 倍。但能力就那样,只能干轻活,还得自己搭环境。省钱可以,当主力不行。
模型没有好坏,只有配不配你这件活。
02 这张榜凭什么这么排
三个依据,一个个交底。
第一个是公开评测。我用的是第三方汇总的一份加权榜,权重是代码 30%、Agent 30%、推理 25%、多模态 15%,分数按这四项加权。
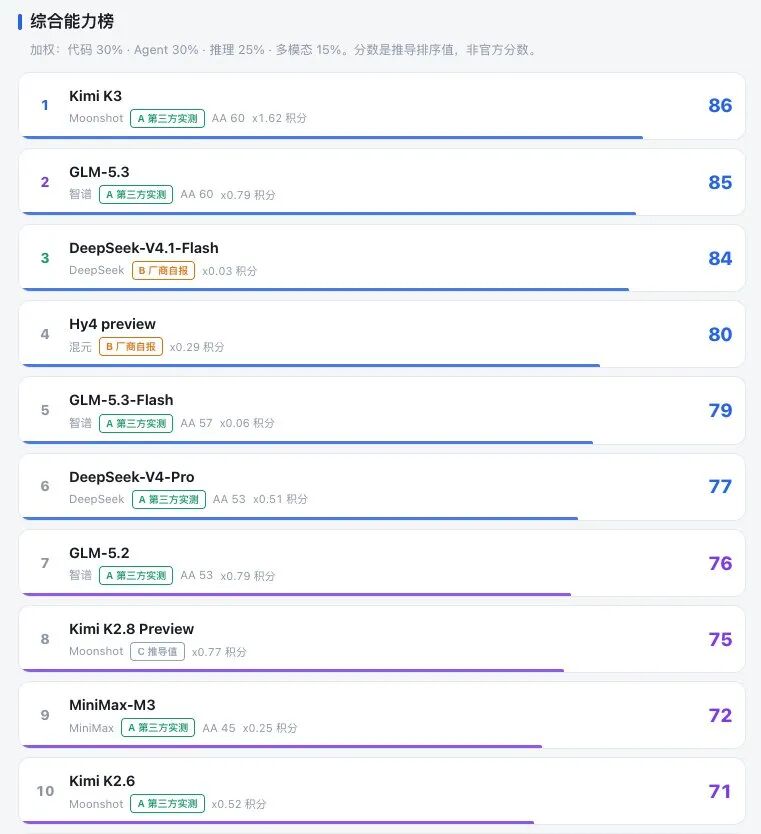
▲ 综合能力榜前十:Kimi-K3 86、GLM-5.3 85、DeepSeek-V4.1-Flash 84、Hy4 80、GLM-5.3-Flash 79
但加权榜是个平均数,会把偏科的人活埋。所以第二个依据是场景榜——同一个模型换个场景,名次就能翻个个儿。
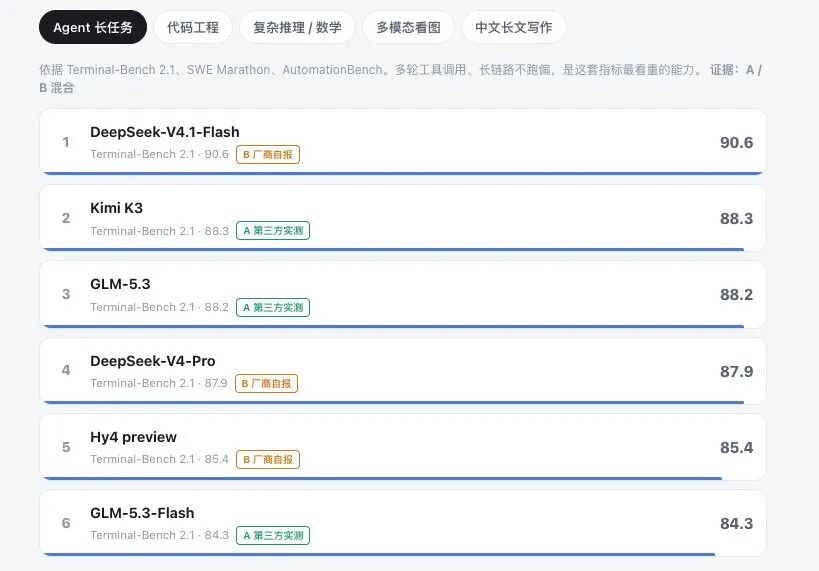
▲ Agent 长任务榜:DeepSeek-V4.1-Flash 90.6 第一,Kimi-K3 88.3 第二,GLM-5.3 88.2 第三
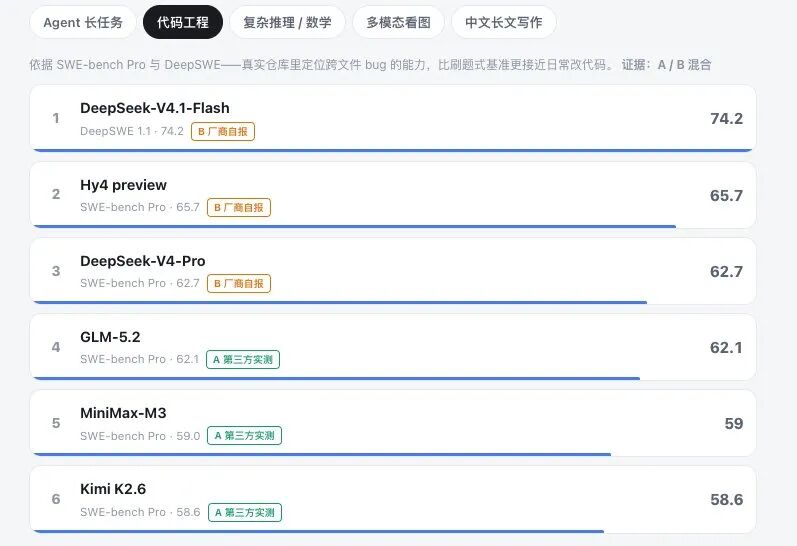
▲ 代码工程榜:DeepSeek-V4.1-Flash 74.2 第一,Hy4 65.7 第二,DeepSeek-V4-Pro 62.7 第三
第三个依据是我自己的账本。榜单说「谁强」,账本说「我付了多少」,这两件事经常不是一回事——第 05 章细讲。
关于这些分数:
分数是推导排序值,不是官方跑分,权重怎么定本身就带主观。模型一个月一换,名次一个月一重排,你看的时候可能已经落后了。真正该记的是「什么活配什么模型」这个逻辑。
顺带说个常被搞混的事:快速、均衡、极致不是三个模型,是三个价格档。
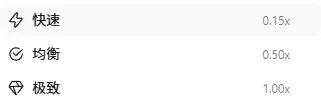
▲ 快速、均衡、极致三档,倍率不一样,但都不指定具体模型
想要可复现就别点这三档——点具体模型,下次还点它,结果才对得上。
03 什么活用什么:场景对照表
我贴在便签上的,直接抄,每行都写了为什么。
| 我要干的事 | 先点谁 | 为什么 |
| 写代码、改 bug | V4.1-Flash | 代码、Agent 双榜第一,还最便宜;抽风换 V4-Pro |
| 多步任务、跑很久 | V4.1-Flash | Agent 榜第一,长链路稳;备选 GLM-5.3 |
| 截图识字、看图表 | GLM-5.3-Flash | 多模态榜第一,0.06x;备选 K3 |
| 写公众号、写长文 | Hy4 preview | 中文原生 + 长程优化;备选 GLM-5.3 |
| 整本书一次读完 | K2.8-Preview | 百万上下文,别硬拆;备选 K3 |
| 数学、硬推理、算账 | GLM-5.2 | 推理榜 99.2 第一;备选 MiniMax-M3 |
| 一句话问答、查词 | MiniMax-M3 | 0.25x,就一轮,贵不起来 |
| 真搞不定,要它稳住 | Kimi-K3 | 1.62x 买的是极限不掉链子 |
倍率随活动变动,具体以你面板上显示的为准
这张表里最值钱的是第一行和最后一行。
第一行那个模型,能力、长任务、价格三样同时占住,这种组合不多见。最后一行那句 1.62x,买的不是日常效率,是极限任务上它不掉链子——这钱该花的时候别省,不该花的时候一分都别多给!
「写长文」这一行,我得单独认个怂。
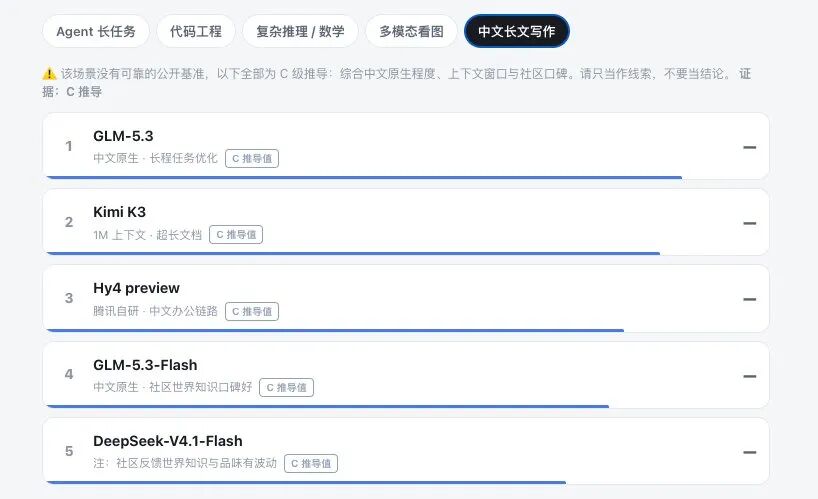
▲ 中文长文写作榜:GLM-5.3 第一、Kimi-K3 第二、Hy4 第三,但全榜都标着 C 级——场景没有可靠基准
这张榜自己就说了:「该场景没有可靠的公开基准,以下全部为 C 级推导。」所以写东西这事,我信的不是榜,是「哪句话出来不像 AI」——只能自己试,试到手感对了为止……
另外两个场景也一并放这儿:
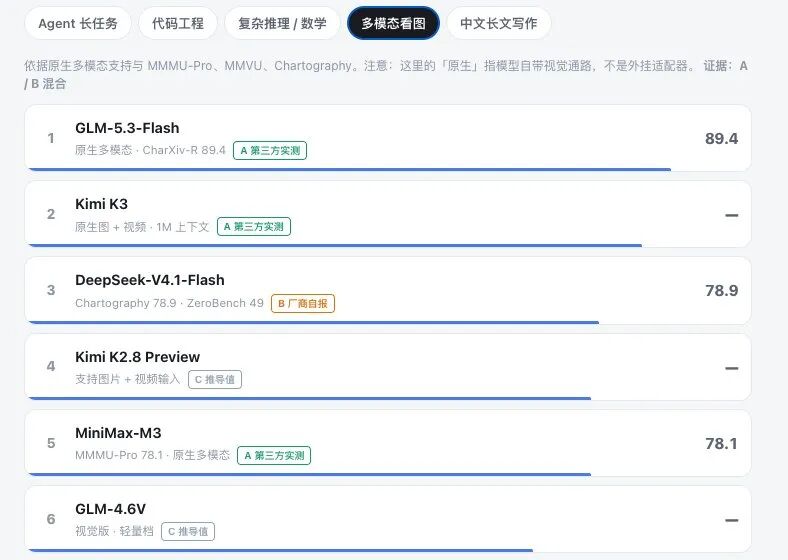
▲ 多模态看图榜:GLM-5.3-Flash 89.4 第一,Kimi-K3 第二,DeepSeek-V4.1-Flash 78.9 第三
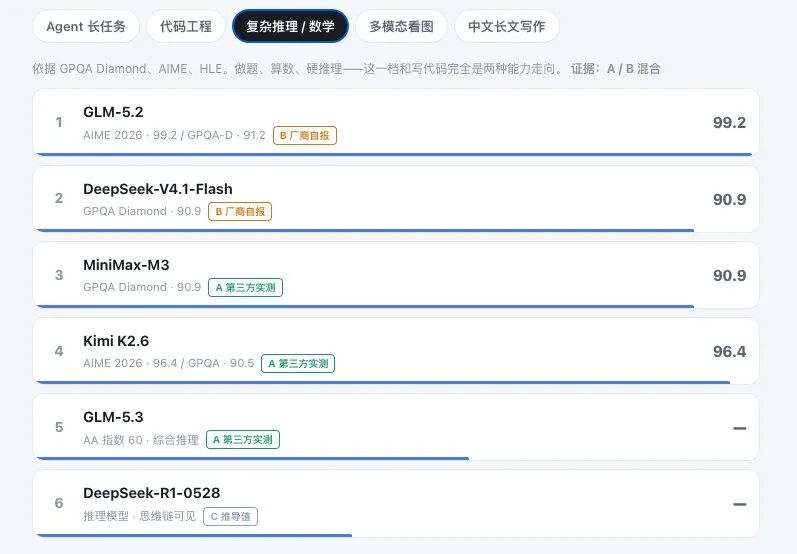
▲ 复杂推理榜:GLM-5.2 99.2 第一,DeepSeek-V4.1-Flash 90.9 第二,MiniMax-M3 90.9 第三
看出规律没有?没有任何一个模型能同时拿下五个榜第一。所以「最强模型」这问题本身就不成立,只有「这件事最强」。
04 最反直觉的四处
有四处我反复看了好几遍。
第一处:最强和最贵是两回事。K3 综合第一,1.62x;GLM-5.3 第二,0.79x。差一分,差一倍价。
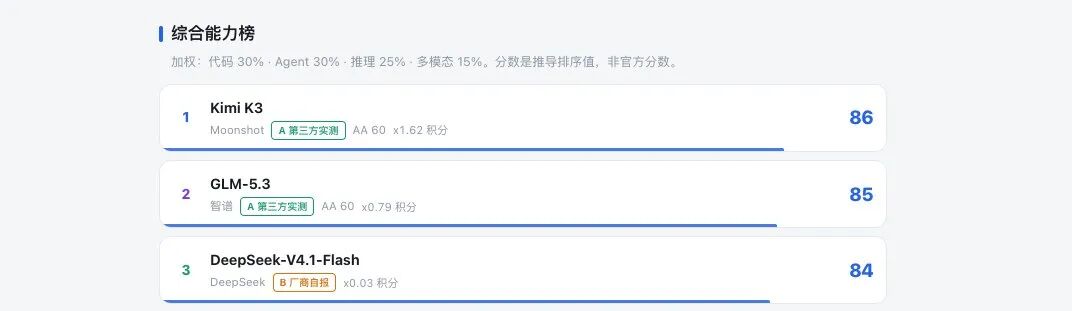
▲ 前三名贴在一起看:Kimi-K3 86 分 1.62x、GLM-5.3 85 分 0.79x、DeepSeek-V4.1-Flash 84 分 0.03x
你要是只看「谁第一」,等于闭着眼挑了最贵的那个!
第二处:偏科生的价值,加权榜看不见。GLM-5.2 综合第七,可推理榜 99.2 分第一,把 K3 都甩在后面。只看综合榜,你这辈子都不会点它。
第三处:免费的没人用。Hy3 挂 0.00x 限时免费,我开了 27 次聊了 13 轮。免费的东西,你反而会怀疑它行不行,一怀疑就聊不长。
第四处最扎心:Agent 榜最强、价格又全场最低的那个,烧掉了我四成的积分。
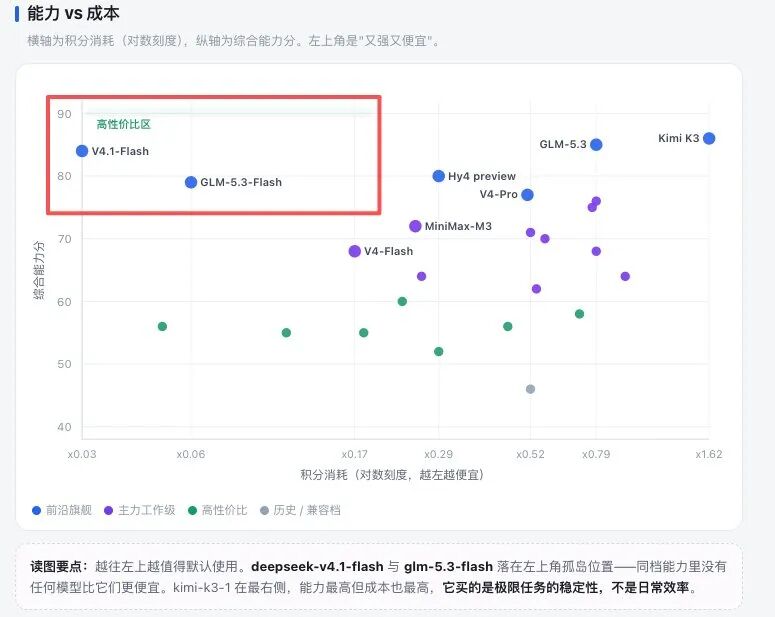
▲ 把能力和倍率画在同一张图上:横轴越往左越便宜,纵轴越高越强,左上角那块才是又强又便宜
V4.1-Flash 是 0.03x,全场最便宜。可我那笔 9077.9 分,就是它烧的。
所以别再问「哪个模型便宜」了。真正该问的是:我这件活,值不值得开一个长对话。
05 省积分:2.2 万积分账单告诉我的事
我这人有个毛病,用什么东西都想知道它到底花了我多少钱。
所以前几天我把 WorkBuddy 的用量记录整个翻了出来。从 8 月 7 号第一次用它,到今天……一共 436 个有记录的任务、1288 轮对话,累计 22680.8 积分,token 走了 2549 万。
这些数不是估的,是它自己记在本地数据库里,赖不掉。
先看按模型的分布:
| 模型 | 任务 | 轮次 | 积分 | 每轮积分 |
| deepseek-v4.1-flash | 14 | 358 | 9139.8 | 25.5 |
| fast-model(快速档) | 69 | 424 | 7175.8 | 16.9 |
| hy4-preview | 309 | 265 | 3044.5 | 11.5 |
| auto | 6 | 50 | 1585.4 | 31.7 |
| glm-5.3-flash | 5 | 95 | 1278.6 | 13.5 |
| glm-5.2 | 1 | 76 | 277.1 | 3.6 |
| hy3 | 27 | 13 | 152.4 | 11.7 |
| 本地 spark-x2.6 | 4 | 2 | 3.6 | 1.8 |
数据来源:本机客户端用量数据库(2026-08-07 至 2026-11-16,只列主力模型)
这张表一摊开,三件事挺打我脸。
- 用得最多的不是最贵的。hy4-preview 我开了 309 个任务,扛掉 62.6% 的 token,只花了 13.4% 的积分。
- 最烧钱的是 V4.1-Flash:只占 14 个任务、5.5% 的 token,却吃掉 40.3% 的积分。
- 单轮最贵的反倒是 auto,31.7 分一轮,比谁都贵!
翻到最后,我在电脑前卧槽了一声!
8 月 7 号那天,我开了一个任务,标题就叫「查看微信公众号文章」。前后聊了 341 轮,烧掉 9077.9 积分。
什么概念?我三个月全部用量的四成,都在那一个对话里。
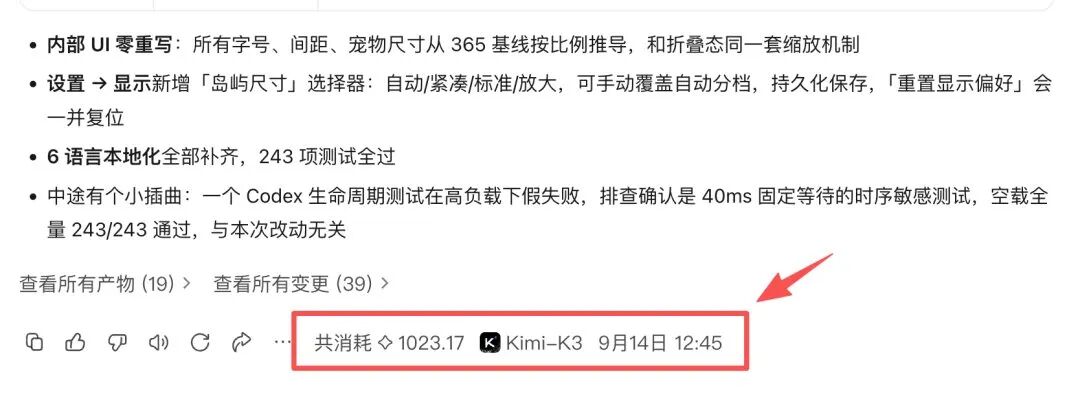
▲ 客户端底部那行小字会实时报账:这一单共消耗 1023.17 积分,用的是 Kimi-K3
单次任务能烧多少?界面底下那行小字会精确到小数点后两位。1023.17 分,用的还是 1.62x 的 K3——签到一天才 100 分,攒十天才够跑这一单。
更离谱的是,那个对话最后残留的上下文只有 4 万 token,按现在的价格本来不该值九千积分。
那钱到底去哪了……
我自己琢磨了两天才算明白:你每发一句话,模型看到的不是这一句,是这个对话里你从头说过的所有话。
第一轮读一千字,第二轮两千字。到第三百轮,它得把前面几万字重读一遍才回你一句「好的」。所以那个 341 轮的对话,累计喂进去的不是 4 万 token,是一百多万。
这就是为什么我老觉得「我明明没问几句,积分怎么没了」。
钱不是花在你问了多少上,是花在你聊了多久上。
怎么算实付价?拿每个模型跑掉的 token 除以它吃掉的积分,就是「1 积分换回多少字」。
| 模型 | 每 1 积分换多少 token |
| 本地 spark-x2.6 | 96,574 |
| hy4-preview | 5,243 |
| fast-model | 593 |
| glm-5.3-flash | 466 |
| deepseek-v4.1-flash | 152 |
token 取客户端累计用量,积分取逐轮记录累计值,均为本机数据(2026-08-07 至 2026-11-16)
排第一的是本地跑的,96,574——1 积分换九万多个 token;排最后的 V4.1-Flash,152。
两头差了 635 倍!
我知道这么比不公平……本地模型不吃云端算力,fast-model 是打包档位,能力和价格根本不是一个量级。这数不代表谁更强,只代表「同一件事,我付了多少钱」。
说三个我现在真在用的土办法:
- 一个对话别超过 50 轮,超了就让它先总结成一段话,复制出来新开一个
- 换任务就换对话,别在同一个窗口里从写文章切到查数据!
- 长对话里别让模型反复读大文件——读一次,后面每轮都在重发
一件事今天做不完,明天也别翻昨天那个对话——新开一个,把结论贴进去,比继续聊便宜得多。
效果是有数的:我 8 月一个月烧掉 16931 分,9 月掉到 1182 分,10 月 2772 分。
这也跟我 8 月刚上手、什么都想试有关系,不能全算方法头上。
省积分的第一步,是换对话,不是换模型。
06 最后说几句
这份排名是我自己的,不是官方数据,也不是权威评测,只能说明我怎么用,说明不了谁家模型更强。我也知道这些数下个月可能又变……倍率会调,新模型会上,榜会重排。但有件事不会变:上下文是要花钱的,你聊的每一轮,都在为前面所有轮付一次费。
想明白这点之后,我看工具的心态都变了——不再纠结选哪个,而是琢磨怎么把一件事拆成几次干净的对话。以前总想找「最好的」,现在只找「最配的」,活儿干完就关窗口,比什么都省!
毕竟工具是拿来用的,不是拿来供着的!
真正贵的从来不是模型,是你舍不得关掉的那个对话框。
本文由人人都是产品经理作者【晓庄AI创业笔记】,微信公众号:【晓庄AI创业笔记】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于CC0协议

- 目前还没评论,等你发挥!