起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
让 AI 补货,但不让它算库存——LangGraph 在生鲜补货的落地实践


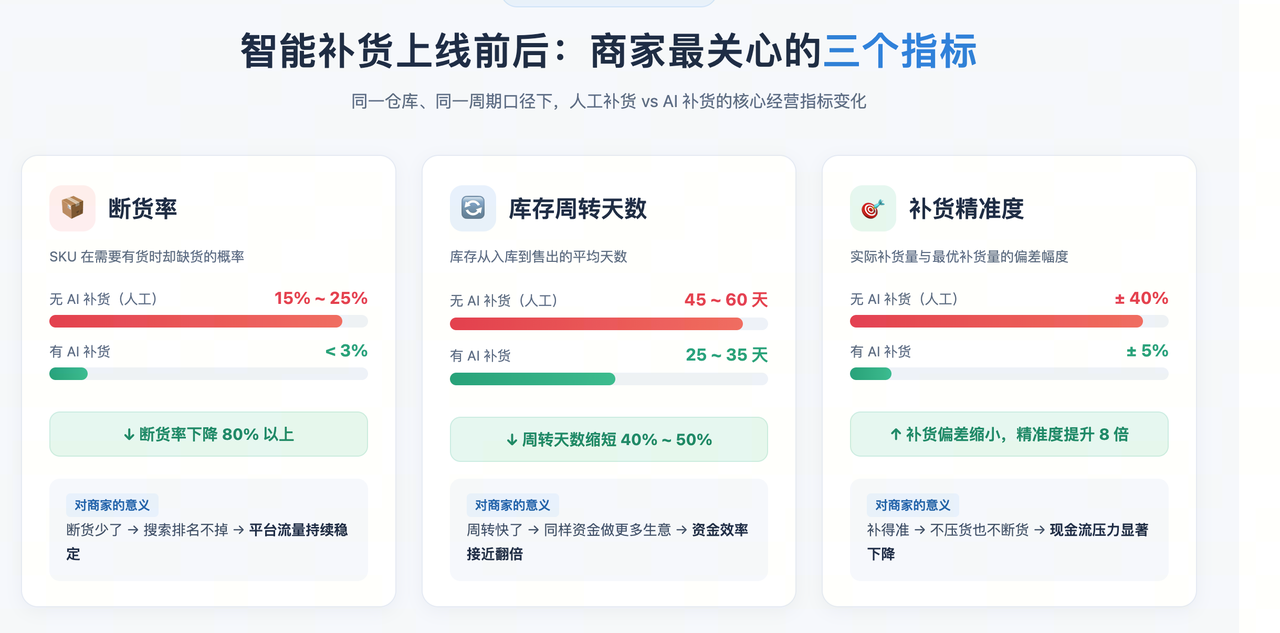
当业务逻辑是确定性计算时,AI 到底该做什么、不该做什么?这篇文章用一次生鲜智能补货的落地过程,拆解 LangGraph 编排 + MCP 工具化代理的三层架构,讲清楚"AI 管调度、业务管计算"的边界该怎么划。
一、从一个真实场景说起
我们做的是生鲜电商的智能补货。业务后端已经有一套成熟的存量 API:日均销量怎么算、实际库存怎么扣减、保险库存怎么定、什么时候触发补货提醒——这些算法逻辑全在后端跑了很多年,稳定、可审计、能回溯。
现在要接入 AI。产品诉求很朴素:
商家在对话里问一句”仓库 WH01 今天有哪些 SKU 该补了”,系统能自动跑完整个补货判断链路,最后用一句话告诉商家哪些 SKU 紧急、要补多少、外部库存还能用多少。
但真正动手设计的时候,第一个冒出来的问题不是”AI 怎么做补货”,而是——这件事,到底要不要让 AI 做?
二、核心矛盾:AI 能力强,但补货是确定性计算
补货这件事的本质,是一串步骤固定、计算确定的流水线:
- 确认提醒日期和覆盖 SKU
- 算日均销量
- 算实际库存 =(初始库存 − 日均 × 时间间隔)× 活动系数 × 类目系数
- 算保险库存 = 日均 ×(最低周转天数 + 1)× 活动系数 × 类目系数
- 对比实际库存与保险库存,得出补货数
每一步都是纯数学公式,输入确定、输出就确定。这里面没有任何”创意发挥””语义理解””模糊判断”的空间。
而大模型的强项恰恰是后者——理解意图、拆解任务、解读结果、组织语言。让它去做乘法口诀式的确定性计算,反而是它的弱项:会算错,会幻觉,会编一个看着合理实则离谱的数字。
这就形成一个尖锐的矛盾:
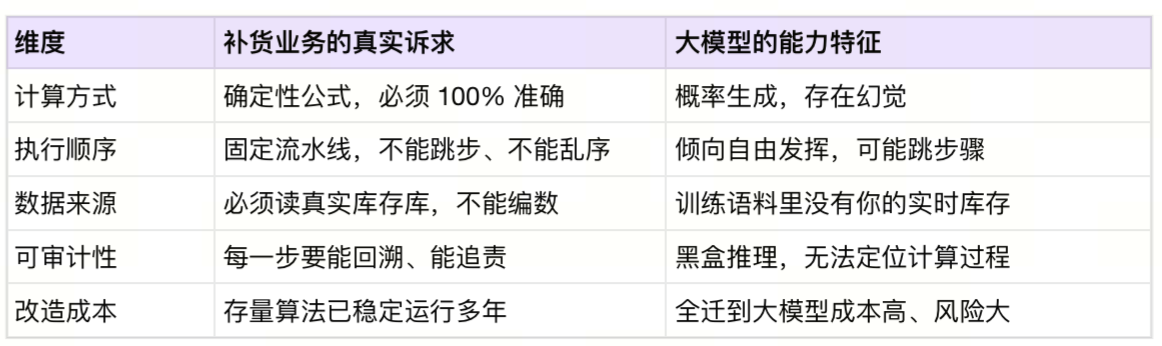
如果硬把补货逻辑全塞给大模型,等于把一套跑了多年、逻辑清晰的确定性系统,换成一台会”猜数字”的概率机器。这是用 AI 的短板去打业务的硬需求。
三、选型思考:为什么是 LangGraph + MCP
想清楚矛盾之后,架构选型就清晰了——AI 和业务必须分层,各干各的。
经过权衡,我们选了 LangGraph 做流程编排 +MCP做存量接口的工具化适配 这套组合。选型理由不是”它火”,而是它正好对得上我们这个场景的三个硬约束:
约束一:流程必须固定,不能让 AI 自由发挥。 LangGraph 的核心是”图”——节点(Node)和边(Edge)构成的有向图,边就是流程的硬性约束。按预先定义的顺序执行,每执行完一个 Node 归入已执行集合,未执行步骤随之减少,流程推进状态清晰可控,不会出现乱序、跳步的问题。这正好对上”补货是固定流水线”的诉求。
约束二:全链路数据要可回溯。 补货链路一跑就是 5 步,每步产出 SKU、库存、销量这些中间结果。后面任意一步要能直接读到前面产出的数据,不能重复查库、不能重复算。LangGraph 用一个全局 State 做全链路上下文载体,上游所有节点的入参、中间结果、判断标记全部保存在 State 里向下传递,整条链路的数据可回溯,便于问题排查。
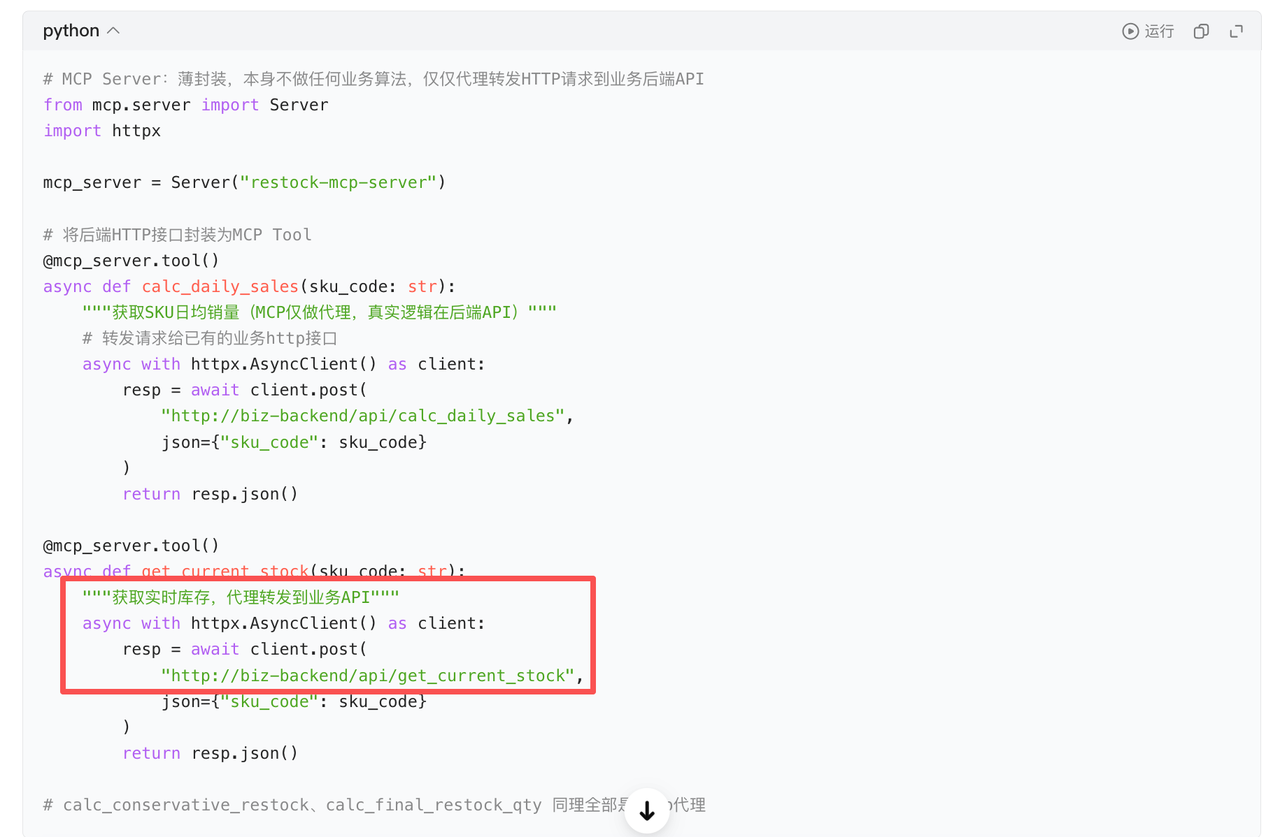
约束三:存量业务API不能推倒重来。 日均销量、库存读取、补货量计算这些算法逻辑,后端已经实现并稳定运行。如果迁移到大模型侧,改造成本高且容易引入幻觉。MCP(Model Context Protocol)正好是”把存量 API 包装成 AI 可调用标准工具”的薄代理层——MCP-Server 本身没有任何业务逻辑、不做计算、不访问 DB,只做 HTTP 代理转发。
一句话总结这套架构的本质:
AI 管调度,MCP管执行。 AI 不碰数据库,不碰计算;MCP-Server(或 Function Calling 里的函数)才是真正执行 SQL、调 API 的角色。AI 只负责”决定调什么 + 把结果组织成人话”。
四、三层架构拆解
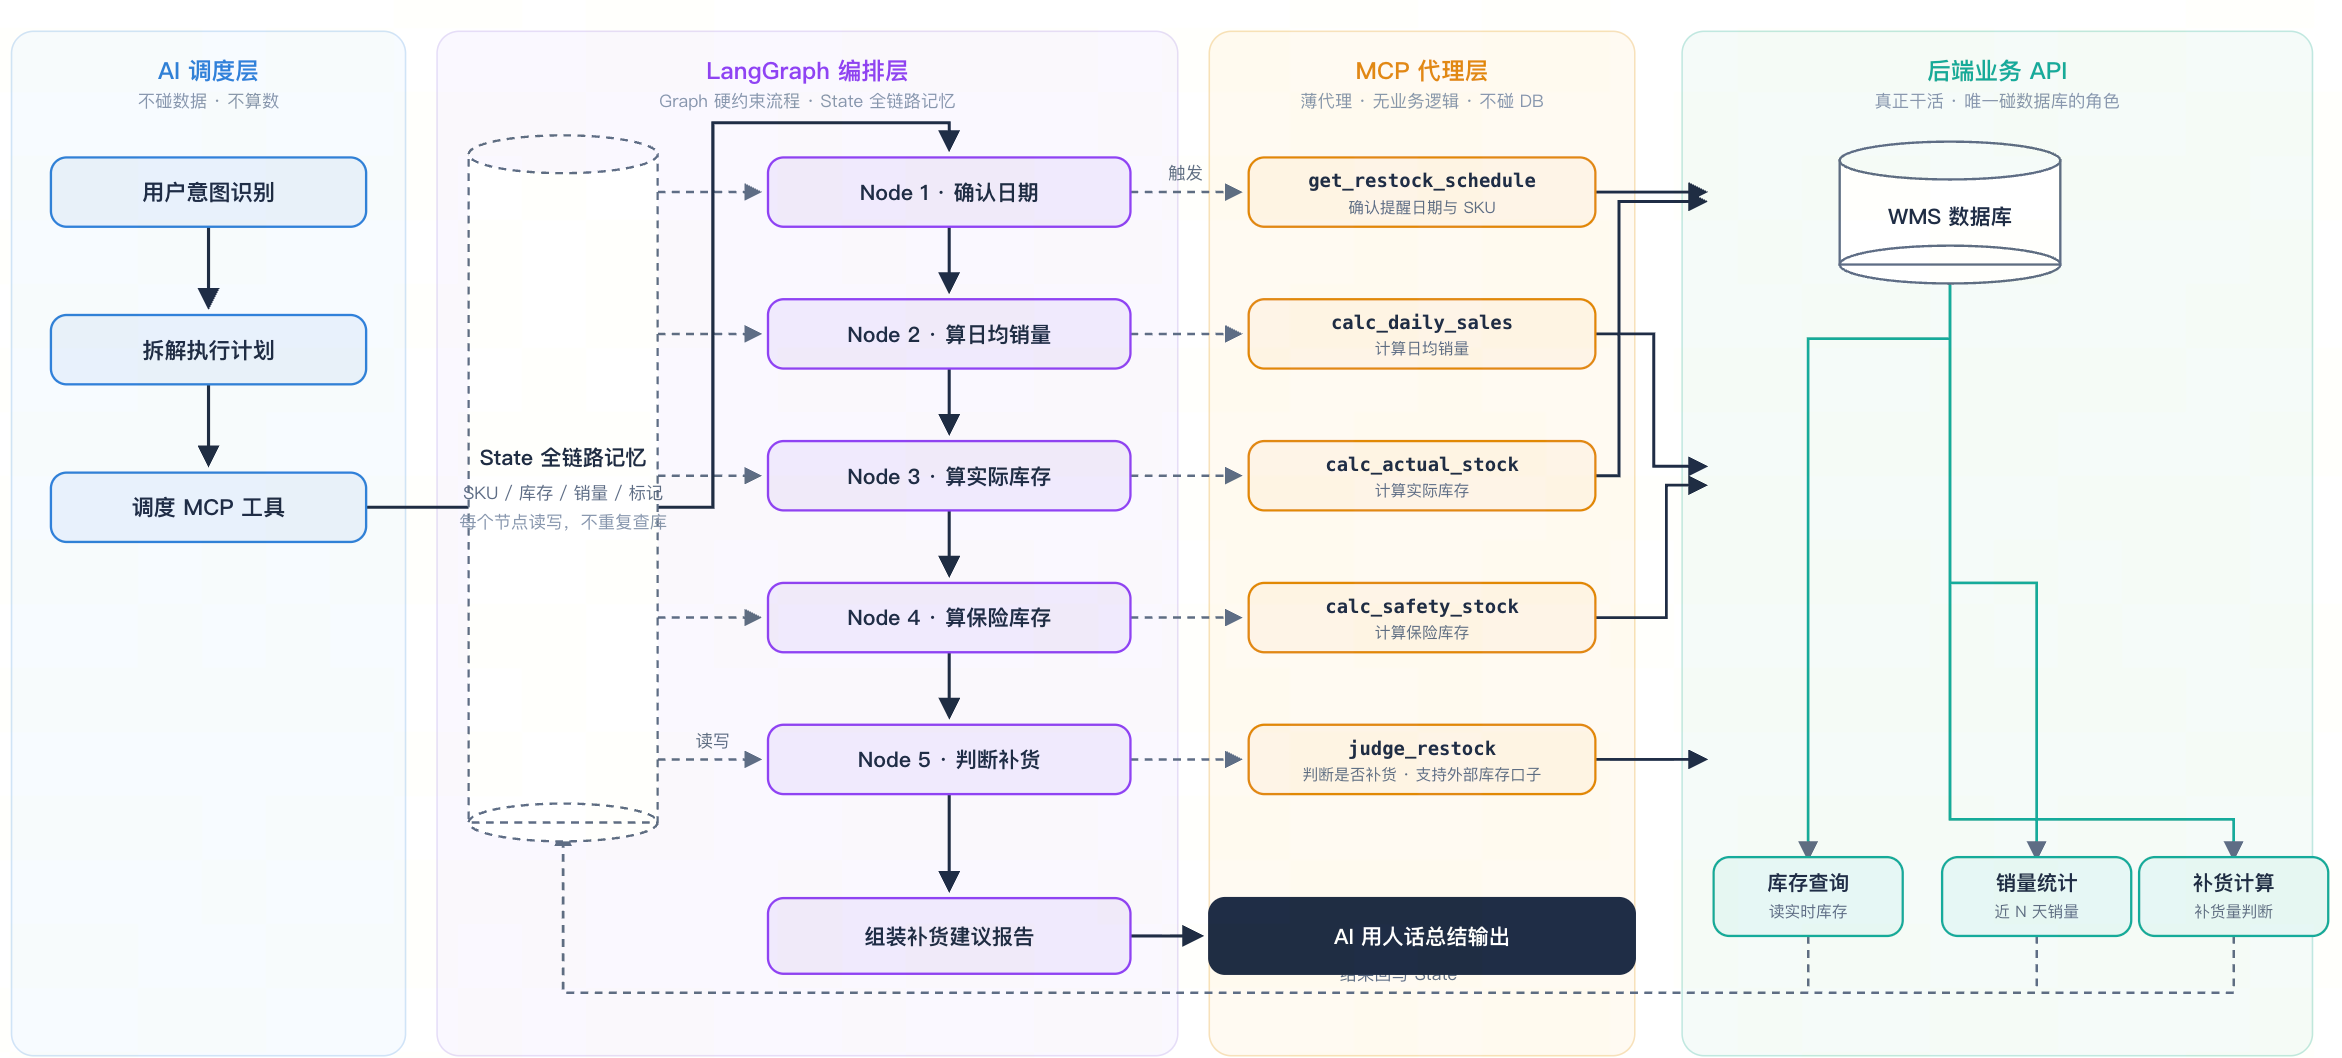
整体架构可以拆成三层,每一层职责清晰、边界分明。
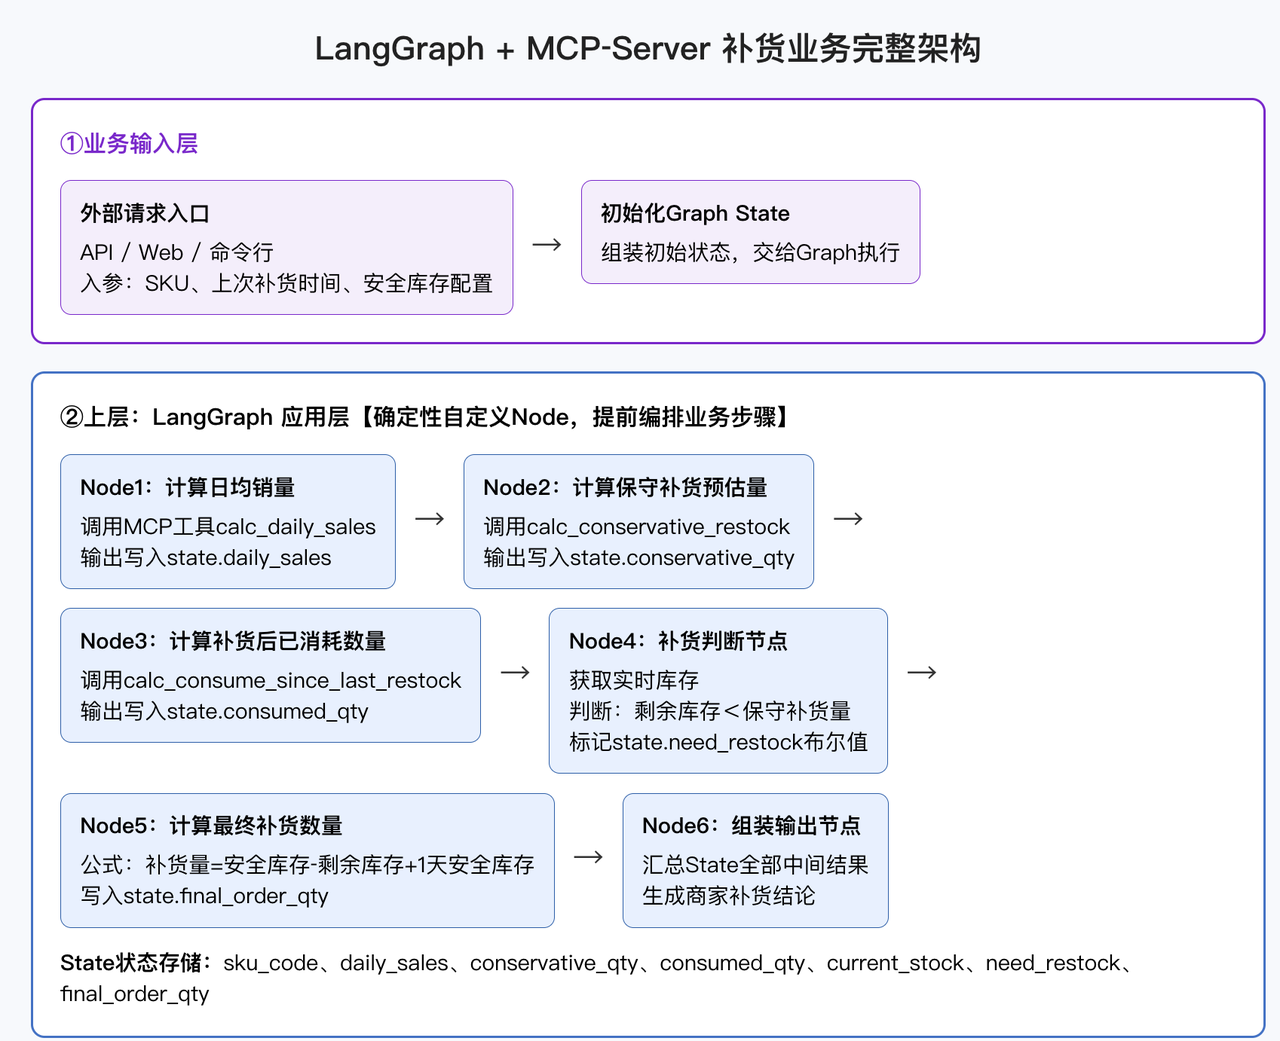
第一层:路线规划层(LangGraph 的 Graph)
流程由 Graph 的边做硬性约束,按预先定义顺序执行。补货链路被固化为固定的节点序列:确认日期 → 算日均 → 算实际库存 → 算保险库存 → 判断补货。每跑完一个节点,该节点归入已执行集合,未执行步骤随之减少。
这一层保证的核心价值是流程可控:大模型不会随意跳步骤,不会跳过”算实际库存”直接去判断补货。流程的”硬”是由 Graph 结构保证的,不是靠 prompt 哄出来的。
第二层:状态记忆层(LangGraph 的 State)
State 是整条业务的上下文载体,整条链路的数据交互都靠它传递。上游节点的入参、中间计算结果(SKU、库存、销量)、判断标记,全部保存在 State 里向下传递。后续任意节点都可以直接读取前面产出的数据,不需要重复查库、重复计算。
State 默认存内存,进程重启会丢;要支持会话记忆和断点续跑,就接入 Checkpointer 检查点组件,搭配 thread_id 把整个 State 持久化。所有节点只能读取和修改 State,节点之间不直接传参,全部依靠状态驱动。
如果业务更复杂,会在框架内置的 MessagesState 基础上做自定义扩展,追加 session_id、user_id、tool_records、loop_count、error_info 这些字段:
- tool_records:记录 MCP 每次调用日志,方便排查
- loop_count:限制最大循环次数,避免 Agent 无限调用 MCP 死循环
- error_info:捕获 MCP 服务异常、网络异常
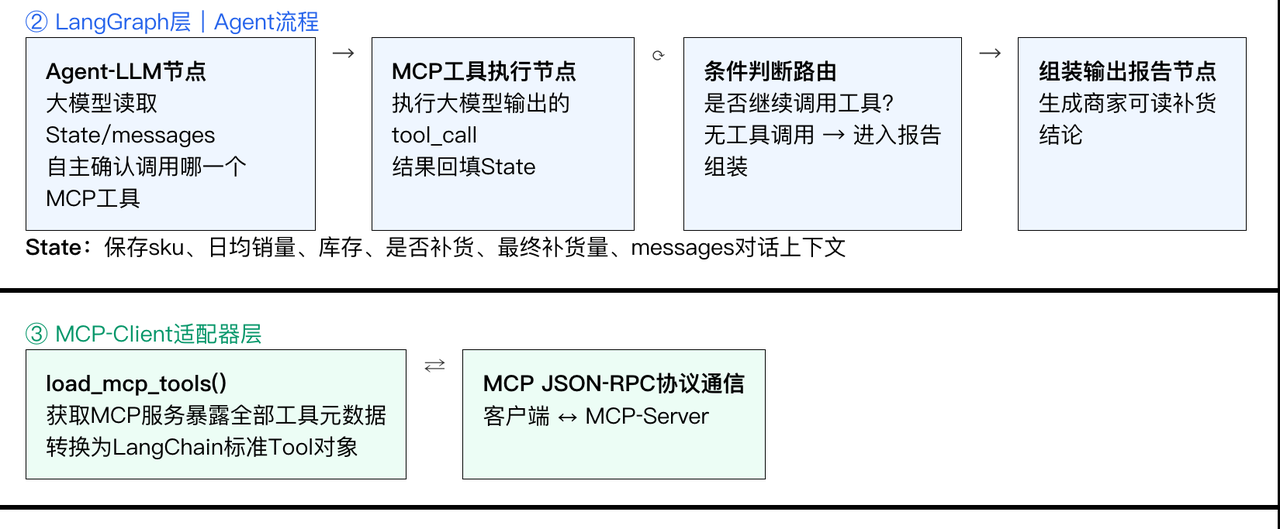
第三层:MCP 代理适配层
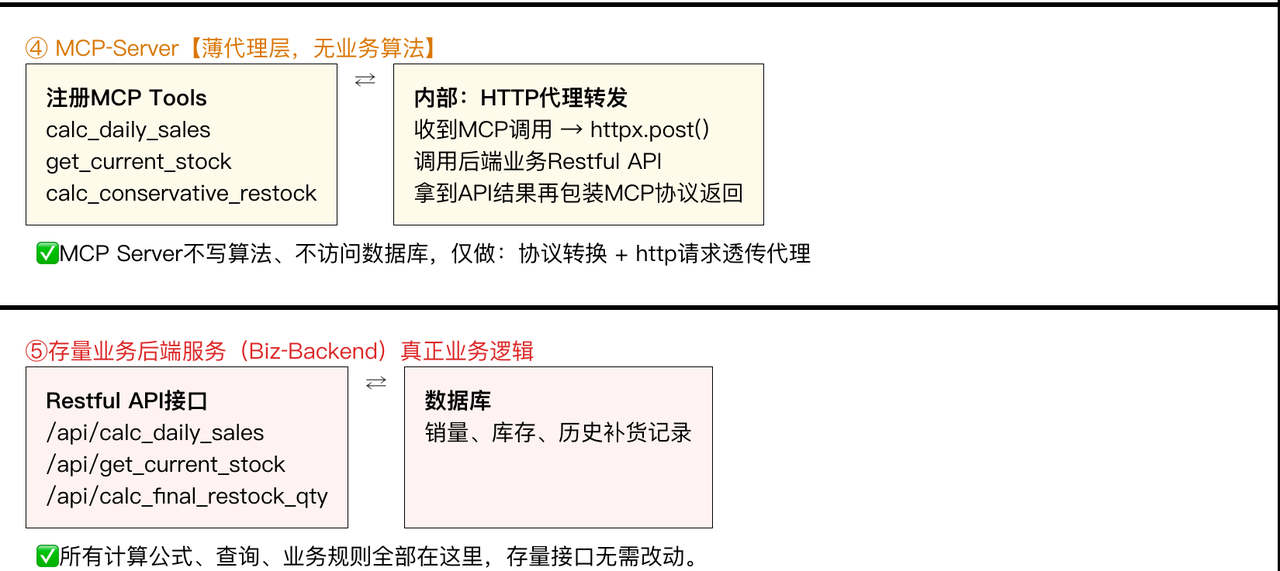
这是连接 AI 和存量业务系统的桥梁。MCP-Server 是一层薄代理,本身没有任何业务逻辑、不碰数据库。Node 需要调用业务能力时,触发 MCP 工具,MCP 内部做 HTTP 代理转发,调用后端真实业务 API,接口返回的业务结果会写回到 State,再继续流转到下一个节点。
外层是 MCP 协议通信,内部就是普通的 HTTP 调用。这样设计的好处是:存量业务服务零改造,MCP 只是把 Restful 接口”翻译”成 AI 能调用的标准工具。
三层各自的职责边界,用一张表说清楚:
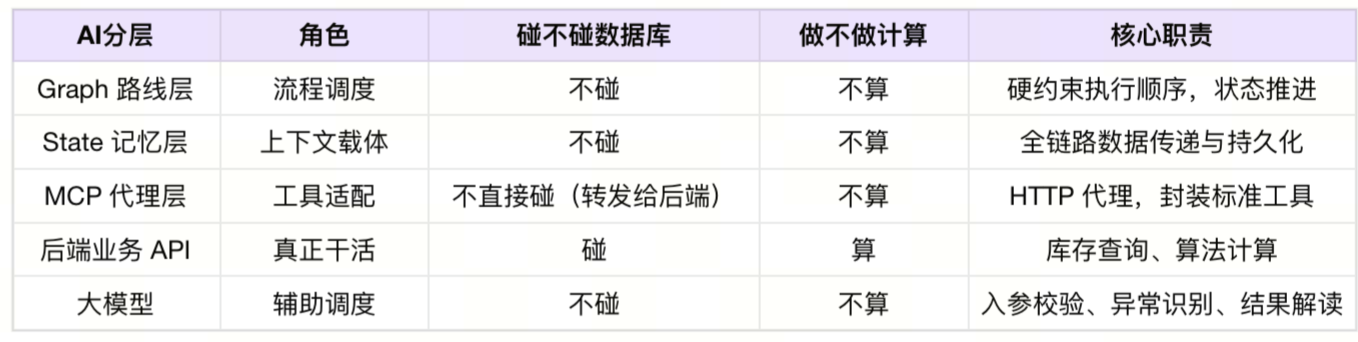
整体链路是这样跑的:
Graph 按规划路线推进 Node → Node 调用 MCP 工具 → MCP 内部 HTTP 转发调用存量业务 API → 后端完成真实业务计算 → 结果回写 State → 更新已执行/未执行步骤,流转至下一个节点,直至输出补货报告。
五、AI 与业务到底各干什么
很多 AI 落地的坑,根源是没把”AI 该干什么”和”业务该干什么”切清楚。这套架构里,两者的边界是这样划的:
AI 的价值在四件事:
- 理解用户意图——商家说”今天哪些该补了”,AI 要识别出这是要跑补货判断
- 拆成执行计划——把一句话拆成 5 步调用计划
- 遇异常能兜底——库存异常、销量波动这种非标情况,AI 能识别并给出解释
- 把结果说人话——把一堆 JSON 计算结果,组织成商家看得懂的补货清单。
MCP的价值在一件事: 把那 5 个确定性函数包装成 AI 可调用的标准工具。AI 调用 calc_actual_stock(sku_id=”SKU001″),MCP-Server 内部转发 HTTP 请求到 http://biz-backend/api/get_current_stock,业务后端接收到请求后去数据库查库存、执行业务逻辑、返回 {“stock_num”:120},MCP 把这个结果原封不动回传给 LangGraph,回写 State。
AI 不参与计算。 日均销量、库存公式这些纯数学,让 AI 算反而出错——交给工具算。
MCP-Server 是唯一的数据库访问者。 AI 和数据库之间有隔离层,AI 永远拿不到 DB 直连权限,只能通过 MCP 工具间接触达。这一层隔离是整套架构的安全底座。
六、落地流程:一个完整对话流的拆解
光说架构不落地就是空中楼阁。我们看一个真实的补货对话,整条链路是怎么跑起来的。
用户输入:
“仓库 WH01 今天有哪些 SKU 该补了?”
第一步:AI 调度阶段——拆解意图、规划调用
AI 识别出这是补货判断诉求,规划出执行计划:
- 调 get_restock_schedule 确认提醒日期和覆盖 SKU
- 对每个 SKU 依次调 calc_daily_sales → calc_actual_stock → calc_safety_stock
- 最后调 judge_restock 判断
- 用人话总结,列出需要补货的 SKU 清单
注意这里 AI 只做了”规划”,没碰任何数字。
第二步:逐个SKU跑工具链
以 SKU-A 为例,AI 按 Graph 定义的顺序依次触发 MCP 工具:
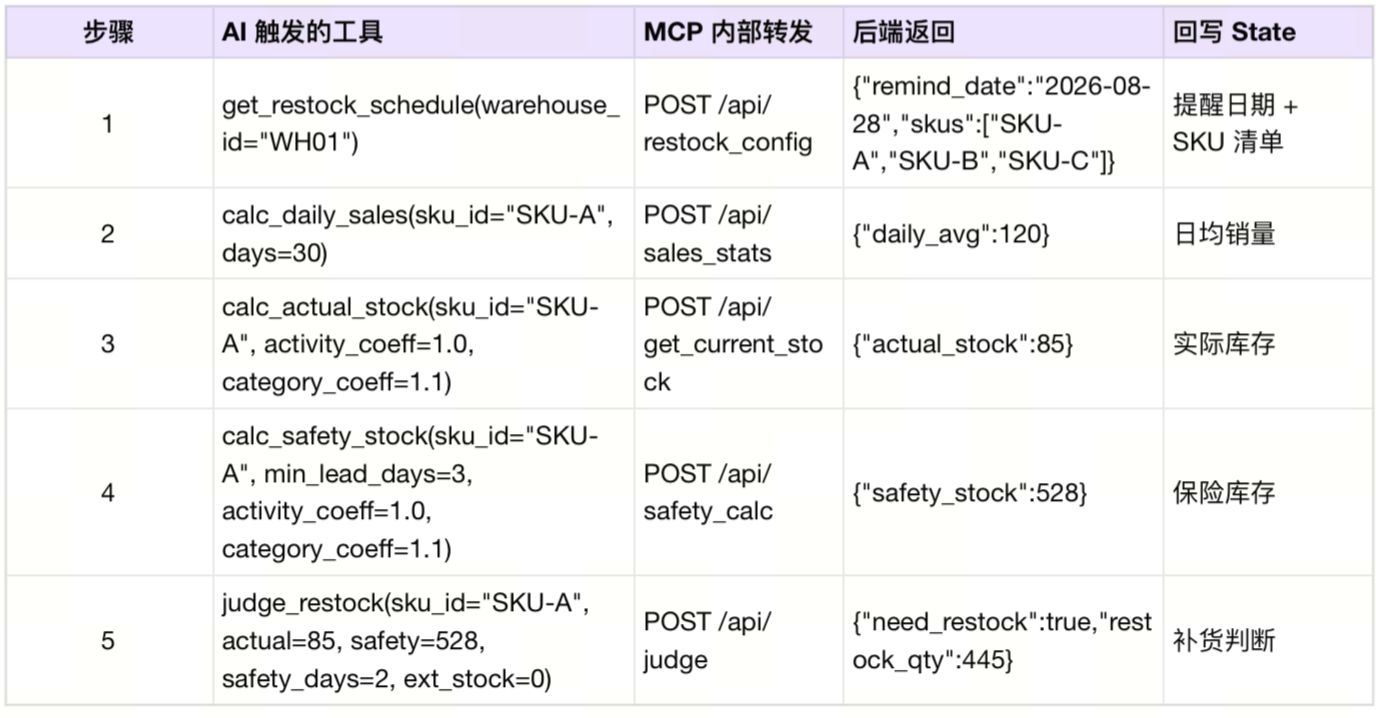
每一步的计算结果都回写到 State,下一步直接从 State 读取,不重复查库。SKU-B、SKU-C 各走一遍同样流程。
第三步:AI 总结阶段——把结果说成人话
全部节点跑完后,AI 从 State 读出所有结果,组织成商家看得懂的补货清单:
今天(8/28)仓库 WH01 有 2 个 SKU 需要补货:
SKU-B 库存充足(620 > 440),暂不需要补货。 SKU-A 紧急度较高,建议优先处理。
这就是一次完整的补货链路。整个过程里,AI 做了三件事:意图识别、调度规划、结果总结;真正算数的,全在后端业务 API 里。
七、几个关键设计点
落地过程中有几个设计决策,值得单独拎出来讲。
1. 5 个工具全是确定性计算,AI 一个都不算
这是这套架构最核心的原则。calc_daily_sales、calc_actual_stock、calc_safety_stock、judge_restock——每一个都是纯函数,输入确定、输出就确定。AI 看到这些工具的入参描述(比如 sku_code),知道什么场景该调哪个,但绝不自己去算数字。这一刀切下去,从根本上规避了大模型幻觉对核心补货逻辑的破坏。
2. 外部库存的口子,留在工具入参里
补货场景有个真实诉求:商家手头可能有一批外部库存(在途、调拨、临储),需要在判断时考虑进去。这个口子怎么留?
不是让 AI 自己去判断”外部库存要不要算”,而是在 judge_restock 工具的入参里加一个 ext_stock 参数。AI 从用户对话里拿到外部库存数,作为参数传给工具,工具内部做最终判断。这样既保留了灵活性,又把判断逻辑锁死在工具里。
3. 加新逻辑只改 MCP,不动 Agent
如果以后要加新能力——比如把”在途入库量”纳入补货判断,只改 MCP-Server 加一个 get_in_transit_stock 工具,Agent 那边 prompt 改一句”算完实际库存后,再调在途库存工具”就行。整个架构的扩展性来自工具层,不动 AI 调度逻辑。
4. State 用 Checkpointer 持久化,支持断点续跑
补货链路一旦跑到一半中断(比如网络抖动),不用从头重来。Checkpointer 搭配 thread_id 把整个 State 持久化,下次进来从断点继续。对长链路、多 SKU 的场景,这个能力很关键。
八、可复用的设计原则
这套架构跑通之后,提炼出几条可复用的 AI 落地设计原则,适用于”业务逻辑是确定性计算、又想接 AI”的场景:
原则一:先判断业务本质,再决定 AI 介入深度。 不是所有业务都适合 AI 直接做。先问一句:这套业务的核心逻辑是”确定性计算”还是”模糊判断”?确定性计算(补货、风控规则、计费)就让 AI 退到调度层;模糊判断(推荐、文案、客服答疑)才让 AI 进决策层。补货属于前者,所以 AI 不碰计算。
原则二:存量系统零改造,用代理层做适配。 存量业务 API 已经稳定运行多年,推倒重来是最大的风险。用一层薄代理(MCP 或 Function Calling)把 Restful 接口包装成 AI 可调用的标准工具,存量服务零改造,AI 也拿到了能力入口。改造成本最低,风险最小。
原则三:流程的“硬”靠结构保证,不靠 prompt 哄。 固定流水线场景,别指望用 prompt 让大模型”按顺序执行”——它会跳步、会乱序。用 LangGraph 的 Graph 结构做硬约束,边就是流程的物理边界。这一刀下去,流程可控性从”概率层面”提升到”结构层面”。
原则四:AI 和数据库之间必须有隔离层。 AI 永远拿不到 DB 直连权限,只能通过工具间接触达。这不是不信任 AI,而是边界清晰才能追责——出了问题能定位是 AI 调错工具,还是工具算错数,还是数据库本身有问题。三层各司其职,排查才有路径。
原则五:扩展性来自工具层,不动调度层。 新能力加在工具层(MCP 加一个工具 + Agent prompt 改一句),而不是改 AI 调度逻辑。这样扩展不会引入新的不确定性,AI 的行为可预测。
九、写在最后:AI 落地的本质是划清边界
回看这次生鲜补货的 AI 落地,最大的收获不是用了 LangGraph、不是接了 MCP,而是想清楚了一件事:
AI 落地的难度,不在“让 AI 能做什么”,而在“让 AI 不做什么”。
补货这件事,AI 能不能算日均销量?技术上能,让它调个计算器工具自己算也行。但该不该让它算?不该。因为确定性计算要的是 100% 准确和可审计,不是概率生成。
划清边界之后,剩下的反而简单:AI 做它擅长的(理解、调度、总结),业务做它该做的(计算、查库、判断),中间用 MCP 做标准化的工具适配。这套分层跑下来,既接入了 AI 的能力,又保住了存量业务的稳定性和可审计性。
MCP 在固定节点流水线里的角色,一句话总结:把你的确定性业务逻辑包装成 AI 可调用的标准化接口,AI 只做调度不做计算。
这套思路不止适用于补货。凡是”业务逻辑是确定性计算、存量系统已稳定运行、又想接 AI 提升交互体验”的场景——计费、风控规则、库存调度、对账——都可以套这个框架。AI 落地的红利,不在替换存量,而在增量赋能;不在让 AI 包打天下,而在让 AI 做它该做的事。
本文由 @Totoro畅 原创发布于人人都是产品经理,未经许可,禁止转载
题图来自 Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!