
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
准确率 97.8% 的模型,为什么换个场景就全部误报?


一个在公开数据集上 AUROC 高达 0.978 的电弧故障检测模型,在跨负载测试中竟出现概率反向的灾难性失效。本文复盘了这个边缘 AI 项目暴露的三个关键问题:产品逻辑依赖的阈值校准远比排序能力脆弱;漏报与误报的代价不对称必须在选模型前想清楚;当分数不可信时,产品应该展示证据而非概率。这些教训与电弧无关,任何 AI 产品经理都会撞上。
去年我参与了一个有点特殊的项目:用深度学习做串联电弧故障检测——就是电线接头松动、绝缘老化时,那种肉眼看不见、但持续打火、最终烧起来的东西。
这东西的产品形态很清晰:一个装在配电箱里的边缘盒子,实时监听回路电流,判断有没有电弧,有就报警、断电。
模型训出来,指标很漂亮。在公开数据集上 AUROC 0.978,比传统方案(手工特征 + 逻辑回归)的 0.934 高出 4.4 个点。按任何常规标准,这都可以开香槟了。
然后我们做了件当时觉得很常规、后来发现是整个项目最值钱的一件事:把 13 种负载逐一轮流留出来,当作”没见过的设备”来测。
结果很难看。整体上我们的方案反而不如传统基线(AUROC 0.843 vs 0.904),而且方差大得多。更难看的是其中两个负载——模型不是变差,是彻底反了。
这篇文章想讲的不是”我们后来怎么修好的”(我们没完全修好),而是这中间暴露出来的三个问题。我认为它们和电弧、和电力都没什么关系,任何做 AI 产品的人都会撞上。
一、”准确率”衡量的是排序,产品逻辑依赖的是阈值
先看那两个崩塌的负载,具体是什么样。
在源域(模型训练时见过的那些负载)的验证集上,模型近乎完美:AUROC 0.998、0.999。正常窗和电弧窗的概率分得很开,一看就知道该怎么定阈值。
把同一个模型拿到目标域(没见过的负载)上,概率变成了这样:
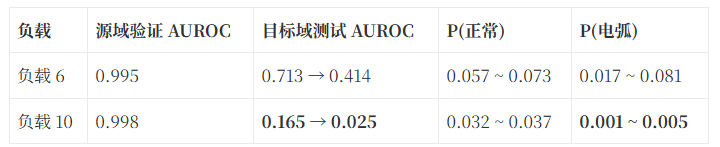
请把最后一行读两遍。
模型对电弧给出的概率是 0.005,对正常给出的是 0.037。它在告诉你:电弧比正常更不像电弧。
这不是”判断得不太准”,这是系统性反向。而同一个模型在源域上是 0.998。
这里发生了什么
我们花了很久排查,最后排除了三个最像的原因:
- 不是标签错了。逐窗核对过,14 类标签和 2 类标签严格对齐。
- 不是幅度失配。负载 10 的电流 RMS 比是 0.85,和那些成功迁移的负载(0.82~0.90)几乎一样。信号强度没问题。
- 不是信息不在信号里。这一点最关键:我们只用一个手工特征(1kHz 以上频段能量占比),在负载 10 上就能拿到 AUROC 0.957。
也就是说,判别电弧所需的信息,明明就在信号里,用一行公式都能捞出来。是模型没能把它迁移过去。
真正的原因是协变量偏移下的校准失效。说人话:
模型学到的”电弧长什么样”,是和它见过的那些负载的具体形态绑在一起的。换一个形态完全不同的负载,输入分布漂移了,模型的输出概率整体被压缩、饱和,绝对数值失去意义——但它内部对”更像电弧/更像正常”的相对排序,有一部分还保留着。
这就解释了那个反直觉的组合:AUROC 还能有 0.958,但两类概率已经完全重叠。
我们在另一个场景里看到过更温和的版本:源域上正常 0.23 / 电弧 0.76,分得清清楚楚;换到未见负载,变成 0.76 / 0.78——几乎完全重叠。
为什么这件事对产品经理重要
因为绝大多数 AI 产品的决策逻辑,都是这么写的:
电弧概率大于 0.7,就断电。
这个逻辑依赖的是绝对概率,也就是”校准”。而上面所有证据都指向一个结论:校准是模型能力里最脆弱的一环,它比排序能力脆弱得多,而且它偏偏是唯一被产品逻辑直接依赖的那个。
AUROC、AUC 这些指标衡量的是排序能力——把所有样本按分数排队,正样本排得够不够靠前。这个能力在域偏移下相对稳。
但”p = 0.76 意味着 76% 的可能是电弧”,这是校准。换个场景,它可以瞬间变成一句废话。
而我们当时选模型、调阈值、写验收标准,用的全是 AUROC。我们从头到尾都在优化一个产品逻辑不依赖的指标,却以为自己在优化产品能力。
这是一个很贵的认知错位。
可迁移的检查清单:
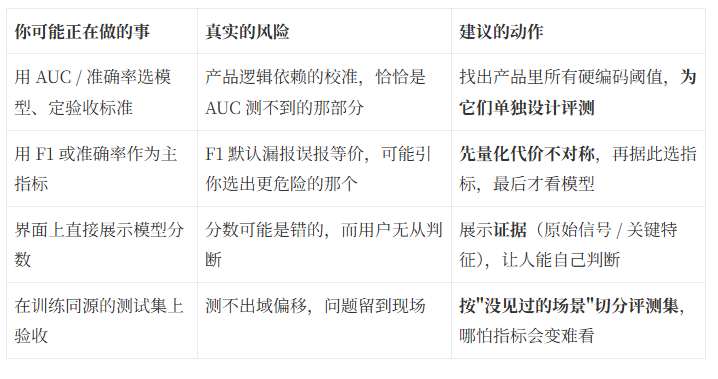
- 你的产品逻辑里,有没有一个硬编码的阈值?如果有,你就在依赖校准——请专门为它设计验收标准,而不是用 AUC 蒙混过去。
- 上线前的评测集,是不是和训练集同源?如果是,你测不出这个问题,它会留到现场才发作。
- 产品要不要”兜底”?比如概率落在一个可疑区间时,不自动断电、而是转人工确认——这本质上是承认校准不可信,用流程补模型的洞。
二、漏报和误报,从来就不是等价的两件事
第二个教训来自一次”选错模型”的经历。
我们试了两种损失函数。一种常规(交叉熵),一种能额外输出”不确定性”(证据深度学习,EDL)。在真实数据上:
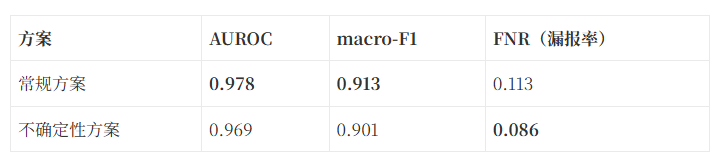
按 AUROC 和 F1 排,常规方案赢。按漏报率排,不确定性方案赢——漏报少了 24%。
那么问题来了:该选哪个?
这个问题的答案不在数据里,在产品定义里。
- 漏报(有电弧,模型说没有)= 该断的电没断 = 可能烧起来。
- 误报(没有电弧,模型说有)= 不该断的电断了 = 用户停电一次,去合闸,骂一句。
这两件事的代价,差了好几个数量级。一次火灾的代价,可能是几十次、几百次误停电都换不回来的。
所以对这个产品,”漏报率低 24%” 的价值,远远大于 “AUROC 高 0.009″。
如果我只盯着 AUROC 选模型,我会选那个更容易烧起来的。
更麻烦的是,这个判断必须在选模型之前做完
我们差点掉进一个更隐蔽的坑:先看指标,再回头解释为什么这个指标重要。 那是事后合理化,不是产品决策。
正确的顺序应该是反过来的:
- 先定义代价不对称。 漏报一次的成本是多少?误报一次的成本是多少?差几倍?
- 再据此确定主指标。 如果代价不对称,就别用 F1 这种”默认漏报误报等价”的指标。F1 会把你引向一个平庸的中间地带。
- 最后才去看模型表现。
一个可操作的量化方式:算出”一次漏报 = N 次误报”,然后直接优化加权代价。这个 N 是多少不重要,重要的是你被迫把这件事想清楚,而不是让 F1 替你默认 N = 1。
顺带说一个我们踩过的具体坑:那个能输出不确定性的方案,在小样本上收敛特别慢——同样的架构,60 轮时 AUROC 0.953,跑到 200 轮才 0.966;而常规方案 200 轮能到 0.990。
当时我们的判断是”这个方案不行”。后来才明白:它的价值本来就不在判别精度,在不确定性输出。 这个结论和 NeurIPS 2024 上一篇文章(”EDL a Mirage”)的发现一致——这类方法更像是一个”这东西我没见过”的探测器,而不是一个更准的分类器。
我们用错了尺子,差点扔掉一个对产品更有用的东西。
三、当分数不可信,产品应该给证据,而不是给分数
前两节说的是”模型靠不住”。那产品怎么办?
这里有一个我觉得挺重要的转变:别再把模型的输出当成结论展示给用户,把它当成线索。
这个转变直接影响了我们的界面设计。原本最自然的做法是——界面上放一个大数字:电弧概率 0.76。
问题是,看完第一节你就知道了:这个数字在换场景后可能毫无意义,甚至会反向。用户看到 0.76 会断电,但这个 0.76 可能是错的。
后来我们改成了展示证据。
电弧检测的原理本身,就是一个很好的可视化对象:正常回路的电流波形,被限制在一个”容差带”里;电弧发生时,高频毛刺会击穿这个容差带。示波器上有个经典功能叫 mask test——画一个容差掩模,波形越界就打标记。
这恰好就是检测原理本身。
所以界面上那个核心元素变成了:波形 + 两条容差线 + 一个实时越界计数(越界 3 / 200)。而且颜色不是按”设备风险等级”给的,是按”波形有没有真的越界”给的——这样”橙色出现”永远等于”波形真的击穿了容差带”,颜色本身携带信息,不是装饰。
这个设计带来的差别是:
- 给分数,用户只能选择信或不信,而且他无从判断该不该信。
- 给证据,用户(以及来验收的人)能自己判断——”这波形确实有毛刺击穿包络,确实像电弧”,或者”这看着挺正常的,为什么报警”。
后者才是可决策的。 尤其是当模型自己的置信度不可信时,把原始证据摆出来,是把判断权交还给人的唯一方式。
一个容易被忽略的前提:训练时和部署时必须行为一致
还有一个更底层、更技术但我觉得产品经理也该知道的事。
边缘端部署是逐窗推理——一次只处理一个窗口(batch size = 1)。而训练时是成批处理的(batch size = 32 或 64)。
我们实测过一个归一化层的影响:同一个输入窗口,在 batch=1 和 batch=4 下的输出差了 0.1748。
同一个输入,模型给出的答案不一样——只因为它旁边还有没有别的样本。
这在训练时完全看不出来(训练永远是成批的),但部署时每一条都是单条推理。也就是说,模型在现场的行为,系统性地偏离了你在实验室测到的行为。
换掉这个层之后,同样的对比差异降到 1.4e-06,可以忽略。
这件事的教训不在于技术选型,而在于:“实验室指标”和”现场行为”之间,隔着一整类只在部署形态下才暴露的问题。 这类问题不会出现在任何验证集上,因为验证集的构造方式和训练集一样。它们只会在现场出现,而且表现为”模型好像变笨了”,让你无从查起。
我们现在有一条自动化测试专门断言这个性质——并且配了一条对照,用来确认”另一种方案确实会依赖 batch”。把这类不变量写成测试,是唯一能防止它被后人改回去的办法。
把三件事收拢成一张检查清单
回头看,这三个教训其实是同一个问题的三个面:我们把”模型表现好”当成了”产品能用”。
最后说一句可能有点反直觉的话。
这个项目做完,我认为那个 AUROC 0.978 不是最有价值的产出,那个”整体不如基线、两个负载彻底崩塌”的负面结果才是。
因为前者只是证明了”这条路能走通”,而后者告诉我们这条路会在哪里断、断的时候长什么样、以及产品该怎么为此设计。
而绝大多数 AI 产品出事,不是因为模型不够好,是因为没人提前问过:”如果它在这个场景下彻底失灵,我的产品会变成什么样?”
这个问题,应该在写第一行产品逻辑之前问。
本文涉及的数据集为 Ferracuti 等人发布的公开数据集(Zenodo 15279701,13 种负载,IEC 62606 采集标准,CC BY 4.0 许可),本文所有指标均在该数据集上实测得出。文中提到的两个研究发现分别来自 ICML 2023 “On Pitfalls of Test-Time Adaptation” 与 NeurIPS 2024 “Uncertainty-aware … EDL a Mirage”,具体出处见参考资料。
参考资料
- Ferracuti, F., et al. Series Arc Fault Dataset — Zenodo record 15279701(13 种负载,IEC 62606,CC BY 4.0)
- On Pitfalls of Test-Time Adaptation. ICML 2023.
- Uncertainty-aware / EDL a Mirage(关于证据深度学习作为 OOD 检测器的讨论). NeurIPS 2024.
本文由 @苏淋 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议


- 目前还没评论,等你发挥!