
 起点课堂会员权益
 职业体系课特权
 线下行业大会特权
 个人IP打造特权
 30+门专项技能课
 1300+专题课程
 12场职场软技能直播
 12场求职辅导直播
 12场专业技能直播
 会员专属社群
 荣耀标识
给客户装个Workbuddy就能搞定的事,为什么我还在搭工作流


十一假期前的一次交流里,对方问:现在通用 Agent 产品都能自己规划、自己调工具执行任务了,为什么还在给客户搭工作流?作者的回答是,可观测系统能把每一次调用还原成流程图,但那是事后的;业务现场真正要命的,是别让它流下去。
十一假期前,我和猎豹移动的FDE团队做了次交流。对方问了我一个问题:
现在 WorkBuddy、豆包工作这类AI办公产品,都能自己规划、自己调工具执行任务了,为什么你还在给客户搭工作流?
这些年我做企业AI培训和项目陪跑,像知识问答、合同审核、报告生成这些智能体,都是用工作流做的,我的理由很简单直接:工作流能把每个节点的动作写清楚,方便逐个检查、调整。
但对方并不买账。他们说,通用Agent也能做长链路任务,再接个可观测系统,一样能知道它调了什么工具、传了什么参数、返回了什么数据。
我回去想了一路,后来想明白了:看得见,不等于管得住。
下面展开讲讲。
01 看得见过程,不等于管得住
对方说的可观测系统,我用过类似的产品,叫Langfuse,它的Tracing能力,能把 Agent 的每一次调用过程都还原成流程图。如下所示:
这在调试时很有用,但它是事后的。
工作流的设计图和 Agent 的 Tracing,是两种东西:设计图管的是“预期怎么走”,Trace 记录的是“这次实际怎么走的”。一个用来规划,一个用来查错。
而业务现场真正要命的,不是“查得出来”,是“别让它流下去”。
Trace 可以在AI读错文件、算错金额的时候,方便查错。可企业要的则是:错了就别进入下一个环节。
这两件事,差着一个量级。
企业要的,是业务结果符合规则,因此规则本身就应该通过工作流或代码程序固定下来。
但处理材料的方法却未必——有些步骤适合提前定死,有些该留给模型自主判断。方案的专业性,就体现在能否划清每一步的决定权。
我把这套方法整理成了一套判断模型,叫做——定、放、问。
- 定:规则能写死的,一律写死
- 放:只有“下一步要看上一步结果”的,才放手给模型
- 问:错了无法收回的,必须停下来问人
02 定:规则能写死的,一律写死
企业里的大部分环节,答案本来就是确定的。
比如销售额要按不含税算。表单提交前必须填好必填项。审批流要走完 A 才能到 B。
这些业务逻辑让模型去“灵活理解”,那就是给自己找麻烦。
我做过一个商品导入的项目。客户自己会先把从各个信息源收集来的商品信息,按固定模板格式进行标准化录入。再检查这些商品在数据库中的状态,如果已有数据就更新,没有就新增。
这件事拆开看会发现:
按什么规则匹配库中的商品、新增记录怎么填进数据库——这是业务规则,可以定死。
而从各个信息源收集到的原始商品数据要按模板统一做填充,他们的字段名、表头位置和文件结构都不一样——这是处理方法,没法写死。
我的做法是:业务规则部分,老老实实写成固定程序。匹配、转换、必填校验,一步都不能让模型插手。
判断标准就一句话:这一步要是错了,最坏会怎样?
如果结果是“要返工”“要道歉”“要赔钱”,那就一定要写死。
03 放:只有“下一步要看上一步结果”的,才放手给模型
什么时候才真正需要 Agent?
只有一种情况:下一步往哪走,你没法提前列出来。
Anthropic 的 Research 系统就是个好例子。它会先自己定调查方向,再根据查到的东西决定要不要继续检索。
想象一下:你去查一家公司的业务变化,先看了官网和公开报告,查着查着发现它上个月收购了一家公司——于是你得接着去查收购目的,以及对原业务的影响。
这条线索,在你打开浏览器之前,是没法写进工作流的。
编程也一样:看代码、改文件、跑测试。测试过了收工,报错了看具体是什么错再改。要动几个文件、改几轮,一开始根本定不了。
我自己手上就有个例子:客户资料室里有 300 多份扫描件 PDF,要抽出来做知识库。
这 300 份文档的版式,是十几年来不同人用不同工具扫出来的,有双栏的、有带表格的、有盖章盖在正文上的、有扫描歪了的。你肯定没法写一套规则把它们全部分对。
这种活,就得让 Agent 自己先看结构、再决定怎么解析和切分。
所以判断标准就一句话:拿三五个真实案例跑一遍,看看每次的处理步骤是不是一样。
一样——定。不一样——放。
04 问:错了无法收回的,必须停下来问人
有些操作错了能改,有些不能。
如果只是生成一版草稿,错了可以删掉重来。但往生产库里写,错了可是要写事故报告的。
因此要把这三类分开处理:
第一类 能改的 —— 放手让它跑,跑完抽查
第二类 不好改的 —— 跑完必须过规则校验,不过就停止报错
第三类 收不回的 —— 停下来,列出来,等人点确认
刚刚那个商品导入项目,我的处理方法是:匹配不上模板字段的记录,就整条拎出来列个清单,让业务同事自己确认。
一份清单二十来条,人家十分钟就确认完了。这十分钟,比事后花两天对账要省事多了。
这里有个反直觉的东西:加人工确认不是拖慢效率,而是把返工成本前置了。
05 这套方法怎么用
说了这么多,这套总结出来的方法,可以如何指导在现场做AI落地方案的决策呢?
其实核心就是讲清楚一件事:每一步,决定权归谁。
我一般会拿一张表,调研的时候和业务同事坐在一起,一格一格地填:
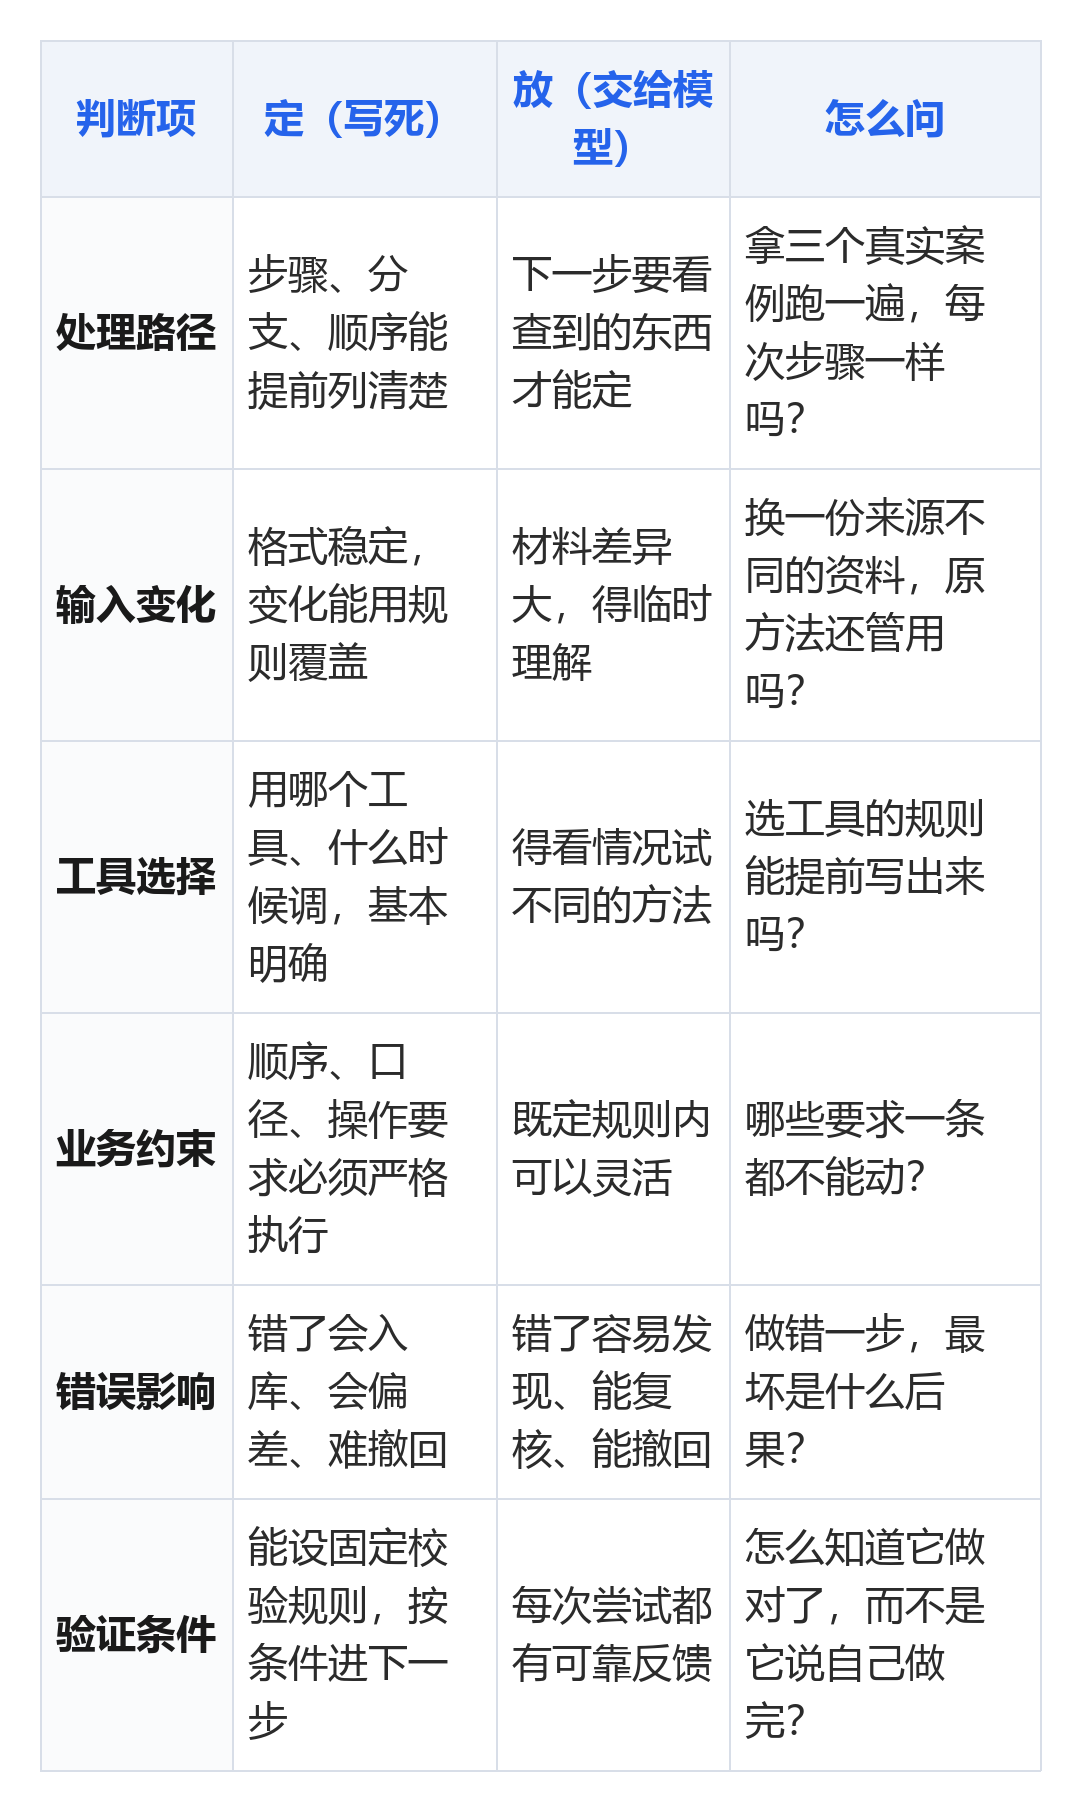
填完这六行,方案基本就有了。
06 总结
回到开头那个问题:Agent 都能自己干活了,为什么还要搭工作流?
我的答案是:这个问题本身就问错了。
不该问“是用Agent还是搭工作流”,而是问“这一步,决策权归谁”。
规则能写死的,定。下一步要看结果的,放。错了收不回的,问。
方案的专业性,不在于你引入了多少AI节点,而在于你懂得选择哪些地方不让AI插手。
如果你手上也有正在跑的 AI 项目,可以试着把流程翻出来,对着上面那张表过一遍,大概就知道哪几步该定、哪几步该放了。
作者:申悦
本文由人人都是产品经理作者【申悦】,微信公众号:【申悦的AI项目现场】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载
题图来自Unsplash,基于 CC0 协议


- 目前还没评论,等你发挥!