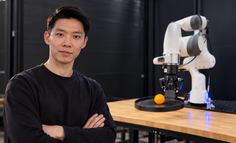
具身智能 斯坦福团队将 LLM 后训练思路引入机器人,VLA 开始从真实经验中继续学 斯坦福博士生 Perry Dong 与导师 Chelsea Finn 提出面向机器人的通用后训练思路。预训练模型已能完成复杂任务,却卡在可靠性上:95% 的成功率放进有玻璃、宠物和孩子的家庭,剩下的 5% 仍会不断制造事故,机器人要学的是稳定把事做对。 有新Newin VLA后训练强化学习

AI,个人随笔 马卡龙的下注:把模型后训练,做成企业服务 Mind Lab 发布模型后训练与推理平台 Mint Recursive,把 MinT 等内部训练链路开放成托管服务。文章复盘 Macaron V1.1 以 GLM-5.3 为基座、训练四个 2B LoRA 专家的过程,以及发票核对与生成式 UI 任务上的前后对照。 赛博禅心 LoRAMind LabMint Recursive
AI,个人随笔 大厂后训练视角看Jev模型的更新(大白话) Jev 的爆火并非因为“读懂潜台词”的趣味截图,而是它试图用 RLCD 取代 RLHF,让大模型从“会聊天”转向“能决策”。本文用大白话拆解预训练、RLHF 到 RLCD 的演进,结合客服等场景,客观分析 Jev 的价值、局限与待验证之处。 AI搭子木木 AI应用JevRLCD
AI 非技术背景,一文读懂大模型后训练(万字长文) 大模型的后训练都在训练些什么?sft、rl、ppo、lora、adapter,这些算法开发们口中的专属名词,都代表着什么意思?本文将尽可能从非技术角度,一文帮你读懂大模型后训练。 同时这也是继去年发布《非技术背景,一文带你读懂大模型》后,时隔一年多,推出的非技术系列第二篇文章啦。也确实看到大家对于此类非技术向讲解的科普文比较感兴趣,希望这篇新文章能一样受大家的喜欢。 Ranger 后训练大模型技术原理
AI AI产品经理必修课:从“半成品”到“杀手级应用”——深度解析后训练(Post-training) 2025年AI领域最深刻的变化,不是算力的军备竞赛,而是后训练技术的战略崛起。从SFT塑造产品人格、RLHF量化用户体验,到推理模型实现System 2思考,本文以卡帕西的经典理论为框架,揭示AI产品经理如何将原始模型雕琢成商业产品。这不仅是技术解码,更是一份从'数据贵族化'到'工具路由'的实战指南。 产品牢大Echo AI产品RLHFSFT
AI,个人随笔 大模型是如何被训练出来的?从预训练到后训练的一次性讲透 大模型从“学认字”到“学做人类偏好”的成长之路,是如何一步步训练出来的?本文带你了解从预训练到后训练的全过程,以及训练师在其中的关键作用。 青蓝色的海 AI应用产品分析后训练
个人随笔 大模型竞赛转向:决胜关键为何是“后训练”? 当前,通用模型在产业落地中面临知识断层、难以对齐用户隐性偏好等难题,而后训练正是解决这些 “最后一公里” 问题的核心。业界已探索出 SFT+RL、纯 RL 等训练范式,MoE 模型、FP8 精度等技术也成为后训练的重要选择。本文解析后训练的关键价值、产业痛点及顶级玩家的实践路径,探讨其如何成为大模型价值释放的决胜场,以及云平台在其中的支撑作用。 甲子光年 后训练大模型技术原理
个人随笔 RL 是 LLM 的新范式 随着人工智能技术的飞速发展,RL(强化学习)逐渐成为LLM(大型语言模型)提升智能的关键技术,而本文就深入探讨了RLHF(基于人类反馈的强化学习)在LLM发展中的重要性和应用。 海外独角兽 RLHF后训练大型语言模型(LLM)